


5. Lösungsdesign und Details zur Storage Architektur

 Änderungen vorschlagen

 PDFs

Karthikeyan Nagalingam, NetApp
[[5-1-design-principles]]
== 5.1 Gestaltungsprinzipien
Konfiguration statt Codeänderungen; explizite Phasengrenzen mit typisierten Verträgen; konsistentes Artefakt-Routing; Validierung mit frühzeitigem Abbruch bei umsetzbaren Fehlern; Neutralität der Storage-Ebene.
[[5-2-stage-design-summary]]
== 5.2 Zusammenfassung des Stufendesigns
| Stufe | Designübersicht |
|---|---|
Erfassung |
|
Datenaufbereitung |
Erkennt/akzeptiert rohe tabellarische StorageGRID-Schlüssel, normalisiert Airbyte/einfache CSV-Dateien, erzeugt deterministische Trainings-/Validierungs-/Inferenz-Aufteilungen und schreibt ein mit einem Ausführungsstempel versehenes Präfix und Manifest der vorbereiteten Daten in den ONTAP NAS Bucket |
Datenmobilität (XCP) |
Kopiert vorbereitete Daten aus dem ONTAP NAS NFS-Export; |
Modelltraining |
Training lokal oder vom XCP Ziel (S3/LustreFS); Erkennung in mehreren Formaten (CSV/Parquet/JSON) |
Feinabstimmung |
Materialisiert das Basismodell aus dem XCP-Ziel; |
Schlussfolgerung |
Materialisiert angepasste Artefakte aus demselben XCP Ziel; konfigurierbarer Split-/Textbereich |
Checkpoint/Fortsetzen |
|
Archivierung |
|
[[5-3-configuration-driven-philosophy]]
== 5.3 Konfigurationsgesteuerte Philosophie
Alle nicht geheimen Speicher-, Engine- und Verhaltensauswahlen sind `dag_run.conf`Parameter, der Wechsel zwischen S3 und LustreFS oder Python und Spark erfordert keine Codeänderung, während der von Airflow verwaltete Secrets-Speicher die erforderlichen Anmeldeinformationen auflöst.
[[5-4-storage-architecture-detail]]
== 5.4 Details zur Storage Architektur
Die Speicherarchitektur unterteilt den KI-Lebenszyklus in speziell entwickelte Ebenen: StorageGRID speichert Rohdaten und Archivobjekte, der ONTAP NAS Bucket enthält aufbereitete und mit einem Ausführungsstempel versehene Datensätze, und ONTAP S3 oder LustreFS stellt die ausgewählte aktive Trainingsebene bereit. Diese Trennung ermöglicht die unabhängige Verwaltung von Quelldaten, aufbereiteten Daten, Modellartefakten und archivierten Nachweisen, während die Herkunft durch die gemeinsame run_stamp erhalten bleibt.
[[5-4-1-storage-layout-diagrams]]
=== 5.4.1 Storage Layout-Diagramme
| Stufe | Logischer Speicherpfad | Inhalte / Gespeicherte Artefakte |
|---|---|---|
StorageGRID Raw-Tier |
|
Tabellarische CSV-Teile ( |
ONTAP NAS vorbere |
|
Formatierte Aufteilungen ( |
Aktive Trainingsstufe (XCP Dest) |
|
Kopierte Datenaufteilungen, trainierte Modellbinärdateien ( |
StorageGRID Archivierungsebene |
|
Phasenbezogene Basislinien- oder vollständige Modellartefakte, Vorhersagenachweise ( |
Inter-Tier-Herkunft und -Ablauf |
Rohdaten → Aufbereitet → Aktive Ebene → Archivierung |
Durchgängige Datenübertragung und Artefaktverfolgung über alle Speicherebenen hinweg, verknüpft über die gemeinsame |
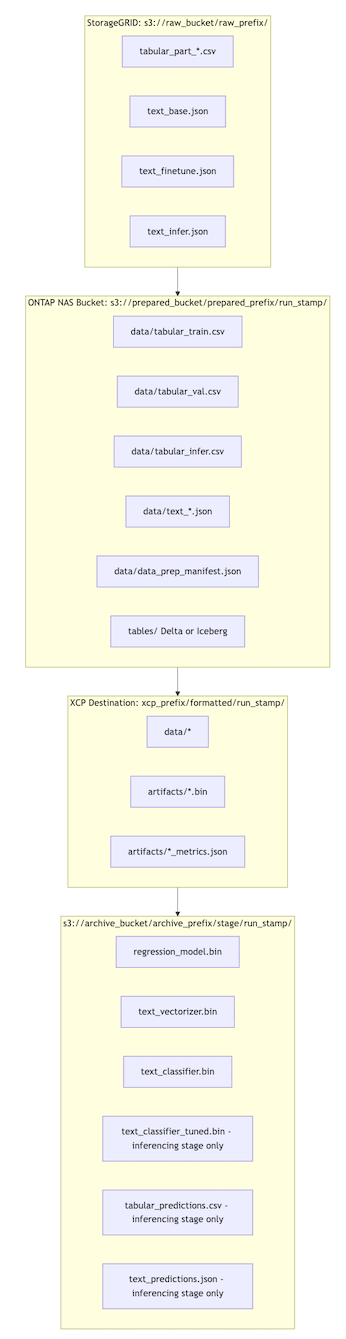
Dieses Diagramm bildet das logische Bucket- und Präfix-Layout für einen einzelnen Pipeline-Lauf über alle Storage Tiers hinweg ab:
[[5-4-2-storage-sizing-guidance]]
=== 5.4.2 Leitfaden zur Storage-Dimensionierung
Jede Speicherebene sollte entsprechend ihrer Rolle und Aufbewahrungsrichtlinie unabhängig dimensioniert werden. Das ONTAP NAS und das ausgewählte XCP Ziel müssen gleichzeitige aktive Ausführungen unterstützen, während die StorageGRID Kapazität in erster Linie durch Rohdaten und die Archivaufbewahrung bestimmt wird. Bei der Planung der maximalen Pipeline Parallelität sollten temporäre Arbeitskapazität und Wachstumsreserven berücksichtigt werden.
| Stufe | Grundlage für die Größenbestimmung |
|---|---|
StorageGRID Rohdaten-Bucket |
Aufnahmevolumen × Aufbewahrungszeitraum |
ONTAP NAS Bucket für vorbereitete Daten |
Größe des vorbereiteten Datensatzes × Anzahl der beibehaltenen Ausführungen |
XCP Ziel (S3 oder Lustre) |
Maximale Größe des gleichzeitigen Trainingsdatensatzes + Modellartefakt-Overhead |
Archiv-Bucket |
Aufbewahrungsrichtlinie × Auswahl der Archivierungsphase (model_training = kleiner; inferencing = größer) |
[[5-4-3-storage-performance-considerations]]
=== 5.4.3 Überlegungen zur Storage-Performance
Das XCP-Ziel wird pro Lauf ausgewählt xcp_copy_destination, sodass die Speicherleistung an die Arbeitslast angepasst wird, anstatt jede Arbeitslast auf eine einzige Ebene zu zwingen. LustreFS ist für Datensätze mit hoher Zeilenanzahl, viele gleichzeitige Leser oder E/A-intensives Training geeignet. ONTAP S3 ist für kostenbewusste Workloads mit elastischem Zugriff geeignet, deren Leistungsanforderungen kein paralleles Dateisystem erfordern. In beiden Fällen hält XCP Daten und Modellartefakte auf die ausgewählte Trainingsebene abgestimmt.