


Conmute por error aplicaciones a un sitio remoto con NetApp Disaster Recovery


 Sugerir cambios

 PDF

Cuando ocurra un desastre u otro evento similar, usa NetApp Disaster Recovery para recuperar cargas de trabajo críticas y que las aplicaciones puedan reanudarse en el sitio de recuperación ante desastres con las asignaciones planificadas.
La recuperación ante desastres también permite realizar pruebas de conmutación por error. Realizar pruebas te ayuda a familiarizarte con el proceso y confirma que la recuperación funciona como esperas.
Rol requerido de NetApp Console Se requiere el rol de Super admin, Disaster recovery admin o Disaster recovery failover admin para realizar esta tarea. "Obtenga información sobre los roles y permisos de usuario en NetApp Disaster Recovery". "Obtenga información sobre los roles de acceso a la NetApp Console para todos los servicios".
Acerca de esta tarea
Durante la conmutación por error, Disaster Recovery usa de forma predeterminada la copia de Snapshot más reciente de SnapMirror, aunque puedes seleccionar una Snapshot específica de una instantánea de momento específico (según la política de retención de SnapMirror). Usa la opción de momento específico si las réplicas más recientes están comprometidas, por ejemplo, durante un ataque de ransomware.
Este proceso difiere dependiendo de si el sitio de producción está en buen estado y si está realizando una conmutación por error al sitio de recuperación ante desastres por motivos distintos a una falla crítica de la infraestructura:
-
Fallo crítico del sitio de producción en el que no se puede acceder al vCenter de origen, al clúster de Kubernetes o al clúster de ONTAP: Disaster Recovery te permite seleccionar cualquier snapshot disponible desde la que restaurar.
-
El entorno de producción está en buen estado: puede "Tomar una instantánea ahora" o seleccionar una instantánea creada previamente.
Este procedimiento interrumpe la relación de replicación, desconecta las cargas de trabajo de origen, hace que los volúmenes replicados estén disponibles en el sitio de recuperación ante desastres, reinicia las cargas de trabajo protegidas siguiendo las reglas de conmutación por error del plan y habilita la lectura/escritura en el sitio de destino. En el caso de las cargas de trabajo de VMware, el servicio pone fuera de línea las VM de origen del vCenter, registra los volúmenes como datastores en el vCenter de recuperación ante desastres y reinicia las VM protegidas. Las cargas de trabajo de Kubernetes siguen la secuencia equivalente para sus aplicaciones y volúmenes persistentes.
Probar el proceso de conmutación por error
Antes de llevar a cabo una conmutación por error en directo, puedes realizar una prueba para comprobar que todo está listo. Las cargas de trabajo permanecen en línea durante el proceso de prueba.
Durante una prueba de conmutación por error de cargas de trabajo de VMware, Disaster Recovery crea VMs de forma temporal. Disaster Recovery asigna un almacén de datos temporal que respalda el volumen FlexClone a los hosts ESXi. Una prueba de conmutación por error de cargas de trabajo de Kubernetes sigue la secuencia equivalente para las aplicaciones protegidas y los volúmenes persistentes en el clúster de destino.
Este proceso no consume capacidad física adicional en el almacenamiento ONTAP local ni en FSx para el almacenamiento ONTAP de NetApp en AWS. El volumen de origen original no se modifica y los trabajos de réplica pueden continuar incluso durante la recuperación ante desastres.
Cuando completes la prueba, te recomendamos restablecer el entorno de prueba con la opción Clean up test.
Una operación de conmutación por error de prueba no afecta las cargas de trabajo de producción, la relación SnapMirror utilizada en el sitio de prueba y las cargas de trabajo protegidas que deben seguir funcionando normalmente.
En caso de una conmutación por error de prueba, Disaster Recovery lleva a cabo las siguientes operaciones.
-
Realice comprobaciones previas en el clúster de destino y la relación SnapMirror .
-
Cree un nuevo volumen FlexClone a partir de la instantánea seleccionada para cada volumen ONTAP protegido en el clúster ONTAP del sitio de destino.
-
Si alguno de los almacenes de datos es VMFS, cree y asigne un iGroup a cada LUN.
-
Registra las máquinas virtuales de destino en vCenter como nuevos almacenes de datos.
-
Enciende las máquinas virtuales de destino según el orden de arranque capturado en la página de grupos de recursos.
-
Desactive cualquier aplicación de base de datos compatible en las máquinas virtuales indicadas como "compatibles con la aplicación".
-
Si los clústeres de origen vCenter y ONTAP aún están activos, cree una relación SnapMirror en dirección inversa para replicar cualquier cambio mientras esté en estado de conmutación por error en el sitio de origen original.
-
Iniciar sesión en el "NetApp Console" .
-
Desde el panel de navegación izquierdo de la NetApp Console , seleccione Protección > Recuperación ante desastres.
-
Desde el menú Disaster Recovery, selecciona Replication plans.
-
Seleccione el plan de replicación.
-
A la derecha, selecciona la opción Actions
 y selecciona Test failover.
-
En la página Test failover, elige la instantánea para el test failover: selecciona Take snapshot now o Select para elegir una instantánea existente. Si eliges Select, elige la instantánea existente.
A continuación, escribe “Test failover” y selecciona Test failover.
-
Una vez finalizada la prueba, limpie el entorno de prueba.
Limpiar el entorno de prueba después de una prueba de conmutación por error
Cuando termine la prueba de conmutación por error, debes limpiar el entorno de prueba. Este proceso elimina los recursos de prueba temporales y los FlexClones de la ubicación de prueba. En el caso de las cargas de trabajo de VMware, esto incluye las máquinas virtuales temporales y los datastores temporales.
-
Desde el menú Disaster Recovery, selecciona Replication plans.
-
Seleccione el plan de replicación.
-
A la derecha, selecciona la opción Acciones
y luego Limpiar prueba de conmutación por error. -
En la página de prueba de conmutación por error, ingrese "Limpiar conmutación por error" y luego seleccione Limpiar prueba de conmutación por error.
Conmutar por error el sitio de origen a un sitio de recuperación ante desastres
Si se produce un desastre, conmuta por error tu sitio principal al sitio de recuperación ante desastres cuando lo necesites. Para las cargas de trabajo de VMware, puedes conmutar por error tu sitio principal de VMware local a otro sitio de VMware local o a VMware Cloud on AWS con FSx for NetApp ONTAP. Para las cargas de trabajo de Kubernetes, conmutas por error al clúster de destino del plan de replicación.
El proceso de conmutación por error implica las siguientes operaciones. Las operaciones que hacen referencia a vCenter, máquinas virtuales o almacenes de datos se aplican a las cargas de trabajo de VMware; las cargas de trabajo de Kubernetes siguen las operaciones equivalentes para sus aplicaciones y volúmenes persistentes:
-
Disaster Recovery realiza comprobaciones previas en el clúster de destino y en la relación SnapMirror .
-
Si seleccionó la última instantánea, se realiza la actualización de SnapMirror para replicar los últimos cambios.
-
Las máquinas virtuales de origen se apagan.
-
La relación SnapMirror se rompe y el volumen de destino se convierte en lectura/escritura.
-
Según la selección de la instantánea, el sistema de archivos activo se restaura a la instantánea especificada (la más reciente o la seleccionada).
-
Los almacenes de datos se crean y se montan en el clúster o host VMware o VMC según la información capturada en el plan de replicación. Si alguno de los almacenes de datos es VMFS, cree y asigne un iGroup a cada LUN.
-
Las máquinas virtuales de destino se registran en vCenter como nuevos almacenes de datos.
-
Las máquinas virtuales de destino se encienden según el orden de arranque capturado en la página Resource groups.
-
Si el vCenter de origen sigue activo, apaga todas las máquinas virtuales del lado de origen que estén siendo objeto de una conmutación por error.
-
Desactive cualquier aplicación de base de datos compatible en las máquinas virtuales indicadas como "compatibles con la aplicación".
-
Si los clústeres de origen vCenter y ONTAP siguen activos, crea una relación SnapMirror en sentido inverso para replicar cualquier cambio que se produzca mientras se esté en estado de conmutación por error de vuelta al sitio de origen original. La relación SnapMirror se invierte, pasando de la máquina virtual de destino a la de origen.

|
Para las cargas de trabajo de VMware, después de que se inicie el failover, puedes ver las máquinas virtuales recuperadas en el vCenter del sitio de recuperación ante desastres (máquinas virtuales, redes y datastores). De forma predeterminada, las máquinas virtuales se recuperan en la carpeta Workload. |
En el caso de los planes de replicación basados en almacenes de datos, si agregó y descubrió máquinas virtuales pero no proporcionó detalles de mapeo, esas máquinas virtuales se incluyen en la conmutación por error. La conmutación por error fallará con una notificación en los trabajos. Debe proporcionar los detalles de asignación para completar la conmutación por error con éxito.
-
Desde el menú Disaster Recovery, selecciona Replication plans.
-
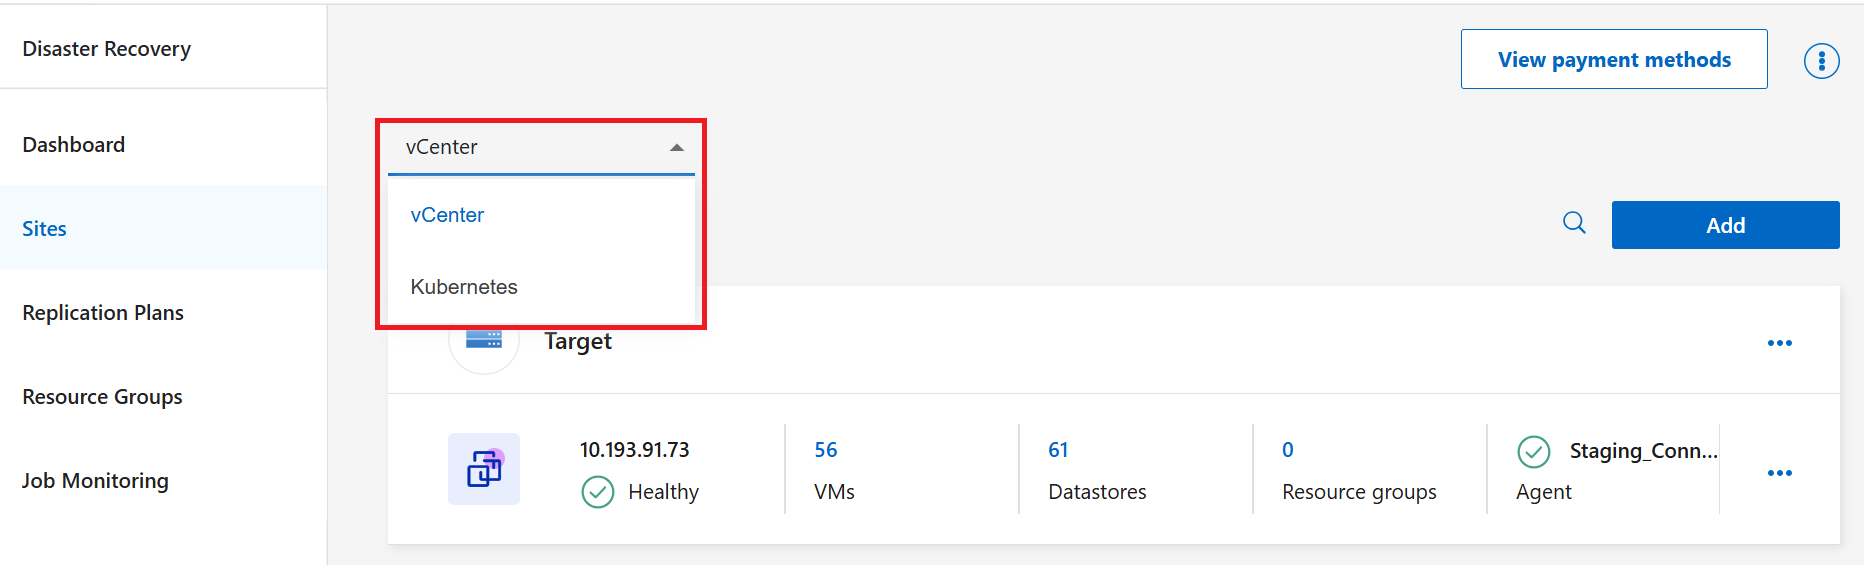
En el menú desplegable, filtra a los planes de replicación de vCenter.
-
Seleccione el plan de replicación.
-
A la derecha, selecciona la opción Actions
, pasa el mouse por encima de Recover y luego selecciona Fail over.
-
Elige la copia de instantánea que quieres usar para la conmutación por error:
-
Selecciona Tomar instantánea ahora para crear una instantánea totalmente nueva que se copiará al clúster de destino antes de la conmutación por error.
-
Selecciona Usar la última instantánea para utilizar la instantánea más reciente disponible en el clúster de destino.
-
Selecciona Seleccionar para consultar una lista de instantáneas ordenadas por recencia.

Al seleccionar una línea de base de instantáneas específica, las instantáneas de transferencia de SnapMirror se ocultan de forma predeterminada porque pueden eliminarse durante la conmutación por error. Esta eliminación impide volver a proteger la carga de trabajo tras la conmutación por error debido a un error de "no se ha encontrado ninguna instantánea común". Aún puedes usar las instantáneas de transferencia de SnapMirror, pero tendrás que completar un mensaje de confirmación adicional para reconocer el riesgo.
-
-
Selecciona Forzar conmutación por error si deseas que la conmutación por error continúe incluso cuando el servicio detecte un error que, en condiciones normales, la bloquearía.
-
Selecciona Omitir protección si quieres evitar que el servicio cree automáticamente una relación de protección de SnapMirror inversa después de una conmutación por error del plan de replicación. Esto es útil si quieres realizar operaciones adicionales en el sitio restaurado antes de volver a ponerlo en línea en Disaster Recovery.
Puede establecer protección inversa seleccionando Proteger recursos en el menú Acciones del plan de replicación. Esto intenta crear una relación de replicación inversa para cada volumen del plan. Puede ejecutar este trabajo repetidamente hasta que se restablezca la protección. Cuando se restablezca la protección, puede iniciar una conmutación por error de la forma habitual. -
Escriba "conmutación por error" en el cuadro.
-
Seleccione Conmutación por error.
-
Para comprobar el progreso, en el menú, seleccione Monitorización de trabajos.
-
Desde el menú Disaster Recovery, selecciona Replication plans.
-
En el menú desplegable, filtra a planes de replicación Kubernetes.
-
Seleccione el plan de replicación.
-
A la derecha, selecciona la opción Actions
, pasa el mouse por encima de Recover y luego selecciona Fail over. -
Elige la copia de instantánea que quieres usar para la conmutación por error:
-
Selecciona Realizar instantánea ahora para crear una instantánea totalmente nueva que se copiará al clúster de destino.
-
Selecciona Usar la última instantánea para utilizar la instantánea más reciente disponible en el clúster de destino.
-
Selecciona Seleccionar para consultar una lista de instantáneas ordenadas por recencia.
Al seleccionar una línea de base de instantáneas específica, las instantáneas de transferencia de SnapMirror se ocultan de forma predeterminada porque pueden eliminarse durante la conmutación por error. Esta eliminación impide volver a proteger la carga de trabajo tras la conmutación por error debido a un error de "no se ha encontrado ninguna instantánea común". Aún puedes usar las instantáneas de transferencia de SnapMirror, pero tendrás que completar un mensaje de confirmación adicional para reconocer el riesgo.
-
-
Selecciona Skip protection si quieres que Disaster Recovery no cree automáticamente una relación de protección de SnapMirror inversa tras una conmutación por error de un plan de replicación. Esto resulta útil si quieres realizar operaciones adicionales en el sitio restaurado antes de volver a ponerlo en línea en Disaster Recovery.
-
Introduce "Failover" para confirmar la acción y luego selecciona Failover.
Puedes supervisar el estado del trabajo en Supervisión de trabajos o Planes de replicación.