3. Descripción general de la arquitectura

 Sugerir cambios

 PDF

Karthikeyan Nagalingam, NetApp
En esta sección se presentan el flujo de trabajo lógico, las interacciones entre componentes, la implementación física y el linaje de datos del pipeline de IA validado. En conjunto, los diagramas muestran cómo Apache Airflow coordina el movimiento de datos desde StorageGRID a través de ONTAP NAS, utiliza opcionalmente NetApp XCP para colocar los datos en ONTAP S3 o LustreFS para la ejecución de modelos y devuelve los resultados gobernados al almacenamiento de archivado de StorageGRID.
[[3-1-high-level-three-tier-ai-storage-architecture]]
== 3.1 Arquitectura de almacenamiento de IA de tres niveles de alto nivel
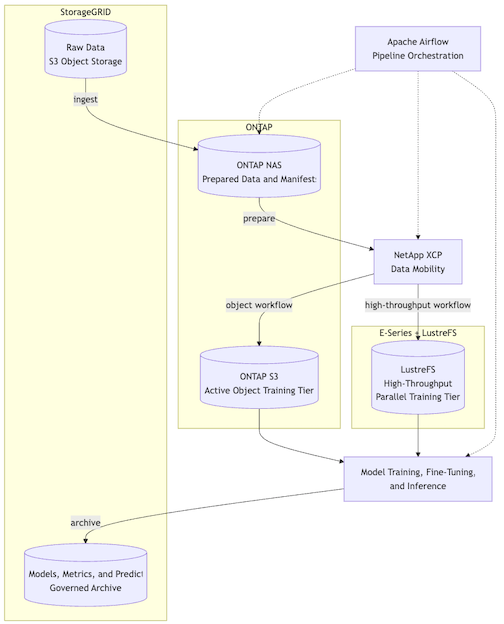
La arquitectura de almacenamiento de IA de NetApp coloca los datos en el nivel de almacenamiento que mejor se adapta a cada fase del ciclo de vida. StorageGRID se utiliza para la ingesta de datos sin procesar escalable y optimizada en costes, así como para el archivado gestionado. ONTAP NAS y ONTAP S3 se utilizan para los flujos de trabajo de preparación activa, almacenamiento temporal para la movilidad de datos y entrenamiento basado en objetos. E-Series con LustreFS se utiliza cuando se requiere una E/S de entrenamiento paralela de alto rendimiento. Apache Airflow coordina el ciclo de vida, mientras que NetApp XCP mueve los datos preparados desde el nivel ONTAP NAS al nivel de entrenamiento activo seleccionado.
[[3-2-high-level-solution-architecture]]
== 3.2 Arquitectura de la solución a grandes rasgos
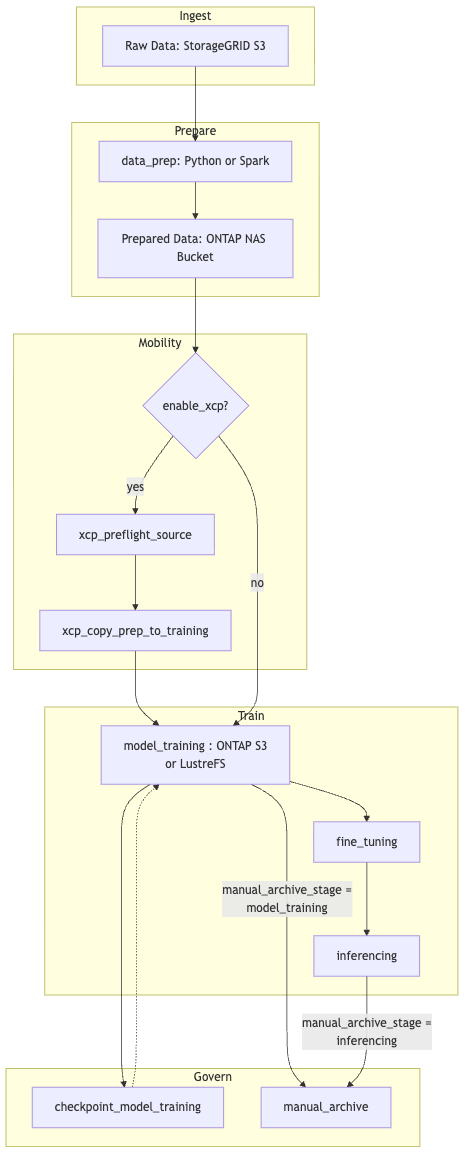
Este diagrama de flujo muestra el ciclo de vida controlado por Airflow, desde los datos sin procesar de StorageGRID hasta la preparación, la movilidad de datos XCP opcional, la ejecución del modelo, la creación de puntos de control y el archivado. enable_xcp determina si los datos preparados se copian del bucket NAS de ONTAP a ONTAP S3 o LustreFS antes del entrenamiento. Las ramas de archivado son independientes: manual_archive_stage=model_training archiva la línea base inmediatamente después del entrenamiento, mientras que manual_archive_stage=inferencing archiva el resultado completo después de que se generen las predicciones.
[[3-3-component-interaction-diagram]]
== 3.3 Diagrama de interacción entre componentes
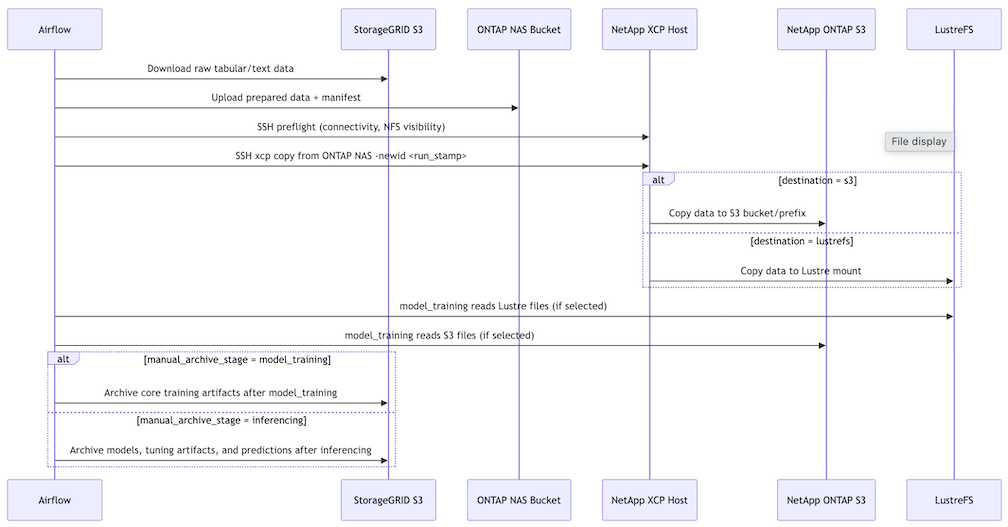
Este diagrama de secuencia identifica qué componente de la plataforma realiza cada intercambio. Airflow lee los objetos sin procesar de StorageGRID y escribe los datos preparados en el bucket NAS de ONTAP; luego, invoca XCP a través de SSH. XCP lee la exportación NFS de ONTAP NAS y escribe en el nivel de entrenamiento configurado. El bloque condicional final muestra que el contenido de archivado de StorageGRID depende de la etapa de archivo manual seleccionada.
[[3-4-physical-deployment-architecture]]
== 3.4 Arquitectura física y de implementación
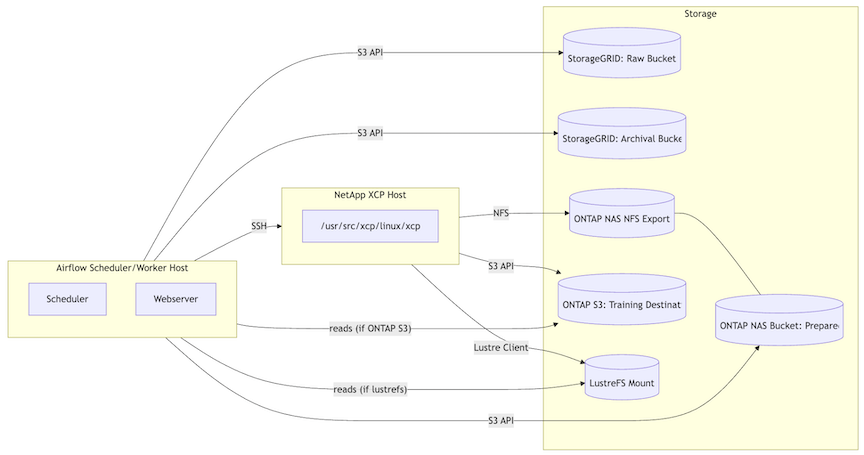
Este diagrama de implementación muestra los hosts, los endpoints de almacenamiento y las interfaces de red necesarios. El host de Airflow usa las API de S3 para StorageGRID, el bucket NAS de ONTAP y el destino S3 de ONTAP seleccionado, y usa SSH para controlar el host XCP. El host XCP accede al origen de datos preparados a través de NFS y escribe en ONTAP S3 o en el montaje de LustreFS; cuando se selecciona LustreFS, el host de Airflow también debe montarlo para leer los datos de entrenamiento y materializar los artefactos.
[[3-5-data-flow-overview]]
== 3.5 Resumen del flujo de datos
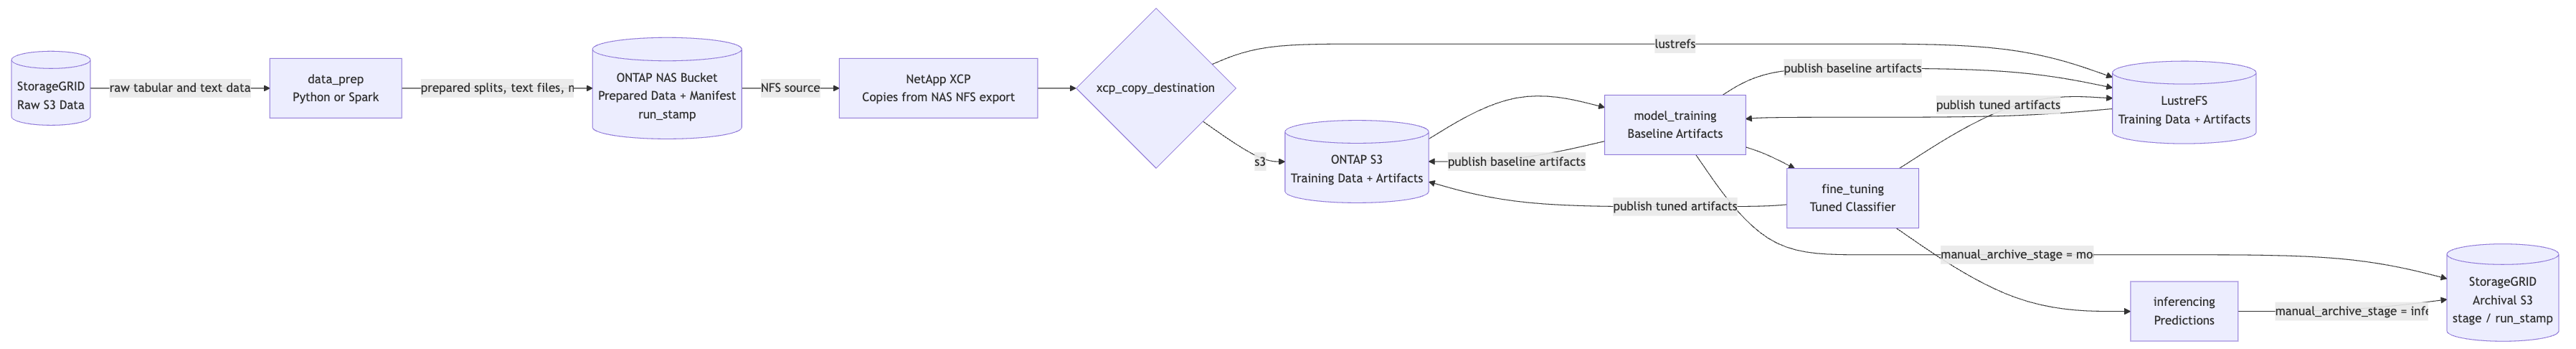
Este flujo compacto resume la procedencia de los datos y los artefactos. Cada ejecución recibe un identificador único run_stamp, que permite rastrear los datos preparados, la salida de XCP, los artefactos del modelo, las predicciones y los objetos archivados hasta la misma ejecución. La selección del destino de XCP rige el nivel de datos de entrenamiento y artefactos del modelo, mientras que manual_archive_stage determina si StorageGRID recibe el paquete de entrenamiento de referencia o el paquete completo de inferencia.