


5. Detalles del diseño de la solución y la arquitectura de almacenamiento

 Sugerir cambios

 PDF

Karthikeyan Nagalingam, NetApp
[[5-1-design-principles]]
== 5.1 Principios de diseño
Configuración por encima de los cambios en el código; límites explícitos entre etapas con contratos tipados; enrutamiento coherente de artefactos; validación de fallo rápido con errores accionables; neutralidad respecto al nivel de almacenamiento.
[[5-2-stage-design-summary]]
== 5.2 Resumen del diseño de la etapa
| Escenario | Resumen del diseño |
|---|---|
Ingestión |
|
Preparación de datos |
Descubre y acepta claves tabulares sin procesar de StorageGRID; normaliza Airbyte/CSV sin formato; genera divisiones determinísticas de train/val/infer; escribe un prefijo de datos preparados con marca de ejecución y un manifiesto en el bucket NAS de ONTAP |
Movilidad de datos (XCP) |
Copia los datos preparados desde la exportación NFS del NAS de ONTAP; |
Entrenamiento de modelos |
Se entrena localmente o desde el destino XCP (S3/LustreFS); detección multiformato (CSV/Parquet/JSON) |
Ajuste fino |
Materializa el modelo base desde el destino XCP; |
Inferencia |
Materializa artefactos ajustados desde el mismo destino XCP; ámbito configurable de división/texto |
Punto de control/Reanudar |
|
Archivado |
|
[[5-3-configuration-driven-philosophy]]
== 5.3 Filosofía basada en la configuración
Todas las selecciones no secretas de almacenamiento, motor y comportamiento son parámetros dag_run.conf: cambiar entre S3 y LustreFS, o entre Python y Spark, no requiere ninguna modificación del código, mientras que el almacenamiento de secretos gestionado por Airflow resuelve las credenciales necesarias.
[[5-4-storage-architecture-detail]]
== 5.4 detalle de la arquitectura de almacenamiento
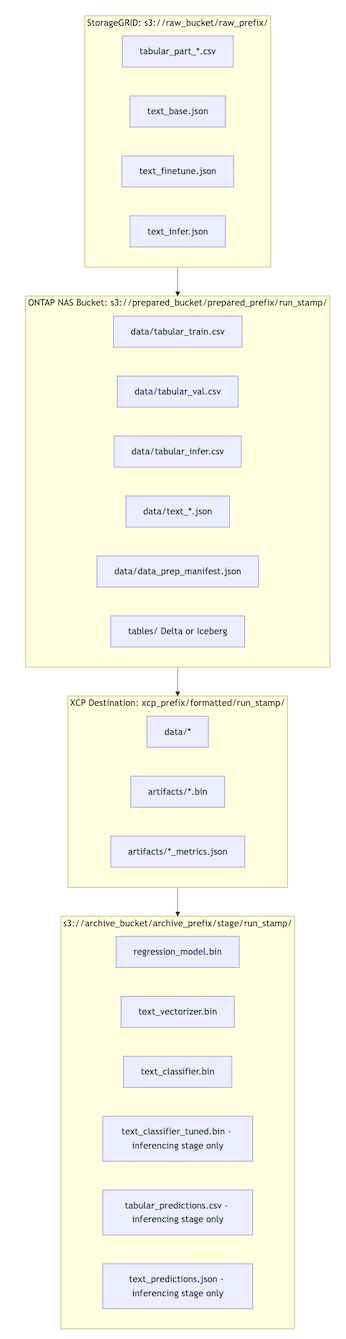
La arquitectura de almacenamiento divide el ciclo de vida de la IA en niveles diseñados específicamente para cada fin: StorageGRID almacena objetos sin procesar y archivados; el bucket NAS de ONTAP contiene conjuntos de datos preparados y con marca de ejecución; y ONTAP S3 o LustreFS proporcionan el nivel de entrenamiento activo seleccionado. Esta separación permite gestionar de forma independiente los datos de origen, los datos preparados, los artefactos del modelo y las pruebas archivadas, al tiempo que se conserva el linaje a través del run_stamp compartido.
[[5-4-1-storage-layout-diagrams]]
=== 5.4.1 Diagramas de distribución de almacenamiento
| Nivel | Ruta de almacenamiento lógica | Contenido / artefactos almacenados |
|---|---|---|
Nivel «Raw» de StorageGRID |
|
Partes tabulares de CSV ( |
Nivel preparado para NAS de ONTAP |
|
Datos fragmentados con formato ( |
Nivel de entrenamiento activo (XCP Dest) |
|
Datos copiados y divididos, archivos binarios de modelos entrenados (( |
Nivel de archivado de StorageGRID |
|
Artefactos del modelo de referencia o del modelo completo con alcance por etapas, evidencia de predicción ( |
Linaje y flujo entre niveles |
Sin procesar → Preparado → Nivel activo → Archivado |
Movimiento de datos de extremo a extremo y linaje de artefactos vinculados en todos los niveles de almacenamiento a través del almacenamiento compartido |
Este diagrama muestra la estructura lógica de los buckets y los prefijos para una única ejecución de la canalización en todos los niveles de almacenamiento:
[[5-4-2-storage-sizing-guidance]]
=== 5.4.2 guía de dimensionamiento del almacenamiento
Dimensiona cada nivel de forma independiente según su función y su política de retención. El NAS de ONTAP y el destino XCP seleccionado deben admitir ejecuciones activas simultáneas, mientras que la capacidad de StorageGRID viene determinada principalmente por la retención de datos sin procesar y de archivo. Incluye capacidad de trabajo temporal y margen de crecimiento al planificar la concurrencia máxima de la canalización.
| Nivel | Base de dimensionamiento |
|---|---|
Bucket sin procesar de StorageGRID |
Volumen de ingestión × intervalo de retención |
Bucket de datos preparados de ONTAP NAS |
Tamaño del conjunto de datos preparado × número de ejecuciones conservadas |
Destino de XCP (S3 o Lustre) |
Tamaño máximo simultáneo del conjunto de datos de entrenamiento + sobrecarga de artefactos del modelo |
Bucket de archivado |
Política de retención × selección de la etapa de archivo (model_training = más pequeña; inferencing = más grande) |
[[5-4-3-storage-performance-considerations]]
=== 5.4.3 Consideraciones sobre el rendimiento del almacenamiento
El destino XCP se selecciona en cada ejecución con xcp_copy_destination, lo que permite que el rendimiento del almacenamiento se adapte a la carga de trabajo en lugar de obligar a todas las cargas de trabajo a usar un único nivel. Selecciona LustreFS para conjuntos de datos con un elevado número de filas, muchos lectores simultáneos o entrenamiento con un uso intensivo de E/S. Selecciona ONTAP S3 para cargas de trabajo en las que se prima la rentabilidad y el acceso elástico, y cuyos requisitos de rendimiento no exigen un sistema de archivos paralelo. En cualquier caso, XCP mantiene los datos y los artefactos del modelo alineados con el nivel de entrenamiento seleccionado.