


Prácticas recomendadas para cargas de trabajo NAS con un elevado número de archivos

 Sugerir cambios

 PDF

El diseño de cargas de trabajo con un elevado número de archivos debe tener en cuenta el total de nodos de información públicos, las entradas del directorio más grande, la tasa de operaciones de metadatos y las tareas del ciclo de vida. Recopila esos datos tal y como se describe en "Enfoque de planificación", y después sigue estas recomendaciones. No consideres el número de archivos como un único límite ni te bases únicamente en la capacidad de los datos.
Analiza el espacio de nombres antes de dimensionar el almacenamiento
Recopila o calcula:
-
Número total actual y máximo de archivos, directorios, flujos y objetos ACL
-
Crecimiento anual o por fases del proyecto
-
Número máximo de archivos creados y eliminados por segundo
-
Número máximo de entradas en un directorio
-
Distribución de la longitud de los nombres de archivo y conjuntos de caracteres
-
Uso de nombres SMB DOS 8.3 o nombres NFS alternativos
-
Tasas de lectura, escritura, búsqueda, atributos, enumeración, cambio de nombre y eliminación
-
Planificación de SnapVault y retención
-
Copias de seguridad, replicación, migración, análisis y frecuencia de análisis de seguridad
Utiliza los valores máximos en lugar de las medias diarias. Las canalizaciones de compilación, los trabajos de análisis, las migraciones y los flujos de trabajo temporales suelen crear su espacio de nombres más grande durante un breve periodo de tiempo y luego lo limpian, pero los archivos de nodo de información y de directorio pueden conservar las marcas de nivel máximo después de la limpieza.
Establece los valores de «maxfiles» y «maxdir-size» de forma independiente
Mantén dos previsiones distintas:
-
Previsión de nodos de información de volumen: todos los objetos públicos del sistema de archivos que se esperan en FlexVol o en cada componente de FlexGroup.
-
Previsión del directorio más grande: bytes en disco de los archivos de directorio del directorio con más nombres o con los nombres más largos.
No deduzcas un valor a partir del otro. Un espacio de nombres fragmentado (archivos repartidos en muchos directorios) puede agotar maxfiles sin crear un directorio grande. Un único directorio plano puede alcanzar el límite de maxdir-size aunque el volumen tenga millones de nodos de información libres.
No determines el tamaño de maxfiles basándote únicamente en el número de archivos visibles en NTFS o en espacios de nombres con muchas ACL. Incluye directorios, nodos de información de ACL, flujos con nombre y otros objetos públicos en tus proyecciones. Cuando las ACL tengan una presencia importante, usa hasta el doble del recuento proyectado de archivos y directorios como una estimación inicial conservadora para files y luego valida con datos representativos, ya que el uso compartido de ACL puede reducir el uso real.
-
En el caso de volúmenes con un gran número de archivos, configura
filescon el valor actual defiles-maximum-possiblecuando el tamaño del volumen y las restricciones del protocolo lo permitan. Ese límite máximo no preasigna espacio; permite quefiles-usedcrezca hasta alcanzar el límite asignado en lugar de requerir aumentos repetidos. -
Aumenta
maxdir-sizesolo si se demuestra que es necesario para un único directorio, normalmente en incrementos de aproximadamente el 2 %. Consulta "Control de «maxfiles»" y "¿Qué ocurre cuando se supera maxdir-size?".
Prefiere una estructura de directorios fragmentada
Hay tres estructuras de espacio de nombres habituales.
-
Plana: uno o varios directorios contienen muchos archivos en el mismo nivel.
-
Amplio: muchos directorios de nivel superior dividen los archivos.
-
Profundo: menos directorios de nivel superior dan lugar a varios niveles de subdirectorios.
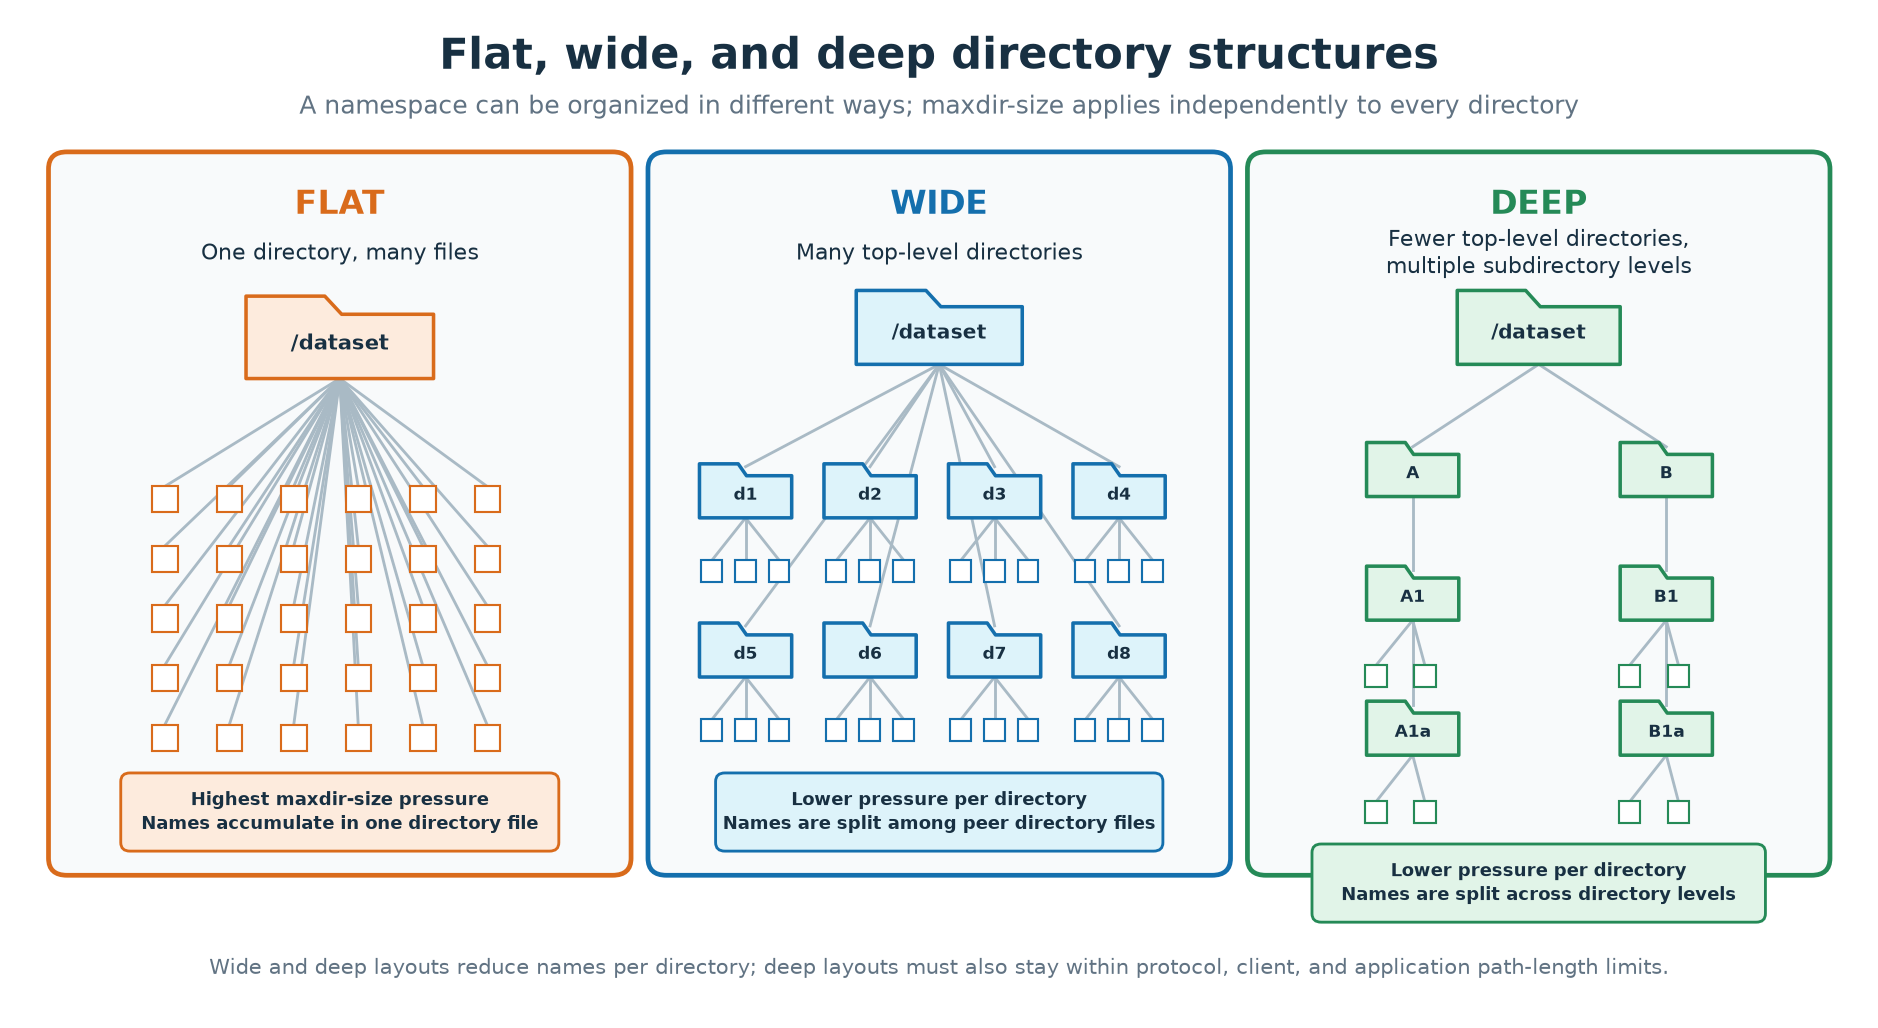
Siempre que sea posible, evita colocar millones de nombres en un mismo nivel plano de directorio si la aplicación puede utilizar una jerarquía amplia o profunda. Las estructuras planas concentran el uso de memoria y CPU y pueden aumentar la latencia durante las operaciones masivas de GETATTR, READDIR, búsqueda y eliminación. En un volumen FlexGroup, un directorio plano grande también puede generar más entradas remotas, lo que hace que su archivo de directorio se acerque a maxdir-size antes que con la misma cantidad de nombres visibles en un FlexVol.
Los volúmenes FlexGroup por lo general funcionan mejor con muchos directorios pequeños que con un único directorio grande y plano. Los directorios de menos de unos 2 MiB permanecen en la ruta de escaneo simple. A partir de ONTAP 9.2, los directorios más grandes se indexan automáticamente, lo que facilita las búsquedas específicas. La indexación no hace que un directorio muy grande sea equivalente a una jerarquía fragmentada: la enumeración, los escaneos con comodines y la serialización de la creación en un solo directorio siguen siendo aplicables. ONTAP puede colocar los directorios secundarios de FlexGroup de forma remota, mientras prioriza la localidad de los archivos con respecto al directorio principal, lo que reduce la latencia remota de esos archivos.
Distribuir archivos en una jerarquía implica usar más directorios con menos archivos en cada directorio.
Entre las claves de fragmentación más habituales se incluyen:
-
Un prefijo hash
-
Cliente, proyecto o inquilino
-
Fecha o intervalo de tiempo
-
Conjunto de datos, trabajo o etapa del flujo de trabajo
-
Tipo de objeto o estado del ciclo de vida
Elige suficientes fragmentos para que las operaciones de directorio sean manejables, pero no crees tantos directorios casi vacíos que el propio número de directorios resulte excesivo. Un esquema determinista hace que la ubicación sea predecible y permite a los clientes localizar archivos sin tener que escanear todos los fragmentos.
Tanto las estructuras anchas como las profundas pueden funcionar. Mantén la longitud total de las rutas dentro de los límites del protocolo NAS, del sistema operativo del cliente y de la aplicación. Si no es posible evitar una estructura plana, supervisa el tamaño actual del archivo del directorio más grande y maxdir-size el margen disponible, tal y como se describe en "Ver maxdir-size y el tamaño del directorio actual", y comprueba si es adecuado un aumento controlado.
Selecciona la arquitectura de volumen adecuada
FlexVol
Utiliza un FlexVol cuando la capacidad de un volumen (inferior a 1 TB), la escala de nodo de información (inferior a 2.000 millones) y el dominio de rendimiento satisfagan la carga de trabajo (menor ingesta, menos clientes). Los volúmenes FlexVol también deben tenerse en cuenta para cargas de trabajo que puedan requerir la creación de muchos volúmenes o sistemas de archivos en el clúster, lo que podría hacer que se alcance el recuento total de volúmenes (como con los PVC de Kubernetes) o para los almacenes de datos de VMware.
FlexGroup
Utiliza FlexGroup cuando la carga de trabajo se beneficie de una mayor capacidad total (>300 TB), una mayor escala en el número de archivos (>2.000 millones) y paralelismo entre los componentes y los nodos.
Planifica lo siguiente:
-
Límites y distribución de nodos de información por componente
-
Identificadores de archivos NFS de 64 bits cuando FlexGroup puede superar unos dos mil millones de archivos (consulta "Identificadores de archivos NFS de 64 bits y recuentos de archivos FlexGroup")
-
Balance de capacidad global y de los componentes (Nota: para NetApp AFX, esto no es necesario)
-
Comportamiento de la asignación de la carga de trabajo
-
Representación específica de una entrada de directorio de FlexGroup
-
Compatibilidad de protección de datos
-
Comportamiento de la aplicación cuando se distribuyen los archivos
Un FlexGroup no paraleliza automáticamente las operaciones en un directorio lógico. La distribución entre directorios sigue siendo valiosa para equilibrar el rendimiento.
Deja margen operativo
No planifiques un funcionamiento en estado estacionario al 100 % de los nodos de información utilizados ni del archivo de directorio más grande. Deja margen para el crecimiento inesperado, los objetos temporales, los metadatos retenidos por Snapshot, las ACL y los flujos, el solapamiento de migración, las tareas de copia de seguridad, el desequilibrio en la ubicación de FlexGroup y los cambios de software que alteren los nombres de archivo.
Establecer files en el máximo actual es un límite, no un permiso para seguir funcionando hasta que se agote el último nodo de información. Configura una alerta en files-used mucho antes de ese límite. Por maxdir-size, la orientación de aumento de aproximadamente 2 % en "¿Qué ocurre cuando se supera maxdir-size?" indica cómo elevar el límite, no un margen operativo universal.
Calcular la capacidad de metadatos
Calcula por separado los metadatos de nodo de información-archivo, directorio-archivo, índice, Snapshot y agregado. Usa 288 bytes por cada nodo de información público asignado como estimación base para el nodo de información-archivo; consulta "Repercusión en la capacidad". Aumentar files no asigna ese espacio de inmediato. Considera persistente la capacidad máxima asignada al nodo de información-archivo.
Utiliza volume show-space para comprobar la capacidad de nodo de información y metadatos en lugar de convertir cada contador de la CLI como si fuera un valor en bytes.
Utiliza ejemplos realistas de nombres de archivo
Comprueba como mínimo:
-
Nombres cortos que solo contienen caracteres ASCII
-
La mediana y el percentil superior de la longitud de los nombres de archivo de la carga de trabajo
-
Caracteres no ASCII o Unicode complementarios cuando se utilizan
-
Cargas de trabajo de SMB que generan alias DOS 8.3
-
Acceso multiprotocolo que puede requerir nombres alternativos
-
Ubicación de FlexGroup representativa de la producción
La longitud de la ruta y la longitud del nombre base no son intercambiables. Una ruta larga repartida entre varios directorios afecta a los límites del protocolo y al recuento de nodos de información, mientras que cada directorio solo almacena su componente inmediato.
Prueba las operaciones de metadatos, no solo el rendimiento
Las pruebas de ancho de banda secuencial no permiten predecir el comportamiento con un gran número de archivos. Incluye:
-
Creación de archivos y directorios
-
Búsqueda de nombres existentes y de nombres que faltan
-
statu operaciones con atributos -
Abrir y cerrar
-
Cambiar el nombre dentro de un directorio y entre directorios
-
Desvinculación y eliminación recursiva
-
Enumeración completa y parcial de directorios
-
Búsquedas con comodines
-
Pruebas con caché fría y con caché caliente
-
Acceso mixto a NFS y SMB cuando proceda
Mide las distribuciones de latencia, la CPU, el comportamiento de la caché, la carga de red y el tiempo de finalización. Repite las pruebas durante Snapshot, la replicación, el análisis, la copia de seguridad y el escaneo de seguridad si esas operaciones coexisten en producción.
Validar las operaciones del ciclo de vida
Realiza pruebas más allá de la importación inicial:
-
Ampliación hasta el número máximo previsto
-
Eliminación masiva y eliminación asíncrona
-
Copia de seguridad y restauración
-
Inicialización, actualización, conmutación por error y resincronización de SnapMirror
-
Flujos de trabajo que hacen un uso intensivo de clones o instantáneas
-
Movimiento de volumen o conmutación por error del almacenamiento
-
Actualización de ONTAP y, cuando sea necesario, comprobaciones de reversión
-
Migración de FlexVol a FlexGroup o entre entornos de protocolo
Es posible que sea necesario crear o transferir los índices de directorio en el destino. Habilita la transferencia de índices públicos solo cuando evitar la reconstrucción mejore sustancialmente la recuperación; no mejora la búsqueda local. Consulta "Cuándo habilitar las transferencias de índices de directorios públicos".
Supervisa los límites y la asignación de nodos de información
Haz un seguimiento de files-used con respecto a files y inodefile-public-capacity como se describe en "Supervisa maxfiles, los eventos EMS y las mejoras de ONTAP". Activa una alerta antes de que files-used alcance files. Para los volúmenes FlexGroup, analiza los eventos a nivel de componente incluso cuando el total general parezca tener margen.
Supervisa directorios grandes
Mide el tamaño de directorios y archivos y resuelve los identificadores de archivo de EMS tal como se describe en "Ver maxdir-size y el tamaño del directorio actual". Haz un inventario de los directorios conocidos planos o con mucha rotación antes de que generen avisos.
Actúa ante las advertencias antes de que se produzcan fallos
Para las advertencias sobre nodos de información:
-
Comprueba
files-used,files,files-maximum-possible, el tamaño del volumen y la capacidad. -
Determina si se espera crecimiento o si se trata de una anomalía.
-
Aumenta
files, amplía el volumen o elimina los objetos innecesarios según corresponda. -
En FlexGroup, comprueba el equilibrio de colocación y el componente afectado.
Para las advertencias sobre el tamaño de los directorios:
-
Resuelve el nodo de información del directorio en una ruta.
-
Mide el tamaño actual del archivo de directorio y analiza el comportamiento de los nombres de archivo.
-
Detén el crecimiento descontrolado de los directorios planos.
-
Si es posible, divide o migra los nombres a nuevos directorios.
-
Aumenta
maxdir-sizesolo cuando no sea posible reestructurar la aplicación y entiendas el riesgo para el rendimiento.
No esperes a que aparezcan callhome.no.inodes o wafl.dir.size.max; en ese momento la creación de clientes ya está fallando.
Gestiona el comportamiento de eliminación
Al eliminar archivos, liberas nodos de información públicos para reutilizarlos, pero no se reduce el tamaño del archivo de nodos de información públicos. Del mismo modo, al eliminar nombres de un directorio, las ranuras del directorio quedan disponibles para reutilizarlas, pero normalmente no se reduce el tamaño máximo alcanzado del archivo de directorio.
Las eliminaciones grandes pueden consumir muchos metadatos y aumentar temporalmente los nodos de información zombi privados. Limita la velocidad de las eliminaciones recursivas del lado del cliente (rm -rf) cuando compiten con el tráfico de producción.
A partir de ONTAP 9.8, la función « volume file async-delete» elimina un directorio del clúster en lugar de hacerlo a través de NFS o SMB, lo que evita la contención en los clientes y en la red. Se aplica a los volúmenes FlexVol y FlexGroup. ONTAP analiza la ruta, elimina primero el contenido de los subdirectorios y ejecuta tareas de eliminación en paralelo (de forma predeterminada, 5000 tareas simultáneas; configurable entre 50 y 100000). En las pruebas de TR-4571, esto fue unas 10 veces más rápido que una operación « rm -rf» de un solo hilo en un árbol de 24000 entradas.
volume file async-delete start -vserver <svm> -volume <volume> -path /relative/dir
volume file async-delete show
Restricciones: el volumen debe estar en línea y montado, la ruta debe ser un directorio (no un único archivo) y solo puede ejecutarse una tarea de eliminación asíncrona a la vez.
Si un directorio grande y disperso sigue siendo un problema, copia las entradas restantes en un directorio nuevo. Reducir maxdir-size no lo compacta. Consulta "Directorios dispersos y perforación de agujeros".
Planifica el nodo y el margen de HA
Las operaciones con un gran número de archivos consumen CPU, memoria, caché y E/S de almacenamiento, incluso cuando el rendimiento de datos es bajo. Mantén un margen de capacidad para:
-
Ráfagas de metadatos
-
Búsqueda y enumeración con caché fría
-
Escáneres y protección de datos
-
Conmutación por error o toma de control del almacenamiento
-
Operaciones remotas de FlexGroup
-
Otros volúmenes que comparten el nodo
Equilibra las cargas de trabajo basándote en la demanda de metadatos observada, no solo en la capacidad o el rendimiento. Un nodo puede verse limitado por los metadatos aunque el ancho de banda de la red y del disco parezca estar disponible.
Distribuye las conexiones de los clientes entre los LIF de datos y los nodos
Los NAS con un gran número de archivos suelen verse limitados por los metadatos. Un montaje NFS o SMB suele utilizar una conexión TCP a un LIF de datos, y ese LIF reside en un único nodo. Si muchos clientes, escáneres o tareas de copia de seguridad montan la misma dirección, ese nodo dedica recursos de CPU al procesamiento del protocolo incluso cuando el resto del clúster está inactivo. Un FlexGroup puede redirigir las operaciones de archivos a través de la red del clúster, pero eso no elimina la carga del nodo que aloja la conexión del cliente.
-
Crea varias LIF de datos (interfaces de red de datos) en la SVM, con más de una LIF en cada nodo que atiende la carga de trabajo, de modo que los clientes dispongan de varias rutas de acceso a cada nodo.
-
Comprueba que cada nodo que deba participar tenga al menos un LIF de datos en ese SVM.
-
Equilibra los montajes entre esos LIF y nodos. Cuando montes por IP, elige las direcciones de forma equitativa. Cuando los clientes monten por nombre, presenta varias direcciones LIF detrás de un único FQDN y usa el equilibrio de carga de DNS.
-
No concentres toda la carga de trabajo en un único LIF o en un único nodo.
Un único cliente que admita NFS nconnect o SMB multicanal puede abrir conexiones adicionales en un mismo montaje. Eso ayuda a ese cliente; no sustituye distribuir muchos clientes entre LIF y nodos.
Utiliza las versiones actuales de ONTAP
Las versiones posteriores de ONTAP incluyen indexación de directorios, mejoras en la gestión de nodos de información, optimizaciones de directorios dispersos, transferencia de índices de directorios y otras mejoras relacionadas con un elevado número de archivos. Al decidir sobre las actualizaciones, todavía debes tener en cuenta la compatibilidad con la plataforma, la compatibilidad con la protección de datos y la homologación de las aplicaciones.
No actives una función únicamente porque esté relacionada con un gran número de archivos:
-
Genéralo
maxdir-sizesolo si se ha demostrado que hace falta un único directorio. -
Establece
filesen el máximo actual cuando sea adecuado; consulta "Control de «maxfiles»". -
Habilita la transferencia de índices de directorio únicamente cuando la replicación o la restauración deban conservar los índices.
-
Activa File System Analytics solo cuando la información que aporta justifique su trabajo de análisis.
-
Trata
-has-dir-index-publicy-has-optimized-sparse-directoriescomo indicadores de estado, no como opciones de activación.
A partir de ONTAP 9.17.1, File System Analytics se puede habilitar de forma predeterminada en los nuevos volúmenes de una SVM NAS recién creada. Compruébalo -analytics-state en lugar de dar por hecho que está deshabilitado y ten en cuenta su análisis del espacio de nombres a la hora de evaluar una carga de trabajo con un elevado número de archivos.
Documenta los supuestos y los umbrales
Registro:
-
Supuestos sobre la carga de trabajo y los nombres de archivo
-
Número máximo de archivos y directorios
-
Márgenes seleccionados
-
Volumen y distribución de componentes
-
Disposición de Data LIF y del montaje del cliente
-
filesymaxdir-sizevalores -
Umbrales de alerta y responsables de la respuesta
-
Tasas previstas de ingesta y eliminación
-
Objetivos de recuperación y migración
-
Dependencias de la versión y la plataforma de ONTAP
Revisa el modelo cuando cambien las versiones de las aplicaciones, los formatos de nombre de archivo, la retención, los protocolos o los flujos de trabajo de protección de datos.