3. Aperçu de l’architecture

 Suggérer des modifications

 PDF

Karthikeyan Nagalingam, NetApp
Cette section présente le flux de travail logique, les interactions entre les composants, le déploiement physique et la traçabilité des données du pipeline d’IA validé. Ensemble, les diagrammes montrent comment Apache Airflow orchestre le déplacement des données de StorageGRID via ONTAP NAS, utilise éventuellement NetApp XCP pour placer les données sur ONTAP S3 ou LustreFS pour l’exécution du modèle, et renvoie les résultats gouvernés vers le stockage d’archivage StorageGRID.
[[3-1-high-level-three-tier-ai-storage-architecture]]
== 3.1 Architecture de stockage IA à trois niveaux
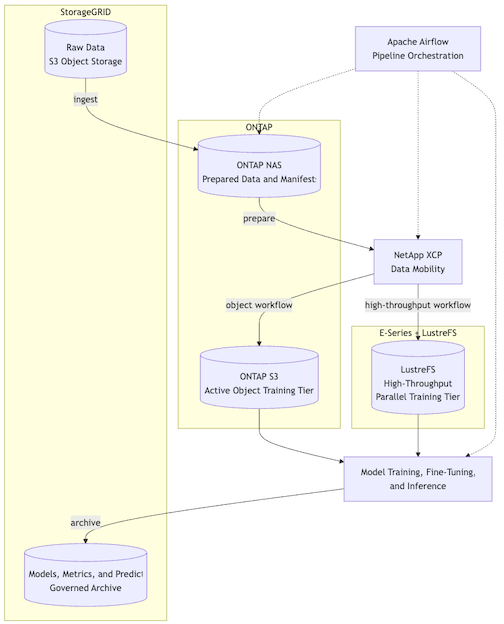
L'architecture de stockage IA de NetApp place les données sur le niveau de stockage qui correspond le mieux à chaque phase du cycle de vie. StorageGRID est utilisé pour l'ingestion évolutive de données brutes optimisée en termes de coûts et l'archivage régi. ONTAP NAS et ONTAP S3 sont utilisés pour les workflows actifs de préparation, de staging de mobilité des données et d'entraînement basé sur des objets. E-Series avec LustreFS est utilisé lorsque des E/S d'entraînement parallèles à haut débit sont requises. Apache Airflow orchestre le cycle de vie, tandis que NetApp XCP déplace les données préparées du niveau ONTAP NAS vers le niveau d'entraînement actif sélectionné.
[[3-2-high-level-solution-architecture]]
== 3.2 Architecture de la solution de haut niveau
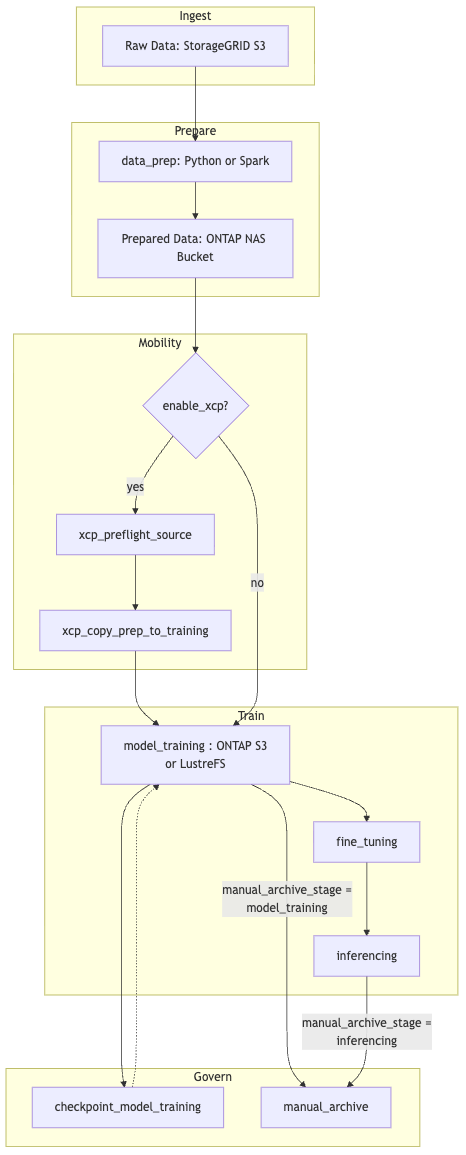
Ce diagramme de flux de travail illustre le cycle de vie contrôlé par Airflow, depuis les données brutes de StorageGRID jusqu’à l’archivage, en passant par la préparation, la mobilité des données XCP en option, l’exécution du modèle, la création de points de contrôle et l’archivage. enable_xcp détermine si les données préparées sont copiées du compartiment NAS ONTAP vers ONTAP S3 ou LustreFS avant l’entraînement. Les branches d’archivage sont indépendantes : manual_archive_stage=model_training archive la base de référence immédiatement après l’entraînement, tandis que manual_archive_stage=inferencing archive le résultat complet après la génération des prédictions.
[[3-3-component-interaction-diagram]]
== 3.3 Diagramme d'interaction des composants
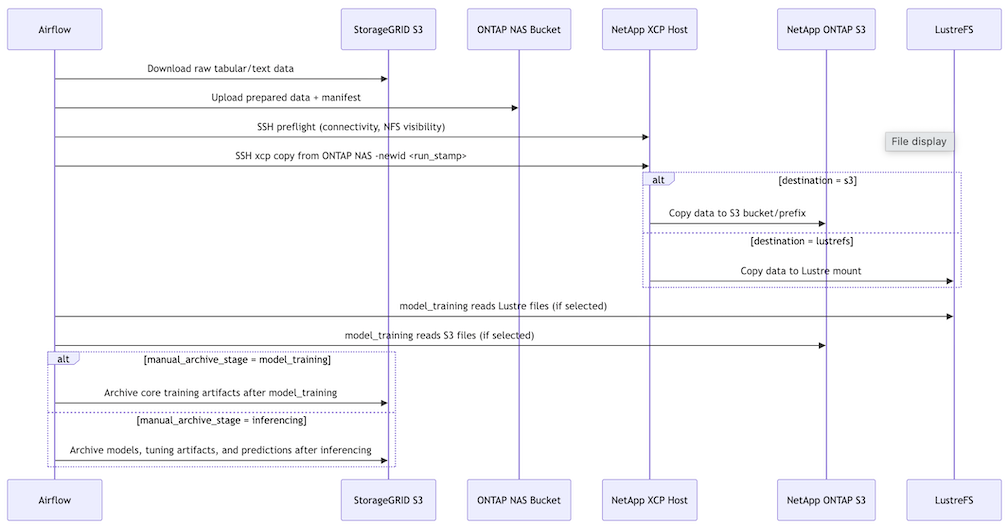
Ce diagramme de séquence indique quel composant de la plateforme effectue chaque échange. Airflow lit les objets bruts depuis StorageGRID et écrit les données préparées dans le bucket NAS ONTAP ; il invoque ensuite XCP via SSH. XCP lit l’exportation NFS du NAS ONTAP et écrit dans le niveau d’entraînement configuré. Le dernier bloc conditionnel montre que le contenu archivé de StorageGRID dépend de l’étape d’archivage manuel sélectionnée.
[[3-4-physical-deployment-architecture]]
== 3.4 Architecture physique / de déploiement
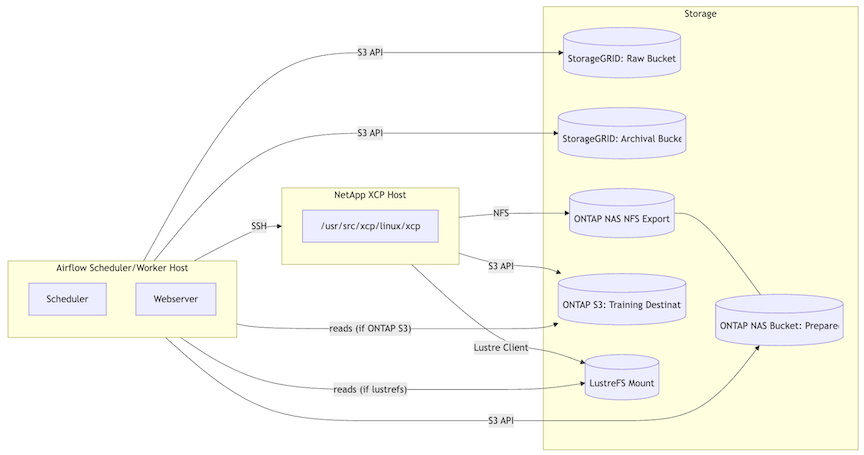
Ce schéma de déploiement présente les hôtes, les points de terminaison de stockage et les interfaces réseau requis. L'hôte Airflow utilise les API S3 pour StorageGRID, le compartiment NAS ONTAP et la destination S3 ONTAP sélectionnée, et utilise SSH pour contrôler l'hôte XCP. L'hôte XCP accède à la source de données préparées via NFS et écrit soit dans ONTAP S3, soit sur le point de montage LustreFS ; lorsque LustreFS est sélectionné, l'hôte Airflow doit également le monter pour lire les données d'entraînement et matérialiser les artefacts.
[[3-5-data-flow-overview]]
== 3.5 Aperçu du flux de données
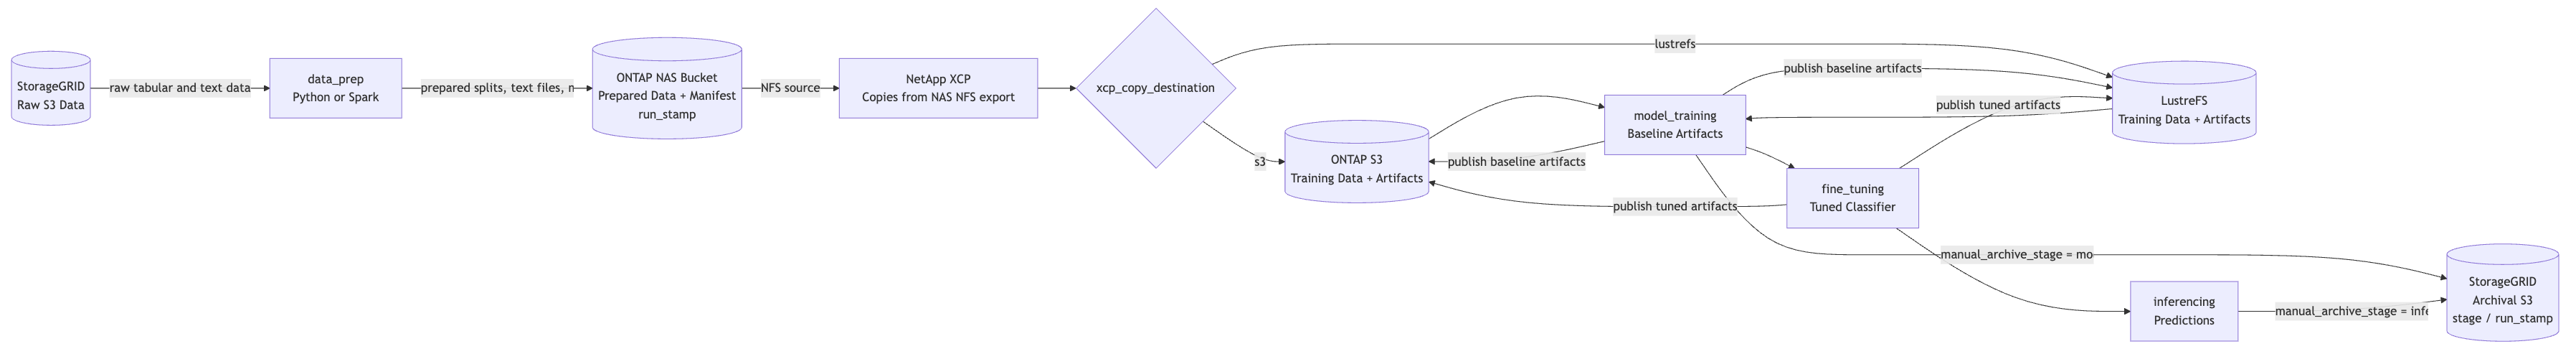
Ce flux compact résume la provenance des données et des artefacts. Chaque exécution reçoit un identifiant unique run_stamp, qui permet de rattacher les données préparées, la sortie XCP, les artefacts du modèle, les prédictions et les objets archivés à la même exécution. La sélection de la destination XCP détermine le niveau des données d'entraînement et des artefacts du modèle, tandis que `manual_archive_stage`détermine si StorageGRID reçoit le package d'entraînement de base ou le package d'inférence complet.