


5. Conception de la solution et détail de l'architecture de stockage

 Suggérer des modifications

 PDF

Karthikeyan Nagalingam, NetApp
[[5-1-design-principles]]
== 5.1 Principes de conception
Configuration plutôt que modifications du code ; limites d’étape explicites avec contrats typés ; routage cohérent des artefacts ; validation rapide avec erreurs exploitables ; neutralité de la couche de stockage.
[[5-2-stage-design-summary]]
== 5.2 Résumé de la conception des étapes
| Étape | Résumé de la conception |
|---|---|
Ingestion |
|
Préparation des données |
Découvre/accepte les clés tabulaires brutes de StorageGRID ; normalise Airbyte/CSV brut ; produit des répartitions déterministes entraînement/validation/inférence ; écrit un préfixe prepared-data horodaté d’exécution et un manifeste dans le bucket NAS ONTAP |
Mobilité des données (XCP) |
Copie les données préparées à partir de l’exportation NFS NAS ONTAP |
Formation de modèle |
S'entraîne localement ou à partir d'une destination XCP (S3/LustreFS) ; découverte multiformat (CSV/Parquet/JSON) |
Ajustement fin |
Matérialise le modèle de base à partir de la destination XCP |
Inférence |
Matérialise des artefacts optimisés à partir de la même destination XCP ; portée du fractionnement/du texte configurable |
Point de contrôle/Reprise |
|
Archivage |
|
[[5-3-configuration-driven-philosophy]]
== 5.3 Philosophie axée sur la configuration
Tous les choix relatifs au stockage non secret, au moteur et au comportement sont dag_run.conf des paramètres — le passage de S3 à LustreFS, ou de Python à Spark, ne nécessite aucune modification du code, tandis que le stockage des secrets géré par Airflow fournit les informations d’identification requises.
[[5-4-storage-architecture-detail]]
== 5.4 Détails de l'architecture de stockage
L'architecture de stockage sépare le cycle de vie de l'IA en niveaux spécialement conçus à cet effet : StorageGRID stocke les objets bruts et d'archive, le bucket NAS ONTAP contient les jeux de données préparés et horodatés par exécution, et ONTAP S3 ou LustreFS fournit le niveau actif d'entraînement sélectionné. Cette séparation permet de gérer indépendamment les données sources, les données préparées, les artefacts de modèle et les preuves archivées, tout en préservant leur traçabilité grâce au run_stamp partagé.
[[5-4-1-storage-layout-diagrams]]
=== 5.4.1 Schémas de disposition du stockage
| Étage | Chemin de stockage logique | Contenu / Artefacts stockés |
|---|---|---|
Tier brut StorageGRID |
|
Parties CSV tabulaires ( |
Niveau préparé ONTAP NAS |
|
Scissions formatées ( |
Niveau de formation actif (XCP Dest) |
|
Copies des données divisées, binaires du modèle entraîné ( |
Niveau d’archivage StorageGRID |
|
Artefacts du modèle de base ou complet à l'échelle de l'étape, preuves de prédiction ( |
Lignée et flux entre les niveaux |
Brut → Préparé → Niveau actif → Niveau d’archivage |
Déplacement des données de bout en bout et traçabilité des artefacts liées à tous les niveaux de stockage via le partagé |
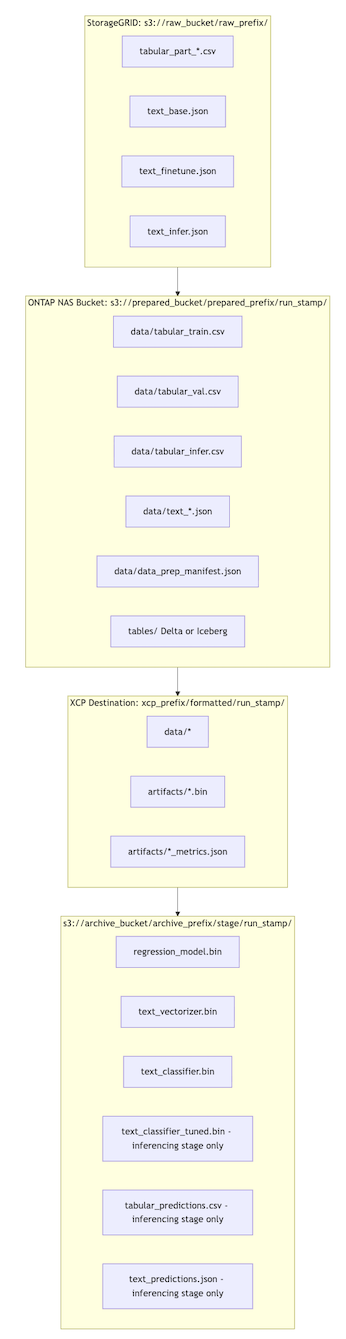
Ce diagramme illustre la disposition logique des compartiments et des préfixes pour une seule exécution de pipeline sur tous les niveaux de stockage :
[[5-4-2-storage-sizing-guidance]]
=== 5.4.2 Conseils de dimensionnement du stockage
Dimensionnez chaque niveau indépendamment en fonction de son rôle et de sa politique de conservation. ONTAP NAS et la destination XCP sélectionnée doivent pouvoir prendre en charge des exécutions actives simultanées, tandis que la capacité de StorageGRID est principalement déterminée par la conservation des données brutes et des archives. Prévoyez une capacité de travail temporaire et une marge de croissance lors de la planification de la simultanéité maximale du pipeline.
| Étage | Base de dimensionnement |
|---|---|
bucket brut StorageGRID |
Volume d’ingestion × fenêtre de rétention |
Compartiment de données préparées ONTAP NAS |
Taille du jeu de données préparé × nombre d'exécutions conservées |
Destination XCP (S3 ou Lustre) |
Taille maximale de l'ensemble de données d'entraînement simultané + surcharge liée à l'artefact du modèle |
compartiment d'archivage |
Politique de rétention × sélection de l’étape d’archivage (model_training = plus petit ; inferencing = plus grand) |
[[5-4-3-storage-performance-considerations]]
=== 5.4.3 Considérations relatives aux performances du stockage
La destination XCP est sélectionnée pour chaque exécution xcp_copy_destination, ce qui permet d’adapter les performances de stockage à la charge de travail au lieu de forcer chaque charge de travail sur un seul niveau. Sélectionnez LustreFS pour les ensembles de données comportant un grand nombre de lignes, de nombreux lecteurs simultanés ou des entraînements nécessitant de nombreuses E/S. Sélectionnez ONTAP S3 pour les charges de travail à accès élastique soucieuses des coûts dont les exigences de performance ne nécessitent pas un système de fichiers parallèle. Dans les deux cas, XCP maintient les données et les artefacts de modèle alignés sur le niveau d’entraînement sélectionné.