3. Panoramica dell'architettura

 Suggerisci modifiche

 PDF

Karthikeyan Nagalingam, NetApp
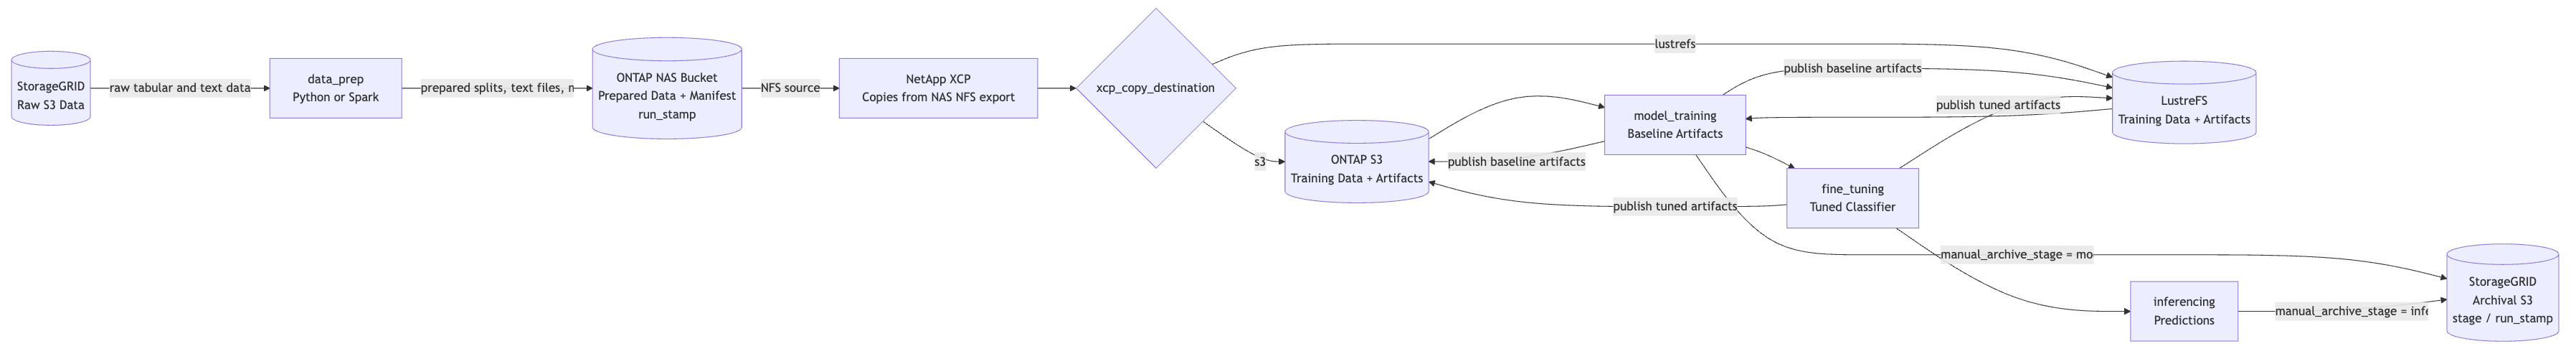
Questa sezione presenta il flusso di lavoro logico, le interazioni tra i componenti, l'implementazione fisica e la provenienza dei dati per la pipeline AI convalidata. Nel complesso, i diagrammi mostrano come Apache Airflow orchestra lo spostamento dei dati da StorageGRID tramite ONTAP NAS, utilizza facoltativamente NetApp XCP per posizionare i dati su ONTAP S3 o LustreFS per l'esecuzione del modello e restituisce i risultati gestiti all'archivio StorageGRID.
[[3-1-high-level-three-tier-ai-storage-architecture]]
== 3.1 Architettura di storage AI a tre livelli di alto livello
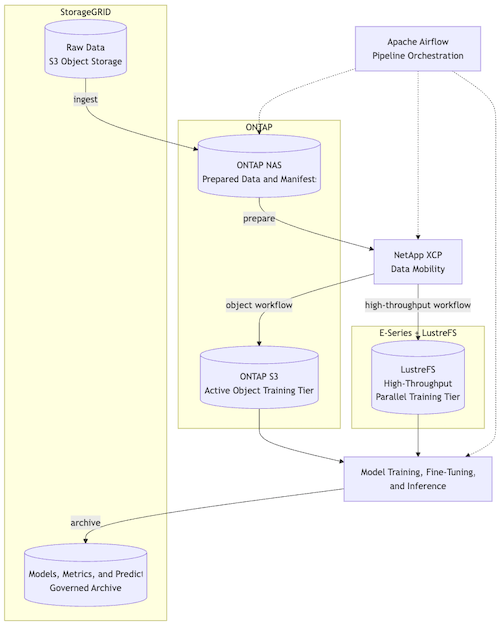
L'architettura di storage AI di NetApp colloca i dati sul tier di storage più adatto a ogni fase del ciclo di vita. StorageGRID viene utilizzato per l'acquisizione scalabile e ottimizzata in termini di costi dei dati raw e per l'archiviazione controllata. ONTAP NAS e ONTAP S3 vengono utilizzati per i flussi di lavoro attivi di preparazione, staging della mobilità dei dati e training basato su oggetti. E-Series con LustreFS viene utilizzato quando è richiesto un I/O di training parallelo a throughput elevato. Apache Airflow orchestra il ciclo di vita, mentre NetApp XCP sposta i dati preparati dal tier ONTAP NAS al tier di training attivo selezionato.
[[3-2-high-level-solution-architecture]]
== 3.2 Architettura della soluzione di alto livello
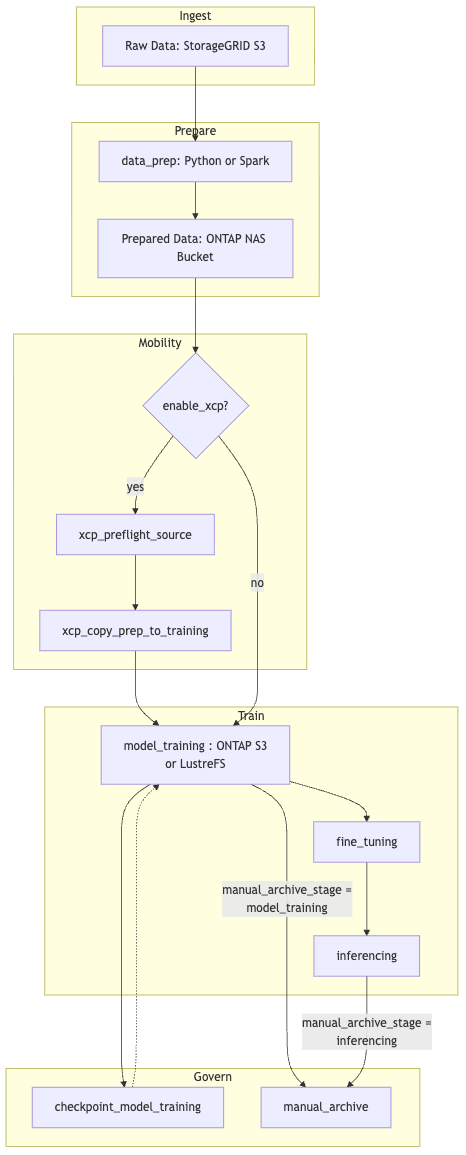
Questo diagramma di flusso mostra il ciclo di vita controllato da Airflow, dai dati raw di StorageGRID fino alla preparazione, alla mobilità XCP opzionale, all'esecuzione del modello, al checkpointing e all'archiviazione. enable_xcp determina se i dati preparati vengono copiati dal bucket NAS di ONTAP a ONTAP S3 o LustreFS prima dell'addestramento. I rami di archiviazione sono indipendenti: manual_archive_stage=model_training archivia la baseline immediatamente dopo l'addestramento, mentre manual_archive_stage=inferencing archivia il risultato completo dopo la generazione delle previsioni.
[[3-3-component-interaction-diagram]]
== 3.3 Diagramma di interazione dei componenti
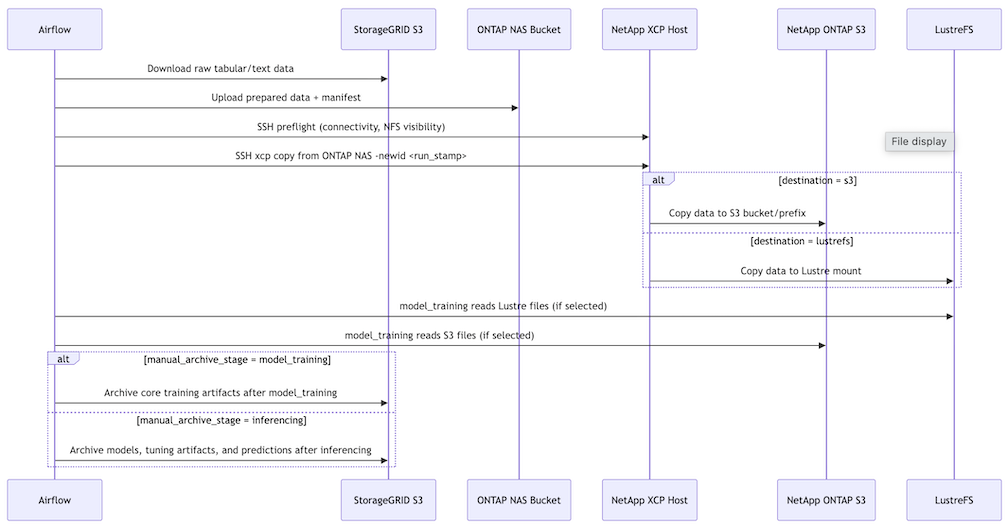
Questo diagramma di sequenza identifica quale componente della piattaforma esegue ogni scambio. Airflow legge oggetti raw da StorageGRID e scrive i dati preparati nel bucket NAS ONTAP; quindi richiama XCP tramite SSH. XCP legge l'esportazione NFS del NAS ONTAP e scrive nel tier di training configurato. Il blocco condizionale finale mostra che il contenuto di archiviazione di StorageGRID dipende dalla fase di archiviazione manuale selezionata.
[[3-4-physical-deployment-architecture]]
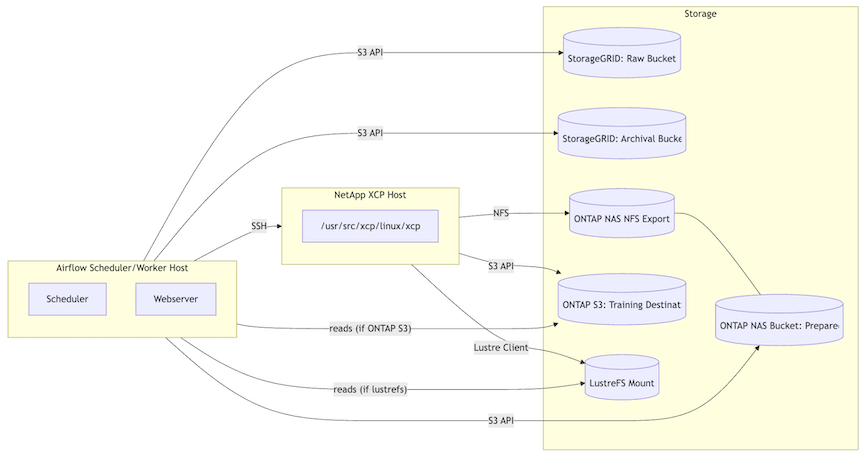
== 3.4 Architettura fisica/di implementazione
Questo diagramma di distribuzione mostra gli host, gli endpoint di storage e le interfacce di rete necessari. L'host Airflow utilizza le API S3 per StorageGRID, il bucket NAS ONTAP e la destinazione S3 ONTAP selezionata, e utilizza SSH per controllare l'host XCP. L'host XCP accede all'origine dei dati preparati tramite NFS e scrive su ONTAP S3 o sul mount LustreFS; quando viene selezionato LustreFS, anche l'host Airflow deve montarlo per leggere i dati di training e materializzare gli artefatti.
[[3-5-data-flow-overview]]
== 3.5 Panoramica del flusso di dati
Questo flusso compatto riassume la provenienza dei dati e degli artefatti. Ogni esecuzione riceve un identificativo univoco run_stamp, che mantiene tracciabili alla stessa esecuzione i dati preparati, l'output XCP, gli artefatti del modello, le previsioni e gli oggetti archiviati. La selezione della destinazione XCP governa il tier di storage dei dati di addestramento e degli artefatti del modello, mentre manual_archive_stage determina se StorageGRID riceve il pacchetto di addestramento di base o il pacchetto di inferenza completo.