


5.解決策設計およびストレージ アーキテクチャの詳細

 変更を提案

 PDF

カーティケヤン ナガリンガム、NetApp
[[5-1-design-principles]]
== 5.1 設計原則
コード変更に対する設定;型付き契約による明確なステージ境界;一貫性のあるアーティファクトルーティング;実行可能なエラーを伴うフェイルファスト検証;ストレージ層への非依存性。
[[5-2-stage-design-summary]]
== 5.2 ステージデザインの概要
| 段階 | 設計概要 |
|---|---|
取り込み |
|
データ準備 |
生の StorageGRID 表形式キーを検出/受け入れ、Airbyte/プレーン CSV を正規化し、決定論的な train/val/infer 分割を生成して、実行スタンプ付きの prepared-data プレフィックスとマニフェストを ONTAP NAS バケットに書き込みます。 |
データモビリティ(XCP) |
ONTAP NAS NFSエクスポートから準備されたデータをコピーし、 `xcp_copy_destination`XCPターゲットとトレーニング読み取りパスを駆動します |
モデルトレーニング |
ローカルまたはXCP宛先(S3/LustreFS)からトレーニング;マルチフォーマット(CSV/Parquet/JSON)検出 |
微調整 |
XCP宛先から基本モデルをマテリアライズし、 `partial_fit`拡張されたクラスセットで調整済みモデルを再公開します。 |
推論 |
同じ XCP 宛先から調整済みのアーティファクトを具体化します。設定可能な分割/テキスト スコープ |
チェックポイント/再開 |
`write_stage_checkpoint`完了レコードを保持します。 `_small_resume_guard`後続の実行時に検証/再利用します |
アーカイブ |
`model_training`コアとなる学習済みモデルを即座にアーカイブします。 `inferencing`予測結果を待機し、結果セット全体をアーカイブします。オプションでXCP入力の組み込みと生データフォルダのクリーンアップが可能です。 |
[[5-3-configuration-driven-philosophy]]
== 5.3 構成主導型哲学
非機密のストレージ、エンジン、および動作の選択はすべて `dag_run.conf`パラメータです。S3とLustreFSの切り替え、またはPythonとSparkの切り替えにはコードの変更は不要で、Airflowが管理するシークレットストレージが必要な認証情報を解決します。
[[5-4-storage-architecture-detail]]
== 5.4 ストレージ アーキテクチャの詳細
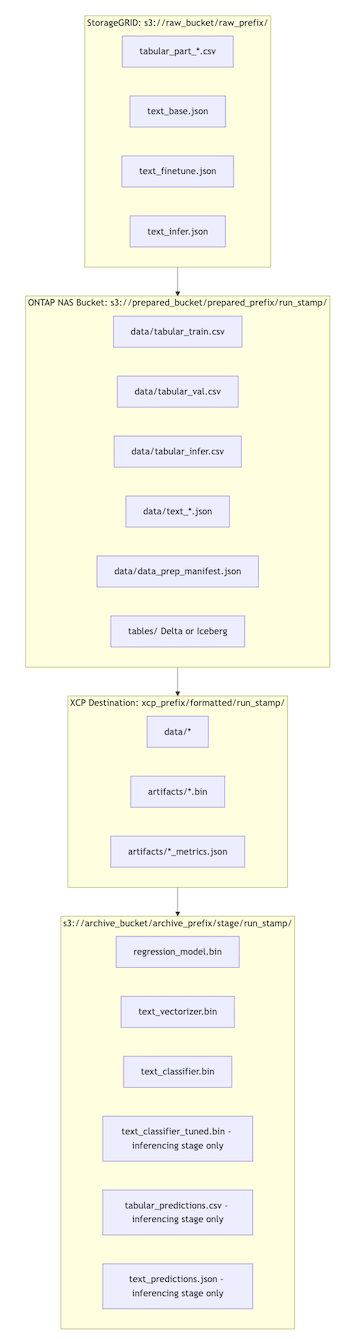
ストレージ アーキテクチャは、AIライフサイクルを目的に即した階層に分割します:StorageGRIDは生データおよびアーカイブオブジェクトを保持し、ONTAP NASバケットには準備済みおよび実行スタンプ付きのデータセットが格納され、ONTAP S3またはLustreFSが選択されたアクティブなトレーニング階層を提供します。この分離により、ソースデータ、準備済みデータ、モデル成果物、およびアーカイブされた証拠を個別に管理しながら、共有された `run_stamp`を通じてリネージを保持します。
[[5-4-1-storage-layout-diagrams]]
=== 5.4.1 ストレージレイアウト図
| 階層 | 論理ストレージパス | 保存されているコンテンツ/アーティファクト |
|---|---|---|
StorageGRID 生データ層 |
|
表形式のCSVパーツ( |
ONTAP NAS 準備済みティア |
|
フォーマットされた分割( |
アクティブトレーニングティア(XCP Dest) |
|
コピーされたデータ分割、トレーニング済みモデルバイナリ( |
StorageGRID アーカイブティア |
|
段階的ベースラインまたはフルモデルの成果物、予測の証拠( |
階層間の系譜と流れ |
生データ → 準備済みデータ → アクティブティア → アーカイブデータ |
エンドツーエンドのデータ移動とアーティファクトの系統は、共有された `run_stamp`を介してすべてのストレージ階層にわたってリンクされています。 |
この図は、すべてのストレージ階層にわたる単一のパイプライン実行における論理バケットとプレフィックスのレイアウトを示しています。
[[5-4-2-storage-sizing-guidance]]
=== 5.4.2 ストレージサイジングに関するガイダンス
各階層をそれぞれの役割と保持ポリシーに応じて個別にサイズ設定してください。ONTAP NASおよび選択した XCP 宛先は同時アクティブ実行に対応する必要がありますが、StorageGRID の容量は主に生データとアーカイブ保持によって決まります。パイプラインの同時処理ピーク時の計画には、一時的な処理容量と成長のための余裕を考慮してください。
| 階層 | サイズ基準 |
|---|---|
StorageGRID 生データバケット |
取り込み量×保持期間 |
ONTAP NAS 準備済みデータバケット |
準備済みデータセットのサイズ × 保持された実行回数 |
XCPの宛先(S3またはLustre) |
同時トレーニングデータセットのピークサイズ+モデルアーティファクトのオーバーヘッド |
アーカイブバケット |
保持ポリシー × アーカイブ段階の選択(model_training = smaller;inferencing = larger) |
[[5-4-3-storage-performance-considerations]]
=== 5.4.3 ストレージのパフォーマンスに関する考慮事項
XCPの宛先は実行ごとに `xcp_copy_destination`選択され、すべてのワークロードを単一の階層に強制的に集中させるのではなく、ストレージのパフォーマンスをワークロードに合わせて調整することが可能になります。行数の多いデータセット、多数の同時読み取り処理、またはI/O負荷の高いトレーニングには、LustreFSを選択してください。コスト効率を重視し、柔軟なアクセスを必要とするワークロードであり、パフォーマンス要件が並列ファイルシステムを必要としない場合は、ONTAP S3を選択してください。いずれの場合も、XCPはデータとモデルの成果物を、選択されたトレーニング階層に合わせて保持します。