


5. 솔루션 설계 및 스토리지 아키텍처 상세 설명

 변경 제안

 PDF

Karthikeyan Nagalingam, NetApp
[[5-1-design-principles]]
== 5.1 설계 원칙
코드 변경보다 구성 우선, 타입이 지정된 계약을 통한 명확한 단계 경계, 일관된 아티팩트 라우팅, 실행 가능한 오류를 통한 신속한 실패 검증, 스토리지 계층 중립성.
[[5-2-stage-design-summary]]
== 5.2 단계 설계 요약
| 단계 | 설계 요약 |
|---|---|
수집 |
|
데이터 준비 |
원시 StorageGRID 테이블 형식 키를 검색/수락하고, Airbyte/일반 CSV를 정규화하며, 결정론적 학습/검증/추론 분할을 생성하고, 실행 스탬프가 찍힌 준비된 데이터 접두사와 매니페스트를 ONTAP NAS 버킷에 기록합니다. |
데이터 이동성(XCP) |
ONTAP NAS NFS 내보내기에서 준비된 데이터를 복사하고, |
모델 학습 |
로컬 또는 XCP 대상(S3/LustreFS)에서 학습하며, 다양한 형식(CSV/Parquet/JSON) 검색을 지원합니다. |
미세 조정 |
XCP 대상에서 기본 모델을 구체화하고, |
추론 |
동일한 XCP 대상에서 조정된 아티팩트를 구체화합니다. 분할/텍스트 범위를 구성할 수 있습니다. |
체크포인트/재개 |
|
보관용 |
|
[[5-3-configuration-driven-philosophy]]
== 5.3 구성 중심 철학
비밀 저장소, 엔진 및 동작 선택 사항을 제외한 모든 항목은 dag_run.conf 매개변수입니다. S3와 LustreFS 또는 Python과 Spark 간 전환에는 코드 수정이 필요하지 않으며, Airflow에서 관리하는 비밀 저장소는 필요한 자격 증명을 해결합니다.
[[5-4-storage-architecture-detail]]
== 5.4 스토리지 아키텍처 세부 정보
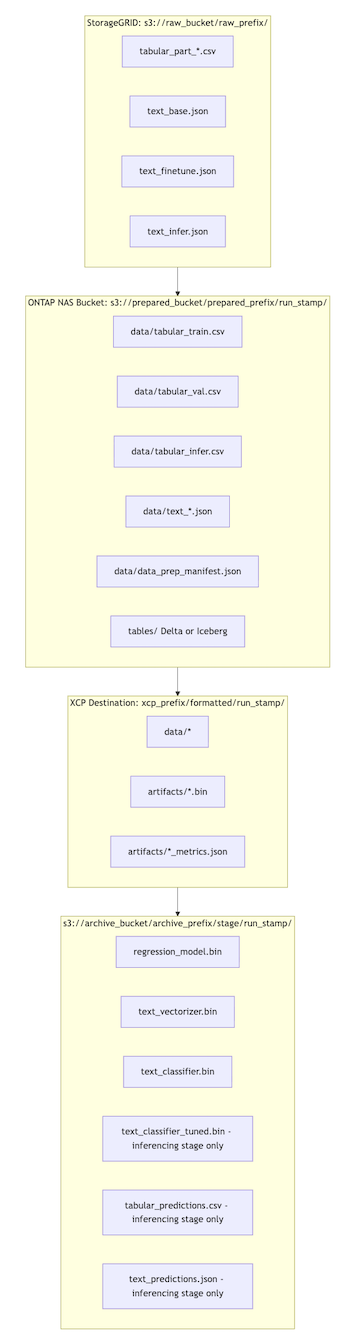
스토리지 아키텍처는 AI 라이프사이클을 목적에 맞게 설계된 계층으로 분리합니다. StorageGRID는 원시 데이터와 아카이브 객체를 저장하고, ONTAP NAS 버킷은 준비되고 실행 스탬프가 찍힌 데이터 세트를 저장하며, ONTAP S3 또는 LustreFS는 선택된 활성 학습 계층을 제공합니다. 이러한 분리를 통해 소스 데이터, 준비된 데이터, 모델 아티팩트 및 아카이브된 증거를 독립적으로 관리할 수 있으며, 공유된 `run_stamp`을 통해 데이터 계보를 보존합니다.
[[5-4-1-storage-layout-diagrams]]
=== 5.4.1 스토리지 레이아웃 다이어그램
| 층 | 논리적 저장 경로 | 저장된 내용/아티팩트 |
|---|---|---|
StorageGRID 원시 계층 |
|
표 형식 CSV 부분 ( |
ONTAP NAS Prepared Tier |
|
형식화된 분할 ( |
활성 훈련 단계(XCP Dest) |
|
복사된 데이터 분할, 학습된 모델 바이너리 ( |
StorageGRID 아카이빙 티어 |
|
단계별 기준선 또는 전체 모델 아티팩트, 예측 증거 ( |
계층 간 계보 및 흐름 |
원시 데이터 → 준비됨 → 활성 단계 → 보관됨 |
공유 `run_stamp`를 통해 모든 스토리지 계층에 걸쳐 엔드투엔드 데이터 이동 및 아티팩트 계보가 연결됩니다. |
이 다이어그램은 모든 스토리지 계층에 걸쳐 단일 파이프라인 실행에 대한 논리적 버킷 및 접두사 레이아웃을 보여줍니다.
[[5-4-2-storage-sizing-guidance]]
=== 5.4.2 스토리지 사이징 지침
각 계층의 규모는 역할 및 보존 정책에 따라 독립적으로 설정해야 합니다. ONTAP NAS와 선택한 XCP 대상은 동시 활성 실행을 수용할 수 있어야 하며, StorageGRID 용량은 주로 원시 데이터 및 아카이브 보존에 따라 결정됩니다. 파이프라인 최대 동시 실행을 계획할 때 임시 작업 용량과 향후 확장을 위한 여유 공간을 포함해야 합니다.
| 층 | 크기 기준 |
|---|---|
StorageGRID 원시 버킷 |
수집 볼륨 × 보존 기간 |
ONTAP NAS 준비된 데이터 버킷 |
준비된 데이터셋 크기 × 유지된 실행 횟수 |
XCP 대상(S3 또는 Lustre) |
최대 동시 학습 데이터셋 크기 + 모델 아티팩트 오버헤드 |
보관용 버킷 |
보존 정책 × 아카이브 단계 선택 (model_training = 더 작음; inferencing = 더 큼) |
[[5-4-3-storage-performance-considerations]]
=== 5.4.3 스토리지 성능 고려 사항
XCP 대상은 `xcp_copy_destination`을 사용하여 실행 시마다 선택되므로 모든 워크로드를 하나의 계층에 강제로 배치하는 대신 워크로드에 맞춰 스토리지 성능을 조정할 수 있습니다. 행 수가 많은 데이터 세트, 동시 읽기 작업이 많은 경우 또는 I/O 집약적인 학습에는 LustreFS를 선택하십시오. 병렬 파일 시스템이 필요하지 않은 비용 효율적이고 탄력적인 액세스 워크로드에는 ONTAP S3를 선택하십시오. 어느 경우든 XCP는 선택한 학습 계층에 맞춰 데이터와 모델 아티팩트를 정렬된 상태로 유지합니다.