3. Visão geral da arquitetura

 Sugerir alterações

 PDFs

Karthikeyan Nagalingam, NetApp
Esta seção apresenta o fluxo de trabalho lógico, as interações entre os componentes, a implantação física e a linhagem de dados para o pipeline de IA validado. Em conjunto, os diagramas mostram como o Apache Airflow orquestra a movimentação de dados do StorageGRID por meio do ONTAP NAS, utiliza opcionalmente o NetApp XCP para colocar dados no ONTAP S3 ou LustreFS para execução do modelo e retorna os resultados controlados ao armazenamento de arquivamento do StorageGRID.
[[3-1-high-level-three-tier-ai-storage-architecture]]
== 3.1 Arquitetura de storage de IA de três camadas de alto nível
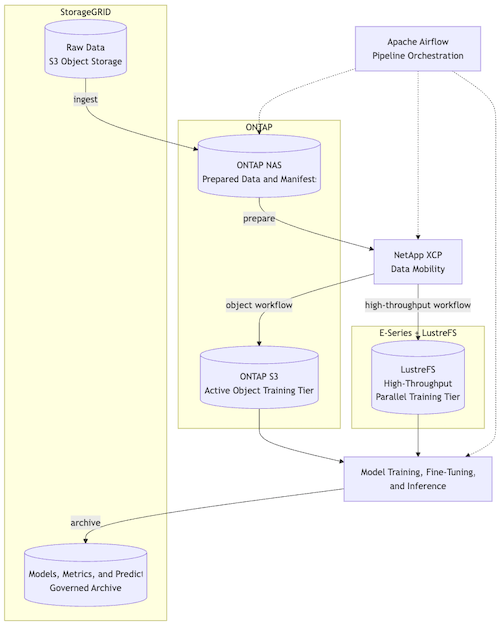
A arquitetura de storage da NetApp coloca os dados na camada de storage que melhor corresponde a cada fase do ciclo de vida. O StorageGRID é usado para ingestão escalável de dados brutos com custo otimizado e arquivamento controlado. O ONTAP NAS e o ONTAP S3 são usados como os fluxos de trabalho ativos de preparação, preparação para mobilidade de dados e treinamento baseado em objetos. O E-Series com LustreFS é usado quando é necessária E/S de treinamento paralela de alta taxa de transferência. O Apache Airflow orquestra o ciclo de vida, enquanto o NetApp XCP move os dados preparados da camada do ONTAP NAS para a camada de treinamento ativa selecionada.
[[3-2-high-level-solution-architecture]]
== 3.2 Arquitetura de solução de alto nível
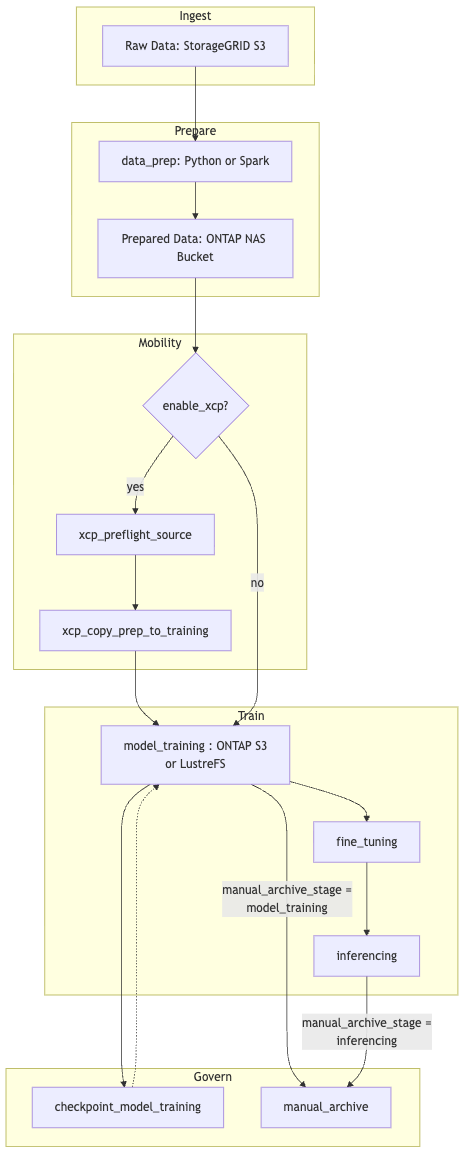
Este diagrama de fluxo de trabalho mostra o ciclo de vida controlado pelo Airflow, desde os dados brutos do StorageGRID até a preparação, a mobilidade XCP opcional, a execução do modelo, o checkpoint e o arquivamento. enable_xcp determina se os dados preparados são copiados do bucket NAS do ONTAP para o ONTAP S3 ou o LustreFS antes do treinamento. Os ramos de arquivamento são independentes: manual_archive_stage=model_training arquiva a linha de base imediatamente após o treinamento, enquanto manual_archive_stage=inferencing arquiva o resultado completo após a geração das previsões.
[[3-3-component-interaction-diagram]]
== 3.3 Diagrama de interação de componentes
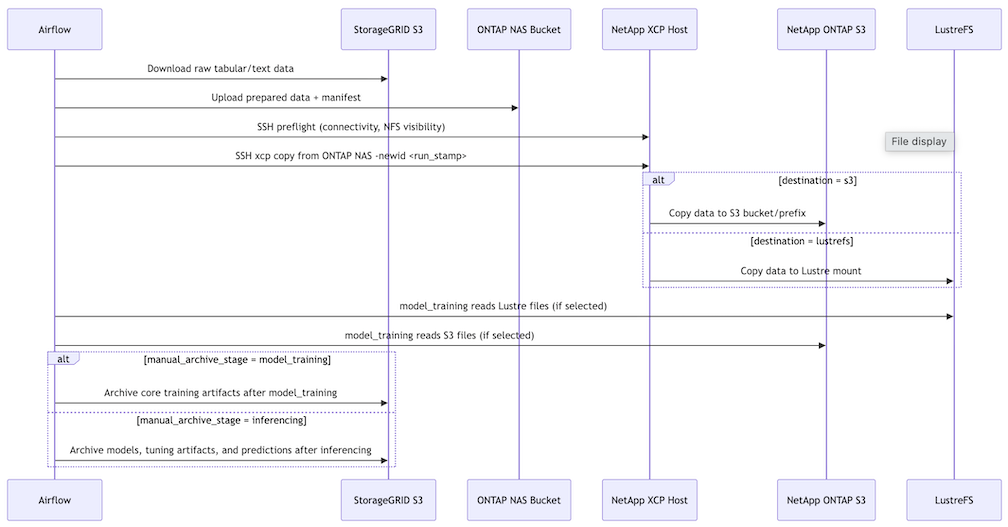
Este diagrama de sequência identifica qual componente da plataforma realiza cada troca. O Airflow lê objetos brutos do StorageGRID e grava os dados preparados no bucket NAS do ONTAP; em seguida, invoca o XCP via SSH. O XCP lê a exportação NFS do ONTAP NAS e grava na camada de treinamento configurada. O bloco condicional final mostra que o conteúdo de arquivamento do StorageGRID depende do estágio de arquivamento manual selecionado.
[[3-4-physical-deployment-architecture]]
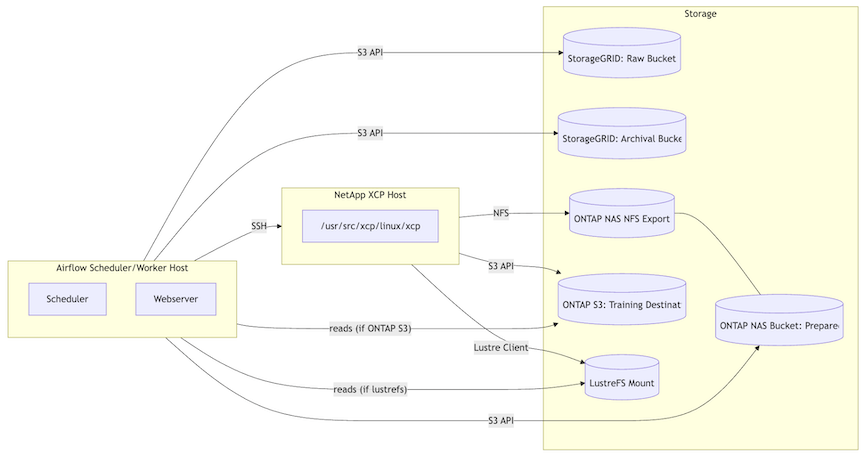
== 3.4 Arquitetura física/de implantação
Este diagrama de implantação mostra os hosts, os endpoints de storage e as interfaces de rede necessários. O host do Airflow usa APIs S3 para o StorageGRID, o bucket NAS do ONTAP e o destino S3 do ONTAP selecionado, e usa SSH para controlar o host do XCP. O host do XCP acessa a origem de dados preparados por NFS e grava no ONTAP S3 ou no ponto de montagem do LustreFS; quando o LustreFS é selecionado, o host do Airflow também deve montá-lo para ler os dados de treinamento e materializar artefatos.
[[3-5-data-flow-overview]]
== 3.5 Visão geral do fluxo de dados
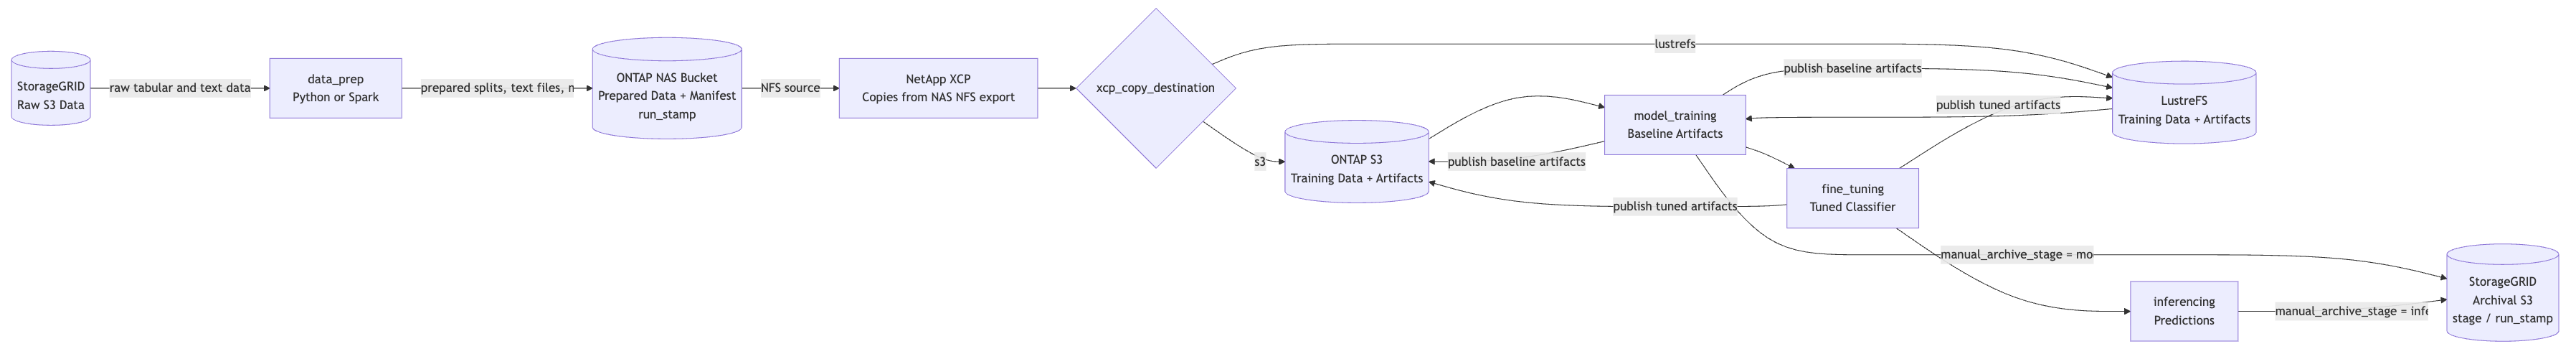
Este fluxo compacto resume a proveniência dos dados e artefatos. Cada execução recebe um identificador exclusivo run_stamp, que mantém os dados preparados, a saída do XCP, os artefatos do modelo, as previsões e os objetos arquivados rastreáveis à mesma execução. A seleção do destino do XCP controla a camada dos dados de treinamento e dos artefatos do modelo, enquanto manual_archive_stage controla se o StorageGRID recebe o pacote de treinamento básico ou o pacote de inferência completo.