


5. Detalhes do design da solução e da arquitetura de storage

 Sugerir alterações

 PDFs

Karthikeyan Nagalingam, NetApp
[[5-1-design-principles]]
== 5.1 Princípios de Projeto
Configuração em vez de alterações de código; limites de estágio explícitos com contratos tipados; roteamento consistente de artefatos; validação com falha rápida com erros acionáveis; neutralidade de camada de storage.
[[5-2-stage-design-summary]]
== 5.2 Resumo do design do estágio
| Estágio | Resumo do projeto |
|---|---|
Ingestão |
|
Preparação de dados |
Descobre/aceita chaves tabulares brutas do StorageGRID; normaliza Airbyte/CSV simples; produz divisões determinísticas de treino/validação/inferência; grava um prefixo de dados preparados com carimbo de execução e um manifesto no bucket NAS do ONTAP |
Mobilidade de dados (XCP) |
Copia os dados preparados da exportação NFS do ONTAP NAS; |
Treinamento de modelo |
Treina localmente ou a partir do destino do XCP (S3/LustreFS); descoberta em vários formatos (CSV/Parquet/JSON) |
Ajuste fino |
Materializa o modelo base do destino XCP; |
Inferência |
Materializa artefatos ajustados a partir do mesmo destino do XCP; escopo de divisão/texto configurável |
Ponto de verificação/Retomada |
|
Arquivamento |
|
[[5-3-configuration-driven-philosophy]]
== 5.3 Filosofia orientada à configuração
Todas as seleções não secretas de storage, mecanismo e comportamento são `dag_run.conf`parâmetros; alternar entre S3 e LustreFS, ou entre Python e Spark, não requer nenhuma modificação de código, enquanto o armazenamento de segredos gerenciado pelo Airflow resolve as credenciais necessárias.
[[5-4-storage-architecture-detail]]
== 5.4 Detalhes da arquitetura de storage
A arquitetura de storage separa o ciclo de vida da IA em camadas dedicadas: o StorageGRID armazena objetos de dados brutos e de arquivamento, o bucket NAS do ONTAP armazena conjuntos de dados preparados e com carimbo de execução, e o ONTAP S3 ou o LustreFS fornecem a camada de treinamento ativa selecionada. Essa separação mantém os dados de origem, os dados preparados, os artefatos do modelo e as evidências arquivadas gerenciáveis de forma independente, preservando a linhagem por meio do compartilhado run_stamp.
[[5-4-1-storage-layout-diagrams]]
=== 5.4.1 Diagramas de layout de armazenamento
| Nível | Caminho de armazenamento lógico | Conteúdo / Artefatos armazenados |
|---|---|---|
StorageGRID camada de dados brutos |
|
Partes tabulares de CSV ( |
Nível preparado para ONTAP NAS |
|
Divisões formatadas ( |
Nível de treinamento ativo (XCP Dest) |
|
Divisões de dados copiadas, binários de modelos treinados ( |
Camada de arquivamento do StorageGRID |
|
Artefatos de modelo completo ou de linha de base com escopo de estágio, evidências de previsão ( |
Linhagem e fluxo entre camadas |
Dados brutos → Preparado → Camada ativa → Arquivamento |
Movimentação de dados completamente e linhagem de artefatos vinculadas em todas as camadas de storage por meio do compartilhamento |
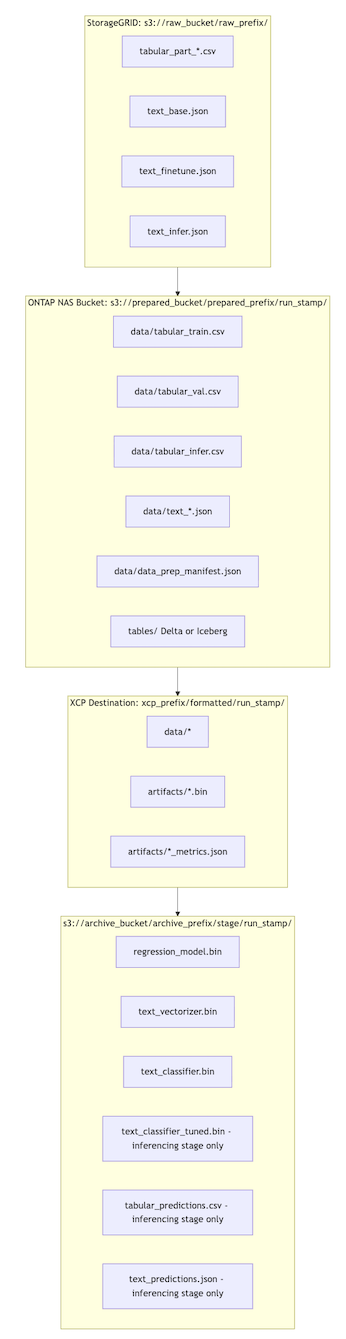
Este diagrama mapeia o layout lógico de buckets e prefixos para uma única execução de pipeline em todas as camadas de storage:
[[5-4-2-storage-sizing-guidance]]
=== 5.4.2 Orientações para dimensionamento do storage
Dimensione cada camada independentemente, de acordo com sua função e política de retenção. O ONTAP NAS e o destino XCP selecionado devem acomodar execuções ativas simultâneas, enquanto a capacidade do StorageGRID é determinada principalmente pelos dados brutos e pela retenção de arquivamento. Inclua capacidade de trabalho temporária e margem de crescimento ao planejar a simultaneidade máxima do pipeline.
| Nível | Critérios de dimensionamento |
|---|---|
Bucket bruto do StorageGRID |
Volume de ingestão × janela de retenção |
Bucket de dados preparados do ONTAP NAS |
Tamanho do conjunto de dados preparado × número de execuções retidas |
Destino do XCP (S3 ou Lustre) |
Tamanho máximo do conjunto de dados de treinamento simultâneo + sobrecarga de artefatos do modelo |
Bucket de arquivamento |
Política de retenção × seleção do estágio de arquivamento (model_training = menor; inferencing = maior) |
[[5-4-3-storage-performance-considerations]]
=== 5.4.3 Considerações sobre o desempenho do storage
O destino do XCP é selecionado por execução xcp_copy_destination, permitindo que o desempenho do armazenamento corresponda à carga de trabalho, em vez de forçar todas as cargas de trabalho para uma única camada. Selecione LustreFS para conjuntos de dados com grande número de linhas, muitos leitores simultâneos ou treinamento com uso intensivo de E/S. Selecione o ONTAP S3 para cargas de trabalho com acesso elástico e custo reduzido, cujos requisitos de desempenho não exigem um sistema de arquivos paralelo. Em ambos os casos, o XCP mantém os dados e os artefatos do modelo alinhados com a camada de treinamento selecionada.