


5.解决方案设计和存储架构详细信息

 建议更改

 PDF

Karthikeyan Nagalingam, NetApp
[[5-1-design-principles]]
== 5.1 设计原则
代码更改的配置;带有类型化合约的明确阶段边界;一致的工件路由;带有可操作错误的快速失败验证;存储层中立性。
[[5-2-stage-design-summary]]
== 5.2 阶段设计总结
| 阶段 | 设计摘要 |
|---|---|
载入 |
|
数据准备 |
发现/接受原始 StorageGRID 表格键;规范化 Airbyte/普通 CSV;生成确定性训练/验证/推断拆分;将运行标记的准备数据前缀和清单写入 ONTAP NAS 存储桶 |
数据移动性 (XCP) |
从 ONTAP NAS NFS 导出复制准备好的数据; `xcp_copy_destination`驱动 XCP 目标和训练读取路径 |
模型训练 |
本地或从 XCP 目标(S3/LustreFS)进行训练;多格式(CSV/Parquet/JSON)发现 |
微调 |
从 XCP 目标实现基本模型; `partial_fit`扩展类集;重新发布优化模型 |
推理 |
从相同 XCP 目标具体化调优后的工件;可配置的拆分/文本范围 |
检查点/恢复 |
|
存档 |
|
[[5-3-configuration-driven-philosophy]]
== 5.3 配置驱动理念
所有非秘密存储、引擎和行为选择都是 `dag_run.conf`参数——在 S3 和 LustreFS 或 Python 和 Spark 之间切换无需修改代码,而由 Airflow 管理的秘密存储负责解析所需凭据。
[[5-4-storage-architecture-detail]]
== 5.4 存储架构详细信息
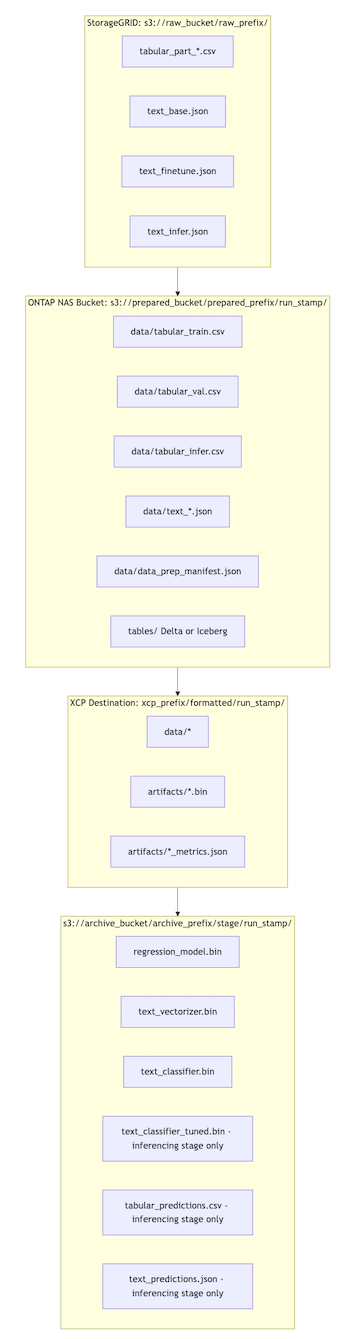
存储架构将 AI 生命周期划分为专用层:StorageGRID 保存原始和归档对象,ONTAP NAS 存储桶保存已准备好并加盖运行戳记的数据集,ONTAP S3 或 LustreFS 提供选定的活动训练层。这种分离使源数据、准备好的数据、模型工件和存档证据可独立管理,同时通过共享 `run_stamp`保留数据谱系。
[[5-4-1-storage-layout-diagrams]]
=== 5.4.1 存储布局图
| 层级 | 逻辑存储路径 | 存储的内容/制品 |
|---|---|---|
StorageGRID 原始层 |
|
表格CSV部分( |
ONTAP NAS 准备就绪层 |
|
格式化分割( |
活动培训层(XCP Dest) |
|
复制的数据拆分,训练的模型二进制文件( |
StorageGRID 存档层 |
|
阶段范围基线或完整模型伪影,预测证据( |
层间沿袭与流程 |
原始→准备→活动层→存档 |
端到端的数据移动和制品沿袭通过共享 `run_stamp`跨所有存储层进行关联 |
此图映射跨所有存储层运行的单个管道的逻辑桶和前缀布局:
[[5-4-2-storage-sizing-guidance]]
=== 5.4.2 存储规模估算指导
根据每个层的角色和保留策略独立调整其大小。ONTAP NAS 和选定的 XCP 目标必须能够支持并发活动运行,而 StorageGRID 容量主要由原始数据和归档保留需求驱动。在规划峰值管道并发时,请包含临时工作容量和增长余量。
| 层级 | 规模估算依据 |
|---|---|
StorageGRID 原始分段 |
采集量 × 保留窗口 |
ONTAP NAS 准备好的数据桶 |
准备好的数据集大小 × 保留的运行次数 |
XCP 目的地(S3 或 Lustre) |
峰值并发训练数据集大小 + 模型工件开销 |
存档分段 |
保留策略 × 存档阶段选择(model_training = 较小;inferencing = 较大) |
[[5-4-3-storage-performance-considerations]]
=== 5.4.3 存储性能注意事项
XCP 目标按运行次数选择 xcp_copy_destination,允许存储性能与工作负载匹配,而不是将每个工作负载强制分配到一个层。对于行数较多的数据集、大量并发读取器或 I/O 密集型训练,请选择 LustreFS。对于性能要求无需并行文件系统的注重成本、弹性访问的工作负载,请选择 ONTAP S3。在任意一种情况下,XCP 都会使数据和模型工件与所选的训练层保持一致。