


Failover von Anwendungen an einen Remote-Standort mit NetApp Disaster Recovery


 Änderungen vorschlagen

 PDFs

Wenn eine Katastrophe oder ein ähnliches Ereignis eintritt, kann NetApp Disaster Recovery verwendet werden, um kritische Workloads wiederherzustellen, sodass Anwendungen am Disaster-Recovery-Standort mit geplanten Zuordnungen fortgesetzt werden können.
Disaster Recovery unterstützt auch das Testen von Failover-Vorgängen. Tests tragen dazu bei, sich mit dem Prozess vertraut zu machen und zu bestätigen, dass die Wiederherstellung wie erwartet funktioniert.
Erforderliche NetApp Console-Rolle Für die Ausführung dieser Aufgabe ist die Rolle „Superadmin“, „Disaster recovery admin“ oder „Disaster recovery failover admin“ erforderlich. "Erfahren Sie mehr über Benutzerrollen und Berechtigungen in NetApp Disaster Recovery". "Erfahren Sie mehr über die Zugriffsrollen der NetApp Console für alle Dienste".
Über diese Aufgabe
Während des Failover verwendet Disaster Recovery standardmäßig die aktuellste Snapshot-Kopie von SnapMirror, Sie können jedoch einen bestimmten Snapshot aus einem zeitpunktgenauen Snapshot auswählen (gemäß der Aufbewahrungsrichtlinie von SnapMirror). Die zeitpunktgenau-Option ist geeignet, wenn die aktuellsten Replikate beeinträchtigt sind, beispielsweise bei einem Ransomware-Angriff.
Dieser Prozess unterscheidet sich, je nachdem, ob der Produktionsstandort fehlerfrei ist und Sie aus anderen Gründen als einem kritischen Infrastrukturausfall ein Failover zum Disaster Recovery-Standort durchführen:
-
Bei einem kritischen Produktionsstandortausfall, bei dem das Quell-vCenter, der Kubernetes-Cluster oder das ONTAP Cluster nicht zugänglich ist, ermöglicht Disaster Recovery die Auswahl eines beliebigen verfügbaren Snapshots, von dem aus die Wiederherstellung erfolgt.
-
Die Produktionsumgebung ist fehlerfrei: Sie können entweder „Jetzt einen Snapshot erstellen“ oder einen zuvor erstellten Snapshot auswählen.
Dieses Verfahren unterbricht die Replikationsbeziehung, nimmt die Quell-Workloads offline, stellt die replizierten Volumes am Disaster-Recovery-Standort bereit, startet die geschützten Workloads gemäß den Failover-Regeln des Plans neu und aktiviert lesen/schreiben am Zielstandort. Bei VMware-Workloads nimmt der Dienst die vCenter Quell-VMs offline, registriert die Volumes als Datastores im Disaster-Recovery-vCenter und startet die geschützten VMs neu. Kubernetes-Workloads folgen der entsprechenden Sequenz für ihre Anwendungen und persistenten Volumes.
Testen des Failover-Prozesses
Vor einem Live-Failover kann ein Test durchgeführt werden, um die Einsatzbereitschaft zu überprüfen. Die Workloads bleiben während des Testvorgangs online.
Während eines Failover-Tests von VMware-Workloads erstellt Disaster Recovery temporär VMs. Disaster Recovery ordnet den ESXi-Hosts einen temporären Datenspeicher zu, der das FlexClone Volume unterstützt. Ein Failover-Test von Kubernetes-Workloads folgt dem entsprechenden Ablauf für die geschützten Anwendungen und persistenten Volumes auf dem Ziel-Cluster.
Dieser Prozess beansprucht keine zusätzliche physische Kapazität auf dem lokalen ONTAP Speicher oder dem FSx für NetApp ONTAP -Speicher in AWS. Das ursprüngliche Quellvolume wird nicht verändert, und Replikationsaufträge können auch während der Notfallwiederherstellung fortgesetzt werden.
Nach Abschluss des Tests empfiehlt es sich, die Testumgebung mit der Option Clean up test zurückzusetzen.
Ein Test-Failover-Vorgang hat keine Auswirkungen auf Produktions-Workloads, die auf der Testsite verwendete SnapMirror -Beziehung und geschützte Workloads, die weiterhin normal ausgeführt werden müssen.
Bei einem Test-Failover führt Disaster Recovery die folgenden Operationen durch.
-
Führen Sie Vorprüfungen des Zielclusters und der SnapMirror -Beziehung durch.
-
Erstellen Sie aus dem ausgewählten Snapshot für jedes geschützte ONTAP Volume auf dem ONTAP -Cluster des Zielstandorts ein neues FlexClone Volume.
-
Wenn es sich bei einem der Datenspeicher um VMFS handelt, erstellen Sie eine iGroup und ordnen Sie sie jeder LUN zu.
-
Registrieren Sie die Ziel-VMs innerhalb von vCenter als neue Datenspeicher.
-
Schalten Sie die Ziel-VMs gemäß der auf der Seite „Ressourcengruppen“ erfassten Startreihenfolge ein.
-
Führen Sie eine Stilllegung aller unterstützten Datenbankanwendungen in VMs durch, die als „anwendungskonsistent“ gekennzeichnet sind.
-
Wenn die Quell-vCenter- und ONTAP Cluster noch aktiv sind, erstellen Sie eine SnapMirror -Beziehung in umgekehrter Richtung, um alle Änderungen im Failover-Zustand zurück auf die ursprüngliche Quellsite zu replizieren.
-
Melden Sie sich an bei "NetApp Console" .
-
Wählen Sie in der linken Navigation der NetApp Console Schutz > Notfallwiederherstellung.
-
Im Menü „Notfallwiederherstellung“ ist Replikationspläne auszuwählen.
-
Wählen Sie den Replikationsplan aus.
-
Rechts kann die Option Actions
 und anschließend Test failover ausgewählt werden.
-
Wählen Sie auf der Seite „Failover testen“ den Snapshot für den Failover-Test aus: Wählen Sie Jetzt Snapshot erstellen oder Auswählen, um einen vorhandenen Snapshot auszuwählen. Wenn Sie Auswählen wählen, wählen Sie den vorhandenen Snapshot aus.
Anschließend „Test failover“ eingeben und Test failover auswählen.
-
Nachdem der Test abgeschlossen ist, bereinigen Sie die Testumgebung.
Bereinigen der Testumgebung nach einem Failovertest
Nach Abschluss des Failover-Tests ist eine Bereinigung der Testumgebung erforderlich. Dabei werden die temporären Testressourcen und die FlexClones vom Teststandort entfernt. Bei VMware Workloads umfasst dies die temporären VMs und die temporären Datastores.
-
Im Menü „Notfallwiederherstellung“ ist Replikationspläne auszuwählen.
-
Wählen Sie den Replikationsplan aus.
-
Rechts erfolgt die Auswahl der Option Aktionen
und anschließend von Failover-Test bereinigen. -
Geben Sie auf der Seite „Test-Failover“ die Option „Failover bereinigen“ ein und wählen Sie dann Failover-Test bereinigen aus.
Führen Sie ein Failover des Quellstandorts auf einen Notfallwiederherstellungsstandort durch
Im Katastrophenfall können Sie Ihren primären Standort bei Bedarf auf den Notfallwiederherstellungsstandort umschalten. Bei VMware-Workloads können Sie Ihren primären lokalen VMware-Standort auf einen anderen lokalen VMware-Standort oder auf VMware Cloud on AWS mit FSx for NetApp ONTAP umschalten. Bei Kubernetes-Workloads schalten Sie auf den Ziel-Cluster im Replikationsplan um.
Der Failover-Prozess umfasst die folgenden Operationen. Die Operationen, die sich auf vCenter, VMs oder Datastores beziehen, gelten für VMware-Workloads; Kubernetes-Workloads folgen den entsprechenden Operationen für ihre Anwendungen und persistenten Volumes:
-
Disaster Recovery führt Vorprüfungen des Zielclusters und der SnapMirror -Beziehung durch.
-
Wenn Sie den neuesten Snapshot ausgewählt haben, wird das SnapMirror Update durchgeführt, um die neuesten Änderungen zu replizieren.
-
Die Quell-VMs sind heruntergefahren.
-
Die SnapMirror Beziehung ist unterbrochen und das Ziel-Volume ist nun lesen/schreiben.
-
Basierend auf der Auswahl des Snapshots wird das aktive Dateisystem auf den angegebenen Snapshot (neuester oder ausgewählter) wiederhergestellt.
-
Datenspeicher werden basierend auf den im Replikationsplan erfassten Informationen erstellt und im VMware- oder VMC-Cluster oder -Host bereitgestellt. Wenn es sich bei einem der Datenspeicher um VMFS handelt, erstellen Sie eine iGroup und ordnen Sie sie jeder LUN zu.
-
Die Ziel-VMs werden innerhalb von vCenter als neue Datenspeicher registriert.
-
Die Ziel-VMs werden gemäß der auf der Seite „Ressourcengruppen“ erfassten Bootreihenfolge eingeschaltet.
-
Wenn das Quell-vCenter noch aktiv ist, müssen alle Quellseiten-VMs, die gerade ein Failover durchlaufen, ausgeschaltet werden.
-
Führen Sie eine Stilllegung aller unterstützten Datenbankanwendungen in VMs durch, die als „anwendungskonsistent“ gekennzeichnet sind.
-
Wenn Quell-vCenter und ONTAP Cluster noch aktiv sind, wird eine umgekehrte SnapMirror Beziehung erstellt, um alle Änderungen im Failover-Zustand zurück zum ursprünglichen Quellstandort zu replizieren. Die SnapMirror Beziehung wird von der Ziel- zur Quell-VM umgekehrt.

|
Bei VMware Workloads können Sie nach Beginn des Failovers die wiederhergestellten VMs im vCenter des Disaster-Recovery-Standorts sehen (VMs, Netzwerke und Datastores). Standardmäßig werden die VMs im Ordner Workload wiederhergestellt. |
Bei datenspeicherbasierten Replikationsplänen werden VMs, die Sie hinzugefügt und erkannt haben, für die aber keine Zuordnungsdetails angegeben wurden, in das Failover einbezogen. Der Failover schlägt fehl und es wird eine Benachrichtigung in den Jobs angezeigt. Sie müssen die Zuordnungsdetails angeben, um das Failover erfolgreich abzuschließen.
-
Im Menü „Notfallwiederherstellung“ ist Replikationspläne auszuwählen.
-
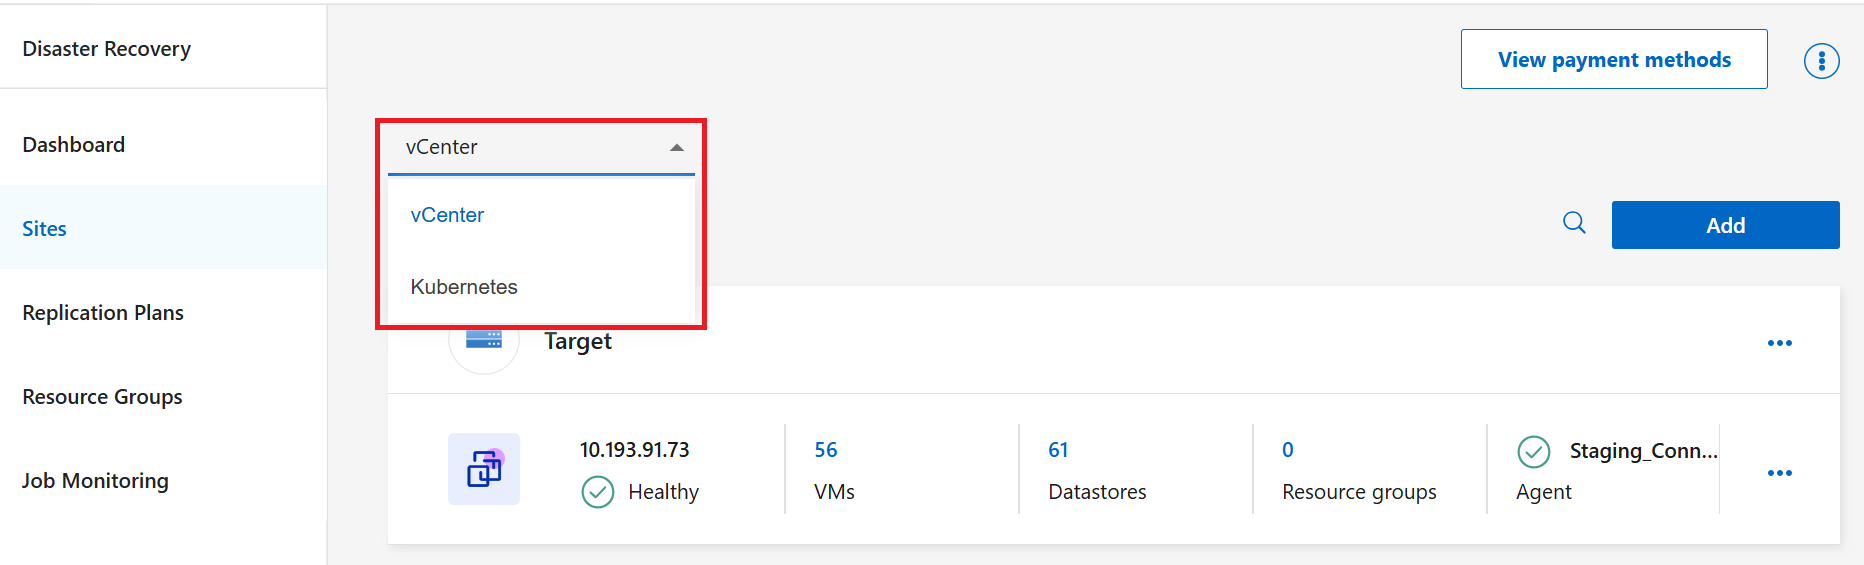
Im Dropdown-Menü nach vCenter Replikationsplänen filtern.
-
Wählen Sie den Replikationsplan aus.
-
Wählen Sie rechts die Option Aktionen aus
, bewegen Sie den Mauszeiger über Wiederherstellen und wählen Sie dann Fail over aus.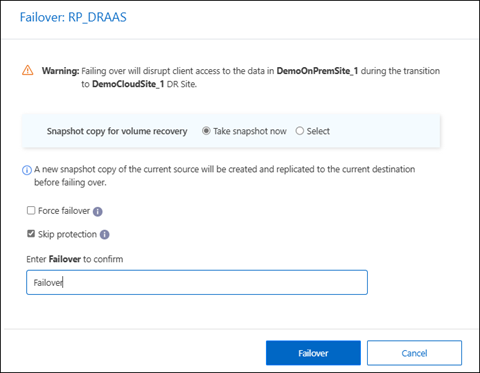
-
Wählen Sie die Snapshot-Kopie aus, die Sie für den Failover-Zustand verwenden möchten:
-
Jetzt Snapshot erstellen auswählen, um einen brandneuen Snapshot zu erstellen, der vor dem Failover in den Ziel-Cluster kopiert wird.
-
Neuesten Snapshot verwenden ermöglicht die Nutzung des aktuellsten verfügbaren Snapshots auf dem Ziel-Cluster.
-
Auswählen zeigt eine nach Aktualität sortierte Liste der Momentaufnahmen an.

Bei Auswahl einer bestimmten Snapshot-Baseline werden SnapMirror Transfer-Snapshots standardmäßig ausgeblendet, da sie während eines Failovers gelöscht werden können. Diese Löschung führt dazu, dass die Workload nach dem Failover aufgrund des Fehlers „Kein gemeinsamer Snapshot gefunden“ nicht erneut geschützt werden kann. SnapMirror Transfer-Snapshots können weiterhin verwendet werden, allerdings ist eine zusätzliche Bestätigungsabfrage erforderlich, um das Risiko zu bestätigen.
-
-
Failover erzwingen auswählen, wenn der Failover auch dann fortgesetzt werden soll, wenn der Dienst einen Fehler erkennt, der ihn normalerweise blockieren würde.
-
Die Option Schutz überspringen wird verwendet, wenn der Dienst nach einem Failover eines Replikationsplans nicht automatisch eine umgekehrte SnapMirror Schutzbeziehung erstellen soll. Dies ist hilfreich, wenn Sie zusätzliche Vorgänge am wiederhergestellten Standort durchführen möchten, bevor Sie ihn im Rahmen von Disaster Recovery wieder online schalten.
Sie können einen umgekehrten Schutz einrichten, indem Sie im Menü „Aktionen“ des Replikationsplans die Option „Ressourcen schützen“ auswählen. Dadurch wird versucht, für jedes Volume im Plan eine umgekehrte Replikationsbeziehung zu erstellen. Sie können diesen Job wiederholt ausführen, bis der Schutz wiederhergestellt ist. Wenn der Schutz wiederhergestellt ist, können Sie auf die übliche Weise ein Failback einleiten. -
Geben Sie „Failover“ in das Feld ein.
-
Wählen Sie Failover.
-
Um den Fortschritt zu überprüfen, wählen Sie im Menü Jobüberwachung.
-
Im Menü „Notfallwiederherstellung“ ist Replikationspläne auszuwählen.
-
Im Dropdown-Menü nach Kubernetes-Replikationsplänen filtern.
-
Wählen Sie den Replikationsplan aus.
-
Wählen Sie rechts die Option Aktionen aus
, bewegen Sie den Mauszeiger über Wiederherstellen und wählen Sie dann Fail over aus. -
Wählen Sie die Snapshot-Kopie aus, die Sie für den Failover-Zustand verwenden möchten:
-
Jetzt Snapshot erstellen auswählen, um einen brandneuen Snapshot zu erstellen, der in den Ziel-Cluster kopiert wird.
-
Neuesten Snapshot verwenden ermöglicht die Nutzung des aktuellsten verfügbaren Snapshots auf dem Ziel-Cluster.
-
Auswählen zeigt eine nach Aktualität sortierte Liste der Momentaufnahmen an.
Bei Auswahl einer bestimmten Snapshot-Baseline werden SnapMirror Transfer-Snapshots standardmäßig ausgeblendet, da sie während eines Failovers gelöscht werden können. Diese Löschung führt dazu, dass die Workload nach dem Failover aufgrund des Fehlers „Kein gemeinsamer Snapshot gefunden“ nicht erneut geschützt werden kann. SnapMirror Transfer-Snapshots können weiterhin verwendet werden, allerdings ist eine zusätzliche Bestätigungsabfrage erforderlich, um das Risiko zu bestätigen.
-
-
Die Option Schutz überspringen ist geeignet, wenn Disaster Recovery nach einem Failover eines Replikationsplans nicht automatisch eine umgekehrte SnapMirror Schutzbeziehung erstellen soll. Dies ist hilfreich, wenn Sie zusätzliche Vorgänge am wiederhergestellten Standort durchführen möchten, bevor Sie ihn in Disaster Recovery wieder online schalten.
-
Geben Sie „Failover“ ein, um die Aktion zu bestätigen, und wählen Sie dann Failover aus.
Den Status des Auftrags können Sie unter Job monitoring oder Replication plans überwachen.