


NetApp Disaster Recovery für VMFS-Datastores


 Änderungen vorschlagen

 PDFs

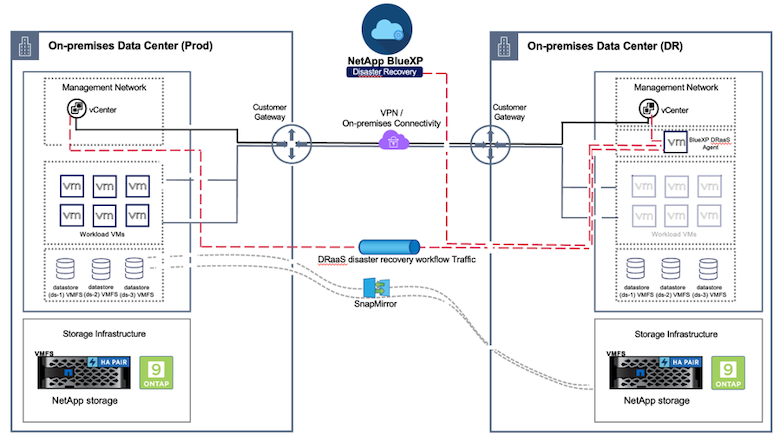
Die Notfallwiederherstellung mithilfe der Blockebenenreplikation vom Produktionsstandort zum Notfallwiederherstellungsstandort ist eine robuste und kostengünstige Möglichkeit, die Workloads vor Standortausfällen und Datenbeschädigungen wie Ransomware-Angriffen zu schützen. Mit der NetApp SnapMirror Replikation können VMware-Workloads, die auf lokalen ONTAP -Systemen mit VMFS-Datenspeicher ausgeführt werden, auf ein anderes ONTAP Speichersystem in einem dafür vorgesehenen Wiederherstellungs-Rechenzentrum repliziert werden, in dem sich VMware befindet.
Dieser Abschnitt des Dokuments beschreibt die Konfiguration von NetApp Diaster Recovery, um die Disaster Recovery für lokale VMware-VMs an einem anderen festgelegten Standort einzurichten. Zu dieser Einrichtung gehören Console agent, das Onboarding der ONTAP-Arrays, die Definition von Standorten und die Zuordnung von VMware vCenter. Darüber hinaus wird in diesem Dokument подробно beschrieben, wie die Replikation zwischen Standorten konfiguriert wird und wie ein Wiederherstellungsplan eingerichtet und getestet wird. Im letzten Abschnitt wird beschrieben, wie ein vollständiges Standort-Failover durchgeführt wird und wie ein Failback erfolgt, wenn der primäre Standort wiederhergestellt und wieder online gebracht wurde.
Mithilfe von Disaster Recovery, einem Teil von NetApp Data Services, können Kunden ihre lokalen VMware vCenters zusammen mit ONTAP Storage identifizieren, Ressourcengruppen erstellen, einen Disaster Recovery Plan erstellen, ihn mit Ressourcengruppen verknüpfen und Failover sowie Failback testen oder ausführen. SnapMirror bietet Storage-seitige Blockreplizierung, um die beiden Standorte mit inkrementellen Änderungen auf dem neuesten Stand zu halten, was zu einem RPO von bis zu 5 Minuten führt. Außerdem können DR-Prozeduren als regelmäßige Übung simuliert werden, ohne die Produktionsumgebung und die replizierten Datastores zu beeinträchtigen oder zusätzliche Storage-Kosten zu verursachen. NetApp Data Services nutzt die FlexClone Technologie von ONTAP, um eine platzsparende Kopie des VMFS-Datastores aus dem zuletzt replizierten Snapshot am DR-Standort zu erstellen. Nach Abschluss des DR-Tests können Kunden die Testumgebung einfach löschen, wiederum ohne Auswirkungen auf die tatsächlich replizierten Produktionsressourcen. Wenn ein tatsächliches Failover erforderlich ist, ob geplant oder ungeplant, orchestriert Disaster Recovery mit wenigen Klicks alle erforderlichen Schritte, um die geschützten virtuellen Maschinen am vorgesehenen Disaster Recovery Standort automatisch hochzufahren. Der Service kehrt bei Bedarf auch die SnapMirror Beziehung zum primären Standort um und repliziert alle Änderungen vom sekundären zum primären Standort für einen Failback-Vorgang. All dies lässt sich im Vergleich zu anderen bekannten Alternativen zu einem Bruchteil der Kosten erreichen.

|
Aktuelle Informationen und unterstützte Versionen von vCenter Server, ESXi und ONTAP for Disaster Recovery finden Sie in der "Unterstützte Konfigurationen für die Notfallwiederherstellung". |
Erste Schritte
Für den Einstieg in Disaster Recovery verwenden Sie die NetApp Console; anschließend greifen Sie auf den Dienst zu.
-
Anmeldung bei Console.
-
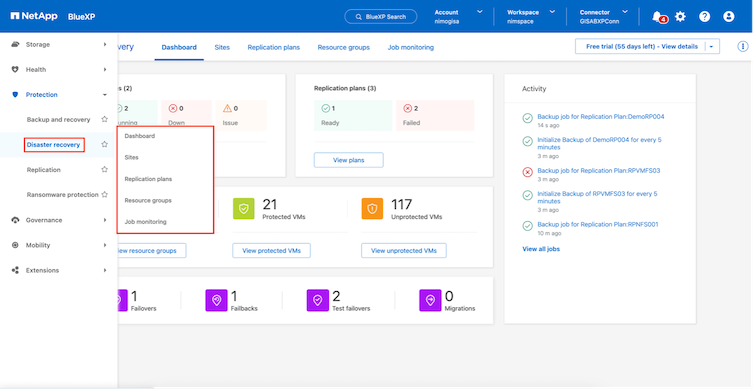
Die Auswahl erfolgt in der linken Navigationsleiste der Console über Protection > Disaster recovery.
-
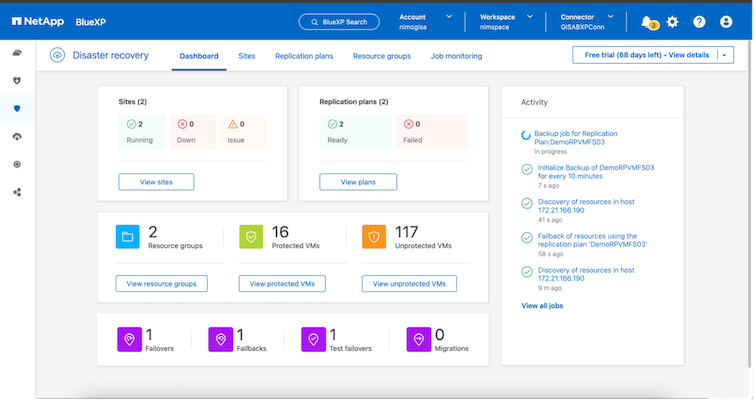
Das Dashboard für die Notfallwiederherstellung erscheint.
Stellen Sie vor der Konfiguration des Notfallwiederherstellungsplans sicher, dass die folgenden Voraussetzungen erfüllt sind:
-
Der Console Agent wird in einer AWS VPC bereitgestellt.
-
Die Console Agent-Instanz verfügt über Verbindungen zu den Quell- und Ziel-vCenter- sowie zu den Storage-Systemen.
-
In Console werden lokale NetApp Storage-Systeme hinzugefügt, die VMFS-Datenspeicher für VMware hosten.
-
Bei der Verwendung von DNS-Namen sollte eine DNS-Auflösung vorhanden sein. Andernfalls verwenden Sie IP-Adressen für das vCenter.
-
Die SnapMirror Replikation ist für die angegebenen VMFS-basierten Datenspeichervolumes konfiguriert.
Sobald die Verbindung zwischen Quell- und Zielstandort hergestellt ist, fahren Sie mit den Konfigurationsschritten fort. Dies sollte etwa 3 bis 5 Minuten dauern.
|
|
NetApp empfiehlt die Bereitstellung des Console Agenten am Disaster-Recovery-Standort oder an einem dritten Standort, damit der Console Agent während tatsächlicher Ausfälle oder Naturkatastrophen über das Netzwerk mit Quell- und Zielressourcen kommunizieren kann. |
|
|
Die Unterstützung für lokale VMFS-Datenspeicher befindet sich beim Schreiben dieses Dokuments in der Technologievorschau. Die Funktion wird sowohl mit FC- als auch mit ISCSI-Protokoll-basierten VMFS-Datenspeichern unterstützt. |
Konfiguration für die Notfallwiederherstellung
Der erste Schritt bei der Vorbereitung auf Disaster Recovery besteht darin, die lokalen Ressourcen für vCenter und Storage zu identifizieren und zu Disaster Recovery hinzuzufügen.
|
|
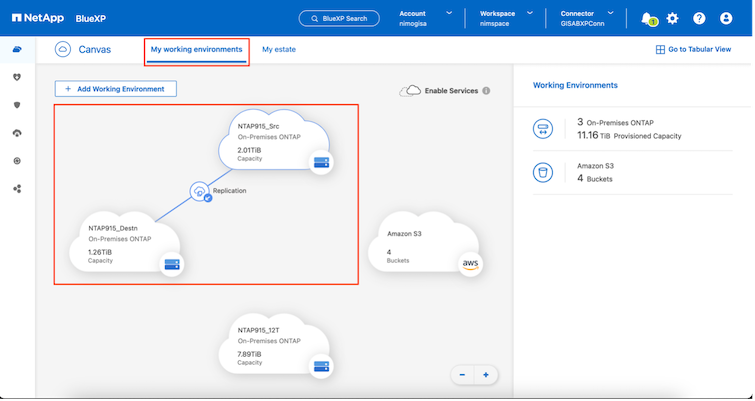
Voraussetzung ist, dass die ONTAP Storage-Systeme in der Arbeitsumgebung innerhalb des Canvas hinzugefügt wurden. In Console erfolgt in der linken Navigation die Auswahl von Protection > Disaster Recovery. Anschließend steht Discover vCenter servers zur Auswahl, alternativ über das obere Menü Sites > Add > Add vCenter. |
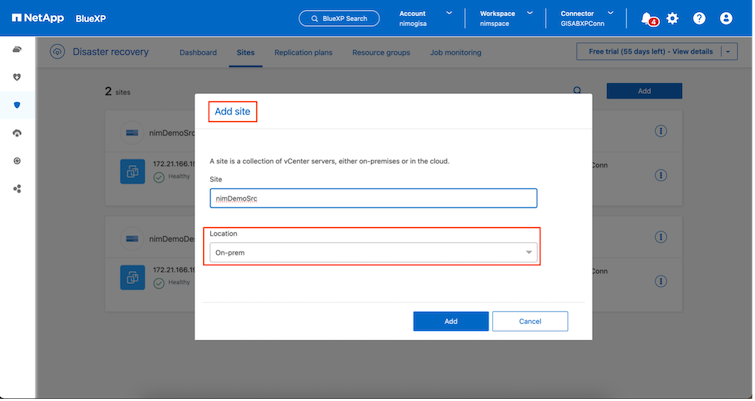
Fügen Sie die folgenden Plattformen hinzu:
-
Quelle. Lokales vCenter.
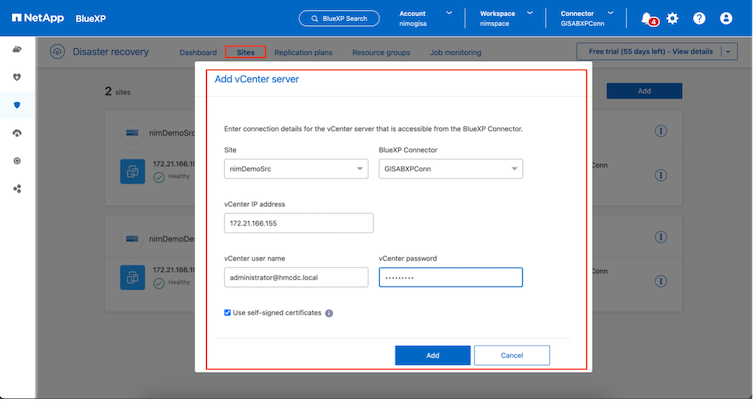
-
Ziel. VMC SDDC vCenter.
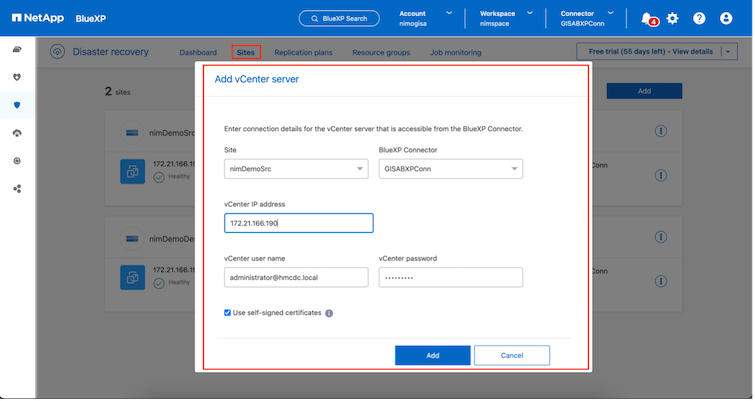
Sobald die vCenter hinzugefügt wurden, wird die automatische Erkennung ausgelöst.
Konfigurieren der Speicherreplikation zwischen Quell- und Zielstandort
SnapMirror nutzt ONTAP -Snapshots, um die Datenübertragung von einem Ort zum anderen zu verwalten. Zunächst wird eine vollständige Kopie basierend auf einem Snapshot des Quellvolumes auf das Ziel kopiert, um eine Basissynchronisierung durchzuführen. Wenn an der Quelle Datenänderungen auftreten, wird ein neuer Snapshot erstellt und mit dem Basis-Snapshot verglichen. Die Blöcke, bei denen Änderungen festgestellt wurden, werden dann zum Ziel repliziert, wobei der neuere Snapshot zur aktuellen Basislinie oder zum neuesten gemeinsamen Snapshot wird. Dadurch kann der Vorgang wiederholt und inkrementelle Updates an das Ziel gesendet werden.
Wenn eine SnapMirror -Beziehung hergestellt wurde, befindet sich das Zielvolume in einem schreibgeschützten Online-Zustand und ist daher weiterhin zugänglich. SnapMirror arbeitet mit physischen Speicherblöcken und nicht auf Datei- oder anderer logischer Ebene. Dies bedeutet, dass das Zielvolume eine identische Replik des Quellvolumes ist, einschließlich Snapshots, Volumeeinstellungen usw. Wenn ONTAP Speicherplatzeffizienzfunktionen wie Datenkomprimierung und Datendeduplizierung vom Quellvolume verwendet werden, behält das replizierte Volume diese Optimierungen bei.
Durch das Aufheben der SnapMirror Beziehung wird das Zielvolume beschreibbar und wird normalerweise zum Durchführen eines Failovers verwendet, wenn SnapMirror zum Synchronisieren von Daten mit einer DR-Umgebung verwendet wird. SnapMirror ist so ausgereift, dass die am Failover-Standort geänderten Daten effizient mit dem primären System resynchronisiert werden können, falls dieses später wieder online geht. Anschließend kann die ursprüngliche SnapMirror Beziehung wiederhergestellt werden.
So richten Sie es für VMware Disaster Recovery ein
Der Prozess zur Erstellung der SnapMirror Replikation bleibt für jede beliebige Applikation gleich. Der Prozess kann manuell oder automatisiert sein. Am einfachsten lässt sich die SnapMirror Replikation mit Console konfigurieren, indem das Quell-ONTAP-System in der Umgebung per Drag & Drop auf das Ziel gezogen wird, um den Assistenten zu starten, der durch den restlichen Prozess führt.
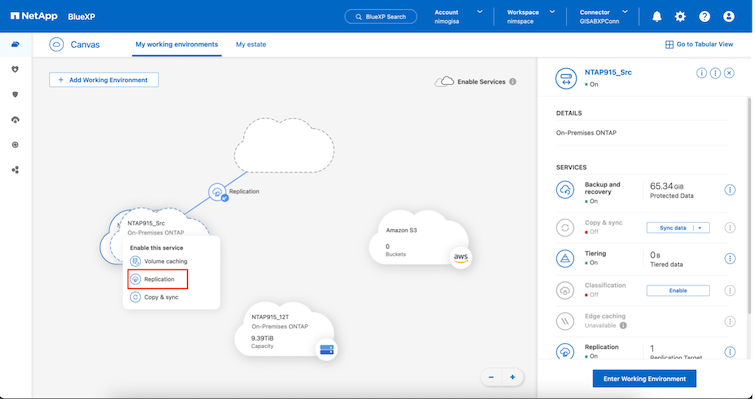
NetApp Data Services kann denselben Vorgang auch automatisieren, sofern die folgenden beiden Kriterien erfüllt sind:
-
Quell- und Zielcluster haben eine Peer-Beziehung.
-
Quell-SVM und Ziel-SVM haben eine Peer-Beziehung.
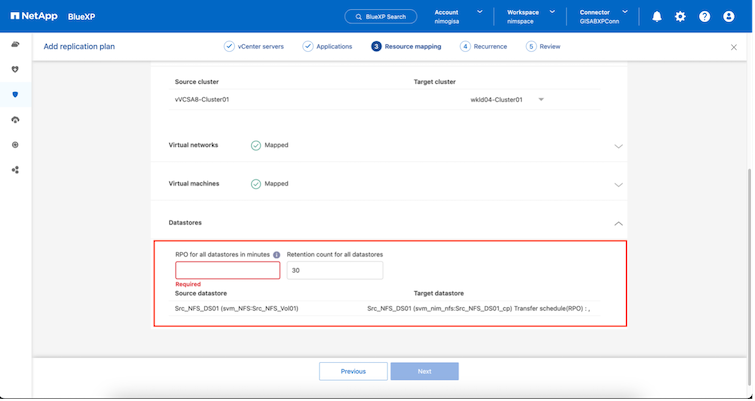
|
|
Wenn die SnapMirror Beziehung für das Volume bereits über die CLI konfiguriert ist, erkennt Console die Beziehung und fährt mit den übrigen Workflow-Operationen fort. |
|
|
Neben den oben genannten Ansätzen kann die SnapMirror Replikation auch über ONTAP CLI oder System Manager erstellt werden. Unabhängig vom Ansatz zur Synchronisierung der Daten mit SnapMirror orchestriert Disaster Recovery den Workflow für nahtlose und effiziente Disaster-Recovery-Abläufe. |
Was kann Disaster Recovery für Sie tun?
Nach dem Hinzufügen der Quell- und Zielstandorte führt Disaster Recovery eine automatische Tiefenerkennung durch und zeigt die VMs zusammen mit den zugehörigen Metadaten an. Disaster Recovery erkennt außerdem automatisch die von den VMs verwendeten Netzwerke und Portgruppen und trägt diese ein.
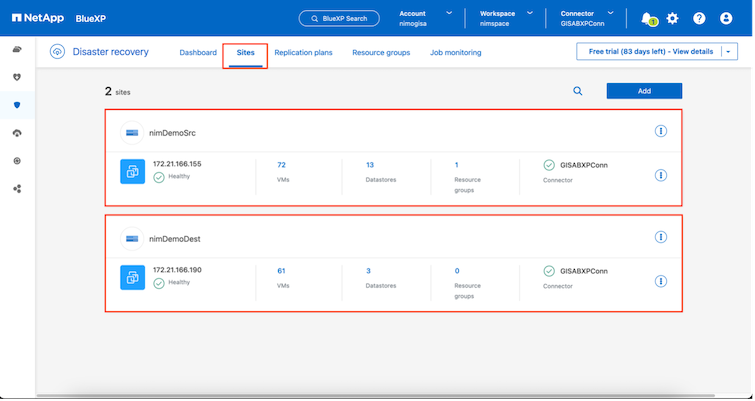
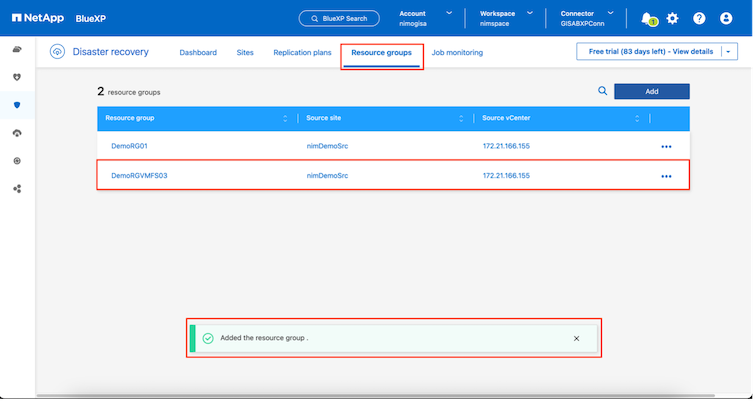
Nachdem die Standorte hinzugefügt wurden, können VMs in Ressourcengruppen zusammengefasst werden. Disaster Recovery Ressourcengruppen ermöglichen die Gruppierung abhängiger VMs in logische Gruppen, die deren Startreihenfolgen und Startverzögerungen enthalten und bei der Wiederherstellung ausgeführt werden können. Die Erstellung von Ressourcengruppen beginnt unter Resource Groups mit einem Klick auf Create New Resource Group.
|
|
Die Ressourcengruppe kann auch beim Erstellen eines Replikationsplans erstellt werden. |
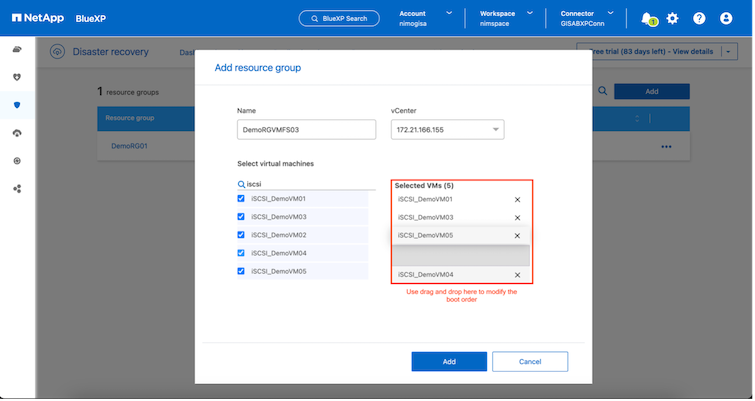
Die Startreihenfolge der VMs kann während der Erstellung von Ressourcengruppen mithilfe eines einfachen Drag-and-Drop-Mechanismus definiert oder geändert werden.
Sobald die Ressourcengruppen erstellt sind, besteht der nächste Schritt darin, den Ausführungsentwurf oder einen Plan zur Wiederherstellung virtueller Maschinen und Anwendungen im Katastrophenfall zu erstellen. Wie in den Voraussetzungen erwähnt, kann die SnapMirror Replikation im Voraus konfiguriert werden, oder DRaaS kann sie mithilfe des RPO und der Aufbewahrungsanzahl konfigurieren, die bei der Erstellung des Replikationsplans angegeben wurden.
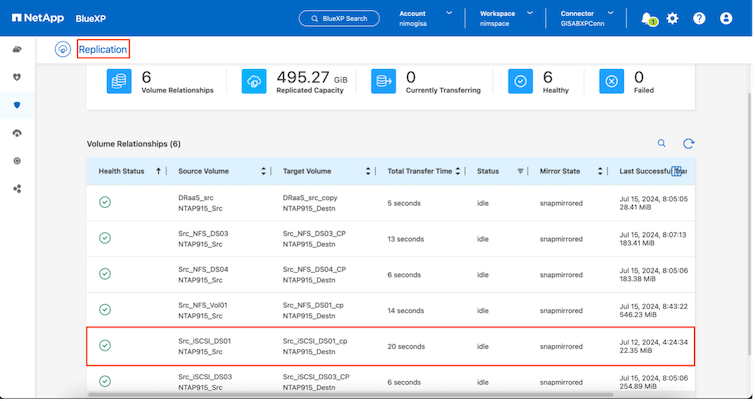
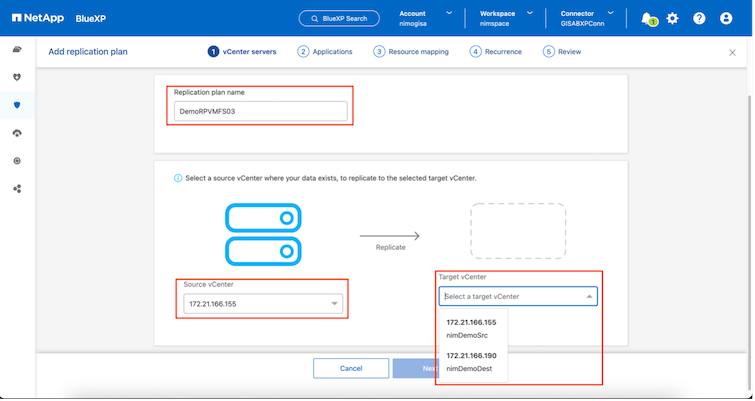
Konfigurieren Sie den Replikationsplan, indem Sie die Quell- und Ziel-vCenter-Plattformen aus der Dropdown-Liste auswählen und die Ressourcengruppen auswählen, die in den Plan aufgenommen werden sollen, zusammen mit der Gruppierung, wie Anwendungen wiederhergestellt und eingeschaltet werden sollen, und der Zuordnung von Clustern und Netzwerken. Um den Wiederherstellungsplan zu definieren, navigieren Sie zur Registerkarte Replikationsplan und klicken Sie auf Plan hinzufügen.
Wählen Sie zuerst das Quell-vCenter und dann das Ziel-vCenter aus.
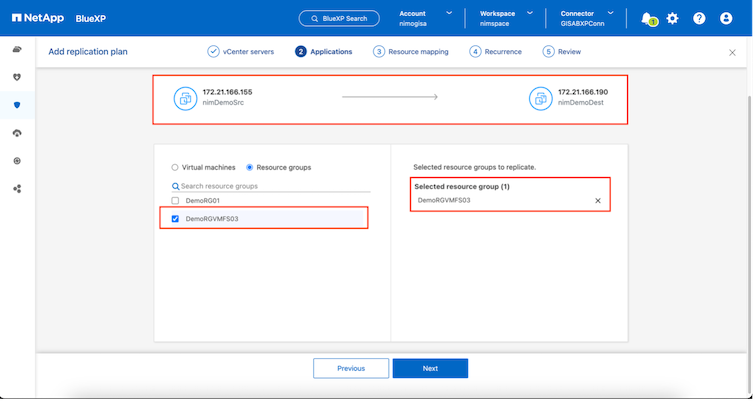
Der nächste Schritt besteht darin, vorhandene Ressourcengruppen auszuwählen. Wenn keine Ressourcengruppen erstellt wurden, hilft der Assistent dabei, die erforderlichen virtuellen Maschinen basierend auf den Wiederherstellungszielen zu gruppieren (im Wesentlichen funktionale Ressourcengruppen zu erstellen). Dies hilft auch dabei, die Vorgangsreihenfolge für die Wiederherstellung virtueller Anwendungsmaschinen zu definieren.
|
|
Die Ressourcengruppe ermöglicht das Festlegen der Startreihenfolge per Drag-and-Drop-Funktion. Damit lässt sich die Reihenfolge, in der die VMs während des Wiederherstellungsprozesses eingeschaltet werden, einfach ändern. |
|
|
Jede virtuelle Maschine innerhalb einer Ressourcengruppe wird der Reihe nach basierend auf der Reihenfolge gestartet. Zwei Ressourcengruppen werden parallel gestartet. |
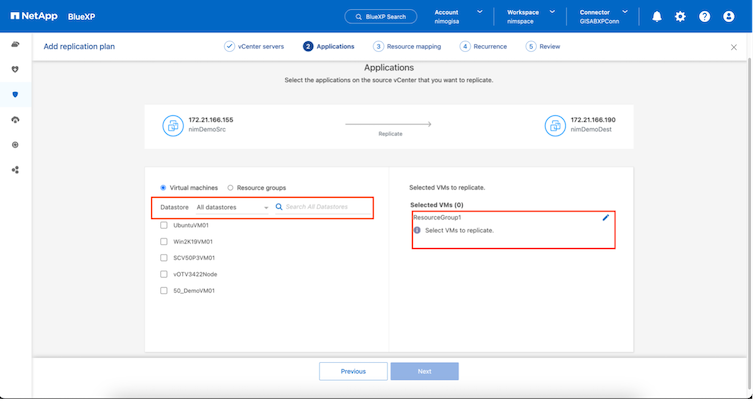
Der folgende Screenshot zeigt die Option zum Filtern virtueller Maschinen oder bestimmter Datenspeicher basierend auf organisatorischen Anforderungen, wenn nicht zuvor Ressourcengruppen erstellt wurden.
Nach der Auswahl der Ressourcengruppen folgt die Erstellung der Failover-Zuordnungen. In diesem Schritt wird festgelegt, wie die Ressourcen aus der Quellumgebung dem Ziel zugeordnet werden. Dazu gehören Rechenressourcen und virtuelle Netzwerke. Auch IP-Anpassungen, Vor- und Nachskripte, Startverzögerungen, Applikationskonsistenz usw. sind darin enthalten. Ausführliche Informationen enthält "Erstellen eines Replikationsplans".
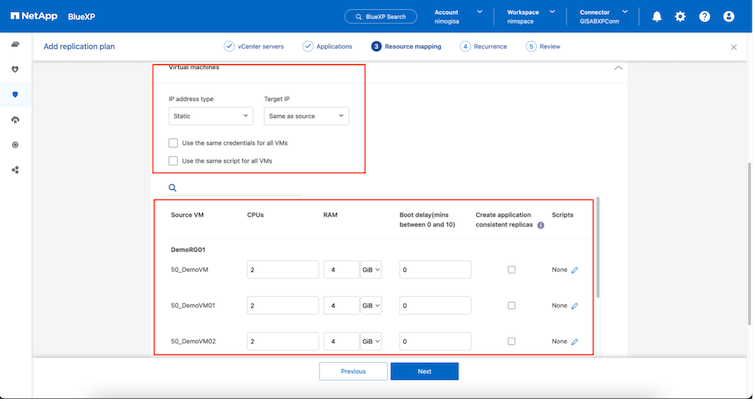
|
|
Standardmäßig werden für Test- und Failovervorgänge dieselben Zuordnungsparameter verwendet. Um verschiedene Zuordnungen für die Testumgebung anzuwenden, wählen Sie die Option „Testzuordnung“ aus, nachdem Sie das Kontrollkästchen wie unten gezeigt deaktiviert haben: |
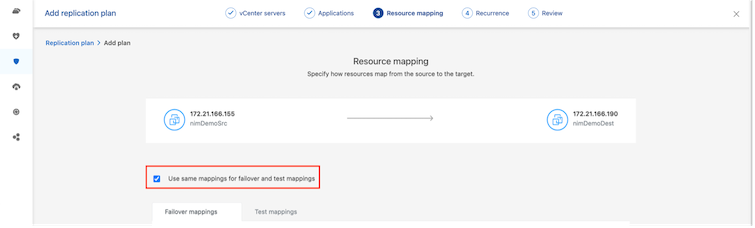
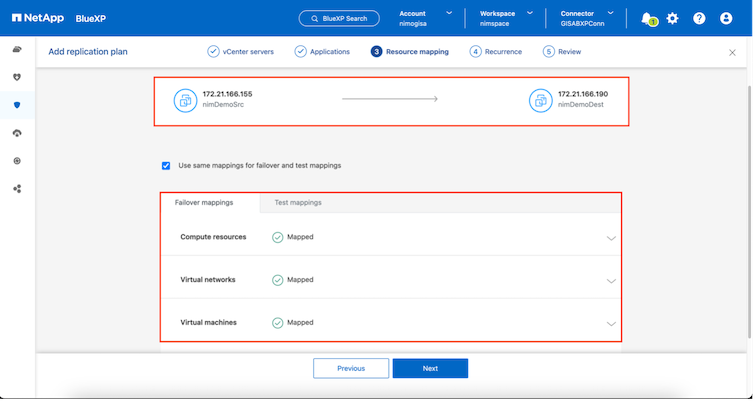
Klicken Sie nach Abschluss der Ressourcenzuordnung auf „Weiter“.
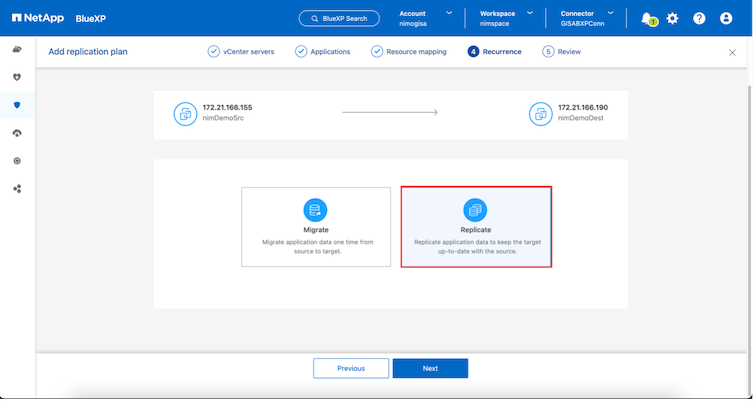
Wählen Sie den Wiederholungstyp aus. Einfach ausgedrückt: Wählen Sie „Migrieren“ (einmalige Migration mit Failover) oder die Option „Wiederkehrende kontinuierliche Replikation“. In dieser exemplarischen Vorgehensweise ist die Option „Replizieren“ ausgewählt.
Überprüfen Sie anschließend die erstellten Zuordnungen und klicken Sie dann auf „Plan hinzufügen“.
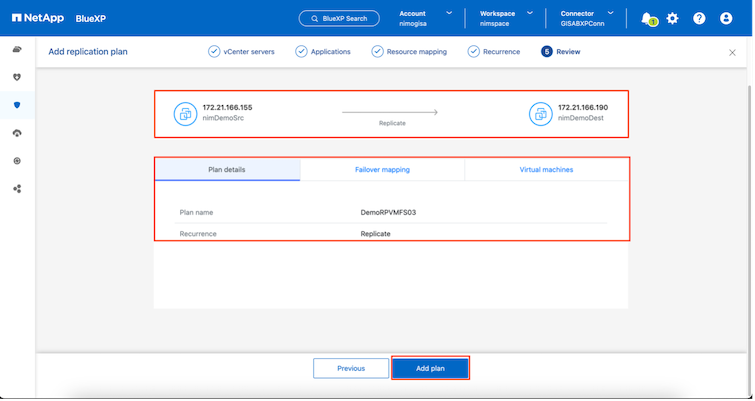
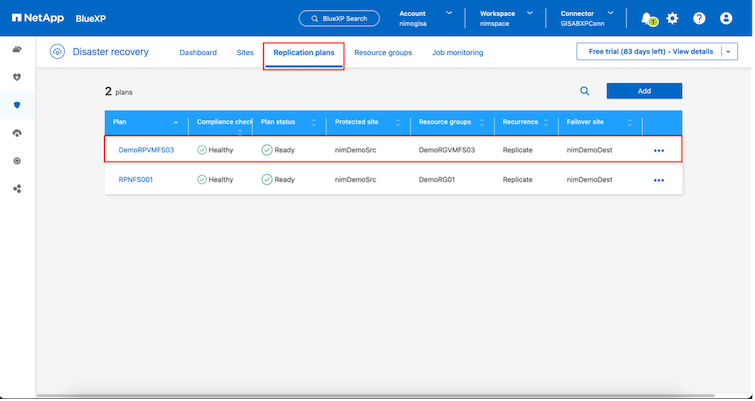
Sobald der Replikationsplan erstellt wurde, kann je nach Anforderungen ein Failover durchgeführt werden, indem die Option für Failover, Test-Failover oder Migration ausgewählt wird. Disaster Recovery stellt sicher, dass der Replikationsprozess alle 30 Minuten gemäß dem Plan ausgeführt wird. Bei den Optionen Failover und Test-Failover können Sie die neueste SnapMirror Snapshot Kopie verwenden, oder Sie können eine bestimmte Snapshot Kopie aus einer zeitpunktgenauen Snapshot Kopie auswählen (gemäß der Aufbewahrungsrichtlinie von SnapMirror). Die zeitpunktgenaue Option kann bei einem Beschädigungsereignis wie Ransomware sehr hilfreich sein, wenn die neuesten Replikate bereits kompromittiert oder verschlüsselt sind. Disaster Recovery zeigt alle verfügbaren Wiederherstellungspunkte an.
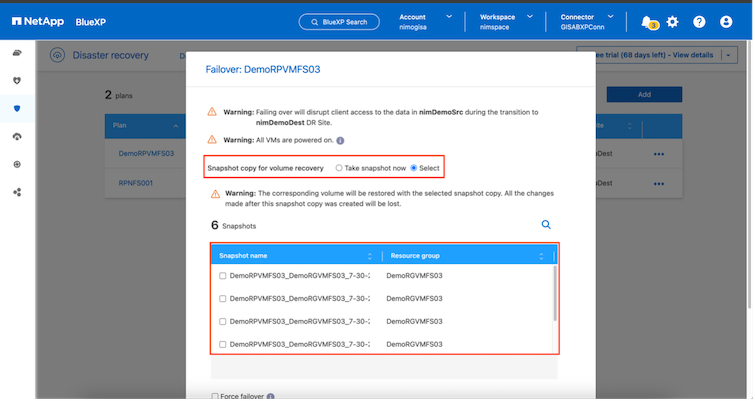
Um ein Failover oder ein Test-Failover mit der im Replikationsplan angegebenen Konfiguration auszulösen, klicken Sie auf Failover oder Test-Failover.
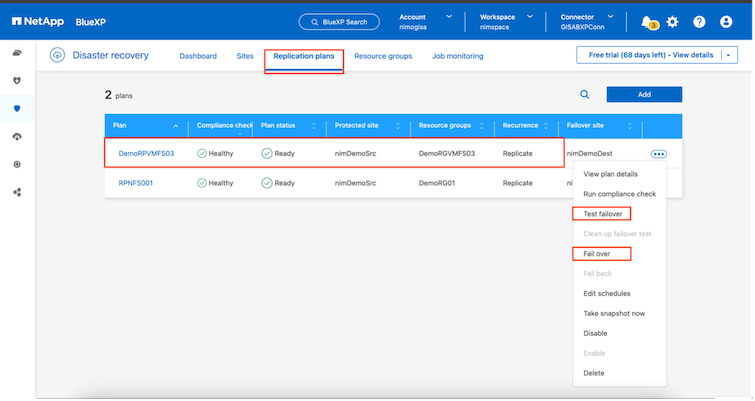
Was passiert während eines Failovers oder Test-Failover-Vorgangs?
Während eines Test-Failover-Vorgangs erstellt Disaster Recovery ein FlexClone Volume auf dem ONTAP Storage-System am Ziel unter Verwendung der neuesten Snapshot-Kopie oder eines ausgewählten Snapshots des Ziel-Volumes.
|
|
Ein Test-Failover-Vorgang erstellt ein geklontes Volume auf dem Ziel ONTAP -Speichersystem. |
|
|
Das Ausführen eines Testwiederherstellungsvorgangs hat keine Auswirkungen auf die SnapMirror Replikation. |
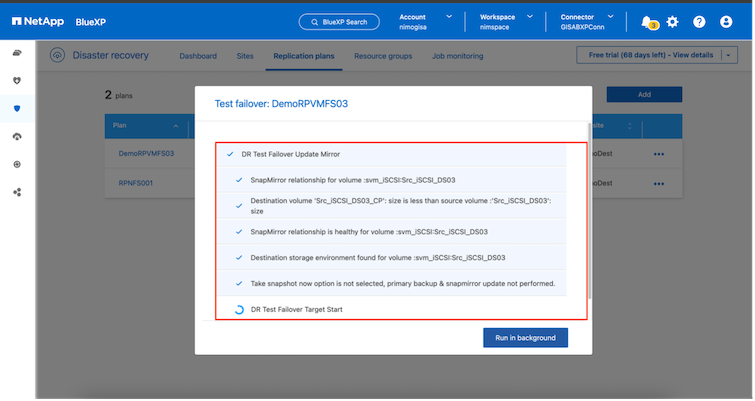
Während des Prozesses ordnet Disaster Recovery das ursprüngliche Ziel-Volume nicht zu. Stattdessen erstellt Disaster Recovery aus dem ausgewählten Snapshot ein neues FlexClone Volume, und ein temporärer Datenspeicher, der das FlexClone Volume unterstützt, wird den ESXi Hosts zugeordnet.
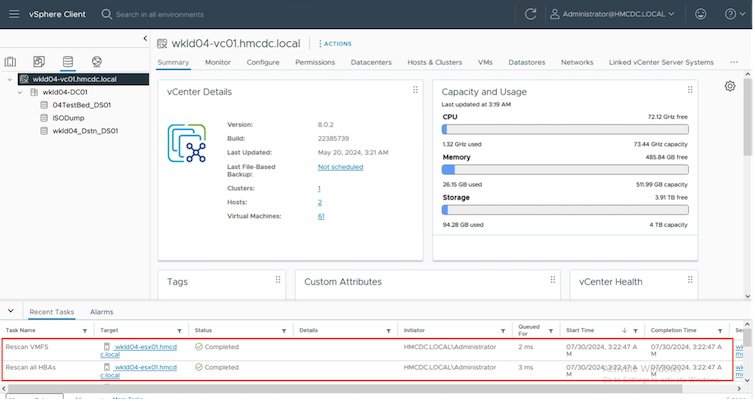
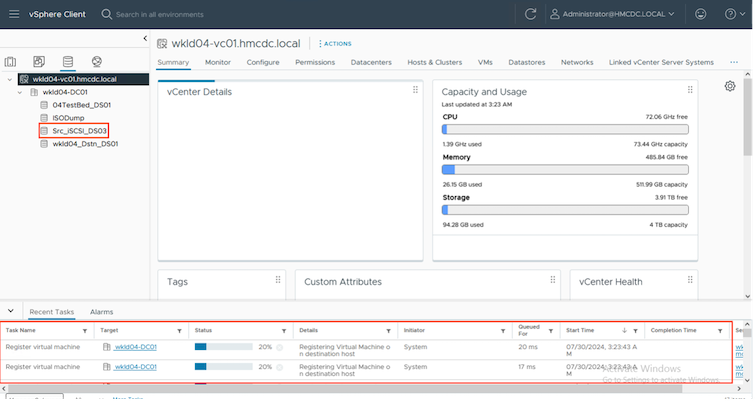
Wenn der Test-Failover-Vorgang abgeschlossen ist, kann die Bereinigungsoperation mit "Clean Up failover test" ausgelöst werden. Während dieses Vorgangs löscht Disaster Recovery das FlexClone Volume, das im Vorgang verwendet wurde.
Im Falle eines tatsächlichen Katastrophenereignisses führt Disaster Recovery die folgenden Schritte durch:
-
Bricht die SnapMirror -Beziehung zwischen den Sites ab.
-
Mountet das VMFS-Datenspeichervolume nach der Neusignierung zur sofortigen Verwendung.
-
Registrieren der VMs
-
VMs einschalten
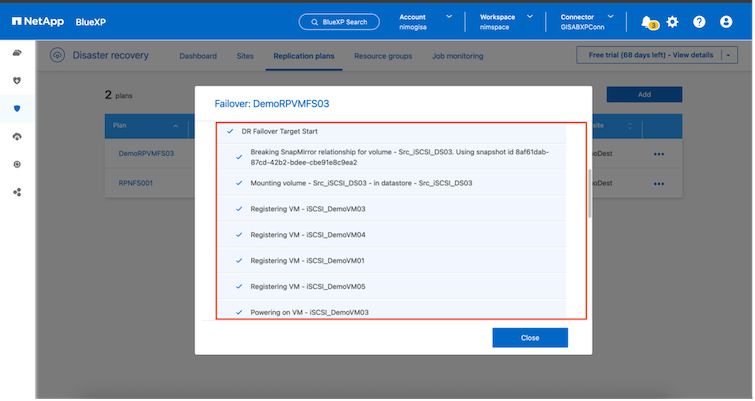
Sobald der primäre Standort betriebsbereit ist, ermöglicht Disaster Recovery die umgekehrte Resynchronisierung für SnapMirror und das Failback, was wiederum mit einem Klick auf eine Schaltfläche durchgeführt werden kann.
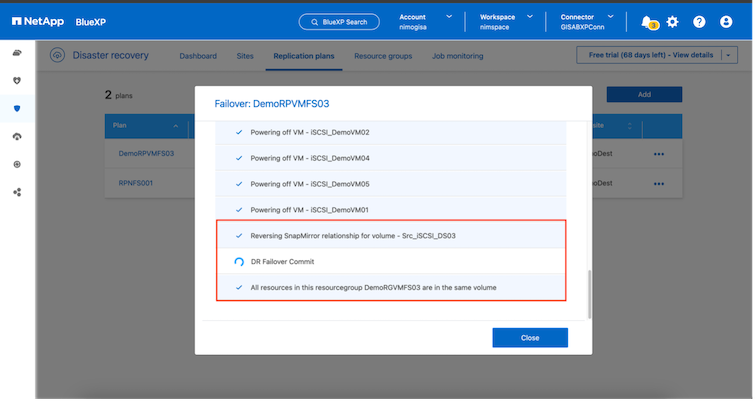
Und wenn die Migrationsoption gewählt wird, wird dies als geplantes Failover-Ereignis betrachtet. In diesem Fall wird ein zusätzlicher Schritt ausgelöst, der darin besteht, die virtuellen Maschinen am Quellstandort herunterzufahren. Die restlichen Schritte bleiben dieselben wie beim Failover-Ereignis.
Über Console oder die ONTAP CLI können Sie den Systemstatus der entsprechenden Datastore-Volumes überwachen, und der Status eines Failover oder Test-Failover lässt sich über Job Monitoring verfolgen.
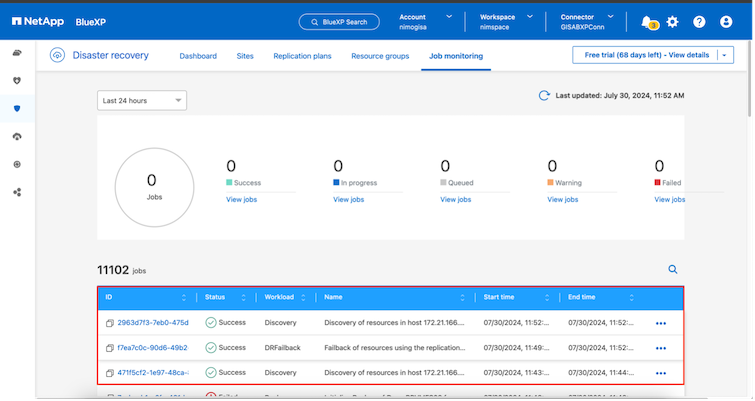
Dies bietet eine leistungsstarke Lösung zur Handhabung eines maßgeschneiderten und individuellen Notfallwiederherstellungsplans. Das Failover kann als geplantes Failover oder per Mausklick erfolgen, wenn ein Notfall eintritt und die Entscheidung zur Aktivierung der DR-Site getroffen wird.
Um mehr über diesen Prozess zu erfahren, können Sie sich gerne das ausführliche Walkthrough-Video ansehen oder die"Lösungssimulator" .