


Esegui il failover delle applicazioni su un sito remoto con NetApp Disaster Recovery


 Suggerisci modifiche

 PDF

Quando si verifica un disastro o un evento simile, usa NetApp Disaster Recovery per recuperare i carichi di lavoro critici, così le applicazioni possono riprendere a funzionare nel sito di recovery con le mappature pianificate.
NetApp Disaster Recovery supporta anche il test dei failover. Eseguire i test ti aiuta a familiarizzare con il processo e a confermare che il recovery funzioni come ti aspetti.
Ruolo NetApp Console richiesto Per eseguire questa attività è necessario il ruolo di Super admin, Disaster recovery admin o Disaster recovery failover admin. "Scopri di più sui ruoli utente e sulle autorizzazioni in NetApp Disaster Recovery". "Scopri di più sui ruoli di accesso NetApp Console per tutti i servizi".
Informazioni su questa attività
Durante il failover, Disaster Recovery utilizza per impostazione predefinita la copia Snapshot più recente di SnapMirror, anche se puoi selezionare uno Snapshot specifico da uno Snapshot point-in-time (in base alla policy di conservazione di SnapMirror). Usa l'opzione point-in-time se le repliche più recenti sono compromesse, ad esempio durante un attacco ransomware.
Questo processo varia a seconda che il sito di produzione sia integro e che si stia eseguendo un failover sul sito di disaster recovery per motivi diversi da un guasto critico dell'infrastruttura:
-
Guasto critico del sito di produzione in cui il vCenter di origine, il cluster Kubernetes o il cluster ONTAP non sono accessibili: Disaster Recovery ti consente di selezionare qualsiasi Snapshot disponibile da cui eseguire il ripristino.
-
L'ambiente di produzione è integro: puoi scegliere "Esegui uno snapshot ora" oppure selezionare uno snapshot creato in precedenza.
Questa procedura interrompe la relazione di replica, mette offline i carichi di lavoro di origine, rende disponibili i volumi replicati nel sito di disaster recovery, riavvia i carichi di lavoro protetti utilizzando le regole di failover definite nel piano e abilita le operazioni di lettura/scrittura sul sito di destinazione. Per i carichi di lavoro VMware, il servizio mette offline le VM di origine di vCenter, registra i volumi come datastore nel sito di disaster recovery vCenter e riavvia le VM protette. I carichi di lavoro Kubernetes seguono una sequenza equivalente per le rispettive applicazioni e i volumi persistenti.
Testare il processo di failover
Prima di eseguire un failover in tempo reale, puoi effettuare un test per verificarne la predisposizione. I carichi di lavoro rimangono online durante il processo di test.
Durante un test di failover di carichi di lavoro VMware, Disaster Recovery crea temporaneamente delle VM. Disaster Recovery mappa sugli host ESXi un datastore temporaneo che supporta il volume FlexClone. Un test di failover di carichi di lavoro Kubernetes segue una sequenza equivalente per le applicazioni protette e i volumi persistenti sul cluster di destinazione.
Questo processo non consuma ulteriore capacità fisica sullo storage ONTAP locale o sullo storage ONTAP FSx per NetApp in AWS. Il volume di origine originale non viene modificato e i processi di replica possono continuare anche durante il ripristino di emergenza.
Quando completi il test, ti consigliamo di ripristinare l'ambiente di test con l'opzione Pulisci test.
Un'operazione di failover di prova non ha alcun impatto sui carichi di lavoro di produzione, sulla relazione SnapMirror utilizzata sul sito di prova e sui carichi di lavoro protetti che devono continuare a funzionare normalmente.
Per un failover di prova, Disaster Recovery esegue le seguenti operazioni.
-
Eseguire controlli preliminari sul cluster di destinazione e sulla relazione SnapMirror .
-
Crea un nuovo volume FlexClone dallo snapshot selezionato per ciascun volume ONTAP protetto sul cluster ONTAP del sito di destinazione.
-
Se alcuni datastore sono VMFS, creare e mappare un iGroup su ogni LUN.
-
Registra le VM di destinazione in vCenter come nuovi datastore.
-
Avvia le macchine virtuali di destinazione in base all'ordine di avvio specificato nella pagina Gruppi di risorse.
-
Riattiva tutte le applicazioni di database supportate nelle VM indicate come "coerenti con l'applicazione".
-
Se i cluster vCenter e ONTAP di origine sono ancora attivi, creare una relazione SnapMirror in direzione inversa per replicare eventuali modifiche durante lo stato di failover sul sito di origine originale.
-
Accedi al "NetApp Console" .
-
Dal menu di navigazione a sinistra NetApp Console , selezionare Protezione > Disaster recovery.
-
Dal menu Disaster Recovery, seleziona Piani di replica.
-
Selezionare il piano di replicazione.
-
Sulla destra, seleziona l'opzione Actions
 e seleziona Test failover.
-
Nella pagina Test failover, scegli lo snapshot per il test failover: seleziona Crea snapshot ora oppure Seleziona per scegliere uno snapshot esistente. Se scegli Seleziona, scegli lo snapshot esistente.
Quindi inserisci "Test failover" e seleziona Test failover.
-
Una volta completato il test, pulire l'ambiente di prova.
Pulisci l'ambiente di test dopo un test di failover
Al termine del test di failover, devi ripulire l'ambiente di test. Questo processo rimuove le risorse di test temporanee e i FlexClones dalla posizione di test. Per i carichi di lavoro VMware, questo include le VM temporanee e i datastore temporanei.
-
Dal menu Disaster Recovery, seleziona Piani di replica.
-
Selezionare il piano di replicazione.
-
A destra, seleziona l'opzione Actions
quindi Clean up failover test. -
Nella pagina Test failover, immettere "Pulisci failover", quindi selezionare Pulisci test failover.
Eseguire il failover del sito di origine su un sito di ripristino di emergenza
In caso di disastro, puoi eseguire il failover del tuo sito primario su richiesta verso il sito di disaster recovery. Per i carichi di lavoro VMware, puoi eseguire il failover del tuo sito VMware on-premises primario verso un altro sito VMware on-premises o VMware Cloud on AWS con FSx for NetApp ONTAP. Per i carichi di lavoro Kubernetes, esegui il failover verso il cluster di destinazione nel piano di replica.
Il processo di failover prevede le seguenti operazioni. Le operazioni che si riferiscono a vCenter, VM o datastore si applicano ai carichi di lavoro VMware; i carichi di lavoro Kubernetes seguono le operazioni equivalenti per le rispettive applicazioni e i volumi persistenti:
-
Disaster Recovery esegue controlli preliminari sul cluster di destinazione e sulla relazione SnapMirror .
-
Se hai selezionato l'ultima istantanea, verrà eseguito l'aggiornamento SnapMirror per replicare le modifiche più recenti.
-
Le macchine virtuali di origine sono spente.
-
La relazione di SnapMirror è interrotta e il volume di destinazione è impostato su lettura/scrittura.
-
In base alla selezione dello snapshot, il file system attivo viene ripristinato allo snapshot specificato (più recente o selezionato).
-
Gli archivi dati vengono creati e montati sul cluster o sull'host VMware o VMC in base alle informazioni acquisite nel piano di replica. Se alcuni datastore sono VMFS, creare e mappare un iGroup su ogni LUN.
-
Le macchine virtuali di destinazione vengono registrate all'interno di vCenter come nuovi datastore.
-
Le macchine virtuali di destinazione vengono avviate in base all'ordine di avvio acquisito nella pagina Gruppi di risorse.
-
Se la sorgente vCenter è ancora attiva, spegni tutte le VM lato sorgente che stanno passando in failover.
-
Riattiva tutte le applicazioni di database supportate nelle VM indicate come "coerenti con l'applicazione".
-
Se i cluster vCenter e ONTAP di origine sono ancora attivi, crea una relazione di SnapMirror in direzione inversa per replicare eventuali modifiche apportate durante lo stato di failover al sito di origine. La relazione di SnapMirror viene invertita dalla macchina virtuale di destinazione a quella di origine.

|
Per i carichi di lavoro VMware, dopo l'avvio del failover, puoi vedere le VM ripristinate nel vCenter del sito di disaster recovery (VM, reti e datastore). Per impostazione predefinita, le VM vengono ripristinate nella cartella Workload. |
Per i piani di replica basati su datastore, se hai aggiunto e individuato delle VM ma non hai fornito dettagli di mappatura, tali VM vengono incluse nel failover. Il failover fallirà e verrà visualizzata una notifica nei processi. Per completare correttamente il failover, è necessario fornire i dettagli di mappatura.
-
Dal menu Disaster Recovery, seleziona Piani di replica.
-
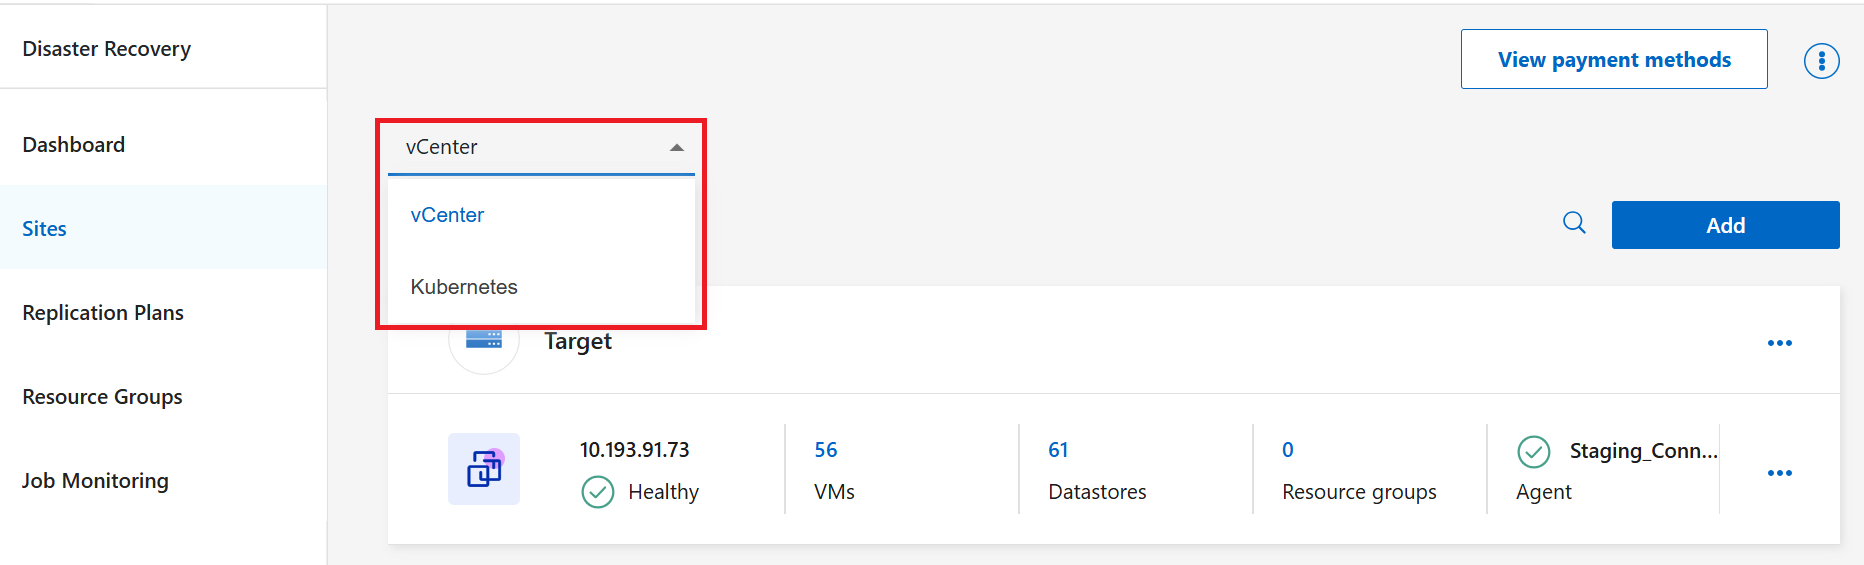
Nel menu a tendina, filtra per vCenter piani di replica.
-
Selezionare il piano di replicazione.
-
Sulla destra, seleziona l'opzione Azioni
, posiziona il cursore su Ripristina e quindi seleziona Fail over.
-
Scegli la copia snapshot che vuoi usare per il failover:
-
Scegli Crea snapshot ora per creare un nuovo snapshot che verrà copiato nel cluster di destinazione prima del failover.
-
Scegli Usa snapshot più recente per utilizzare lo snapshot più recente disponibile sul cluster di destinazione.
-
Scegli Seleziona per visualizzare un elenco di snapshot ordinate per data più recente.

Quando selezioni una baseline di snapshot specifica, gli snapshot di trasferimento SnapMirror sono nascosti per impostazione predefinita perché possono essere eliminati durante un failover. Questa eliminazione porta all'impossibilità di riproteggere il carico di lavoro dopo il failover a causa di un errore "no common snapshot found". Puoi comunque usare gli snapshot di trasferimento SnapMirror, ma dovrai completare una conferma aggiuntiva per riconoscere il rischio.
-
-
Seleziona Forza failover se vuoi che il failover continui anche quando il servizio rileva un errore che normalmente lo bloccherebbe.
-
Seleziona Ignora protezione se non vuoi che il servizio crei automaticamente una relazione di protezione SnapMirror inversa dopo un failover del piano di replica. Questa opzione è utile se vuoi eseguire operazioni aggiuntive sul sito ripristinato prima di riportarlo online in Disaster Recovery.
È possibile impostare la protezione inversa selezionando Proteggi risorse dal menu Azioni del piano di replica. In questo modo si tenta di creare una relazione di replicazione inversa per ogni volume nel piano. È possibile eseguire questo processo più volte finché la protezione non viene ripristinata. Una volta ripristinata la protezione, è possibile avviare un failback nel modo consueto. -
Digitare "failover" nella casella.
-
Selezionare Fail over.
-
Per controllare l'avanzamento, nel menu selezionare Monitoraggio lavori.
-
Dal menu Disaster Recovery, seleziona Piani di replica.
-
Nel menu a tendina, filtra per piani di replica Kubernetes.
-
Selezionare il piano di replicazione.
-
Sulla destra, seleziona l'opzione Azioni
, posiziona il cursore su Ripristina e quindi seleziona Fail over. -
Scegli la copia snapshot che vuoi usare per il failover:
-
Scegli Crea snapshot ora per creare un nuovo snapshot che verrà copiato nel cluster di destinazione.
-
Scegli Usa snapshot più recente per utilizzare lo snapshot più recente disponibile sul cluster di destinazione.
-
Scegli Seleziona per visualizzare un elenco di snapshot ordinate per data più recente.
Quando selezioni una baseline di snapshot specifica, gli snapshot di trasferimento SnapMirror sono nascosti per impostazione predefinita perché possono essere eliminati durante un failover. Questa eliminazione porta all'impossibilità di riproteggere il carico di lavoro dopo il failover a causa di un errore "no common snapshot found". Puoi comunque usare gli snapshot di trasferimento SnapMirror, ma dovrai completare una conferma aggiuntiva per riconoscere il rischio.
-
-
Seleziona Skip protection se non vuoi che Disaster Recovery crei automaticamente una relazione di protezione di SnapMirror inversa dopo un failover del piano di replica. Questa opzione è utile se vuoi eseguire ulteriori operazioni sul sito ripristinato prima di riportarlo online in Disaster Recovery.
-
Digita "Failover" per confermare l'azione, quindi seleziona Failover.
È possibile monitorare lo stato del job in Monitoraggio job o Piani di replica.