


NetApp Disaster Recovery 사용하여 원격 사이트로 애플리케이션 장애 조치


 변경 제안

 PDF

재해 또는 이와 유사한 상황이 발생하면 NetApp Disaster Recovery를 사용하여 중요 워크로드를 복구하고 계획된 매핑을 통해 재해 복구 사이트에서 애플리케이션을 다시 시작할 수 있습니다.
재해 복구는 장애 조치 테스트도 지원합니다. 테스트를 수행하면 프로세스에 익숙해지고 복구가 예상대로 작동하는지 확인할 수 있습니다.
필요한 NetApp Console 역할 이 작업을 수행하려면 Super admin, Disaster recovery admin 또는 Disaster recovery failover admin 역할이 필요합니다. "NetApp Disaster Recovery 의 사용자 역할 및 권한에 대해 알아보세요.". "모든 서비스에 대한 NetApp Console 액세스 역할에 대해 알아보세요.".
이 작업 정보
장애 조치 시 재해 복구는 기본적으로 가장 최근의 SnapMirror 스냅샷 복사본을 사용하지만, 특정 시점 스냅샷에서 특정 스냅샷을 선택할 수 있습니다(SnapMirror의 보존 정책에 따라). 랜섬웨어 공격 등 가장 최근의 복제본이 손상된 경우 특정 시점 옵션을 사용하십시오.
이 프로세스는 프로덕션 사이트가 정상인지 여부와 중요 인프라 장애 외의 다른 이유로 재해 복구 사이트로 장애 조치를 수행하는지에 따라 다릅니다.
-
소스 vCenter, Kubernetes 클러스터 또는 ONTAP 클러스터에 액세스할 수 없는 중요한 프로덕션 사이트 장애: 재해 복구를 통해 사용 가능한 스냅샷 중에서 복원할 스냅샷을 선택할 수 있습니다.
-
프로덕션 환경이 정상입니다. "지금 스냅샷을 찍으세요" 또는 이전에 만든 스냅샷을 선택할 수 있습니다.
이 절차는 복제 관계를 끊고 소스 워크로드를 오프라인으로 전환한 다음, 복제된 볼륨을 재해 복구 사이트에서 사용할 수 있도록 하고, 계획에 포함된 장애 조치 규칙을 사용하여 보호된 워크로드를 다시 시작하고, 대상 사이트에서 읽기/쓰기 권한을 활성화합니다. VMware 워크로드의 경우, 서비스는 vCenter 소스 VM을 오프라인으로 전환하고, 볼륨을 재해 복구 vCenter의 데이터스토어로 등록하며, 보호된 VM을 다시 시작합니다. Kubernetes 워크로드도 애플리케이션 및 영구 볼륨에 대해 동일한 순서를 따릅니다.
장애 조치 프로세스 테스트
실제 장애 조치를 수행하기 전에 테스트를 통해 준비 상태를 확인할 수 있습니다. 테스트 과정 동안 워크로드는 온라인 상태를 유지합니다.
VMware 워크로드의 페일오버 테스트 중에 재해 복구는 임시로 VM을 생성합니다. 재해 복구는 FlexClone 볼륨을 지원하는 임시 데이터 저장소를 ESXi 호스트에 매핑합니다. Kubernetes 워크로드의 페일오버 테스트는 타겟 클러스터의 보호된 애플리케이션 및 영구 볼륨에 대해 동일한 시퀀스를 따릅니다.
이 프로세스는 온프레미스 ONTAP 스토리지 또는 AWS의 NetApp ONTAP 스토리지용 FSx에 추가적인 물리적 용량을 소모하지 않습니다. 원본 소스 볼륨은 수정되지 않으며, 복제 작업은 재해 복구 중에도 계속될 수 있습니다.
테스트를 완료하면 테스트 정리 옵션을 사용하여 테스트 환경을 초기화하는 것이 좋습니다.
테스트 장애 조치 작업은 프로덕션 워크로드, 테스트 사이트에서 사용되는 SnapMirror 관계, 그리고 정상적으로 작동을 계속해야 하는 보호 워크로드에는 영향을 미치지 않습니다.
테스트 페일오버를 위해 재해 복구는 다음과 같은 작업을 수행합니다.
-
대상 클러스터와 SnapMirror 관계에 대한 사전 검사를 수행합니다.
-
대상 사이트 ONTAP 클러스터의 각 보호된 ONTAP 볼륨에 대해 선택한 스냅샷에서 새 FlexClone 볼륨을 만듭니다.
-
데이터 저장소가 VMFS인 경우 각 LUN에 iGroup을 생성하여 매핑합니다.
-
타겟 VM을 vCenter 내에 새 데이터스토어로 등록합니다.
-
리소스 그룹 페이지에 캡처된 부팅 순서에 따라 타겟 VM의 전원을 켜십시오.
-
"애플리케이션 일관성"으로 표시된 VM에서 지원되는 모든 데이터베이스 애플리케이션을 취소합니다.
-
소스 vCenter 및 ONTAP 클러스터가 여전히 활성 상태인 경우, 장애 조치 상태에서 모든 변경 사항을 원래 소스 사이트로 복제하기 위해 역방향 SnapMirror 관계를 만듭니다.
-
에 로그인하세요 "NetApp Console" .
-
NetApp Console 왼쪽 탐색에서 보호 > *재해 복구*를 선택합니다.
-
재해 복구 메뉴에서 *복제 계획*을 선택합니다.
-
복제 계획을 선택하세요.
-
오른쪽에서 작업 옵션을 선택
 하고 *페일오버 테스트*를 선택합니다.
-
테스트 페일오버 페이지에서 테스트 페일오버에 사용할 스냅샷을 선택합니다. 지금 스냅샷 생성을 선택하거나 기존 스냅샷을 선택하려면 선택을 선택합니다. 선택을 선택하는 경우 기존 스냅샷을 선택하십시오.
그런 다음 "Test failover"를 입력하고 *Test failover*를 선택합니다.
-
테스트가 완료되면 테스트 환경을 정리합니다.
장애 조치 테스트 후 테스트 환경 정리
장애 조치 테스트가 완료되면 테스트 환경을 정리해야 합니다. 이 프로세스는 테스트 위치에서 임시 테스트 리소스와 FlexClones를 제거합니다. VMware 워크로드의 경우 여기에는 임시 VM과 임시 데이터스토어가 포함됩니다.
-
재해 복구 메뉴에서 *복제 계획*을 선택합니다.
-
복제 계획을 선택하세요.
-
오른쪽에서 작업 옵션을 선택한
다음 *장애 조치 테스트 정리*를 선택합니다. -
테스트 페일오버 페이지에서 "페일오버 정리"를 입력한 다음 "페일오버 테스트 정리"를 선택합니다.
소스 사이트를 재해 복구 사이트로 장애 조치합니다.
재해가 발생할 경우, 필요에 따라 기본 사이트를 재해 복구 사이트로 페일오버합니다. VMware 워크로드의 경우, 기본 온프레미스 VMware 사이트를 다른 온프레미스 VMware 사이트 또는 FSx for NetApp ONTAP이 포함된 VMware Cloud on AWS로 페일오버할 수 있습니다. Kubernetes 워크로드의 경우, 복제 계획의 타겟 클러스터로 페일오버합니다.
장애 조치 프로세스는 다음과 같은 작업으로 구성됩니다. vCenter, VM 또는 데이터스토어를 참조하는 작업은 VMware 워크로드에 적용되며, Kubernetes 워크로드는 애플리케이션 및 영구 볼륨에 대해 동일한 작업을 따릅니다:
-
재해 복구는 대상 클러스터와 SnapMirror 관계에 대한 사전 검사를 수행합니다.
-
최신 스냅샷을 선택한 경우 SnapMirror 업데이트가 수행되어 최신 변경 사항이 복제됩니다.
-
소스 VM의 전원이 꺼집니다.
-
SnapMirror 관계가 끊어지고 타겟 볼륨이 읽기/쓰기 모드로 설정되었습니다.
-
스냅샷 선택에 따라 활성 파일 시스템은 지정된 스냅샷(최신 또는 선택)으로 복원됩니다.
-
데이터스토어는 복제 계획에서 수집된 정보를 기반으로 VMware 또는 VMC 클러스터나 호스트에 생성되어 마운트됩니다. 데이터 저장소가 VMFS인 경우 각 LUN에 iGroup을 생성하여 매핑합니다.
-
타겟 VM은 vCenter 내에 새 데이터 저장소로 등록됩니다.
-
타겟 VM은 리소스 그룹 페이지에 기록된 부팅 순서에 따라 전원이 켜집니다.
-
원본 vCenter가 여전히 활성화된 경우, 페일오버 대상인 원본 측 VM을 모두 종료하십시오.
-
"애플리케이션 일관성"으로 표시된 VM에서 지원되는 모든 데이터베이스 애플리케이션을 취소합니다.
-
소스 vCenter 및 ONTAP 클러스터가 여전히 활성화된 경우, 페일오버 상태에서 변경 사항을 원래 소스 사이트로 다시 복제하기 위해 역방향 SnapMirror 관계를 생성하십시오. SnapMirror 관계는 타겟 가상 머신에서 소스 가상 머신으로 역전됩니다.

|
VMware 워크로드의 경우, 장애 조치가 시작된 후 재해 복구 사이트의 vCenter에서 복구된 VM(VM, 네트워크 및 데이터스토어)을 확인할 수 있습니다. 기본적으로 VM은 워크로드 폴더에 복구됩니다. |
데이터스토어 기반 복제 계획의 경우, VM을 추가하고 검색했지만 매핑 세부 정보를 제공하지 않은 경우 해당 VM이 장애 조치에 포함됩니다. 장애 조치가 실패하면 작업에 알림이 표시됩니다. 장애 조치를 성공적으로 완료하려면 매핑 세부 정보를 제공해야 합니다.
-
재해 복구 메뉴에서 *복제 계획*을 선택합니다.
-
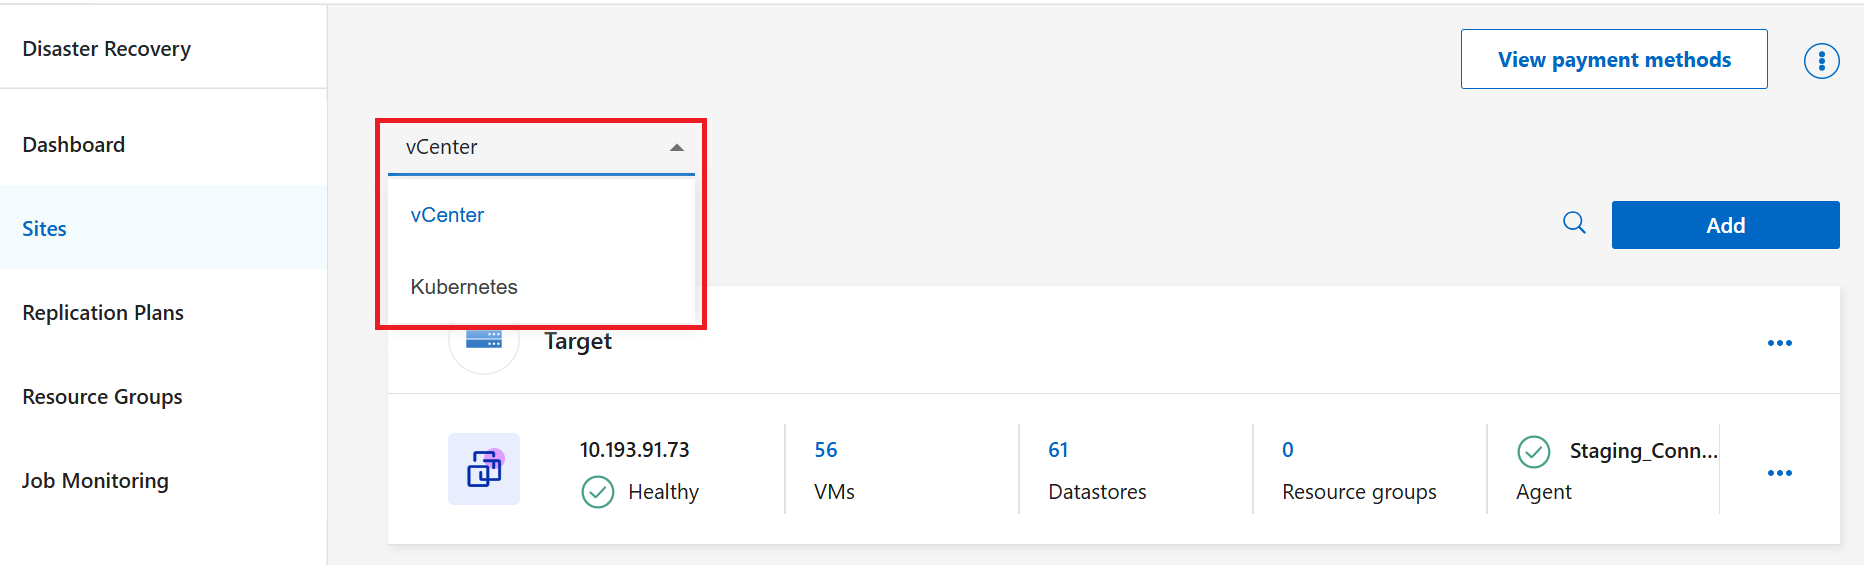
드롭다운 메뉴에서 vCenter 복제 계획을 필터링합니다.
-
복제 계획을 선택하세요.
-
오른쪽에서 Actions 옵션
을 선택하고 Recover 위로 마우스를 가져간 다음 *Fail over*를 선택합니다.
-
페일오버에 사용할 스냅샷 복사본을 선택하십시오.
-
페일오버 전에 타겟 클러스터로 복사될 새 스냅샷을 생성하려면 *지금 스냅샷 생성*을 선택하십시오.
-
타겟 클러스터에서 사용 가능한 가장 최근 스냅샷을 사용하려면 Use latest snapshot 을 선택합니다.
-
최근 항목 순으로 정렬된 스냅샷 목록을 검토하려면 *선택*을 클릭하십시오.

특정 스냅샷 기준선을 선택할 때, SnapMirror 전송 스냅샷은 장애 조치 도중에 삭제될 수 있으므로 기본적으로 숨겨집니다. 이러한 삭제는 "공통 스냅샷을 찾을 수 없음" 오류로 인해 장애 조치 후 워크로드를 다시 보호할 수 없게 만듭니다. SnapMirror 전송 스냅샷을 계속 사용할 수는 있지만, 위험을 인지하고 동의하는 추가 확인 절차를 완료해야 합니다.
-
-
서비스에서 일반적으로 장애 조치를 차단하는 오류가 감지되더라도 장애 조치가 계속되도록 하려면 *Force failover*를 선택하십시오.
-
복제 계획 장애 조치 후 서비스에서 역방향 SnapMirror 보호 관계를 자동으로 생성하지 않도록 하려면 *보호 건너뛰기*를 선택하십시오. 이 옵션은 재해 복구 내에서 사이트를 다시 온라인 상태로 전환하기 전에 복원된 사이트에서 추가 작업을 수행하려는 경우에 유용합니다.
복제 계획 작업 메뉴에서 *리소스 보호*를 선택하여 역방향 보호를 설정할 수 있습니다. 이는 계획의 각 볼륨에 대해 역방향 복제 관계를 생성하려고 시도합니다. 보호가 복구될 때까지 이 작업을 반복해서 실행할 수 있습니다. 보호가 복구되면 평소와 같은 방식으로 장애 복구를 시작할 수 있습니다. -
상자에 "장애 조치"를 입력합니다.
-
*장애 조치*를 선택합니다.
-
진행 상황을 확인하려면 메뉴에서 *작업 모니터링*을 선택하세요.
-
재해 복구 메뉴에서 *복제 계획*을 선택합니다.
-
드롭다운 메뉴에서 Kubernetes 복구 계획으로 필터링합니다.
-
복제 계획을 선택하세요.
-
오른쪽에서 Actions 옵션
을 선택하고 Recover 위로 마우스를 가져간 다음 *Fail over*를 선택합니다. -
페일오버에 사용할 스냅샷 복사본을 선택하십시오.
-
Take snapshot now 를 선택하여 타겟 클러스터에 복사될 새 스냅샷을 생성합니다.
-
타겟 클러스터에서 사용 가능한 가장 최근 스냅샷을 사용하려면 Use latest snapshot 을 선택합니다.
-
최근 항목 순으로 정렬된 스냅샷 목록을 검토하려면 *선택*을 클릭하십시오.
특정 스냅샷 기준선을 선택할 때, SnapMirror 전송 스냅샷은 장애 조치 도중에 삭제될 수 있으므로 기본적으로 숨겨집니다. 이러한 삭제는 "공통 스냅샷을 찾을 수 없음" 오류로 인해 장애 조치 후 워크로드를 다시 보호할 수 없게 만듭니다. SnapMirror 전송 스냅샷을 계속 사용할 수는 있지만, 위험을 인지하고 동의하는 추가 확인 절차를 완료해야 합니다.
-
-
복제 계획 장애 조치 후 재해 복구에서 역방향 SnapMirror 보호 관계를 자동으로 생성하지 않으려면 *보호 건너뛰기*를 선택하십시오. 이 옵션은 재해 복구를 통해 사이트를 다시 온라인 상태로 전환하기 전에 복원된 사이트에서 추가 작업을 수행하려는 경우에 유용합니다.
-
작업을 확인하려면 "Failover"를 입력한 다음 *Failover*를 선택하십시오.
작업 상태는 Job monitoring 또는 *Replication plans*에서 확인할 수 있습니다.