


在 Active IQ Unified Manager 中的集群上分析 MetroCluster 性能事件
 建议更改

 PDF

您可以使用 Unified Manager 在检测到性能事件的 MetroCluster 配置中分析集群。您可以确定集群名称、事件检测时间以及所涉及的 bully 和 victim 工作负载。
-
您必须具有操作员、应用程序管理员或存储管理员角色。
-
MetroCluster 配置必须有新的、已确认的或过时的性能事件。
-
MetroCluster 配置中的两个集群必须由同一个 Unified Manager 实例监控。
-
显示*事件详细信息*页面以查看有关该事件的信息。
-
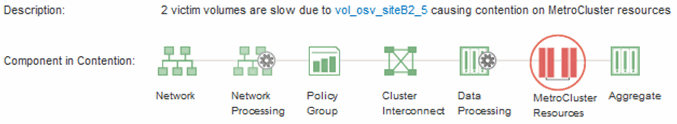
查看事件描述,了解所涉及的工作负载名称以及所涉及的工作负载数量。
在此示例中,“MetroCluster 资源”图标为红色,表示 MetroCluster 资源处于争用状态。将光标定位在图标上以显示图标的说明。
-
记下集群名称和事件检测时间,您可以使用这些信息来分析配对集群上的性能事件。
-
在图表中,查看 victim 工作负载,以确认其响应时间高于性能阈值。
在此示例中,受害者工作负载显示在悬停文本中。延迟图表在较高层面上显示了所涉及的受害者工作负载的一致延迟模式。即使受害者工作负载的异常延迟触发了事件,一致的延迟模式也可能表明工作负载正在其预期范围内执行,但 I/O 峰值增加了延迟并触发了事件。
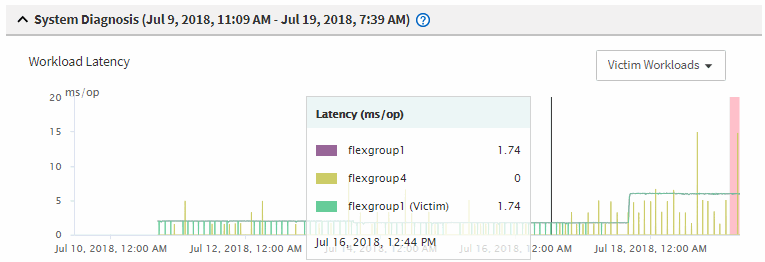
如果您最近在访问这些卷工作负载的客户端上安装了一个应用程序,并且该应用程序向它们发送了大量的 I/O,则您可能会预期它们的延迟会增加。如果工作负载的延迟返回到预期范围内,事件状态更改为已过时,并保持此状态超过 30 分钟,则您可能可以忽略该事件。如果事件正在进行中,并且仍处于新状态,则可以进一步进行调查,以确定是否有其他问题导致该事件。
-
在工作负载吞吐量图表中,选择*恶霸工作负载*以显示恶霸工作负载。
欺凌工作负载的存在表明,该事件可能是由本地集群上的一个或多个工作负载过度使用 MetroCluster 资源引起的。欺凌工作负载的写入吞吐量(MB/s)偏差较高。
此图表在较高层级上显示了工作负载的写入吞吐量(MB/s)模式。您可以查看写入 MB/s 模式以识别异常吞吐量,这可能表明工作负载过度使用 MetroCluster 资源。
如果事件中不涉及恶霸工作负载,则该事件可能是由于集群之间的链路存在运行状况问题或配对集群上的性能问题而引起的。您可以使用 Unified Manager 检查 MetroCluster 配置中两个集群的运行状况。您还可以使用 Unified Manager 检查和分析配对集群上的性能事件。