


在 Active IQ Unified Manager 中分析叢集上的 MetroCluster 效能事件
 建議變更

 PDF

您可以使用 Unified Manager 分析在 MetroCluster 組態中偵測到效能事件的叢集。您可以識別叢集名稱、事件偵測時間,以及涉及的 霸凌者 和 受害者 工作負載。
-
您必須擁有操作員、應用程式管理員或儲存管理員角色。
-
針對 MetroCluster 組態,必須有新的、已確認或已過時的效能事件。
-
MetroCluster 組態中的兩個叢集必須由同一個 Unified Manager 執行個體進行監控。
-
顯示 事件詳細資料 頁面以檢視事件的資訊。
-
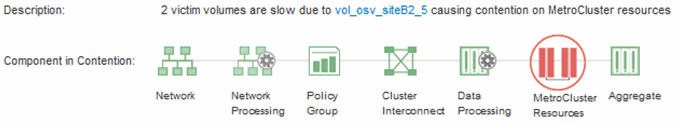
審查事件執行摘要,了解所涉及的工作負載名稱和工作負載數量。
在此範例中,MetroCluster 資源圖示為紅色,表示 MetroCluster 資源發生爭用。將游標停留在圖示上以顯示圖示的執行摘要。
-
請記下叢集名稱和事件偵測時間,以便分析合作夥伴叢集上的效能事件。
-
在圖表中,審查 victim 工作負載,以確認其回應時間高於效能臨界值。
在本例中,受害工作負載顯示在懸停文字中。延遲圖表從高階展示了相關受害工作負載一致的延遲模式。儘管受害工作負載的異常延遲觸發了該事件,但一致的延遲模式可能表明工作負載的效能在其預期範圍內,只是 I/O 峰值導致延遲增加並觸發了該事件。
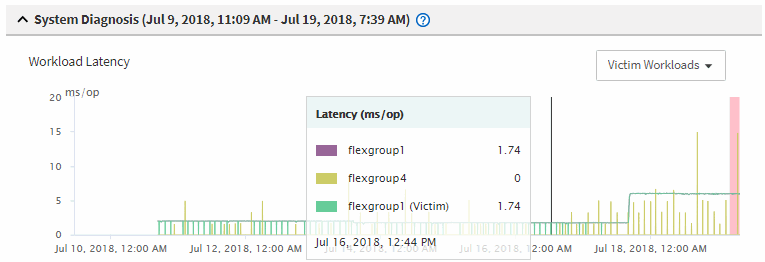
如果您最近在用戶端上安裝了一個應用程式,該應用程式會存取這些 Volume 工作負載,並且向這些工作負載傳送大量 I/O,那麼您可能會預期它們的延遲會增加。如果工作負載的延遲恢復到預期範圍內,事件狀態變更為過時,並且保持此狀態超過 30 分鐘,您可能可以忽略該事件。如果事件為後續,並且保持在新狀態,您可以進一步調查以確定是否是其他問題導致了該事件。
-
在工作負載處理量圖表中,選取 惡霸工作負載 以顯示惡霸工作負載。
存在霸佔資源的工作負載表示,該事件可能是由本機叢集上一個或多個工作負載過度使用 MetroCluster 資源所引起。霸佔資源的工作負載在寫入處理量(MB/s)上有較大的偏差。
此圖表以高階展示了工作負載的寫入處理量(MB/s)模式。您可以審查寫入 MB/s 模式,以識別異常處理量,這可能表示某個工作負載過度利用了 MetroCluster 資源。
如果事件中不涉及任何惡意工作負載,則該事件可能是由叢集間連結的健全狀況問題或合作夥伴叢集的效能問題所引起。您可以使用 Unified Manager 檢查 MetroCluster 組態中兩個叢集的健全狀況。您也可以使用 Unified Manager 檢查和分析合作夥伴叢集上的效能事件。