


5.解決方案設計與儲存架構詳情

 建議變更

 PDF

Karthikeyan Nagalingam, NetApp
[[5-1-design-principles]]
== 5.1 設計原則
組態優於程式碼變更;具有類型化契約的明確階段邊界;一致的工件路由;具有可操作錯誤的快速失敗驗證;儲存設備分層中立性。
[[5-2-stage-design-summary]]
== 5.2 階段設計概要
| 階段 | 設計概要 |
|---|---|
攝取 |
|
資料準備 |
探索/接受原始 StorageGRID 表格鍵;規範化 Airbyte/純 CSV;產生確定性的訓練/驗證/推論分割;將帶有執行戳記的準備資料前綴和清單寫入 ONTAP NAS 儲存桶 |
資料移動性(XCP) |
從 ONTAP NAS NFS 匯出複製已準備好的資料; |
模型訓練 |
在本地或從 XCP 目的地(S3/LustreFS)進行訓練;多格式(CSV/Parquet/JSON)探索 |
微調 |
從 XCP 目的地物化基礎模型; |
推理 |
從相同 XCP 目的地實體化調整後的工件;可設定分割/文字範圍 |
檢查點/恢復 |
`write_stage_checkpoint`儲存完成記錄; `_small_resume_guard`在後續執行時驗證/重複使用 |
歸檔 |
|
[[5-3-configuration-driven-philosophy]]
== 5.3 組態驅動理念
所有非機密儲存設備、引擎和行為選擇都是 `dag_run.conf`參數——在 S3 和 LustreFS 之間切換,或在 Python 和 Spark 之間切換,無需修改程式碼,而 Airflow 管理的機密儲存設備會解析所需的憑證。
[[5-4-storage-architecture-detail]]
== 5.4 儲存架構詳情
儲存架構將 AI 生命週期劃分為專為特定用途所打造的分層:StorageGRID 儲存原始與歸檔物件,ONTAP NAS 儲存體儲存已準備好且帶有執行戳記的資料集,而 ONTAP S3 或 LustreFS 則提供選定的作用中訓練分層。這種分離使得來源資料、已準備好的資料、模型工件與歸檔證據保持獨立且可管理的,同時透過共享的 `run_stamp`保留歷程。
[[5-4-1-storage-layout-diagrams]]
=== 5.4.1 儲存設備佈局圖
| 層級 | 邏輯儲存設備路徑 | 儲存的內容 / 成品 |
|---|---|---|
StorageGRID 原始分層 |
|
表格 CSV 部分 ( |
ONTAP NAS 準備分層 |
|
格式化分割 ( |
作用中訓練分層(XCP 目的地) |
|
複製的資料分割、訓練好的模型二進位檔( |
StorageGRID 歸檔分層 |
|
階段範圍的基線或完整模型工件、預測證據( |
分層間血緣關係與流程 |
原始 → 已準備 → 作用中分層 → 歸檔 |
端到端資料搬移與工件沿襲在所有儲存設備分層之間連結,透過共享的 |
此圖描繪了跨所有儲存設備分層的單一傳輸途徑運行的邏輯儲存桶和前綴佈局:
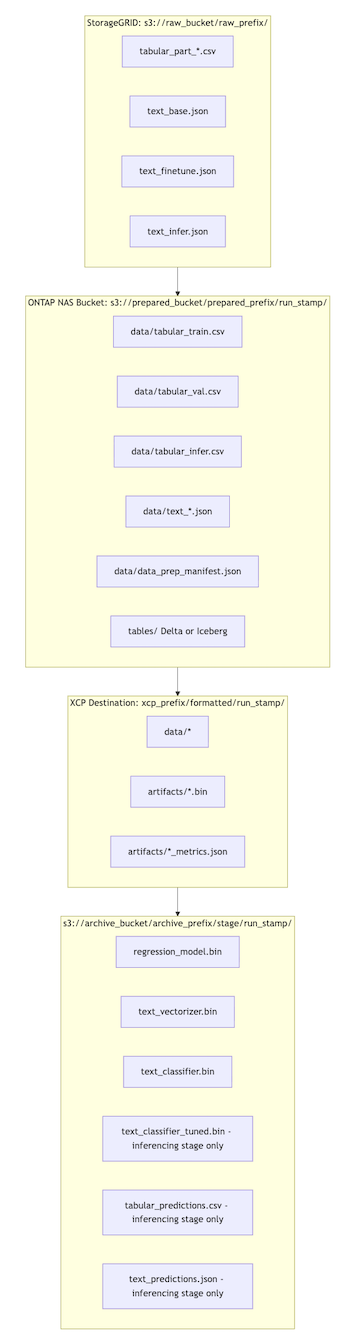
[[5-4-2-storage-sizing-guidance]]
=== 5.4.2 儲存設備規模調整指南
根據各分層的角色和保留政策獨立調整其大小。ONTAP NAS 和選定的 XCP 目的地必須容納並發的作用中執行,而 StorageGRID 容量主要取決於原始資料和歸檔保留。規劃尖峰傳輸途徑並行時,請納入暫時的工作容量與成長空間。
| 層級 | 規模調整依據 |
|---|---|
StorageGRID 原始儲存桶 |
攝取 Volume × 保留期間 |
ONTAP NAS 預先準備的資料儲存桶 |
準備資料集大小 × 保留運行次數 |
XCP 目的地(S3 或 Lustre) |
峰值並行訓練資料集大小 + 模型成品例行成本 |
歸檔儲存體 |
保留政策 × 歸檔階段選擇(模型_訓練 = 較小;推理 = 較大) |
[[5-4-3-storage-performance-considerations]]
=== 5.4.3 儲存效能考量因素
XCP 目的地是每次執行時透過 xcp_copy_destination 選擇的,讓儲存效能符合工作負載,而不是將每個工作負載強制放在同一個分層上。對於行數龐大的資料集、大量並行讀取器或 I/O 密集型訓練,請選擇 LustreFS。對於注重成本、需要彈性存取,且其效能要求不需要並行檔案系統的工作負載,請選擇 ONTAP S3。無論哪種情況,XCP 都能讓資料和模型成品與所選的訓練分層保持一致。