


Verwenden der Workload-Latenz zur Identifizierung von Leistungsproblemen in Active IQ Unified Manager
 Änderungen vorschlagen

 PDFs

Die Workload-Latenz (Antwortzeit) ist die Zeit, die ein Volume in einem Cluster benötigt, um auf E/A-Anforderungen von Clientanwendungen zu reagieren. Unified Manager verwendet die Latenz, um Performance-Ereignisse zu erkennen und Sie darüber zu informieren.
Eine hohe Latenz bedeutet, dass Anfragen von Anwendungen an ein Volume auf einem Cluster länger als üblich dauern. Die Ursache für die hohe Latenz kann im Cluster selbst liegen, beispielsweise durch Engpässe bei einer oder mehreren Clusterkomponenten. Hohe Latenz kann auch durch Probleme außerhalb des Clusters verursacht werden, etwa durch Netzwerkengpässe, Probleme mit dem Client, auf dem die Anwendungen ausgeführt werden, oder Probleme mit den Anwendungen selbst.

|
Unified Manager überwacht lediglich die Workload-Aktivität auf dem Cluster. Es überwacht weder die Anwendungen noch die Clients oder die Pfade zwischen den Anwendungen und dem Cluster. |
Vorgänge im Cluster, wie z. B. Backups oder die Deduplizierung, die den Bedarf an Clusterkomponenten erhöhen, die auch von anderen Workloads genutzt werden, können ebenfalls zu hohen Latenzzeiten führen. Wenn die tatsächliche Latenz den dynamischen Performance Schwellenwert des erwarteten Bereichs (Latenzprognose) überschreitet, analysiert Unified Manager das Ereignis, um festzustellen, ob es sich um ein Performance-Ereignis handelt, das möglicherweise behoben werden muss. Die Latenz wird in Millisekunden pro Vorgang (ms/op) gemessen.
Auf dem Diagramm „Gesamtlatenz“ auf der Seite „Workload-Analyse“ können Sie eine Analyse der Latenzstatistiken anzeigen, um zu sehen, wie sich die Aktivität einzelner Prozesse, z. B. Lese- und Schreibanforderungen, im Vergleich zu den Gesamt-Latenzstatistiken verhält. Der Vergleich hilft Ihnen dabei, festzustellen, welche Operationen die höchste Aktivität aufweisen oder ob bestimmte Operationen ungewöhnliche Aktivität zeigen, die sich auf die Latenz eines Volumes auswirkt. Bei der Analyse von Performance-Ereignissen können Sie anhand der Latenzstatistiken ermitteln, ob ein Ereignis durch ein Problem im Cluster verursacht wurde. Sie können außerdem die spezifischen Workload-Aktivitäten oder Clusterkomponenten identifizieren, die an dem Ereignis beteiligt sind.
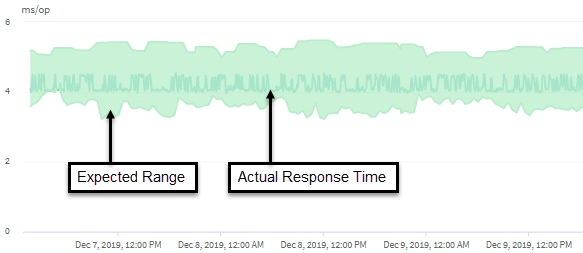
Dieses Beispiel zeigt das Latenzdiagramm. Die tatsächliche Antwortzeit (Latenz) ist eine blaue Linie, und die Latenzprognose (erwarteter Bereich) ist grün.
|
|
Die blaue Linie kann Lücken aufweisen, wenn Unified Manager keine Daten erfassen konnte. Dies kann passieren, wenn der Cluster oder das Volume nicht erreichbar war, Unified Manager währenddessen ausgeschaltet war oder die Datenerfassung länger als die vorgesehenen 5 Minuten dauerte. |