


Erfahren Sie mehr über NetApp Disaster Recovery


 Änderungen vorschlagen

 PDFs

Disaster Recovery in der Cloud ist eine robuste und kostengünstige Möglichkeit, Workloads vor Standortausfällen und Datenbeschädigung zu schützen. NetApp Disaster Recovery ist ein Cloud-basierter Disaster Recovery Service, der Disaster Recovery Workflows für VMware- und Kubernetes-Workloads automatisiert, die auf NetApp Storage ausgeführt werden. Mit Disaster Recovery können Sie die folgenden Workloads schützen:
-
VMware Workloads: NFS-basierte Workloads und VMware vSphere Virtual Machine File System (VMFS) Datastores für iSCSI und FC. Sie können sie zu einem der folgenden Ziele replizieren:
-
Amazon Elastic VMware Service (EVS) mit Amazon FSx für NetApp ONTAP. Weitere Informationen finden Sie unter "Einführung in die Notfallwiederherstellung mit Amazon Elastic VMware Service und Amazon FSx for NetApp ONTAP".
-
VMware Cloud (VMC) auf AWS mit Amazon FSx for NetApp ONTAP
-
Azure VMware Solution mit NetApp Cloud Volumes ONTAP (iSCSI) (Private Preview)
-
Google Cloud VMware Engine (GCVE) mit Google Cloud NetApp Volumes
-
Eine weitere lokale NFS- und/oder VMFS-basierte (iSCSI/FC) VMware Umgebung mit ONTAP Speicher
-
-
Kubernetes-Workloads: Applikationen, die auf Ihren lokalen Kubernetes-Clustern, einschließlich OpenShift Virtualization Umgebungen, ausgeführt werden und Trident-verwalteten ONTAP Storage verwenden. Diese schützen Sie mit Trident Protect und replizieren sie auf einen anderen Kubernetes-Cluster.
Disaster Recovery nutzt die ONTAP SnapMirror Technologie mit integrierter nativer VMware Orchestrierung oder Trident Protect Orchestrierung, um VMware VMs und die zugehörigen OS Images auf Festplatte sowie Kubernetes Applikationen zu schützen und gleichzeitig alle Storage Effizienzvorteile von ONTAP beizubehalten. Disaster Recovery verwendet diese Technologien als Replikationstransport zum Disaster Recovery Standort. Dies ermöglicht branchenweit beste Storage Effizienz (Komprimierung und Deduplizierung) an primären und sekundären Standorten.
NetApp Console
Disaster Recovery ist über die NetApp Console zugänglich.
Die NetApp Console ermöglicht eine zentrale Verwaltung von NetApp -Speicher- und Datendiensten in lokalen und Cloud-Umgebungen auf Unternehmensebene. Die Konsole ist für den Zugriff auf und die Nutzung der NetApp -Datendienste erforderlich. Als Verwaltungsschnittstelle ermöglicht es Ihnen, viele Speicherressourcen über eine Schnittstelle zu verwalten. Konsolenadministratoren können den Zugriff auf Speicher und Dienste für alle Systeme innerhalb des Unternehmens steuern.
Sie benötigen weder eine Lizenz noch ein Abonnement, um die NetApp Console zu nutzen, und es fallen nur dann Kosten an, wenn Sie Console-Agenten in Ihrer Cloud bereitstellen müssen, um die Konnektivität zu Ihren Speichersystemen oder NetApp Datendiensten sicherzustellen. Einige von der Console aus zugängliche NetApp Datendienste sind jedoch lizenz- oder abonnementbasiert.
Erfahren Sie mehr über die "NetApp Console" .
Vorteile der Nutzung von Disaster Recovery
Disaster Recovery bietet folgende Vorteile:
-
Vereinfachte Benutzererfahrung für die Erkennung von vCenter und Kubernetes-Clustern sowie die Wiederherstellung von Applikationen mit mehreren zeitpunktgenauen Wiederherstellungsvorgängen.
-
Niedrigere Gesamtbetriebskosten durch reduzierte Betriebskosten und die Möglichkeit, Notfallwiederherstellungspläne mit minimalem Ressourcenaufwand zu erstellen und anzupassen.
-
Kontinuierliche Notfallwiederherstellungsbereitschaft mit virtuellen Failover-Tests, die den Betrieb nicht unterbrechen. Sie können Ihre DR-Failover-Pläne regelmäßig testen, ohne die Produktionsarbeitslast zu beeinträchtigen.
-
Schnellere Wertschöpfung durch dynamische Änderungen in Ihrer IT-Umgebung und die Möglichkeit, diese in Ihren Notfallwiederherstellungsplänen zu berücksichtigen.
-
Möglichkeit, sowohl die Speicher- als auch die virtuellen Ebenen durch Backend-Orchestrierung von ONTAP und VMware gleichzeitig zu verwalten, ohne dass virtuelle Server-Appliances (VSAs) bereitgestellt und gewartet werden müssen.
-
Applikationszentrierter Schutz für Kubernetes-Workloads mit derselben ONTAP SnapMirror Technologie und Trident Protect Orchestrierung. Ressourcentransformationen ermöglichen die Anpassung von Workloads an die Wiederherstellungsumgebung während des Failovers.
-
DR-Lösungen für VMware können ressourcenintensiv sein. Viele DR-Lösungen replizieren VMs auf der virtuellen VMware-Ebene mithilfe von VSAs, was mehr Rechenressourcen verbrauchen und zu einem Verlust der wertvollen Speichereffizienz von ONTAP führen kann. Da Disaster Recovery die ONTAP SnapMirror -Technologie verwendet, kann es mithilfe unseres inkrementellen Replikationsmodells mit allen nativen Datenkomprimierungs- und Deduplizierungseffizienzen von ONTAP Daten von Produktionsdatenspeichern zum DR-Standort replizieren.
Funktionen von Disaster Recovery
Disaster Recovery bietet Ihnen die volle Nutzung verschiedener NetApp Technologien, um die folgenden Ziele zu erreichen:
-
Replizieren Sie VMware-Apps auf Ihrem lokalen Produktionsstandort mithilfe der SnapMirror -Replikation an einen Remote-Standort zur Notfallwiederherstellung in der Cloud oder vor Ort.
-
Kubernetes-Applikationen lassen sich mithilfe von SnapMirror Replikation und Trident Protect auf einen Ziel-Kubernetes-Cluster replizieren.
-
VMware-Workloads lassen sich von Ihrem ursprünglichen Standort zu einem anderen Standort migrieren. Eine Migration von Kubernetes-Workloads wird derzeit nicht unterstützt.
-
Es lässt sich ein Failover-Test durchführen. Für VMware Workloads erstellt der Dienst temporäre virtuelle Maschinen. Disaster Recovery erstellt aus dem ausgewählten Snapshot ein neues FlexClone Volume und ordnet den ESXi Hosts einen temporären Datastore zu, der auf dem FlexClone Volume basiert. Dieser Prozess verbraucht keine zusätzliche physische Kapazität auf lokalem ONTAP Storage oder FSx for NetApp ONTAP Storage in AWS. Das ursprüngliche Quellvolume wird nicht geändert, und Replikationsjobs können auch während der Disaster Recovery fortgesetzt werden. Auch das Failover von Kubernetes Workloads lässt sich testen, und die Testressourcen lassen sich anschließend bereinigen.
-
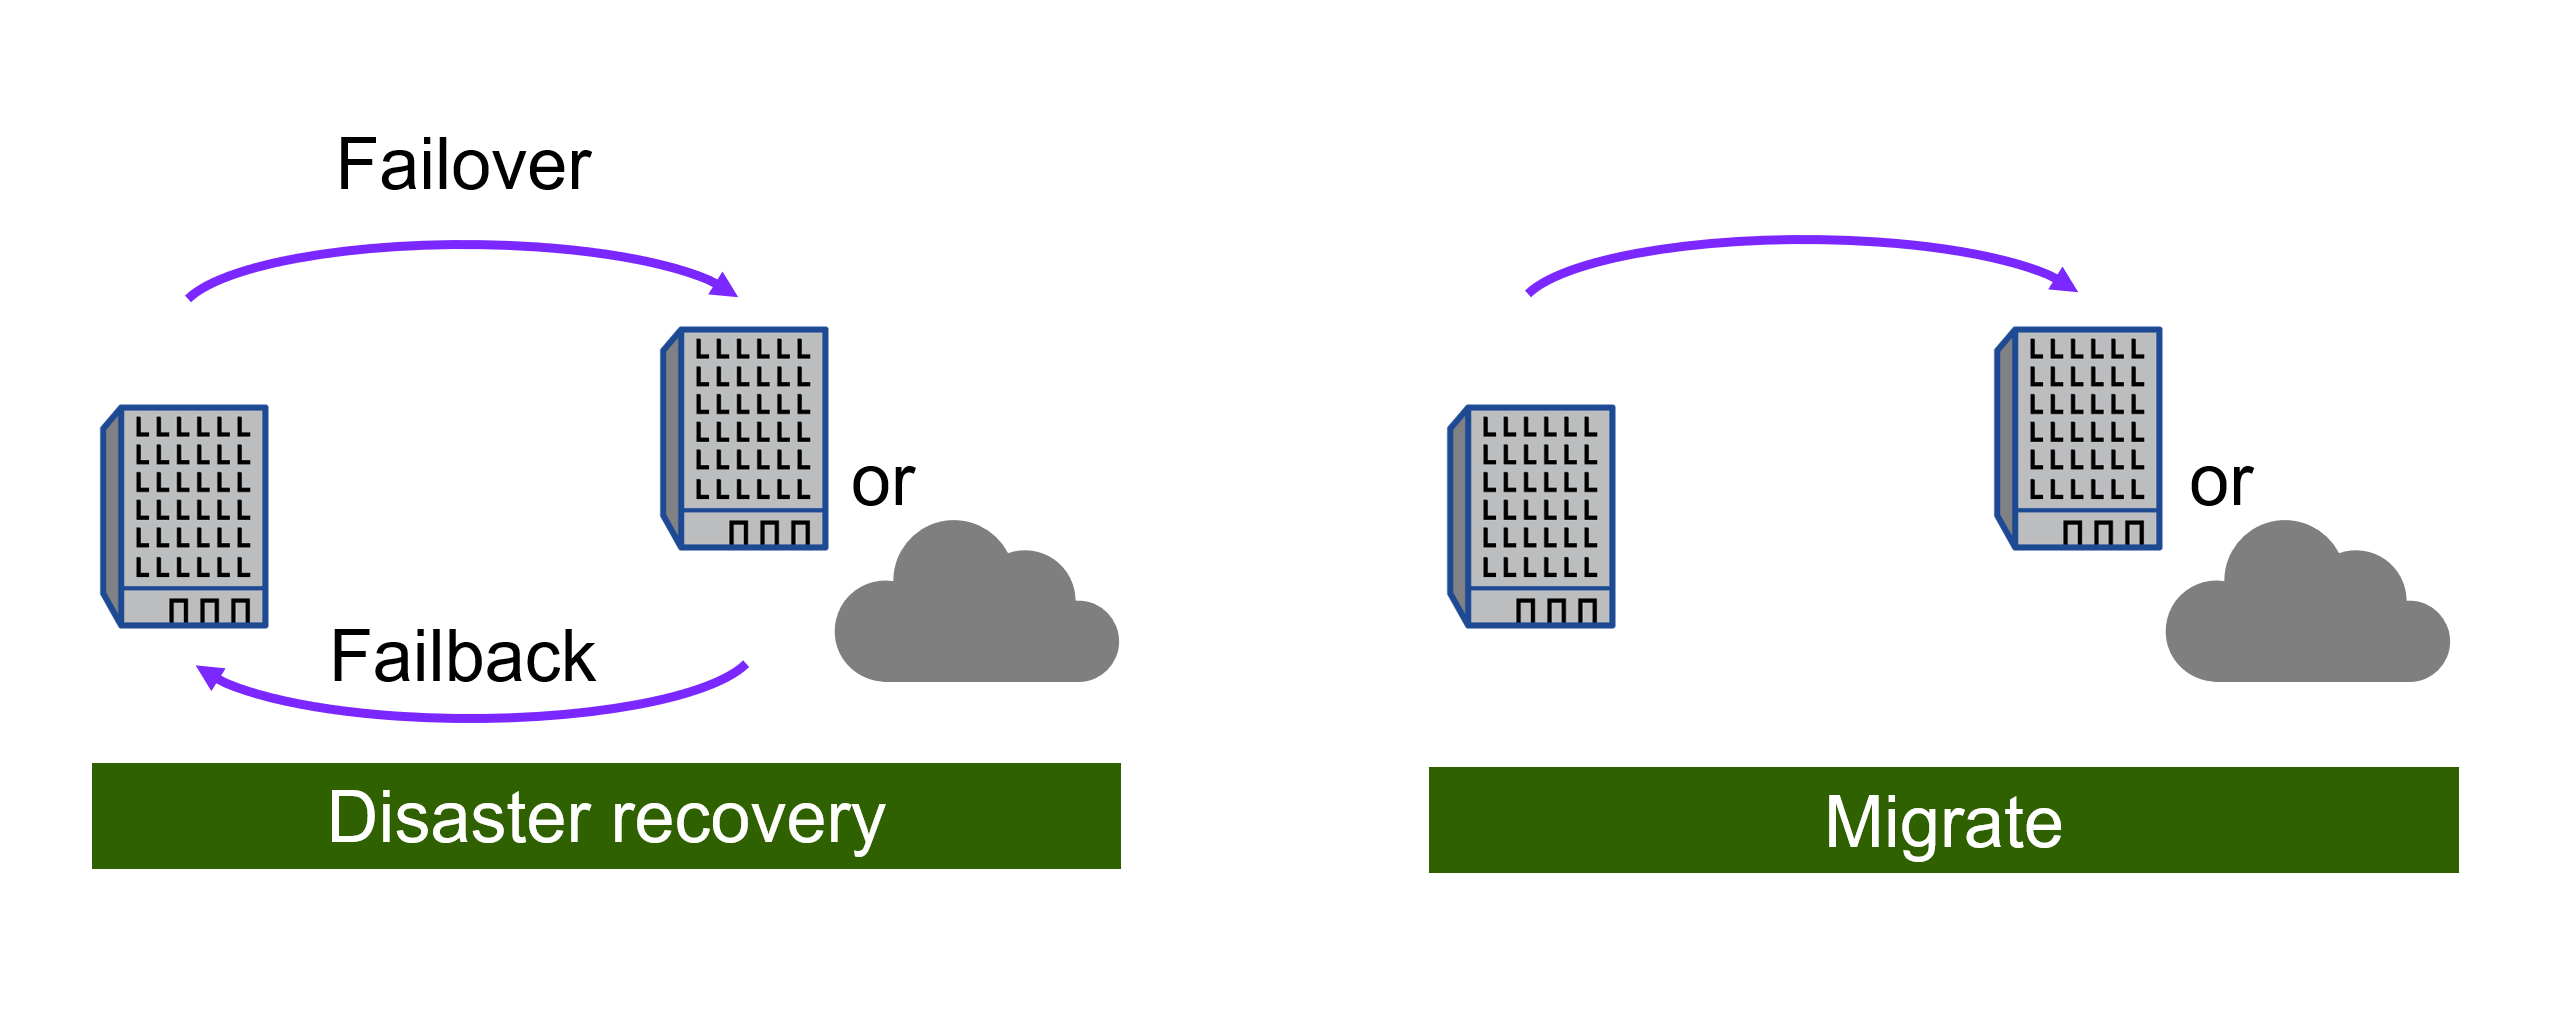
Im Katastrophenfall kann bei Bedarf ein Failover Ihres primären Standorts auf den Disaster-Recovery-Standort erfolgen. Bei VMware Workloads kann der Disaster-Recovery-Standort VMware Cloud on AWS mit Amazon FSx for NetApp ONTAP oder eine lokale VMware Umgebung mit ONTAP sein. Bei Kubernetes Workloads erfolgt das Failover auf den Ziel-Cluster im Replikationsplan.
-
Nachdem der Notfall behoben wurde, führen Sie bei Bedarf ein Failback vom Notfallwiederherstellungsstandort zum primären Standort durch.
-
VMs, Datastores oder Kubernetes-Ressourcen lassen sich zur effizienten Verwaltung in logische Ressourcengruppen zusammenfassen.
-
Bei Kubernetes-Workloads dienen Ressourcentransformationen dazu, Applikationen während eines Failover an die Wiederherstellungsumgebung anzupassen, und Pre-Snapshot- oder Post-Snapshot-Skripte managen die Applikationsstilllegung und -wiederaufnahme.

|
Bei VMware-Workloads müssen Sie den vSphere server außerhalb von Disaster Recovery in vSphere Server konfigurieren. |
Kosten
NetApp berechnet keine Gebühren für die Nutzung der Testversion von Disaster Recovery.
Disaster Recovery kann entweder mit einer NetApp Lizenz oder einem jährlichen abonnementbasierten Plan über Amazon Web Services genutzt werden.

|
Einige Versionen enthalten eine Technologievorschau. NetApp berechnet Ihnen keine Gebühren für Vorschau-Workload-Kapazität. Informationen zu den neuesten Technologievorschauen finden Sie unter "Was ist neu in Disaster Recovery". |
Lizenzierung
Sie können die folgenden Lizenztypen verwenden:
-
Melden Sie sich für eine 30-tägige kostenlose Testversion an.
-
Ein Pay-as-you-go (PAYGO)-Abonnement kann über den Amazon Web Services (AWS) Marketplace, den Azure Marketplace oder den Google Cloud Marketplace erworben werden. Diese Lizenz ermöglicht den Erwerb einer Lizenz mit fester, geschützter Kapazität ohne langfristige Verpflichtung.
-
Bringen Sie Ihre eigene Lizenz (BYOL) mit. Dabei handelt es sich um eine NetApp Lizenzdatei (NLF), die Sie von Ihrem NetApp Vertriebsmitarbeiter erhalten. Sie können die Seriennummer der Lizenz verwenden, um BYOL in der NetApp Console zu aktivieren.
Lizenzen für alle NetApp -Datendienste werden über Abonnements in der NetApp Console verwaltet. Nachdem Sie Ihr BYOL eingerichtet haben, können Sie in der Konsole eine aktive Lizenz für den Dienst sehen.
Disaster Recovery wird basierend auf der Datenmenge lizenziert, die auf geschützten ONTAP Volumes gehostet wird. Der Service ermittelt, welche Volumes für die Lizenzierung berücksichtigt werden sollten, indem geschützte VMs ihren vCenter Datastores zugeordnet werden. Jeder Datastore wird auf einem ONTAP Volume oder einer LUN gehostet. Für die Lizenzierung wird die von ONTAP für dieses Volume oder diese LUN gemeldete genutzte Kapazität verwendet. Die Lizenzierung wird für Kubernetes Workloads auf die gleiche Weise berechnet.
Geschützte Volumes können viele VMs aufnehmen. Einige davon gehören möglicherweise keiner Disaster Recovery-Ressourcengruppe an. Ungeachtet dessen wird der von allen VMs auf diesem Volume oder dieser LUN belegte Storage auf die maximale Lizenzkapazität angerechnet.
|
|
Die Gebühren für Disaster Recovery basieren auf der genutzten Kapazität der Datastores am Quellstandort, wenn es mindestens eine VM oder Kubernetes-Ressource mit einem Replikationsplan gibt. Die Kapazität für einen Failover-Datastore ist nicht im Kapazitätskontingent enthalten. Bei BYOL sind die Vorgänge im Service eingeschränkt, wenn die Daten die zulässige Kapazität überschreiten, bis Sie eine zusätzliche Kapazitätslizenz erhalten oder die Lizenz in der NetApp Console aktualisieren. |
Einzelheiten zum Einrichten der Lizenzierung für Disaster Recovery finden Sie in "Einrichtung der NetApp Disaster Recovery Lizenzierung".
[[30-day-free-trial]]
== 30 Tage kostenlos testen
Sie können Disaster Recovery 30 Tage lang kostenlos testen.
Um nach der 30-tägigen Testphase fortfahren zu können, benötigen Sie ein Pay-as-you-go (PAYGO)-Abonnement von Ihrem Cloud-Anbieter oder müssen eine BYOL-Lizenz von NetApp erwerben.
Sie können jederzeit eine Lizenz erwerben und es fallen erst nach Ablauf der 30-tägigen Testphase Kosten für Sie an.
Wie die Katastrophenwiederherstellung funktioniert
Disaster Recovery ist ein Dienst, der in der Software-as-a-Service-Umgebung (SaaS) von NetApp Console verfügbar ist. Disaster Recovery kann Workloads wiederherstellen, die von einem On-Premises-Standort zu Amazon FSx for ONTAP oder zu einem anderen On-Premises-Standort repliziert wurden. Für VMware Workloads automatisiert dieser Dienst die Wiederherstellung auf SnapMirror Level, über die Registrierung virtueller Maschinen in VMware Cloud on AWS bis hin zu Netzwerkzuordnungen direkt auf der VMware Plattform für Netzwerkvirtualisierung und -sicherheit, NSX-T. Diese Funktion ist in allen Virtual Machine Cloud Umgebungen enthalten.
Die Notfallwiederherstellung verwendet die ONTAP SnapMirror Technologie, die eine hocheffiziente Replikation ermöglicht und die ONTAP Effizienz inkrementeller, dauerhaft verfügbarer Snapshots bewahrt. SnapMirror Replikation stellt sicher, dass applikationskonsistente Snapshot Kopien immer synchron sind und die Daten unmittelbar nach einem Failover nutzbar sind.
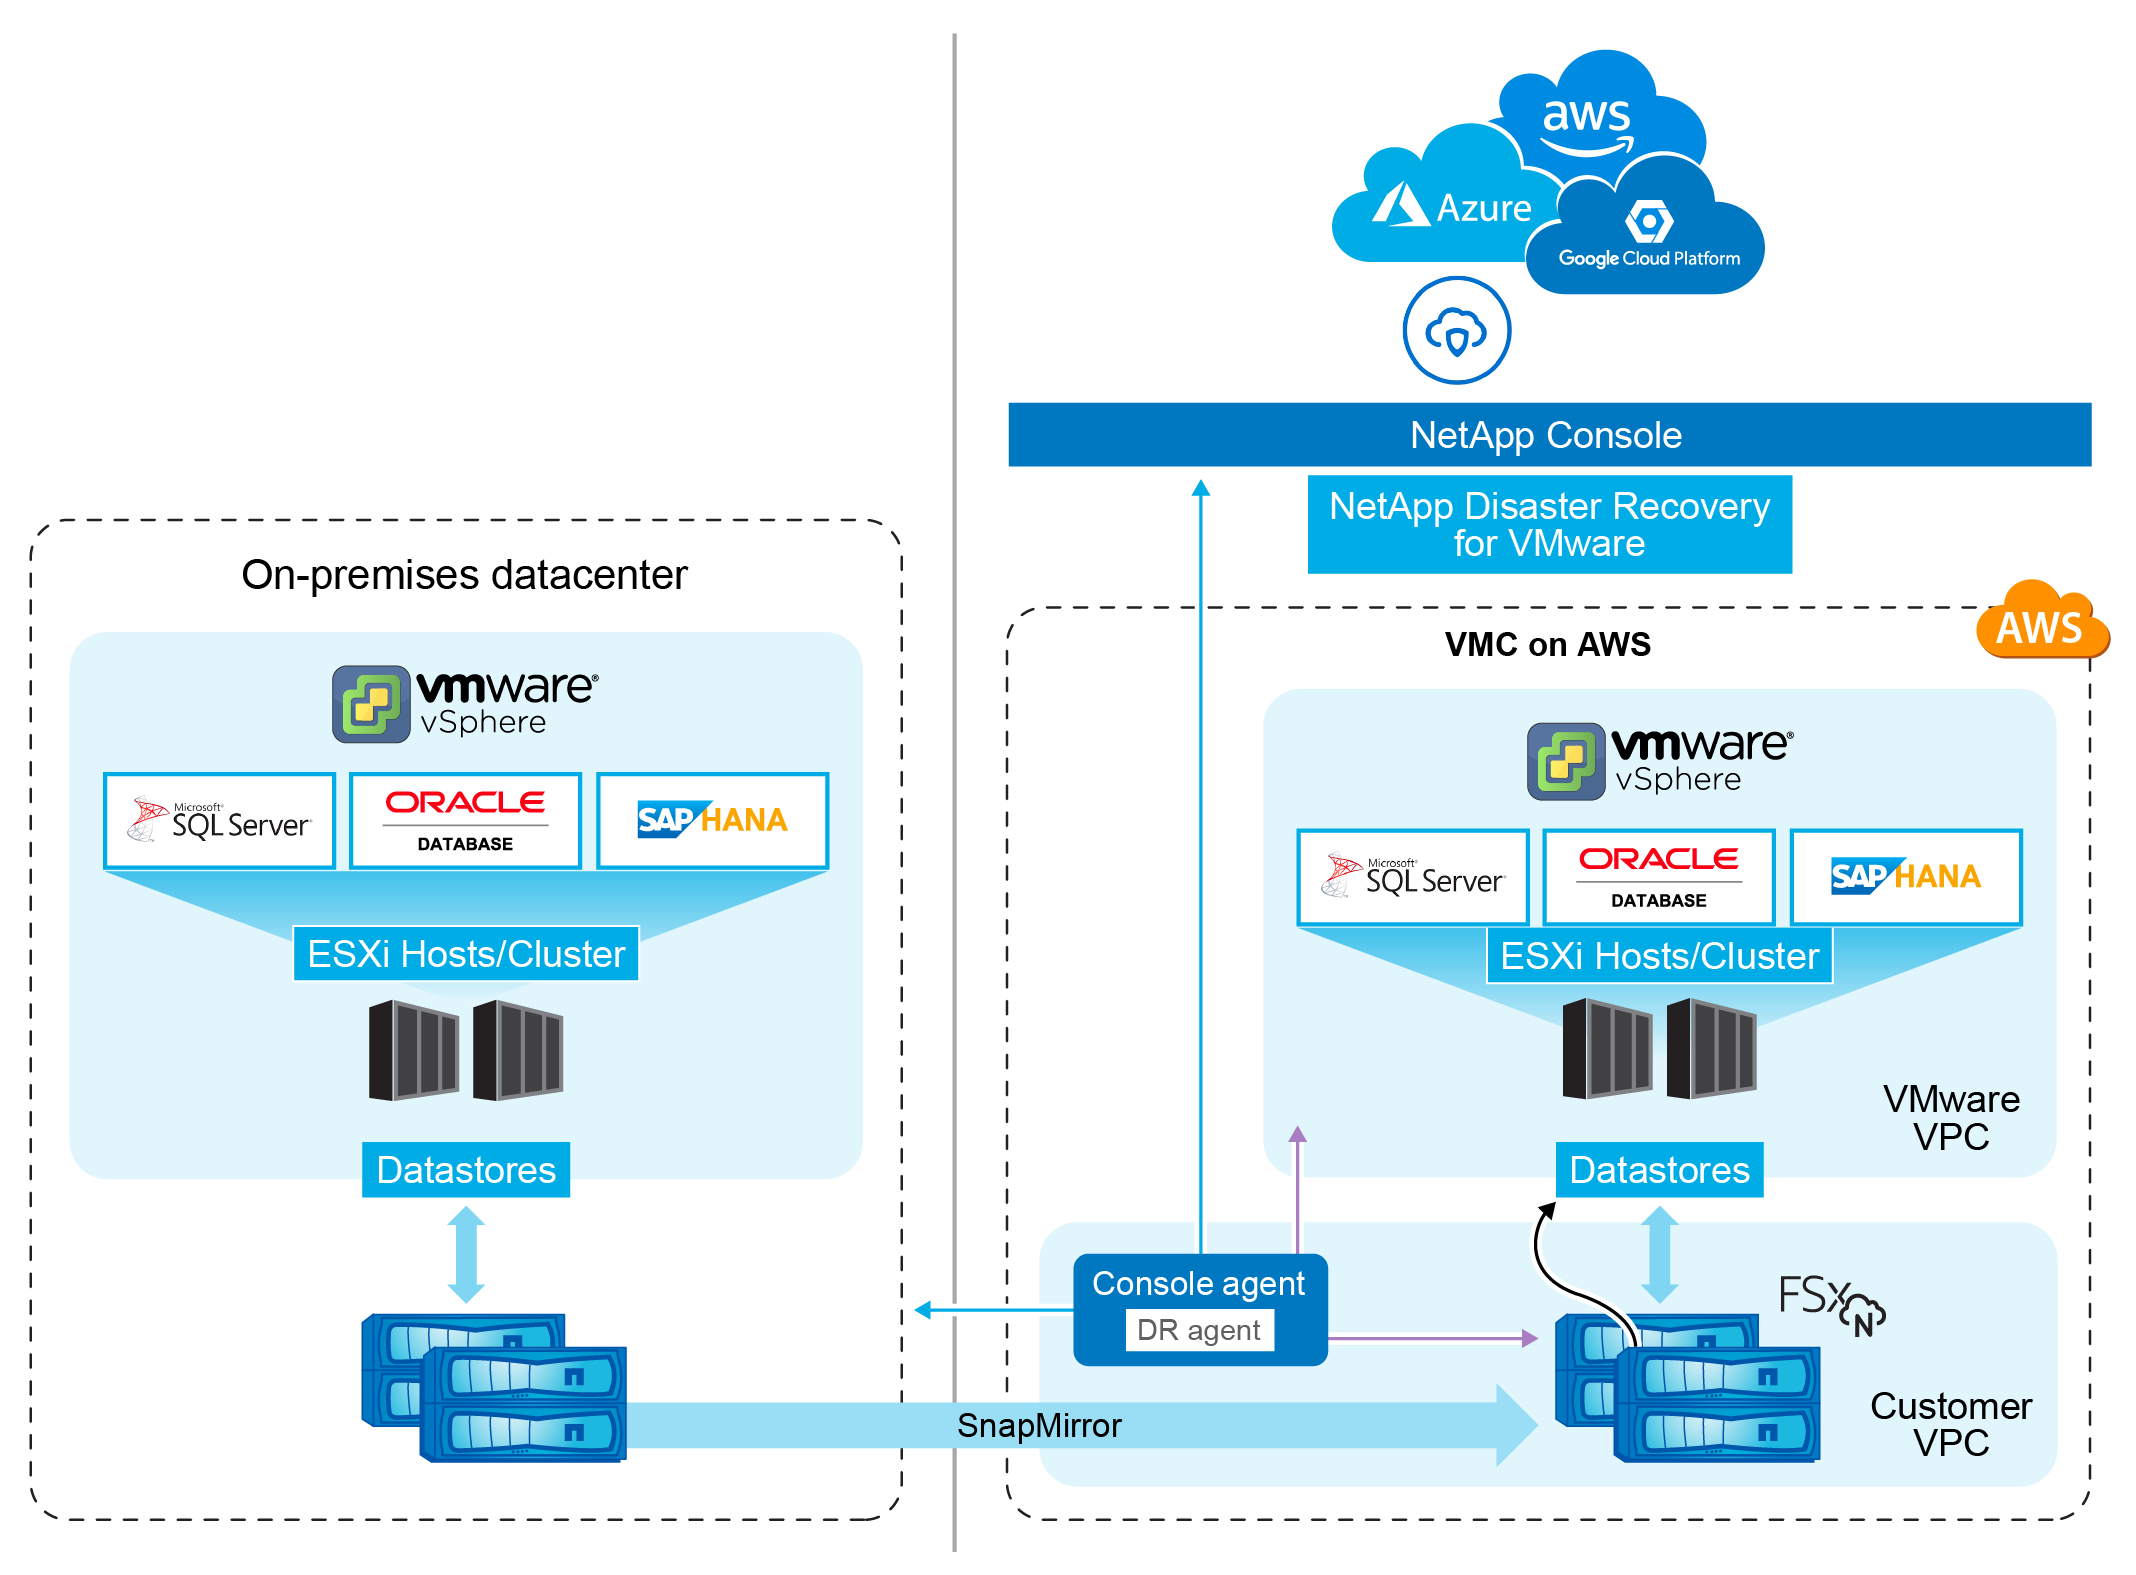
Im Katastrophenfall hilft Ihnen dieser Dienst dabei, VMware VMs in der anderen lokalen VMware Umgebung oder VMC wiederherzustellen, indem er die SnapMirror Beziehungen aufhebt und den Zielstandort aktiviert.
-
Mit dem Dienst können Sie außerdem ein Failback virtueller Maschinen auf den ursprünglichen Quellspeicherort durchführen.
-
Sie können den Failover-Prozess für die Notfallwiederherstellung testen, ohne die ursprünglichen virtuellen Maschinen zu unterbrechen. Der Test stellt virtuelle Maschinen in einem isolierten Netzwerk wieder her, indem ein FlexClone des Volumes erstellt wird.
-
Für den Failover- oder Test-Failover-Prozess können Sie den neuesten (Standard) oder ausgewählten Snapshot auswählen, von dem aus Ihre virtuelle Maschine wiederhergestellt werden soll.
Kubernetes Workloads
Für Kubernetes-Workloads verwendet Disaster Recovery Trident Protect, um Applikationen zu schützen, die auf Ihren Kubernetes-Clustern ausgeführt werden, einschließlich Umgebungen mit OpenShift Virtualization. Der Dienst verwendet SnapMirror, um die persistenten Volumes zu replizieren, die NetApp Trident auf ONTAP Storage bereitstellt. Trident Protect speichert Kubernetes-Schutzdaten in einem AppVault, einem Cloud-Storage-Ziel. Im Katastrophenfall erfolgt ein Failover zum Ziel-Cluster, und nach Behebung der Störung ist ein Failback zum ursprünglichen Quell-Cluster möglich. Failover, Failback und Failover-Tests für Kubernetes-Workloads folgen derselben Abfolge wie bei VMware-Workloads.
Komponenten der Notfallwiederherstellung
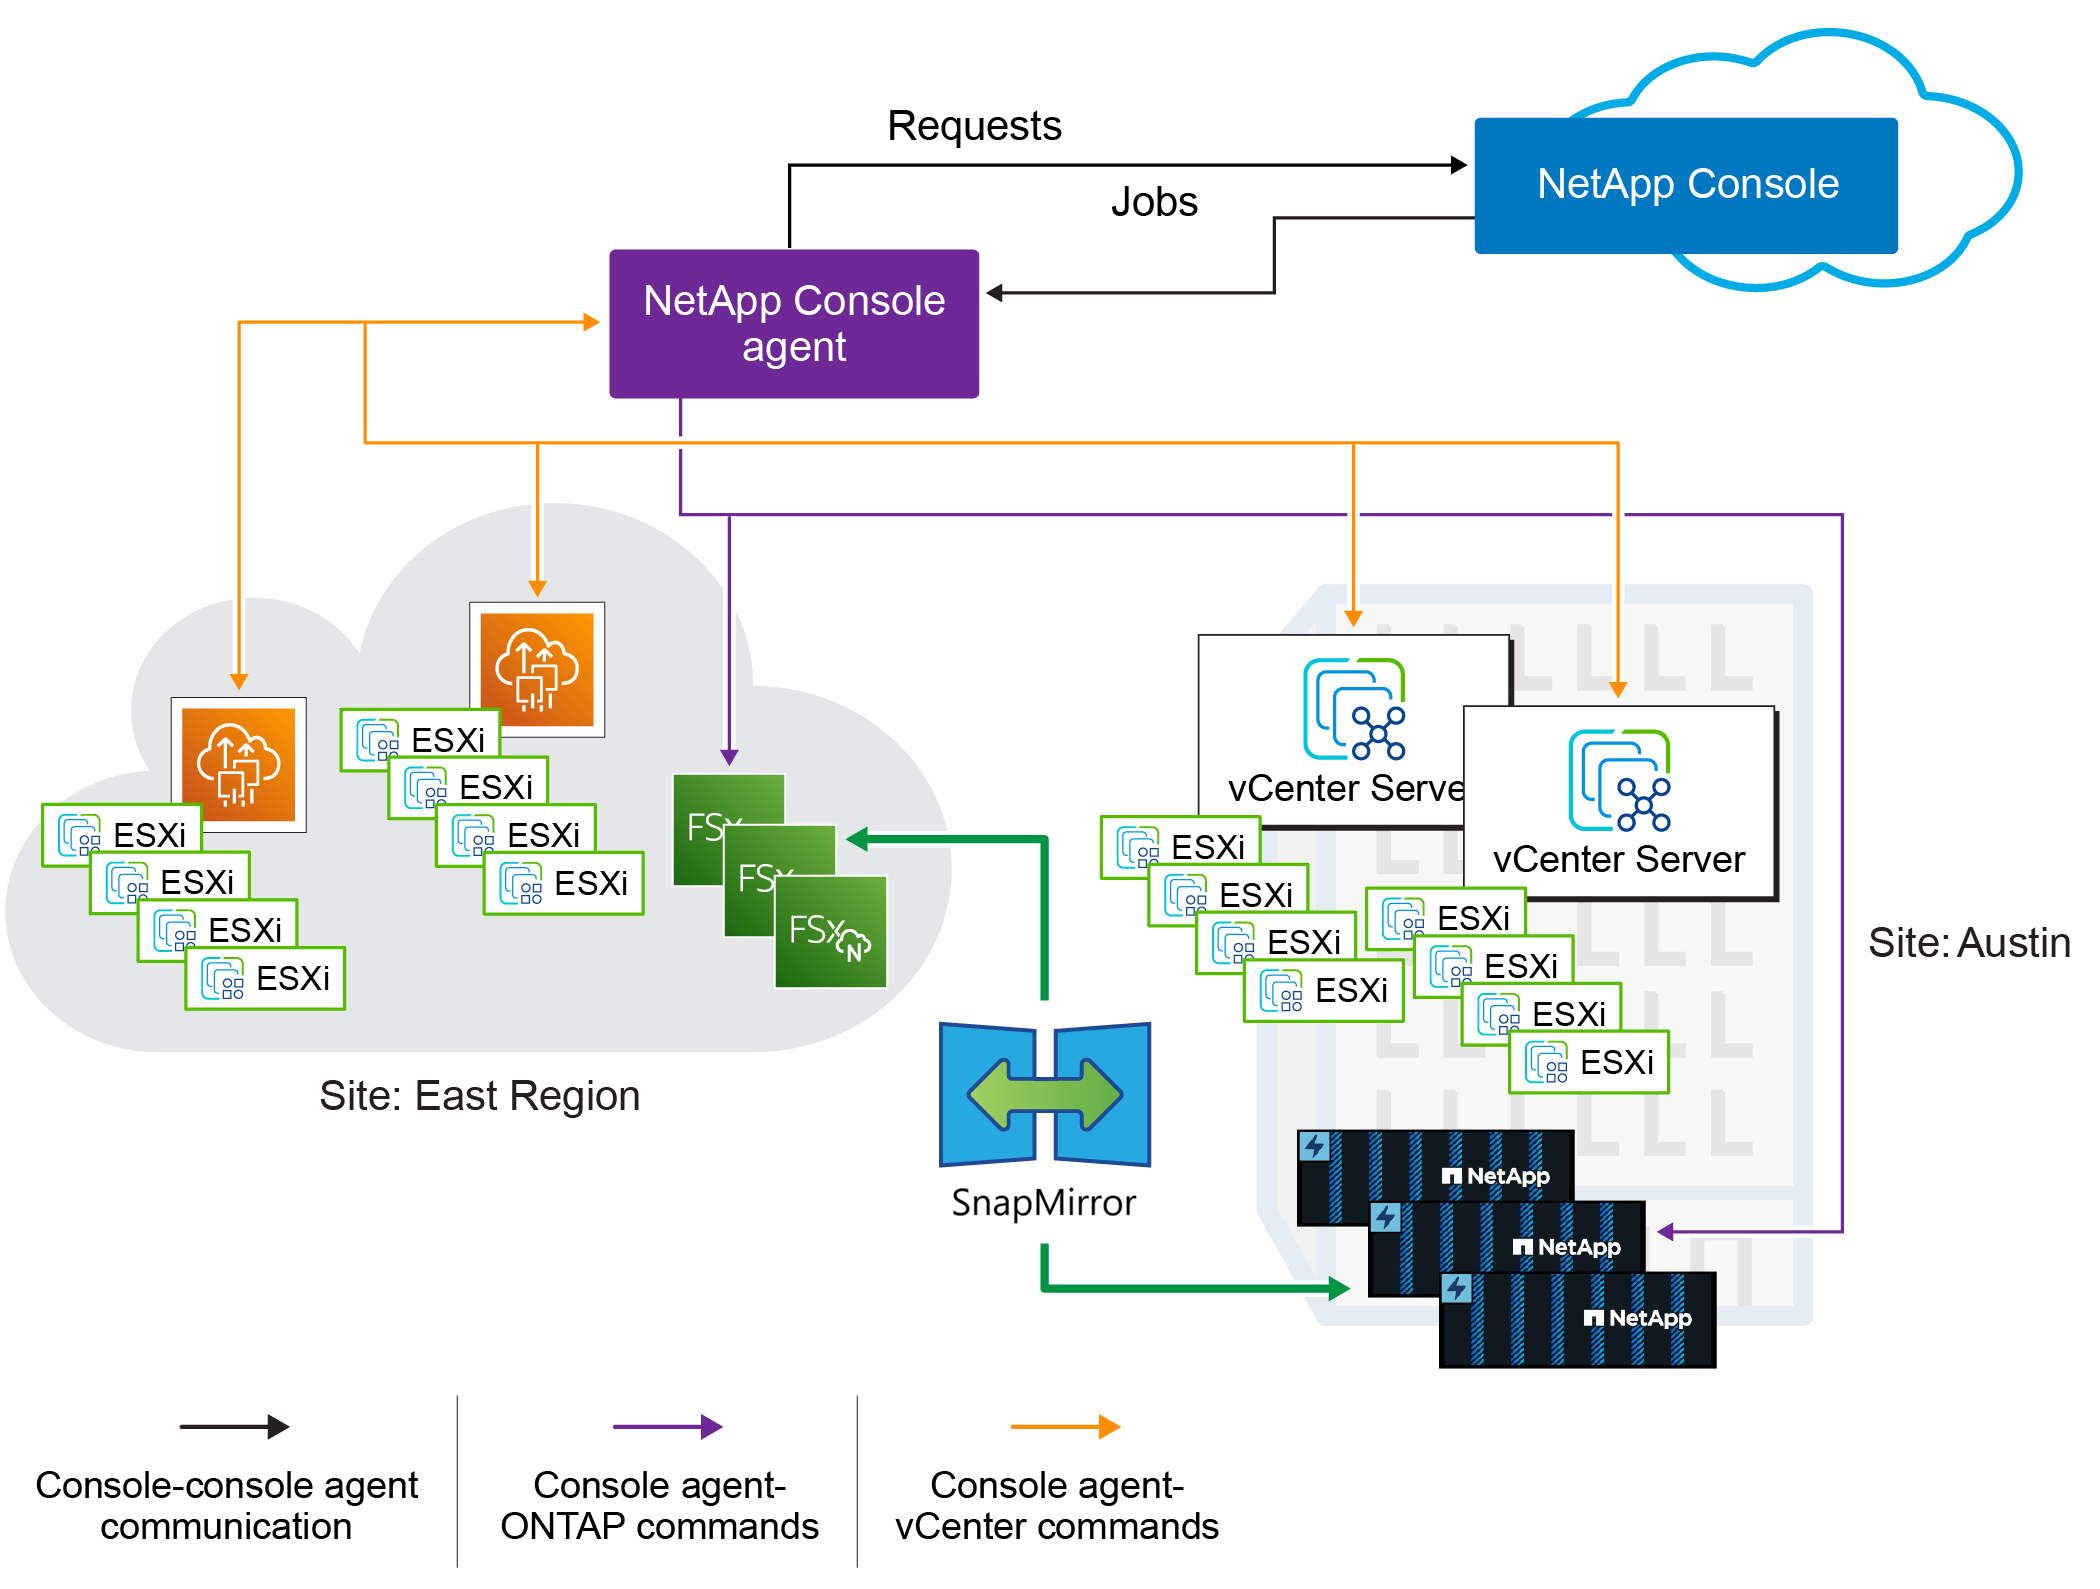
Für die Notfallwiederherstellung werden folgende Komponenten verwendet:
-
* NetApp Console*: Die Benutzeroberfläche zum Verwalten Ihrer Notfallwiederherstellungspläne. Mit der NetApp Console können Sie Replikationspläne, Ressourcengruppen und Failover-Vorgänge in Ihren lokalen und Cloud-Umgebungen erstellen und verwalten.
-
Console agent: Eine schlanke Softwarekomponente, die in Ihrem Cloud-gehosteten Netzwerk oder Ihrer lokalen VMware-Umgebung ausgeführt wird. Er kommuniziert mit der NetApp Console und managt die Datenreplikation zwischen Ihrer lokalen Umgebung und dem Disaster-Recovery-Standort. Der Console agent ist auf einer virtuellen Maschine in Ihrer VMware-Umgebung installiert. Für Kubernetes-Workloads kommuniziert der Console agent auf dieselbe Weise mit Ihren Kubernetes-Clustern.
-
ONTAP Storage-Cluster: Die ONTAP Storage-Cluster sind die primären Storage-Systeme, auf denen Ihre VMware- und Kubernetes-Workloads gehostet werden. Die ONTAP Storage-Cluster stellen die zugrunde liegende Storage-Infrastruktur für Ihre Disaster-Recovery-Pläne bereit. Disaster Recovery verwendet ONTAP Storage APIs, um ONTAP Storage-Cluster wie lokale Arrays und Cloud-basierte Lösungen wie Amazon FSx for NetApp ONTAP zu managen.
-
vCenter-Server: Das VMware vCenter ist der Verwaltungsserver für Ihre VMware-Umgebung. Es verwaltet die ESXi-Hosts und die zugehörigen Datenspeicher. Der Konsolenagent kommuniziert mit dem VMware vCenter, um die Datenreplikation zwischen Ihrer lokalen Umgebung und dem Notfallwiederherstellungsstandort zu verwalten. Dazu gehört das Registrieren von ONTAP -LUNs und -Volumes als Datenspeicher, das Neukonfigurieren von VMs sowie das Starten und Stoppen von VMs.
-
Kubernetes Cluster und Trident Protect: Für Kubernetes Workloads wird Trident Protect auf jedem Kubernetes Cluster installiert und registriert, der durch Disaster Recovery geschützt wird. Beim Hinzufügen eines Kubernetes Clusters als Standort führt Disaster Recovery durch die Installation und Registrierung von Trident Protect auf diesem Cluster.
Der Disaster Recovery-Schutz-Workflow
Wenn einer Ressourcengruppe ein Replikationsplan zugewiesen wird, führt Disaster Recovery eine Erkennungsprüfung aller Komponenten in der Ressourcengruppe und im Plan durch, um sicherzustellen, dass der Plan aktiviert werden kann.
Wenn diese Prüfung erfolgreich ist, führt Disaster Recovery die folgenden Initialisierungsschritte durch:
-
Identifizieren Sie für jede VM in der Zielressourcengruppe den VMware-Hostdatenspeicher.
-
Identifizieren Sie für jeden gefundenen VMware-Datenspeicher das Host ONTAP FlexVol volume oder die LUN.
-
Stellen Sie für jedes gefundene ONTAP Volume und LUN fest, ob eine vorhandene SnapMirror Beziehung zwischen den Quellvolumes und einem Zielvolume am Zielstandort besteht.
-
Wenn keine SnapMirror -Beziehung vorhanden ist, erstellen Sie alle neuen Zielvolumes und erstellen Sie eine neue SnapMirror -Beziehung zwischen jedem ungeschützten Quellvolume.
-
Wenn bereits eine SnapMirror -Beziehung besteht, verwenden Sie diese Beziehung, um alle Replikationsvorgänge durchzuführen.
-
Nachdem Disaster Recovery alle Beziehungen erstellt und initialisiert hat, führt der Dienst bei jeder geplanten Sicherung die folgenden Schritte zum Datenschutz aus:
-
Für jede als „applikationskonsistent“ gekennzeichnete VM kommt VMware Tools zum Einsatz, um die unterstützte Applikation in einen Sicherungszustand zu versetzen.
-
Erstellen Sie einen neuen Snapshot aller ONTAP -Volumes, die geschützte VMware-Datenspeicher hosten.
-
Führen Sie einen SnapMirror Aktualisierungsvorgang durch, um diese Snapshots auf den Ziel ONTAP -Cluster zu replizieren.
-
Stellen Sie fest, ob die Anzahl der aufbewahrten Snapshots die im Replikationsplan definierte maximale Snapshot-Aufbewahrung überschritten hat, und löschen Sie alle überflüssigen Snapshots sowohl vom Quell- als auch vom Zielvolume.
Unterstützte Schutzziele und Datenspeichertypen
Unterstützte Datenspeichertypen Disaster Recovery unterstützt die folgenden Datenspeichertypen:
-
NFS-Datenspeicher, die auf ONTAP FlexVol -Volumes gehostet werden, die sich auf ONTAP Clustern befinden.
-
VMware vSphere Virtual Machine File System (VMFS)-Datenspeicher mit dem iSCSI- oder FC-Protokoll
Für Kubernetes-Workloads schützt Disaster Recovery persistente Volumes, die über NetApp Trident auf ONTAP Storage bereitgestellt werden.
Unterstützte Schutzziele
-
VMware Cloud (VMC) auf AWS mit Amazon FSx for NetApp ONTAP
-
Eine weitere lokale, NFS-basierte VMware-Umgebung mit ONTAP Storage oder eine lokale FC/iSCSI VMFS-Umgebung
-
Amazon Elastic VMware Service
-
Azure VMware Solution mit NetApp Cloud Volumes ONTAP (iSCSI) (Private Preview)
-
Google Cloud VMware Engine (GCVE) mit Google Cloud NetApp Volumes
-
Kubernetes-Cluster mit von Trident verwaltetem ONTAP Storage (geschützt mit Trident Protect)
Begriffe, die Ihnen bei Disaster Recovery helfen könnten
Es kann für Sie von Vorteil sein, einige Begriffe im Zusammenhang mit der Notfallwiederherstellung zu verstehen.
-
Datenspeicher: Ein VMware vCenter-Datencontainer, der ein Dateisystem zum Speichern von VMDK-Dateien verwendet. Typische Datenspeichertypen sind NFS, VMFS, vSAN oder vVol. Disaster Recovery unterstützt NFS- und VMFS-Datenspeicher. Jeder VMware-Datenspeicher wird auf einem einzelnen ONTAP Volume oder LUN gehostet. Disaster Recovery unterstützt NFS- und VMFS-Datenspeicher, die auf FlexVol Volumes gehostet werden, die sich auf ONTAP Clustern befinden.
-
Replikationsplan: Ein Satz von Regeln darüber, wie oft Sicherungen durchgeführt werden und wie mit Failover-Ereignissen umgegangen wird. Pläne werden einer oder mehreren Ressourcengruppen zugewiesen.
-
Recovery Point Objective (RPO): Der maximale Datenverlust, der im Katastrophenfall akzeptabel ist. RPO wird in der Häufigkeit der Datenreplikation oder im Replikationszeitplan des Replikationsplans definiert.
-
Wiederherstellungszeitziel (RTO): Die maximal akzeptable Zeitspanne für die Wiederherstellung nach einem Katastrophenfall. Das RTO ist im Replikationsplan definiert und entspricht der Zeit, die für ein Failover zum DR-Standort und den Neustart aller VMs oder Applikationen benötigt wird.
-
Ressourcengruppe: Ein logischer Container, mit dem Sie mehrere VMs, Datastores oder Kubernetes-Ressourcen als eine Einheit managen können. Eine VM kann jeweils nur einer Ressourcengruppe angehören. Sie können für jede Applikation oder jeden Workload, den Sie schützen möchten, eine eigene Ressourcengruppe erstellen.
-
Site: Ein logischer Container, der typischerweise mit einem physischen Datacenter oder Cloud-Standort verbunden ist und einen oder mehrere vCenter Cluster oder Kubernetes-Cluster sowie ONTAP Storage beherbergt.
-
AppVault: Für Kubernetes-Workloads ein Cloud-Storage-Ziel, auf dem Trident Protect Kubernetes-Schutzdaten speichert.
-
Trident Protect: Die NetApp Software, die Disaster Recovery zum Schutz von Kubernetes-Applikationen verwendet.