


Informationen zur Geschäftskontinuität von Proxmox VE mit SnapMirror active sync

 Änderungen vorschlagen

 PDFs

Unternehmen, die geschäftskritische virtuelle Maschinen (VMs) in Proxmox Virtual Environment (VE) betreiben, und Serviceprovider, die Kunden-VMs in Proxmox VE hosten, benötigen diese VMs auch dann weiterhin im Betrieb, wenn ein Storage-System oder ein gesamtes Datacenter offline geht. ONTAP SnapMirror active sync repliziert den gemeinsam genutzten Storage eines Proxmox VE Clusters, der sich über zwei Standorte erstreckt, synchron und führt automatisch ein Failover des Storage auf den verbleibenden Standort durch. Sie erhalten ein Recovery Point Objective (RPO) von null, eine automatisierte Wiederherstellung ohne Skripte oder Runbooks und denselben gemeinsam genutzten Storage an beiden Standorten, sodass Proxmox VE High Availability (HA) VMs ohne jegliche Neukonfiguration des Storage neu starten kann. Für gemeinsam genutzten NFS Storage verwendet die Lösung SnapMirror active sync für NAS.
Kundenherausforderungen
Der Aufbau von Storage- und Standortausfallsicherheit für Proxmox VE allein mit nativen Tools ist schwierig:
-
Datenverlust nach einem Standortausfall. Proxmox VE Storage Replizierung und Proxmox Backup Server sind asynchron. Änderungen, die seit der letzten Replikation oder Sicherung vorgenommen wurden, gehen bei einem Ausfall des primären Standorts verloren.
-
Manuelle, langsame Wiederherstellung. Die Wiederherstellung an einem sekundären Standort erfordert in der Regel das Hochstufen von Replikaten, das Einbinden von Storage unter einer anderen Adresse, das Aktualisieren
/etc/pve/storage.cfg, und den Neustart von VMs. Jeder manuelle Schritt verlängert die Ausfallzeit und erhöht das Fehlerrisiko während eines Ausfalls. -
Gestreckter Storage, der mit VMs um Hostressourcen konkurriert. Hyperkonvergenter gestreckter Storage, wie beispielsweise Ceph im Stretch-Modus, läuft auf den Proxmox VE-Knoten und speichert zwei Replikate jedes Objekts an jedem Standort. Replikations-, Wiederherstellungs- und Rebalancing-Datenverkehr beanspruchen CPU-, Arbeitsspeicher- und Netzwerkressourcen auf denselben Knoten, auf denen auch die VMs laufen.
-
Zwei Quorumsentscheidungen müssen übereinstimmen. Jedes Zwei-Standort-Design benötigt einen Zeugen in einer dritten Ausfalldomäne, sowohl für den Proxmox VE-Cluster als auch für den Storage. Wenn der Cluster und der Storage nach einem Ausfall der Verbindung zwischen den Standorten unterschiedliche überlebende Standorte auswählen, werden VMs auf Knoten neu gestartet, die den aktiven Storage nicht erreichen können.
-
Eine Storage-Adresse, die an beiden Standorten funktionieren muss. Nach einem Storage Failover müssen Proxmox VE Knoten den gemeinsam genutzten Storage unter derselben Adresse erreichen können. Diese Adresse muss an beiden Standorten erreichbar sein, was üblicherweise ein Layer 2 VLAN zwischen den Standorten erfordert.
Herausforderungen für Dienstleister
Service Provider, die Cloud Services auf Proxmox VE aufbauen, stehen vor denselben Herausforderungen, zusätzlich zu den Service-Level-Agreements (SLAs) der Mandanten:
-
Das Storage-System stellt einen gemeinsamen Ausfallpunkt dar. Proxmox VE HA schützt Mandanten-VMs vor einem Host-Ausfall, jedoch nicht vor einem Ausfall des Storage-Systems, auf dem sich ihre Festplatten befinden. Ein Storage-Ausfall betrifft alle Mandanten auf diesem System.
-
Keine Möglichkeit, höhere Verfügbarkeit zu verkaufen. Ohne synchrone Replizierung und automatisches Storage Failover kann ein Anbieter kein Premium-Verfügbarkeits-Level mit null Datenverlust und stärkeren Verfügbarkeitszusagen anbieten.
-
Tenant-Isolation während der Wiederherstellung. Wiederherstellungs-, Wartungs- und Notfallwiederherstellungstests dürfen sich nur auf die betroffenen Tenants auswirken, nicht auf die gesamte Plattform.
Herausforderungen für Unternehmen
Unternehmen, die geschäftskritische Workloads von anderen Hypervisoren auf Proxmox VE migrieren, erwarten dieselbe Standortausfallsicherheit wie zuvor, beispielsweise null Datenverlust für Datenbanken und Geschäftsapplikationen sowie eine Wiederherstellung ohne manuelles Runbook. Diesen Erwartungen allein mit den nativen Tools von Proxmox VE zu entsprechen, erfordert erheblichen Aufwand bei Design, Skripterstellung und Betrieb.
Lösungsübersicht
Die Lösung kombiniert einen Proxmox VE Stretch-Cluster mit SnapMirror active sync auf NetApp AFF-Systemen an zwei Standorten:
-
Null RPO. ONTAP repliziert jeden Schreibvorgang synchron vom primären Cluster an Standort A zum sekundären Cluster an Standort B auf den gemeinsam genutzten Storage.
-
Gleicher gemeinsam genutzter Storage an beiden Standorten. Nach einem Failover präsentiert der sekundäre Cluster Proxmox VE denselben Storage, sodass die Storage-Definitionen in
/etc/pve/storage.cfggültig bleiben. -
Automatisches Failover. Ein Mediator fungiert als Zeuge außerhalb der beiden Standorte. Sie können ONTAP Mediator an einem dritten Standort installieren oder ONTAP Cloud Mediator verwenden, einen in der NetApp Console gehosteten Service. Wenn das primäre Storage oder der Standort ausfällt, führt ONTAP ohne manuelles Eingreifen ein Failover auf Standort B durch.
-
Feingranulare Kontrolle. Sie wählen aus, welche Workloads geschützt werden sollen, und Sie können für einzelne Workloads ein Failover durchführen, beispielsweise um einen Mandanten oder eine Applikation für Wartungsarbeiten am Standort zu verschieben.
-
Verwendung der sekundären Kopie. Sie können die sekundäre Kopie für Entwicklungs-, Test- oder Notfallwiederherstellungstests klonen, ohne die Replikation zu beeinträchtigen.
Wie die Lösung die Herausforderungen bewältigt
| Herausforderung | So unterstützt die Lösung | Wofür Sie noch planen |
|---|---|---|
Datenverlust und manuelle Wiederherstellung |
Die synchrone Replizierung führt zu einem RPO von null. ONTAP führt automatisch ein Failover durch, und die sekundäre SVM stellt dieselbe NFS-Adresse bereit, sodass |
Proxmox VE HA startet VMs eines ausgefallenen Standorts weiterhin neu. |
Gestreckter Storage auf den Hosts |
Die Replikation läuft auf den AFF Controllern, nicht auf den Proxmox VE Knoten, sodass CPU, Arbeitsspeicher und Netzwerk des Hosts für VMs verfügbar bleiben. ONTAP speichert an jedem Standort eine Kopie, und die Storage-Effizienz gilt für beide Kopien. |
Wie bei jeder synchronen Replizierung benötigt die Lösung eine vollständige zweite Kopie an Standort B, und die Replizierung erhöht die Last auf beiden AFF Clustern. Die Dimensionierung beider Cluster muss auf die Replizierungs-Workload ausgelegt sein. |
Zwei Quorum-Entscheidungen |
ONTAP Mediator oder ONTAP Cloud Mediator als Service in der NetApp Console ist ein ressourcenschonender Zeuge außerhalb des Datenpfads. Diese Lösung zeigt, wie das corosync QDevice auf den primären Cluster abgestimmt wird, sodass beide denselben Standort auswählen. |
Für das QDevice wird weiterhin ein dritter Standort benötigt. Dieser ist auch für ONTAP Mediator erforderlich, jedoch nicht für ONTAP Cloud Mediator. Weitere Informationen finden Sie unter Mediator-Optionen. |
Eine Storage-Adresse an beiden Standorten |
Die sekundäre SVM übernimmt dieselbe NFS LIF-Adresse, sodass kein erneutes Mounten oder keine Neukonfiguration des Storage erforderlich ist. |
Das NFS-Subnetz muss an beiden Standorten erreichbar sein, typischerweise über ein gestrecktes Layer-2-VLAN. Der Qualifizierungsstatus von VIP LIFs ist in Layer 3 Netzwerke mit VIP LIFs und BGP beschrieben. |
Das folgende Diagramm zeigt die Lösungsarchitektur mit gemeinsam genutztem NFS Storage.
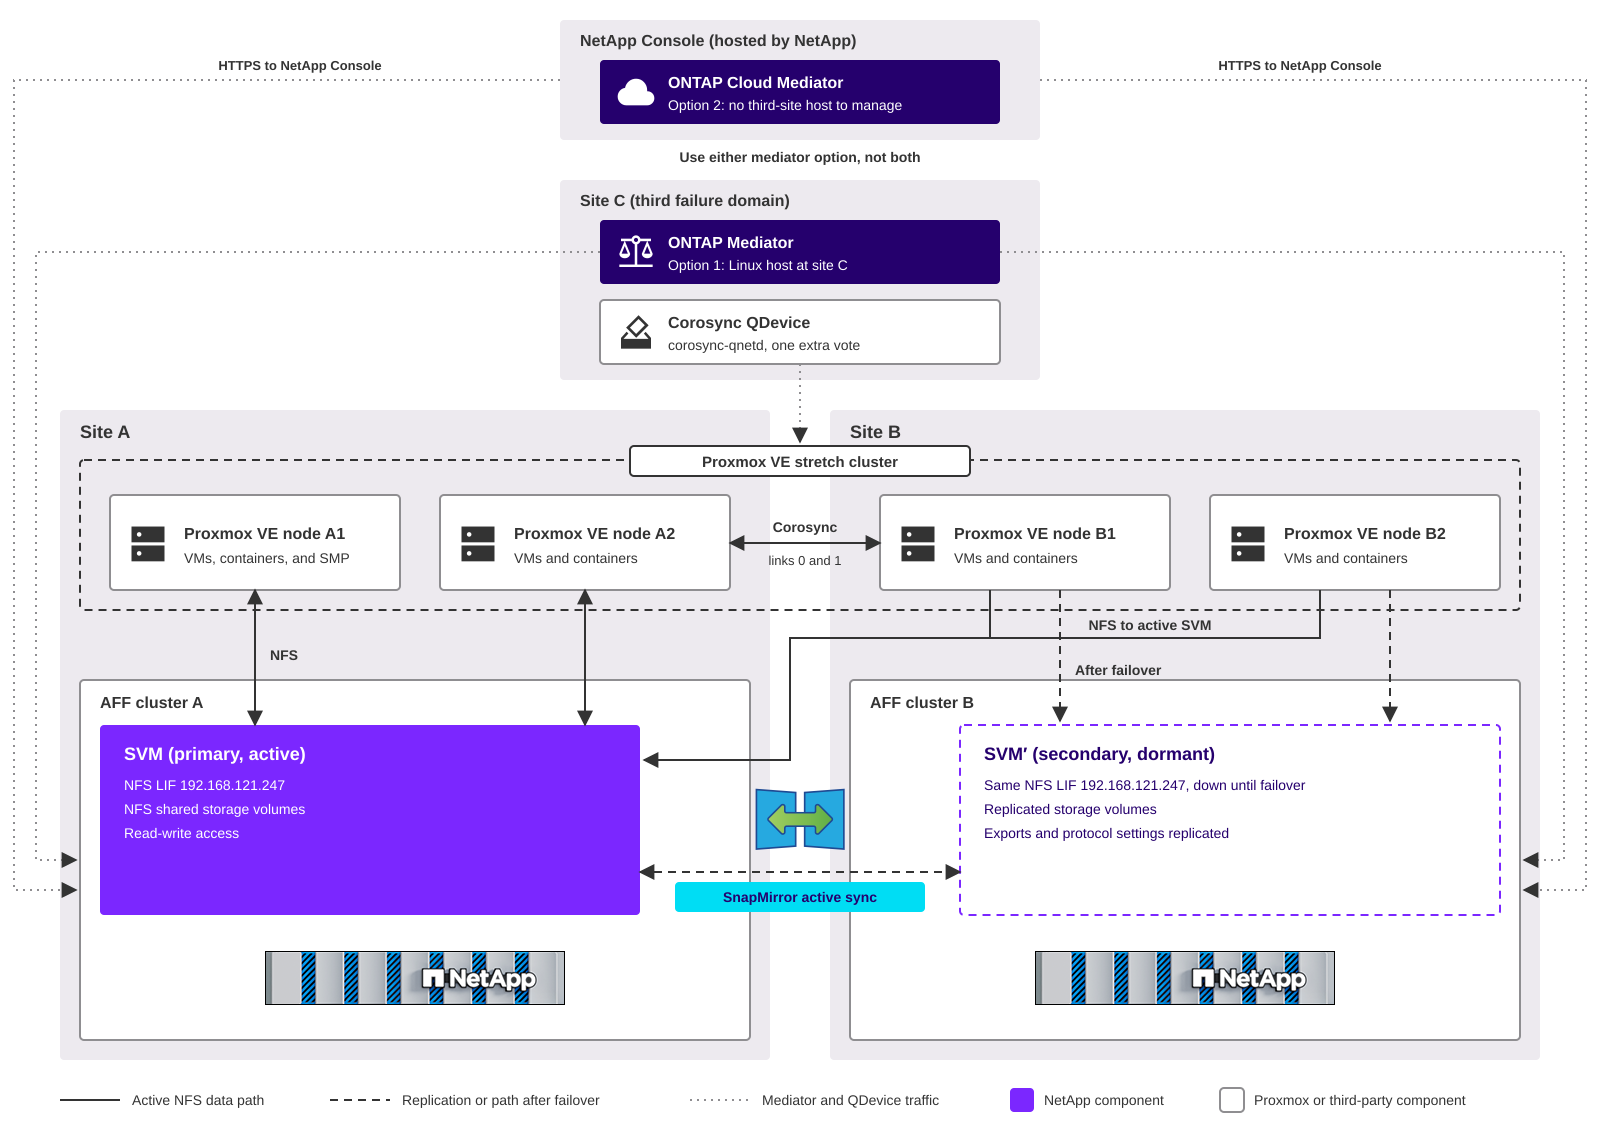
- Standort A und Standort B
-
Jeder Standort verfügt über einen AFF Zwei-Node-Cluster und die Hälfte der Proxmox VE-Knoten. Der primäre Cluster an Standort A stellt den gemeinsam genutzten Storage für alle Proxmox VE-Knoten bereit. Die Knoten an Standort B erreichen den primären Cluster über das standortübergreifende Netzwerk. Bei Verwendung von NFS Storage bleibt die sekundäre SVM an Standort B inaktiv, bis ein Failover auftritt.
- Standort C
-
Eine dritte Ausfalldomäne beherbergt den corosync QDevice Daemon (
corosync-qnetd) und, wenn Sie Option 1 wählen, ONTAP Mediator. Das QDevice stellt eine zusätzliche Stimme bereit, sodass der Proxmox VE Cluster bei Ausfall eines Standorts das Quorum aufrechterhält. - NetApp Console
-
Wenn Sie Option 2 wählen, wird ONTAP Cloud Mediator als Service in der NetApp Console ausgeführt, die NetApp hostet und managt. Beide AFF Cluster stellen über HTTPS eine Verbindung dazu her, sodass die Installation und Wartung eines Mediator-Hosts entfällt.
- Mediator
-
ONTAP Mediator oder ONTAP Cloud Mediator unterstützt ONTAP bei der Entscheidung, welcher Cluster Daten bereitstellt. Es kommt nur einer von beiden zum Einsatz, nicht beide. Einen Vergleich finden Sie unter Mediator-Optionen.
- Proxmox VE Stretch-Cluster
-
Alle Proxmox VE Knoten gehören zu einem Cluster und verwenden dieselben Storage-Definitionen. Proxmox VE HA startet VMs von einem ausgefallenen Standort auf den verbleibenden Knoten neu. Storage Manager for Proxmox (SMP) läuft als HA-VM im Cluster, um gemeinsam genutzten Storage zu provisionieren sowie VMs zu sichern, wiederherzustellen und zu klonen.
Mediator-Optionen
SnapMirror active sync verwendet einen Mediator als passiven Zeugen. Bei einer Netzwerkpartitionierung oder dem Ausfall eines Clusters verwendet ONTAP den Mediator, um zu entscheiden, welche Kopie weiterhin E/A verarbeitet. Der Mediator befindet sich nicht im Datenpfad und initiiert kein Failover selbst. Eine der folgenden Optionen kann verwendet werden, jedoch nicht beide gleichzeitig.
| Überlegung | Option 1: ONTAP Mediator | Option 2: ONTAP Cloud Mediator |
|---|---|---|
Wo es ausgeführt wird |
Ein Linux-Host, den Sie in einer dritten Ausfalldomäne, z. B. Standort C, mit unabhängiger Stromversorgung und Netzwerkinfrastruktur installieren und managen. |
Ein Cloud-Service in der NetApp Console. NetApp hostet und managt ihn, sodass kein Mediator-Host an einem dritten Standort erforderlich ist. |
ONTAP Version |
ONTAP 9.19.1 oder höher für SnapMirror active sync für NAS. |
ONTAP Cloud Mediator ist ab ONTAP 9.17.1 verfügbar. SnapMirror active sync für NAS erfordert ONTAP 9.19.1 oder höher. |
Cluster-Konnektivität |
Beide Cluster sind mit dem Mediator-Host verbunden. Der Standard-Service-Port ist 31784. |
Beide Cluster stellen ausgehende Verbindungen über HTTPS zur NetApp Console her, direkt oder über einen HTTP-Proxy. Die empfohlene Ping-Latenz zur NetApp Console liegt unter 200 ms. |
Einrichtung |
Das Paket auf dem Linux-Host installieren und es anschließend mit der Hostadresse und einem Mediator-Benutzer zu den Clustern hinzufügen. |
Erforderlich sind die Erstellung eines NetApp Console Service-Kontos mit der ONTAP Mediator Setup Role sowie das anschließende Hinzufügen des Mediators zu den Clustern mit der Unternehmens-ID, der Client-ID und dem Client-Secret. |
Betrieb |
Sie spielen Patches ein, aktualisieren den Host und halten ihn verfügbar. |
Es gibt keinen Host, der gepatcht oder aktualisiert werden muss. Sie sind auf den Internetzugang an beiden Standorten und auf die Verfügbarkeit des NetApp Console Service angewiesen. |
Bestmögliche Übereinstimmung |
Umgebungen, die über einen dritten Standort verfügen oder in denen die Storage-Cluster das Internet nicht erreichen können. |
Umgebungen ohne einen dritten Standort für einen Mediator oder Umgebungen, die den Betrieb eines solchen vermeiden möchten. |
Bei der Auswahl ist Folgendes zu beachten:
-
Das QDevice benötigt weiterhin einen dritten Standort. ONTAP Cloud Mediator entfernt den Mediator-Host, nicht den corosync QDevice-Host. Das QDevice benötigt einen kleinen Linux-Host, den alle Proxmox VE-Knoten über TCP-Port 5403 erreichen können, und es hat nicht die Anforderung an niedrige Latenz von corosync.
-
Beide Cluster benötigen Zugriff auf die NetApp Console. Wenn die Cluster einen Proxy verwenden, ist das Root-CA-Zertifikat des Proxy auf beiden Clustern zu installieren. NetApp empfiehlt für jeden Cluster einen anderen Proxyserver.
-
Bei beiden Optionen ist mit demselben Ausfallverhalten zu rechnen. Wenn der Mediator nicht verfügbar ist, wird die Replikation ohne Datenverlust fortgesetzt, automatische und geplante Failover sind jedoch erst wieder möglich, wenn der Mediator wieder verfügbar ist. Bei ONTAP Cloud Mediator umfasst dies auch einen Verbindungsverlust von den Clustern zur NetApp Console.

|
Die Mediatoroptionen in diesem Abschnitt gelten für SnapMirror active sync. Für MetroCluster verwendet diese Lösung ONTAP Mediator oder MetroCluster Tiebreaker. Vor dem Einsatz ist zu überprüfen, ob Ihre ONTAP Version, die Mediatoroption und die Proxmox VE-Version zusammen in der "NetApp Interoperabilitätsmatrix Tool (IMT)" aufgeführt sind. |
Vorteile für Dienstleister
-
VM-Verfügbarkeit über die Host-HA hinaus. Tenant-VMs laufen weiter, wenn das Storage-System, auf dem ihre Festplatten gehostet werden, ausfällt. ONTAP führt ein Failover auf den zweiten AFF Cluster durch, und die VMs setzen die E/A auf demselben gemeinsam genutzten Storage ohne Neustart fort.
-
Eine Premium-Verfügbarkeitsstufe. Sie können einen VM-Dienst mit Zero-RPO und Speicherausfallsicherheit als Zusatzoption anbieten, parallel zu Standardstufen auf ungeschütztem Storage in denselben Clustern.
-
Mandantenspezifischer Schutz und Failover. Mit separatem geschütztem Storage für jeden Mandanten oder jede Serviceebene können Sie jeden Mandanten unabhängig schützen, ein Failover durchführen und die Notfallwiederherstellung testen, ohne andere Mandanten zu beeinträchtigen.
-
Bessere Nutzung beider Standorte. Sie können einige Workloads primär an Standort A und andere primär an Standort B ausführen, sodass beide Rechenzentren aktive Workloads bedienen.
Vorteile für Unternehmen
-
Kein Datenverlust für geschäftskritische VMs bei einem Storage- oder Standortausfall.
-
Automatisierte Wiederherstellung ohne Skripte, erneutes Mounten von Storage oder Änderungen an
/etc/pve/storage.cfg. -
In ONTAP integriert, ohne zusätzliche Softwareschicht auf den Proxmox VE Knoten.
-
Tägliche Bedienung über eine einzige Schnittstelle. Storage Manager für Proxmox stellt den geschützten gemeinsam genutzten Storage bereit und sichert, stellt VMs wieder her und klont sie mit ONTAP Snapshots und FlexClone Technologie.
Wie die Lösung auf Ausfälle reagiert
ONTAP und Proxmox VE treffen unabhängige Quorumentscheidungen. Die Architektur sorgt dafür, dass beide denselben verbleibenden Standort auswählen.
| Ereignis | ONTAP Verhalten | Verhalten von Proxmox VE |
|---|---|---|
Standort A fällt aus |
Der Mediator bestätigt den Ausfall, und ONTAP schaltet das gemeinsam genutzte Storage automatisch auf Cluster B um. |
Die Knoten an Standort B und das QDevice halten das Quorum aufrecht. HA isoliert die Knoten an Standort A und startet deren VMs auf den Knoten an Standort B neu. Die bereits an Standort B befindlichen VMs nehmen den I/O nach dem Storage Failover wieder auf. |
AFF Cluster A fällt aus, Proxmox VE Knoten an Standort A laufen weiter |
Der Mediator bestätigt, dass Cluster A nicht erreichbar ist, und ONTAP schaltet den gemeinsam genutzten Storage automatisch auf Cluster B um. |
Es gibt keine Quorumänderung und keinen VM-Neustart. Die VMs auf allen Knoten setzen den I/O nach dem Storage Failover auf demselben gemeinsam genutzten Storage fort, wobei die Knoten von Standort A Cluster B über das standortübergreifende Netzwerk erreichen. |
Ein AFF Controller am Standort A fällt aus |
Der Partner-Controller übernimmt im Rahmen einer lokalen HA-Übernahme. Es erfolgt kein SnapMirror active sync Failover. |
Keine Auswirkungen. Die VMs unterbrechen die E/A-Vorgänge während der Übernahme kurzzeitig. |
Standort B fällt aus |
Cluster A stellt weiterhin Daten bereit. Die Replikation wird wieder aufgenommen, sobald Standort B wieder verfügbar ist. |
Die Knoten von Standort A und das QDevice halten das Quorum aufrecht. HA startet die VMs von Standort B auf den Knoten von Standort A neu. |
Verbindung zwischen Standorten fällt aus |
Cluster A stellt weiterhin Daten bereit. Es findet kein Failover statt. |
Das QDevice gibt seine Stimme der Partition von Standort A, wenn der Trennschalter auf das primäre Cluster ausgerichtet ist. Die Knoten von Standort B verlieren das Quorum und schalten sich selbst ab, und HA startet ihre VMs auf Standort A neu. |
Standort C fällt aus, oder die Cluster verlieren den Zugriff auf die NetApp Console |
Die Replikation wird ohne Datenverlust fortgesetzt, automatische und geplante Failover sind jedoch erst möglich, wenn der Mediator verfügbar ist. Mit ONTAP Cloud Mediator betrifft ein Standortausfall von Standort C nur das QDevice. |
Der Cluster erhält das Quorum durch die Stimmen der vier Knoten aufrecht. Es sind keine VMs betroffen. |
Ein Proxmox VE Knoten fällt aus |
Keine Auswirkungen. |
HA startet die VMs dieses Knotens auf anderen Knoten neu und bevorzugt dabei Knoten am selben Standort. |
Storage-Systemausfall
Ein Storage-Systemausfall ist ein Fall, den HA auf Host-Ebene allein nicht bewältigen kann, und der Fall, in dem SnapMirror active sync den größten Mehrwert für Dienstanbieter bietet. Das folgende Diagramm zeigt den Zustand nach dem Ausfall von AFF Cluster A, während alle Proxmox VE-Knoten bei Verwendung von gemeinsam genutztem NFS-Storage weiterhin online bleiben.
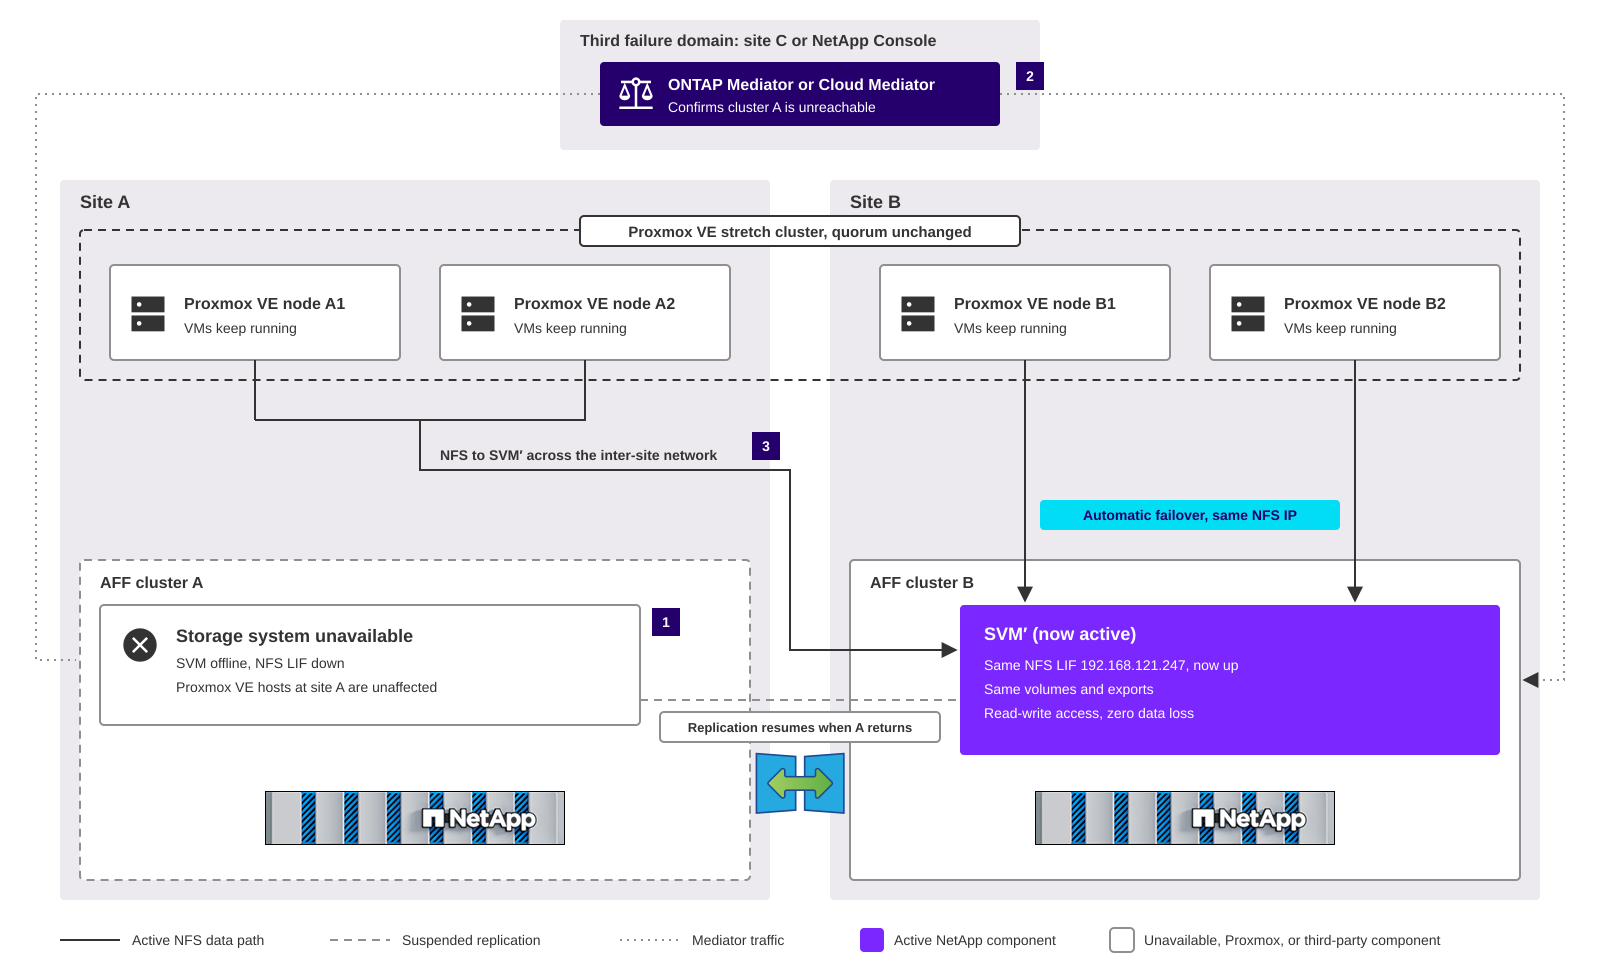
-
AFF Cluster A ist nicht mehr verfügbar. Die Proxmox VE-Knoten an Standort A bleiben jedoch in Betrieb, sodass der Cluster sein Quorum nicht verliert und HA keinen Knoten isoliert.
-
Der Mediator, ONTAP Mediator an Standort C oder ONTAP Cloud Mediator in der NetApp Console, bestätigt, dass Cluster A nicht erreichbar ist, und ONTAP aktiviert die sekundäre SVM auf Cluster B mit derselben NFS LIF Adresse, denselben Volumes und denselben Exportrichtlinien.
-
Alle Proxmox VE Knoten setzen die E/A-Operationen auf demselben gemeinsam genutzten Storage fort. Knoten an Standort B erreichen Cluster B lokal, und Knoten an Standort A erreichen es über das standortübergreifende Netzwerk. VMs pausieren die E/A-Operationen während des Failovers und laufen ohne Neustart weiter.
Wenn Cluster A zurückkehrt, wird die Replikation fortgesetzt. Das Failback zu Cluster A sollte während eines Wartungsfensters geplant werden, damit die VMs von Standort A wieder auf lokalen Storage zugreifen.
Standortausfall
Bei einem Standortausfall gehen sowohl das Storage-System als auch die Proxmox VE Knoten an diesem Standort offline. ONTAP führt ein Failover des gemeinsam genutzten Storage auf den verbleibenden Cluster durch, und Proxmox VE HA startet die VMs vom ausgefallenen Standort auf den verbleibenden Knoten neu, wie in der Tabelle beschrieben.
Die Wahl zwischen SnapMirror active sync und MetroCluster
NetApp MetroCluster Konfigurationen bieten außerdem einen RPO von null und eine automatische Wiederherstellung für einen Proxmox VE Stretch-Cluster. Die beiden Lösungen unterscheiden sich darin, was sie schützen:
-
MetroCluster schützt alle Workloads. MetroCluster kombiniert array-basiertes Clustering mit synchroner Replizierung. Es spiegelt die Daten in jedem gespiegelten Aggregat, den nichtflüchtigen Speicher (NVRAM) und die Konfiguration jeder SVM auf den Partnerstandort, sodass der gesamte gemeinsam genutzte Storage im Cluster ohne Einrichtung pro Workload geschützt ist.
-
SnapMirror active sync schützt eine Teilmenge der Workloads. Sie wählen aus, welche SVMs oder Volumes geschützt werden sollen, und Sie können für jedes davon unabhängig ein Failover durchführen. Ungeschützte Workloads können dieselben Cluster gemeinsam nutzen.
Beide Lösungen speichern an jedem Standort eine vollständige Kopie der geschützten Daten, benötigen einen Zeugen in einer dritten Ausfalldomäne und erhöhen die Replikationslast auf den Storage-Controllern. Sie unterscheiden sich hinsichtlich Schutzumfang, Failover-Granularität und Clusterdesign.
|
|
Vor dem Einsatz einer der beiden Lösungen sollten Sie prüfen, ob Ihre ONTAP Version, MetroCluster oder SnapMirror Active Sync Konfiguration und Ihre Proxmox VE Version gemeinsam in der "NetApp Interoperabilitätsmatrix Tool (IMT)" aufgeführt sind. |
MetroCluster Architektur mit Proxmox VE
Das folgende Diagramm zeigt einen Proxmox VE Stretch-Cluster mit einer Vier-Knoten-MetroCluster IP-Konfiguration und gemeinsam genutztem NFS-Storage.
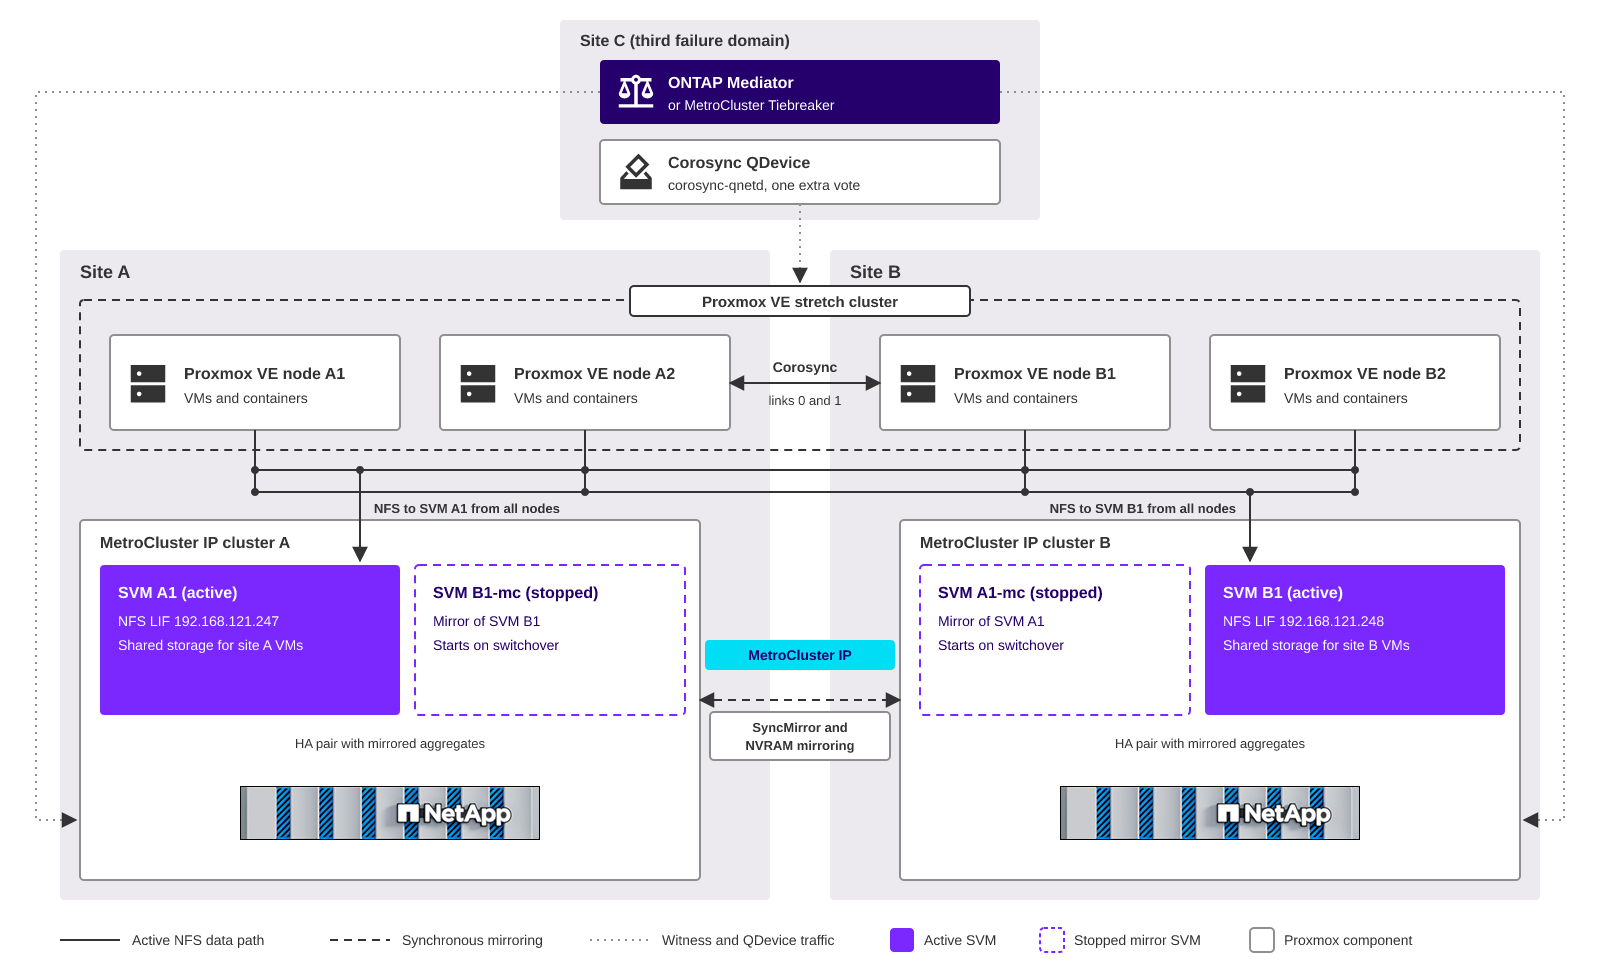
- MetroCluster IP Cluster
-
Jeder Standort verfügt über ein HA-Paar mit gespiegelten Aggregaten. Das MetroCluster IP Back-End-Netzwerk spiegelt Daten (SyncMirror) und NVRAM synchron zum Partnerstandort.
- SVMs an beiden Standorten
-
Jeder Standort kann seine eigenen SVMs bedienen. Für jede SVM unterhält MetroCluster am Partnerstandort eine gestoppte Spiegel-SVM mit dem
-mcSuffix sowie derselben Konfiguration und denselben LIF-Adressen. - NFS-Zugriff von allen Knoten
-
Jeder Proxmox VE Knoten bindet den gemeinsamen Storage beider aktiver SVMs, SVM A1 und SVM B1, ein, sodass HA jede VM auf jedem Knoten neu starten kann. Knoten an Standort B erreichen SVM A1, und Knoten an Standort A erreichen SVM B1 über das standortübergreifende Netzwerk. Dies entspricht demselben Zugriffsmodell wie SnapMirror active sync.
- Umschaltung
-
Wenn ein Standort ausfällt, ermöglicht ONTAP Mediator oder MetroCluster Tiebreaker an Standort C eine automatische Umschaltung. Die gespiegelten SVMs am verbleibenden Standort starten und stellen den gesamten gemeinsam genutzten Storage mit denselben NFS-Adressen bereit, und Proxmox VE HA startet die VMs des ausgefallenen Standorts neu. Der Ausfall eines einzelnen Controllers wird durch ein lokales HA-Takeover ohne Umschaltung verarbeitet. Nach der Reparatur des ausgefallenen Standorts werden die Aggregate geheilt und es wird zurückgeschaltet.
Wie MetroCluster auf Fehler reagiert
Die folgende Tabelle zeigt, wie eine MetroCluster IP Konfiguration und der Proxmox VE Stretch-Cluster auf dieselben Fehler wie in Wie die Lösung auf Ausfälle reagiert reagieren. In diesem Beispiel ist SVM A1 an Standort A aktiv und SVM B1 an Standort B aktiv.
| Ereignis | ONTAP Verhalten | Verhalten von Proxmox VE |
|---|---|---|
Standort A fällt aus |
ONTAP Mediator oder MetroCluster Tiebreaker bestätigt den Ausfall, und ONTAP führt für Standort A ein Failover durch. SVM A1-mc startet an Standort B mit derselben NFS-LIF-Adresse. SVM B1 stellt weiterhin Daten bereit. |
Die Knoten an Standort B und das QDevice halten das Quorum aufrecht. HA isoliert die Knoten an Standort A und startet deren VMs auf den Knoten an Standort B neu. VMs, die bereits auf den Knoten an Standort B liefen, bleiben aktiv, und die VMs auf SVM A1 nehmen nach dem Switchover die E/A-Operationen wieder auf. |
MetroCluster IP Cluster A fällt aus, Proxmox VE Knoten an Standort A laufen weiter |
ONTAP Mediator oder MetroCluster Tiebreaker bestätigt, dass Cluster A nicht erreichbar ist, und ONTAP führt ein Switchover von Standort A durch. SVM A1-mc startet an Standort B mit derselben NFS-LIF-Adresse. |
Keine Quorumänderung und kein Neustart der VM. Die VMs auf SVM A1 nehmen nach dem Switchover die E/A wieder auf, wobei die Knoten von Standort A Standort B über das standortübergreifende Netzwerk erreichen. |
Ein Controller an Standort A fällt aus |
Der HA-Partner an Standort A übernimmt bei einer lokalen HA-Übernahme. Es findet kein Switchover statt. |
Keine Auswirkungen. Die VMs unterbrechen die E/A-Vorgänge während der Übernahme kurzzeitig. |
Standort B fällt aus |
ONTAP schaltet auf Standort B um. SVM B1-mc startet an Standort A mit derselben NFS LIF-Adresse. SVM A1 stellt weiterhin Daten bereit. |
Die Knoten von Standort A und das QDevice halten das Quorum aufrecht. HA startet die VMs von Standort B auf den Knoten von Standort A neu, wo sie auf SVM B1 an Standort A zugreifen. |
Verbindung zwischen Standorten fällt aus |
Es findet kein Switchover statt, da beide Cluster weiterhin laufen. Jeder Standort bedient weiterhin seine eigenen SVMs, und die Spiegelung zum Partnerstandort wird ausgesetzt, bis die Verbindung wiederhergestellt ist. |
Das QDevice gibt seine Stimme der Partition von Standort A, wenn der Trennschalter mit Standort A übereinstimmt. Knoten von Standort B verlieren das Quorum und isolieren sich selbst. HA startet VMs auf SVM A1 auf Knoten von Standort A neu. VMs auf SVM B1 können erst neu gestartet werden, wenn die Verbindung wiederhergestellt ist, da Knoten von Standort A SVM B1 nicht erreichen können. |
Standort C fällt aus |
Die Spiegelung wird ohne Datenverlust fortgesetzt, ein automatisches Umschalten ist jedoch erst möglich, wenn der Witness verfügbar ist. Sie können weiterhin manuell umschalten. |
Der Cluster erhält das Quorum durch die Stimmen der vier Knoten aufrecht. Es sind keine VMs betroffen. |
Ein Proxmox VE Knoten fällt aus |
Keine Auswirkungen. |
HA startet die VMs dieses Knotens auf anderen Knoten neu und bevorzugt dabei Knoten am selben Standort. |
Der Ausfall der standortübergreifenden Verbindung ist der Hauptunterschied zu einem Design mit einem primären Standort. Wenn beide Standorte aktive SVMs hosten, mit MetroCluster oder mit zwei SnapMirror active sync SVMs in entgegengesetzte Richtungen, kann der corosync Trennschalter nur einen Standort bevorzugen. VMs, deren aktive SVM sich am anderen Standort befindet, bleiben ausgefallen, bis die Verbindung wiederhergestellt ist. Zur Begrenzung der Auswirkungen empfiehlt sich der Einsatz redundanter standortübergreifender Verbindungen auf separaten physischen Pfaden sowie die Platzierung der kritischsten VMs auf der SVM an dem Standort, den der Trennschalter bevorzugt.
Funktionsvergleich
| Überlegung | SnapMirror Active Sync für NAS | MetroCluster IP |
|---|---|---|
Schutzumfang |
Ausgewählte SVMs und Volumes |
Alle gespiegelten Aggregate und alle SVMs in der Konfiguration |
Failover-Granularität |
Jede SVM unabhängig |
Der gesamte Standort, durch Umschaltung |
Ungeschützte Workloads |
Ausführung auf ungeschützten SVMs in denselben Clustern |
Es können ungespiegelte Aggregate verwendet werden, die nach einer Umschaltung offline gehen, bis Sie sie online schalten |
Clusterdesign |
Zwei unabhängige Cluster, die über ein IP-Netzwerk verbunden sind |
Eine Konfiguration mit zwei Partnerclustern und einem dedizierten MetroCluster IP Back-End-Netzwerk |
Witness an Standort C |
ONTAP Mediator oder ONTAP Cloud Mediator |
ONTAP Mediator oder MetroCluster Tiebreaker |
Kopien geschützter Daten |
Jeweils einer an jedem Standort |
Jeweils eines an jedem Standort, in gespiegelten Aggregaten |
Replikationspfad |
SnapMirror synchron über Intercluster-LIFs |
SyncMirror und NVRAM-Spiegelung über das MetroCluster IP-Back-End-Netzwerk |
NFS-Adresse an beiden Standorten |
Erweitertes Layer-2-VLAN. VIP LIFs mit ausstehender BGP-Qualifizierung |
Gestrecktes Layer-2-VLAN oder VIP-LIFs mit BGP |
Wiederherstellung nach einem Standortausfall |
Failback jeder SVM |
Die Aggregate reparieren und anschließend den Standort zurückschalten |
Auswahlhilfe
-
MetroCluster ist die richtige Wahl, wenn alle oder nahezu alle Workloads auf dem Storage einen RPO von null benötigen, beispielsweise wenn ein Unternehmen ausschließlich geschäftskritische VMs im Cluster betreibt oder ein Serviceprovider allen Mandanten dieselbe Verfügbarkeitsstufe anbietet. Sie erhalten eine Schutzdomäne ohne Konfiguration pro Workload.
-
SnapMirror active sync ist die richtige Wahl, wenn nur ein Teil der Workloads ein RPO von null benötigt, beispielsweise eine Premium-Stufe für einige Mandanten, oder wenn für jeweils nur einen Mandanten oder eine Applikation ein Failover oder ein Disaster-Recovery-Test erforderlich ist.
-
SnapMirror active sync für NAS wird in einer MetroCluster Konfiguration nicht unterstützt. Für jedes Clusterpaar kommt eine eigene Lösung zum Einsatz.
-
Die in dieser Lösung enthaltenen Hinweise zu Corosync, QDevice und HA gelten für beide Fälle. Mit MetroCluster richten Sie den QDevice Trennschalter an dem Standort aus, der die Datenversorgung aufrechterhält, wenn die Verbindung zwischen den Standorten ausfällt, und verwenden HA-Knotenaffinitätsregeln, um VMs am selben Standort wie ihre aktive SVM zu halten.
-
MetroCluster IP unterstützt außerdem VIP LIFs mit BGP für Layer-3-Netzwerke zwischen Standorten.
Corosync-Überlegungen für einen Proxmox VE Stretch-Cluster
Proxmox VE verwendet corosync für die Clusterzugehörigkeit und das Quorum. Corosync reagiert empfindlicher auf das Netzwerk zwischen den Standorten als SnapMirror active sync, daher empfiehlt es sich, das Clusternetzwerk zuerst zu planen.
Latenz- und Netzwerkdesign
-
SnapMirror active sync erfordert eine Intercluster-Round-Trip-Time (RTT) von unter 10 ms. Proxmox empfiehlt eine Corosync-Latenz von unter 5 ms zwischen allen Knoten, daher legt die Corosync-Anforderung die Entfernungsgrenze für die Lösung fest.
-
Corosync benötigt eine niedrige, konstante Latenz anstelle einer hohen Bandbreite. Für Corosync empfiehlt sich ein dediziertes Netzwerk, getrennt von Storage- und Live-Migrationsverkehr, damit Storage-Spitzen keine Corosync-Zeitüberschreitungen verursachen.
-
Es sollten mindestens zwei Corosync Links, zum Beispiel Link 0 und Link 1, auf separaten physischen Pfaden zwischen den Standorten konfiguriert sein. Corosync verwendet Kronosnet, um die Links bei Ausfall eines Pfads automatisch umzuschalten.
Quorum mit einem QDevice an einem dritten Standort
Die Proxmox VE-Knoten werden gleichmäßig auf Standort A und Standort B verteilt, und an Standort C wird ein QDevice hinzugefügt. Mit vier Knoten und einem QDevice verfügt der Cluster über fünf Stimmen und benötigt drei für das Quorum, sodass jeder Standort ausfallen kann, ohne dass das Quorum verloren geht. Das QDevice verbindet sich über TCP-Port 5403 mit dem Cluster und unterliegt nicht der Anforderung von corosync an niedrige Latenz, sodass es sich Standort C mit ONTAP Mediator teilen kann. Bei Verwendung von ONTAP Cloud Mediator wird weiterhin ein dritter Standort für das QDevice benötigt, dieser kann jedoch ein kleiner Linux-Host sein, auf dem nicht zusätzlich ein Mediator gehostet wird.
Abstimmung des Trennschalters mit dem primären Cluster
Wenn die Verbindung zwischen den Standorten ausfällt, beide Standorte aber weiterhin Standort C erreichen können, hält ONTAP den primären Cluster an Standort A für die Datenbereitstellung aufrecht. Das QDevice muss seine Stimme demselben Standort geben. Standardmäßig wählt das QDevice die Partition mit der niedrigsten Knoten-ID.
EMPFEHLUNG: Der Proxmox VE-Cluster sollte auf einem Knoten an Standort A erstellt werden, und die anderen Knoten an Standort A sollten hinzugefügt werden, bevor Knoten an Standort B hinzugefügt werden, sodass Standort A die niedrigsten Knoten-IDs erhält. Wenn der primäre Storage für längere Zeit an Standort B verschoben wird, sollte die QDevice tie_breaker Einstellung auf eine Knoten-ID von Standort B aktualisiert werden.
Wenn das QDevice stattdessen Standort B bevorzugen würde, würden sich die Knoten von Standort A selbst isolieren, und HA würde VMs auf Knoten von Standort B neu starten, die den aktiven Storage an Standort A nicht erreichen können.
HA-Verhalten und VM-Platzierung
-
Proxmox VE HA erkennt typischerweise einen ausgefallenen Knoten und stellt dessen VMs in etwa zwei Minuten wieder her, einschließlich einer 60-sekündigen Watchdog-Fencing-Zeitüberschreitung. Bei einem Standortausfall laufen das SnapMirror active sync Failover und die Proxmox VE HA-Wiederherstellung parallel.
-
HA-Knotenaffinitätsregeln mit Knotenprioritäten dienen dazu, VMs auf den Knoten am selben Standort wie ihr primärer Storage zu platzieren und ein Failover zum anderen Standort zu ermöglichen.
-
Nach einem Standort Failover ist die HA
failbackEigenschaft für betroffene VMs bis zum Failback des Storage auf0zu setzen. Andernfalls migriert HA die VMs zurück zu den Knoten an Standort A, sobald diese wieder verfügbar sind, während sich der aktive Storage noch an Standort B befindet. -
Die Zeitüberschreitungen für Festplattenzugriffe des Gastbetriebssystems müssen länger sein als die erwartete Failover-Zeit, damit Gäste während eines Storage Failover keine I/O-Fehler melden.
Integration mit Storage Manager für Proxmox
Storage Manager für Proxmox (SMP) bietet Proxmox VE-Administratoren eine zentrale Schnittstelle, um gemeinsam genutzten ONTAP Storage zu provisionieren und VMs mithilfe von ONTAP Snapshots und FlexClone Technologie zu sichern, wiederherzustellen und zu klonen. SMP stellt über die APIs eine Verbindung zum Proxmox VE-Cluster und zu ONTAP her, sodass keine Agenten auf den Proxmox VE-Knoten erforderlich sind.
SMP und SnapMirror active sync schützen vor unterschiedlichen Arten von Ausfällen. SnapMirror active sync hält VMs bei einem Storage- oder Standortausfall in Betrieb, repliziert jedoch jeden Schreibvorgang synchron, einschließlich einer versehentlichen Löschung, eines fehlgeschlagenen Gast-Updates oder von durch Ransomware verschlüsselten Daten. SMP Snapshots liefern zeitpunktgenaue Kopien für die Wiederherstellung nach solchen logischen Ausfällen. Zusammen bieten sie kontinuierliche Verfügbarkeit und eine schnelle operative Wiederherstellung aus demselben ONTAP Storage.
| Schutzschicht | Schützt vor | Wiederherstellungspunkt | Verwaltet mit |
|---|---|---|---|
SnapMirror aktive Synchronisierung |
Storage-Systemausfall und Standortausfall |
Kein Datenverlust |
ONTAP |
SMP Backups (ONTAP snapshots) |
Versehentliches Löschen, Datenbeschädigung, fehlgeschlagene Updates und Ransomware |
Letzte geplante oder bedarfsgesteuerte Datensicherung |
SMP |
SnapMirror asynchrones Fan-out oder Proxmox Backup Server |
Verlust beider Standorte und langfristige Aufbewahrung |
Letzte Replikation oder Sicherung |
ONTAP oder Proxmox Backup Server |
Datensicherung und Wiederherstellung
SMP erstellt absturzkonsistente oder dateikonsistente Backups als ONTAP Snapshots der Storage Volumes, entweder bedarfsgesteuert oder gemäß Richtlinien, und stellt einzelne VMs, Storage oder Ressourcengruppen wieder her:
-
Mit Ressourcengruppen und Sicherungsrichtlinien lassen sich derselbe Zeitplan und dieselbe Aufbewahrungsdauer auf die VMs eines Mandanten oder einer Applikation anwenden.
-
Für VMs, auf denen der QEMU Guest Agent ausgeführt wird, sollten dateikonsistente Backups verwendet werden, damit die Gastdateisysteme angehalten werden, bevor ONTAP den Snapshot erstellt.
-
SMP verwaltet den aktiven Storage. Nach einem SnapMirror active sync Failover ist in SMP eine Erkennung erforderlich, damit der Storage Cluster B zugeordnet wird, bevor Sicherungs- oder Wiederherstellungsvorgänge ausgeführt werden.
-
Für eine dritte Kopie außerhalb der beiden Standorte oder für eine längere Aufbewahrung eignet sich eine asynchrone Fan-out-Beziehung mit SnapMirror von den geschützten Volumes aus, alternativ kann Proxmox Backup Server verwendet werden.
-
Manipulationssichere Snapshots werden mit SnapMirror active sync nicht unterstützt, daher darf die Snapshot-Sperre in SMP für geschützte Volumes nicht aktiviert werden.
VM-Klonen
SMP nutzt ONTAP FlexClone Technologie, um platzsparende VM-Klone für Entwicklung, Tests und schnelle Provisionierung zu erstellen. Klone, die Sie in geschütztem Storage erstellen, verbrauchen Replikationsbandbreite und Kapazität an beiden Standorten. Klone und Test-Storage, die keine Geschäftskontinuität benötigen, sollten vom Schutz durch SnapMirror active sync ausgeschlossen werden.
SMP Platzierung
-
Die SMP-VM läuft als HA-Ressource auf einem durch SnapMirror active sync geschützten gemeinsam genutzten Storage, sodass SMP auch nach einem Storage- oder Standortausfall verfügbar bleibt.
-
Die Registrierung des Proxmox VE Cluster und beider ONTAP Cluster in SMP stellt sicher, dass SMP den aktiven Storage an beiden Standorten erreichen kann.
Gemeinsam genutzter NFS-Storage mit SnapMirror active sync für NAS
Ab ONTAP 9.19.1 schützt SnapMirror active sync NAS-Workloads. Die folgenden Hinweise gelten nur für gemeinsam genutzten NFS-Storage. Für den Einsatz der Lösung mit NFS-Storage ist die "NAS Konfigurationsworkflow" zu verwenden.
Schutz auf SVM-Ebene und Netzwerkidentität
-
SnapMirror active sync für NAS schützt eine gesamte Storage VM (SVM). Sie können alle Volumes in der SVM schützen oder einzelne Volumes ausschließen. Nur FlexVol Volumes werden unterstützt, und die SVM darf keine LUNs enthalten.
-
Die sekundäre SVM bleibt im Ruhezustand, wobei ihre LIFs bis zu einem Failover inaktiv sind. ONTAP repliziert die SVM-Konfiguration, einschließlich LIF-IP-Adressen, Exportrichtlinien und NFS-Einstellungen, sodass die sekundäre SVM nach einem Failover denselben NFS-Endpunkt bereitstellt.
-
Failover ist bei NFSv3 und höher unterbrechungsfrei.
-
SnapMirror active sync für NAS ist Aktiv/Passiv, sodass VMs auf Knoten an Standort B über das standortübergreifende Netzwerk Lese- und Schreibzugriffe auf die primäre SVM ausführen. Für aktive Workloads an beiden Standorten kommen zwei SVMs mit entgegengesetzten Replikationsrichtungen zum Einsatz, mit jeweils einer primären SVM an jedem Standort, und die Knotenaffinitätsregel jeder VM ist auf den Standort ihrer primären SVM abzustimmen.
-
SnapMirror active sync für NAS wird auf AFF A-Series- und C-Series-Zwei-Knoten-Clustern unterstützt.
Einstellungen des NFS-Clients
Beim NFS Storage sollten NFSv3 oder NFSv4.1 zum Einsatz kommen. Das standardmäßige Hard-Mount-Verhalten sollte beibehalten werden, und die `soft`Mount-Option sollte nicht hinzugefügt werden, damit NFS-E/A-Vorgänge während eines Failover wiederholt werden, anstatt fehlzuschlagen.
Mehrere TCP-Verbindungen zum Storage sorgen für bessere Performance und Fehlertoleranz. Zum Einsatz kommt entweder nConnect oder Session Trunking, nicht beides:
-
nConnect. Öffnet mehrere TCP-Verbindungen zu einer einzelnen NFS-LIF-Adresse, beispielsweise
nconnect=4. nConnect funktioniert mit NFSv3 und NFSv4.1 sowie mit einer einzelnen VIP-LIF-Adresse und ist daher die empfohlene Option für SnapMirror active sync für NAS, einschließlich Layer-3-Netzwerken. -
Session-Trunking. Fasst beispielsweise mehrere Daten-LIFs in einer NFSv4.1-Session zusammen
vers=4.1,trunkdiscovery,max_connect=16. Session-Trunking erfordert NFSv4.1 oder höher. Verwenden Sie es nur, wenn die geschützte SVM über mehrere Daten-LIFs verfügt, die Clients an beiden Standorten erreichen können, z. B. in einem Stretched-Layer-2-Netzwerk. Weitere Informationen finden Sie unter "NFS Trunking".
Die Befehle für die Mount-Optionen und die Verifizierungsschritte sind unter "Konfigurieren Sie NFS-Speicher für Proxmox VE" beschrieben.
NFS Storage Provisionierung mit SMP
SMP provisioniert ein ONTAP Volume, erstellt oder wählt eine Exportrichtlinie aus und bindet das Volume als gemeinsam genutzten NFS Storage auf den ausgewählten Proxmox VE Knoten ein. Für Storage in einer geschützten SVM:
-
Das Volume ist in der primären SVM zu provisionieren, und als bevorzugte LIF ist die NFS LIF oder in einem Layer 3 Netzwerk die VIP LIF auszuwählen. Die sekundäre SVM verwendet nach einem Failover dieselbe Adresse, sodass die Storage-Definition gültig bleibt.
-
Das Storage muss auf allen Proxmox VE-Knoten an beiden Standorten eingebunden sein, damit HA VMs auf jedem Knoten neu starten kann.
-
Es ist sicherzustellen, dass die Exportrichtlinie die Proxmox VE Knoten an beiden Standorten zulässt. ONTAP repliziert die Exportrichtlinie auf die sekundäre SVM.
-
Nach der Provisionierung ist zu prüfen, ob das Volume in den SnapMirror Active Sync-Schutz einbezogen ist.
Layer 3 Netzwerke mit VIP LIFs und BGP
SnapMirror active sync für NAS erfordert dieselbe IP-Adresse auf den primären und sekundären SVMs. Wenn das NFS VLAN zwischen Standorten erweitert wird, wandert die LIF IP-Adresse mit der SVM. Wenn die Standorte über ein geroutetes Layer-3-Netzwerk verbunden sind, existiert das Subnetz einer LIF von Standort A an Standort B nicht.

|
Zum Zeitpunkt der Veröffentlichung hat NetApp VIP-LIFs mit BGP für SnapMirror active sync für NAS noch nicht als qualifizierte Konfiguration dokumentiert. Vor der Planung eines Layer-3-Designs ist die aktuelle Unterstützung bei NetApp zu bestätigen. Andernfalls ist das NFS-VLAN zwischen den Standorten zu erweitern. MetroCluster IP-Konfigurationen unterstützen VIP-LIFs mit BGP. |
ONTAP virtual IP (VIP) LIFs lösen dieses Problem. Ein VIP LIF gehört zu keinem Subnetz. ONTAP kündigt die VIP-Adresse gegenüber den Peer-Routern mithilfe des Border Gateway Protocol (BGP) als /32-Hostroute an, sodass die Adresse ohne VLAN-Erweiterung zwischen Standorten verschoben werden kann.
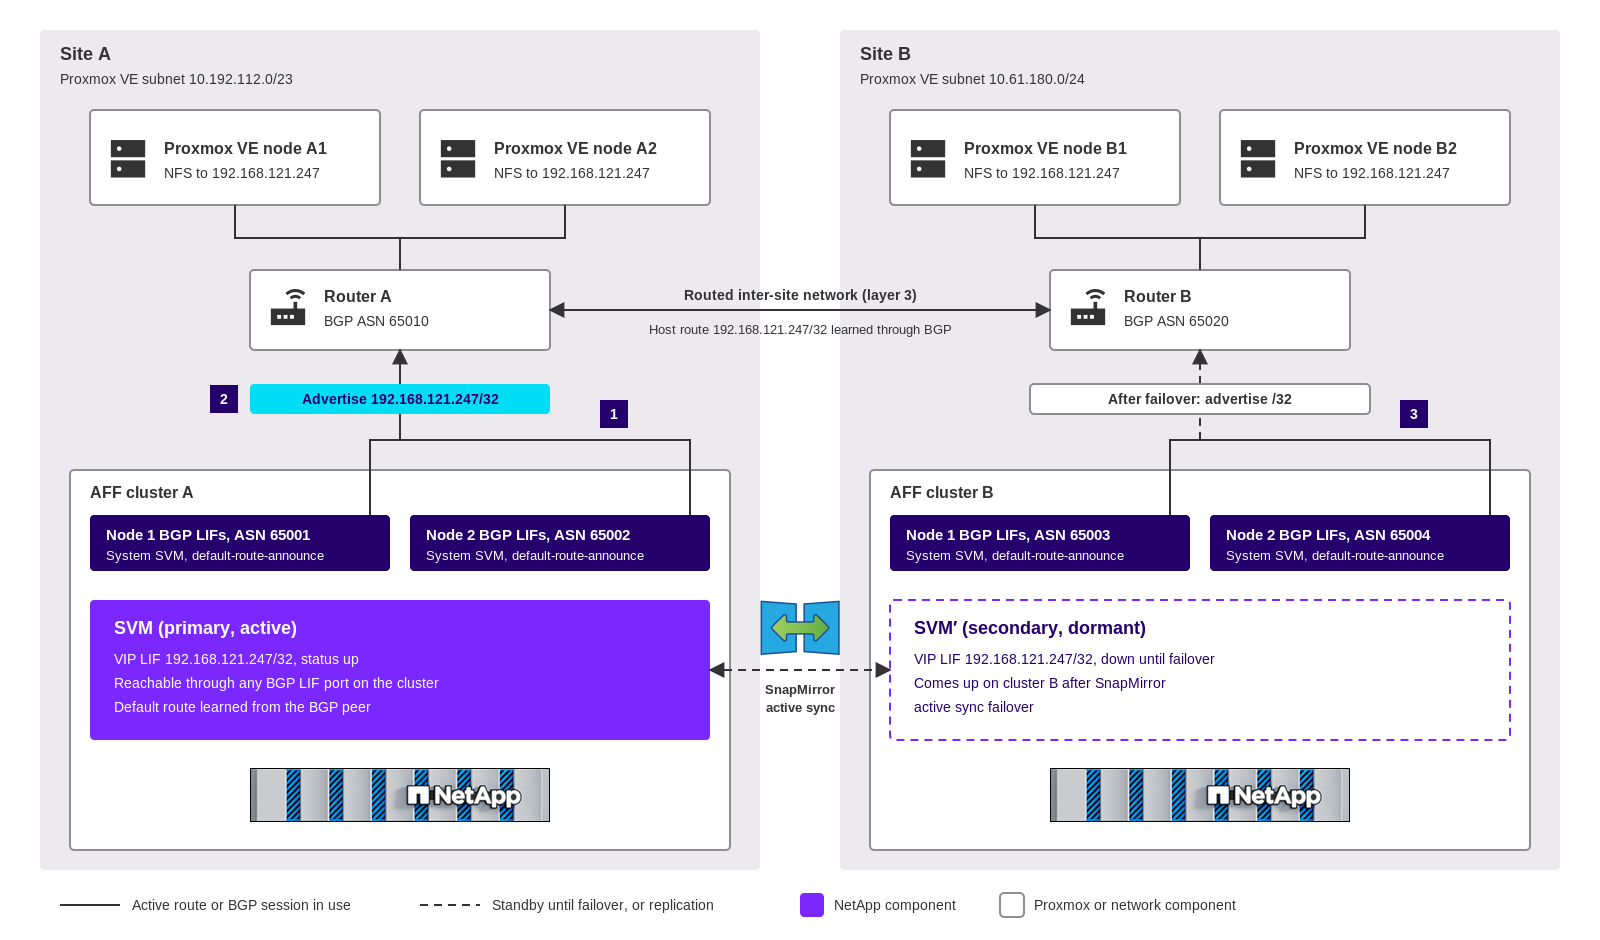
-
Jeder Knoten an beiden Standorten verfügt über BGP-LIFs im System-SVM, die mit den Routern an seinem Standort verbunden sind. BGP-LIFs sind knotenspezifisch und werden nicht repliziert, daher müssen sie auf beiden Clustern konfiguriert werden.
-
Die primäre SVM hostet die NFS VIP LIF. Cluster A kündigt die /32-Hostroute an, und die Proxmox VE-Knoten an beiden Standorten erreichen den Storage über das geroutete Netzwerk.
-
Nach einem SnapMirror active sync Failover wird die VIP LIF auf der sekundären SVM aktiviert, Cluster B kündigt die Host-Route an, und die Router konvergieren auf Standort B.
Bei der erstmaligen Planung von BGP in ONTAP ist es hilfreich zu wissen, welcher SVM jede LIF gehört. BGP LIFs gehören zur System-SVM des IPspace, nicht zu den Daten-SVMs. Ein Satz von BGP LIFs auf jedem Cluster bedient die VIP LIFs aller Daten-SVMs in diesem IPspace, sodass Sie nicht für jeden Mandanten BGP LIFs erstellen. Das folgende Diagramm zeigt das LIF- und Port-Layout auf einem Cluster, mit BGP LIFs auf VLAN Ports.
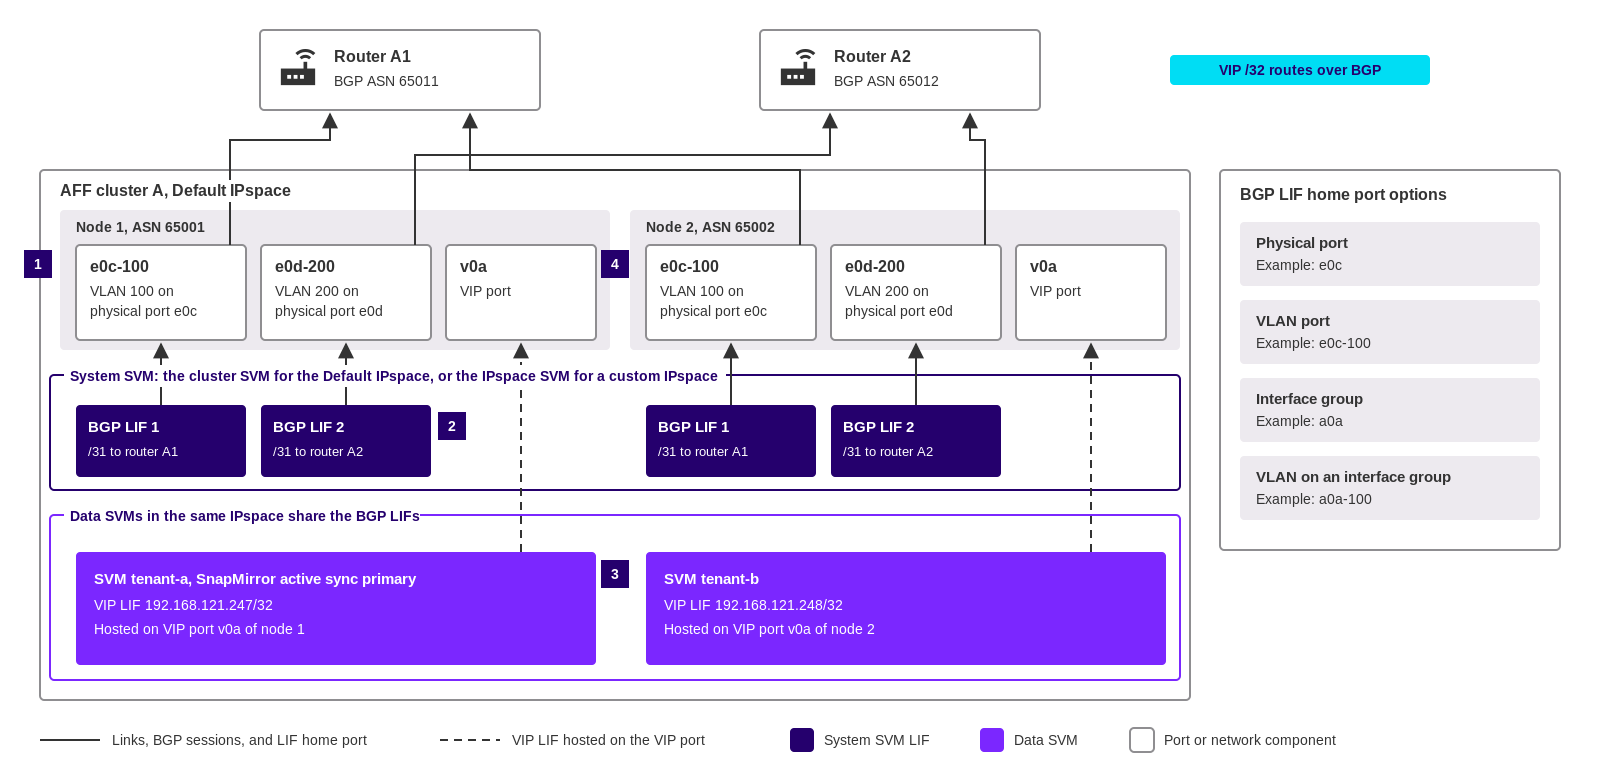
-
Jeder Knoten verfügt über zwei Ports für BGP, in diesem Beispiel die VLAN-Ports
e0c-100unde0d-200. Jeder Port ist direkt mit einem anderen Router verbunden. -
Jeder Knoten verfügt über zwei BGP-LIFs in der system SVM, jeweils eine pro Port, mit einem /31-Subnetz und einer BGP-Peer-Gruppe zu einem Router. Für den Default IPspace ist die system SVM die cluster SVM. Für einen benutzerdefinierten IPspace ist es die SVM mit demselben Namen wie der IPspace.
-
Data SVMs im selben IPspace hosten VIP LIFs und benötigen keine eigenen BGP LIFs. Die BGP Peer-Gruppen kündigen die VIP-Routen für alle SVMs im IPspace an.
-
ONTAP erstellt beim Erstellen der ersten BGP-Peer-Gruppe auf jedem Knoten einen VIP-Port, zum Beispiel
v0a. VIP-LIFs werden auf dem VIP-Port gehostet und sind über jeden Port auf dem Knoten erreichbar, der eine BGP-LIF im IPspace hostet.
Der Home-Port eines BGP LIF kann ein physischer Port, ein VLAN-Port, eine Schnittstellengruppe oder ein VLAN auf einer Schnittstellengruppe sein. Eine Schnittstellengruppe ist nicht erforderlich. NetApp Technical Report TR-4949 empfiehlt für jeden IPspace zwei BGP LIFs auf zwei separaten Ports, die jeweils direkt mit einem anderen First-Hop-Router verbunden sind.
Beachten Sie die folgenden Richtlinien:
-
BGP-LIFs führen kein Failover durch. Die Redundanz ergibt sich aus zwei BGP-LIFs pro Knoten, die jeweils mit einem anderen Router per BGP-Peering verbunden sind. Wenn ein Knoten alle seine BGP-Sitzungen für eine SVM verliert, verschiebt ONTAP die VIP-LIF auf einen anderen Knoten, der für diese SVM über eine aktive BGP-Sitzung verfügt.
-
Zum Einsatz kommt externes BGP (eBGP) mit einer eindeutigen privaten autonomen Systemnummer (ASN) für jeden ONTAP Knoten und jeden Router.
-
Für jeden BGP LIF und den zugehörigen Router wird ein /31-Subnetz (Netzmaske 255.255.255.254) verwendet. Dem BGP LIF wird die Adresse mit ungerader Nummer und dem Router die Adresse mit gerader Nummer zugewiesen.
-
ONTAP verarbeitet keine Routen von den Routern. Die Router müssen so konfiguriert sein, dass sie /32-Hostrouten von ONTAP akzeptieren und keine Routenaktualisierungen an den Cluster senden.
-
Proxmox VE Knoten dürfen sich nicht im selben Subnetz wie die VIP-Adresse befinden. Ein redundanter Layer-3-Router, beispielsweise mit VRRP oder HSRP, muss sich im Pfad zwischen den Knoten und dem Storage befinden.
-
Die BGP-Peer-Gruppen werden
-use-peer-as-next-hop trueso konfiguriert, dass jeder Cluster seine Standardroute von seinen lokalen Routern bezieht. Routen, die auf ein Gateway an Standort A verweisen, sind an Standort B nach einem Failover nicht gültig. -
Multipath-Routing muss aktiviert sein, damit ausgehender VIP-Datenverkehr alle verfügbaren BGP-LIF-Ports nutzt.
-
Die BGP-Haltezeit ist gegenüber dem Standardwert von 180 Sekunden zu verringern. TR-4949 empfiehlt eine Haltezeit von 3 Sekunden. Ein Router zieht die Route aus einem ausgefallenen Cluster erst zurück, wenn der Haltetimer abgelaufen ist, und bei einem Storage-Systemausfall bleibt der Router an Standort A online.