


Utiliza la latencia de las cargas de trabajo para identificar problemas de rendimiento en Active IQ Unified Manager
 Sugerir cambios

 PDF

La latencia de la carga de trabajo (tiempo de respuesta) es el tiempo que tarda un volumen de un clúster en responder a las solicitudes de E/S de las aplicaciones cliente. Unified Manager utiliza la latencia para detectar eventos de rendimiento y avisarte de ellos.
Una latencia alta significa que las solicitudes de las aplicaciones a un volumen de un clúster tardan más de lo habitual. La causa de la latencia alta podría estar en el propio clúster, debido a la contención en uno o más componentes del clúster. La latencia alta también podría deberse a problemas fuera del clúster, como cuellos de botella en la red, problemas con el cliente que aloja las aplicaciones o problemas con las propias aplicaciones.

|
Unified Manager solo supervisa la actividad de la carga de trabajo en el clúster. No supervisa las aplicaciones, los clientes ni las rutas entre las aplicaciones y el clúster. |
Las operaciones en el clúster, como hacer copias de seguridad o ejecutar la deduplicación, que aumentan su demanda de componentes del clúster compartidos con otras cargas de trabajo también pueden contribuir a una latencia elevada. Si la latencia real supera el umbral de rendimiento dinámico del rango previsto (previsión de latencia), Unified Manager analiza el evento para determinar si se trata de un evento de rendimiento que quizá debas resolver. La latencia se mide en milisegundos por operación (ms/op).
En el gráfico «Latency Total» de la página «Workload Analysis», puedes ver un análisis de las estadísticas de latencia para comprobar cómo se compara la actividad de procesos individuales, como las solicitudes de lectura y escritura, con las estadísticas generales de latencia. La comparación te ayuda a determinar qué operaciones tienen la mayor actividad o si hay operaciones específicas con una actividad anómala que está afectando a la latencia de un volumen. Al analizar eventos de rendimiento, puedes usar las estadísticas de latencia para determinar si un evento se debió a un problema en el clúster. También puedes identificar las actividades específicas de la carga de trabajo o los componentes del clúster que intervienen en el evento.
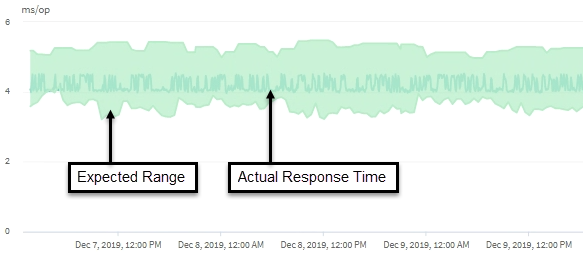
Este ejemplo muestra el gráfico de latencia. La actividad del tiempo de respuesta real (latencia) se representa con una línea azul, mientras que la previsión de latencia (rango esperado) se muestra en verde.
|
|
Puede haber huecos en la línea azul si Unified Manager no pudo recopilar datos. Esto puede ocurrir porque no se podía acceder al clúster o al volumen, porque Unified Manager estaba apagado durante ese tiempo o porque la recopilación tardó más que el periodo de recopilación de 5 minutos. |