


Descubre la continuidad del negocio de Proxmox VE con SnapMirror active sync

 Sugerir cambios

 PDF

Las empresas que ejecutan máquinas virtuales (VM) críticas para el negocio en Proxmox Virtual Environment (VE), así como los proveedores de servicios que alojan VM de clientes en Proxmox VE, necesitan que esas VM sigan funcionando cuando un sistema de almacenamiento o un centro de datos completo se desconecta. SnapMirror active sync de ONTAP replica mediante replicación síncrona el almacenamiento compartido de un clúster de Proxmox VE extendido entre dos sitios y realiza la conmutación por error automática del almacenamiento al sitio superviviente. Obtienes un objetivo de punto de recuperación (RPO) de cero, recuperación automatizada sin scripts ni runbooks y el mismo almacenamiento compartido en ambos sitios, para que la alta disponibilidad (HA) de Proxmox VE pueda reiniciar las VM sin necesidad de reconfigurar el almacenamiento. Para el almacenamiento compartido NFS, la solución utiliza SnapMirror active sync para NAS.
Retos de los clientes
Resulta complicado garantizar la resiliencia del almacenamiento y del sitio para Proxmox VE utilizando únicamente herramientas nativas:
-
Pérdida de datos tras un fallo del sitio. La replicación de almacenamiento de Proxmox VE y Proxmox Backup Server funcionan de forma asíncrona. Los cambios realizados desde la última replicación o copia de seguridad se pierden cuando falla el sitio principal.
-
Recuperación manual y lenta. Recuperarse en un sitio secundario suele implicar promocionar réplicas, montar el almacenamiento en una dirección diferente, actualizar
/etc/pve/storage.cfgy reiniciar las máquinas virtuales. Cada paso manual aumenta el tiempo de inactividad y el riesgo de error durante una interrupción del servicio. -
Almacenamiento extendido que compite con las VMs por los recursos del host. El almacenamiento hiperconvergente extendido, como Ceph en modo stretch, se ejecuta en los nodos de Proxmox VE y mantiene dos réplicas de cada objeto en cada sitio. El tráfico de replicación, recuperación y reequilibrio consume recursos de CPU, memoria y red en los mismos nodos que ejecutan las VMs.
-
Dos decisiones de quórum que deben coincidir. Cualquier diseño de dos sitios necesita un testigo en un tercer dominio de fallo, tanto para el clúster de Proxmox VE como para el almacenamiento. Si el clúster y el almacenamiento eligen diferentes sitios supervivientes tras un fallo en el enlace entre sitios, las VMs se reinician en nodos que no pueden acceder al almacenamiento activo.
-
Una dirección de almacenamiento que debe funcionar en ambos sitios. Tras una conmutación por error del almacenamiento, los nodos de Proxmox VE deben poder acceder al almacenamiento compartido en la misma dirección. Esa dirección debe ser accesible en ambos sitios, lo que normalmente implica una VLAN de capa 2 extendida entre los sitios.
Retos de los proveedores de servicios
Los proveedores de servicios que desarrollan servicios en la nube basados en Proxmox VE se enfrentan a los mismos retos, a los que se suman los acuerdos de nivel de servicio (SLA) con los clientes:
-
El sistema de almacenamiento es un punto de error compartido. Proxmox VE HA protege las VM de los inquilinos de un fallo del host, pero no de un fallo del sistema de almacenamiento que aloja sus discos. Una interrupción del almacenamiento afecta a todos los inquilinos de ese sistema.
-
No hay forma de ofrecer una mayor disponibilidad. Sin replicación síncrona ni conmutación automática por error del almacenamiento, un proveedor no puede ofrecer un nivel prémium de disponibilidad con cero pérdida de datos y compromisos de tiempo de actividad más sólidos.
-
Aislamiento de los inquilinos durante la recuperación. Las pruebas de recuperación, mantenimiento y recuperación ante desastres deben afectar únicamente a los inquilinos implicados y no a toda la plataforma.
Retos empresariales
Las empresas que trasladan cargas de trabajo críticas desde otros hipervisores a Proxmox VE esperan contar con la misma resiliencia del sitio que tenían antes, como cero pérdida de datos para bases de datos y aplicaciones de línea de negocio, y recuperación sin necesidad de un procedimiento manual. Cumplir esa expectativa solo con las herramientas nativas de Proxmox VE requiere un esfuerzo considerable de diseño, scripting y operaciones.
Descripción general de la solución
La solución combina un clúster stretch de Proxmox VE con SnapMirror active sync en sistemas NetApp AFF en dos sitios:
-
RPO cero. ONTAP replica de forma síncrona cada operación de escritura en el almacenamiento compartido desde el clúster primario del sitio A hasta el clúster secundario del sitio B.
-
El mismo almacenamiento compartido en ambos sitios. Tras una conmutación por error, el clúster secundario presenta el mismo almacenamiento a Proxmox VE, por lo que las definiciones de almacenamiento en
/etc/pve/storage.cfgsiguen siendo válidas. -
Conmutación automática por error. Un mediador actúa como testigo fuera de los dos sitios. Puedes instalar ONTAP Mediator en un tercer sitio o usar ONTAP Cloud Mediator, un servicio alojado en la NetApp Console. Cuando falla el almacenamiento primario o el sitio, ONTAP conmuta por error al sitio B sin intervención manual.
-
Control granular. Tú eliges qué cargas de trabajo proteger y puedes realizar la conmutación por error de las cargas de trabajo individualmente, por ejemplo, para trasladar un inquilino o una aplicación por mantenimiento del sitio.
-
Uso de la copia secundaria. Puedes clonar la copia secundaria para desarrollo, pruebas o pruebas de recuperación ante desastres sin afectar a la replicación.
Cómo aborda la solución los retos
| Reto | Cómo ayuda la solución | Lo que todavía tienes previsto hacer |
|---|---|---|
Pérdida de datos y recuperación manual |
La replicación síncrona ofrece un RPO igual a cero. ONTAP realiza la conmutación por error automáticamente, y el SVM secundario presenta la misma dirección NFS, por lo que |
Proxmox VE HA sigue reiniciando las máquinas virtuales desde un sitio que ha fallado. |
Almacenamiento extendido en los hosts |
La replicación se ejecuta en los controladores AFF, no en los nodos de Proxmox VE, por lo que la CPU del host, la memoria y la red siguen disponibles para las VMs. ONTAP mantiene una copia en cada sitio y la eficiencia del almacenamiento se aplica a ambas copias. |
Como cualquier replicación síncrona, la solución necesita una segunda copia completa en el sitio B, y la replicación añade carga a ambos clústeres AFF. Dimensiona ambos clústeres para la carga de trabajo de replicación. |
Dos decisiones de quórum |
ONTAP Mediator, u ONTAP Cloud Mediator como servicio en NetApp Console, es un testigo ligero fuera de la ruta de datos. Esta solución muestra cómo alinear corosync QDevice con el clúster primario para que ambos elijan el mismo sitio. |
Todavía se necesita una tercera ubicación para el QDevice. También se necesita para ONTAP Mediator, pero no para ONTAP Cloud Mediator. Consulta Opciones de Mediator. |
Una dirección de almacenamiento en ambos sitios |
La SVM secundaria asume la misma dirección LIF de NFS, por lo que no es necesario volver a montar ni reconfigurar el almacenamiento. |
La subred NFS debe ser accesible desde ambas ubicaciones, normalmente mediante una VLAN de capa 2 extendida. Consulta Redes de capa 3 con LIF VIP y BGP para conocer el estado de cualificación de las VIP LIF. |
El siguiente diagrama muestra la arquitectura de la solución con almacenamiento compartido NFS.
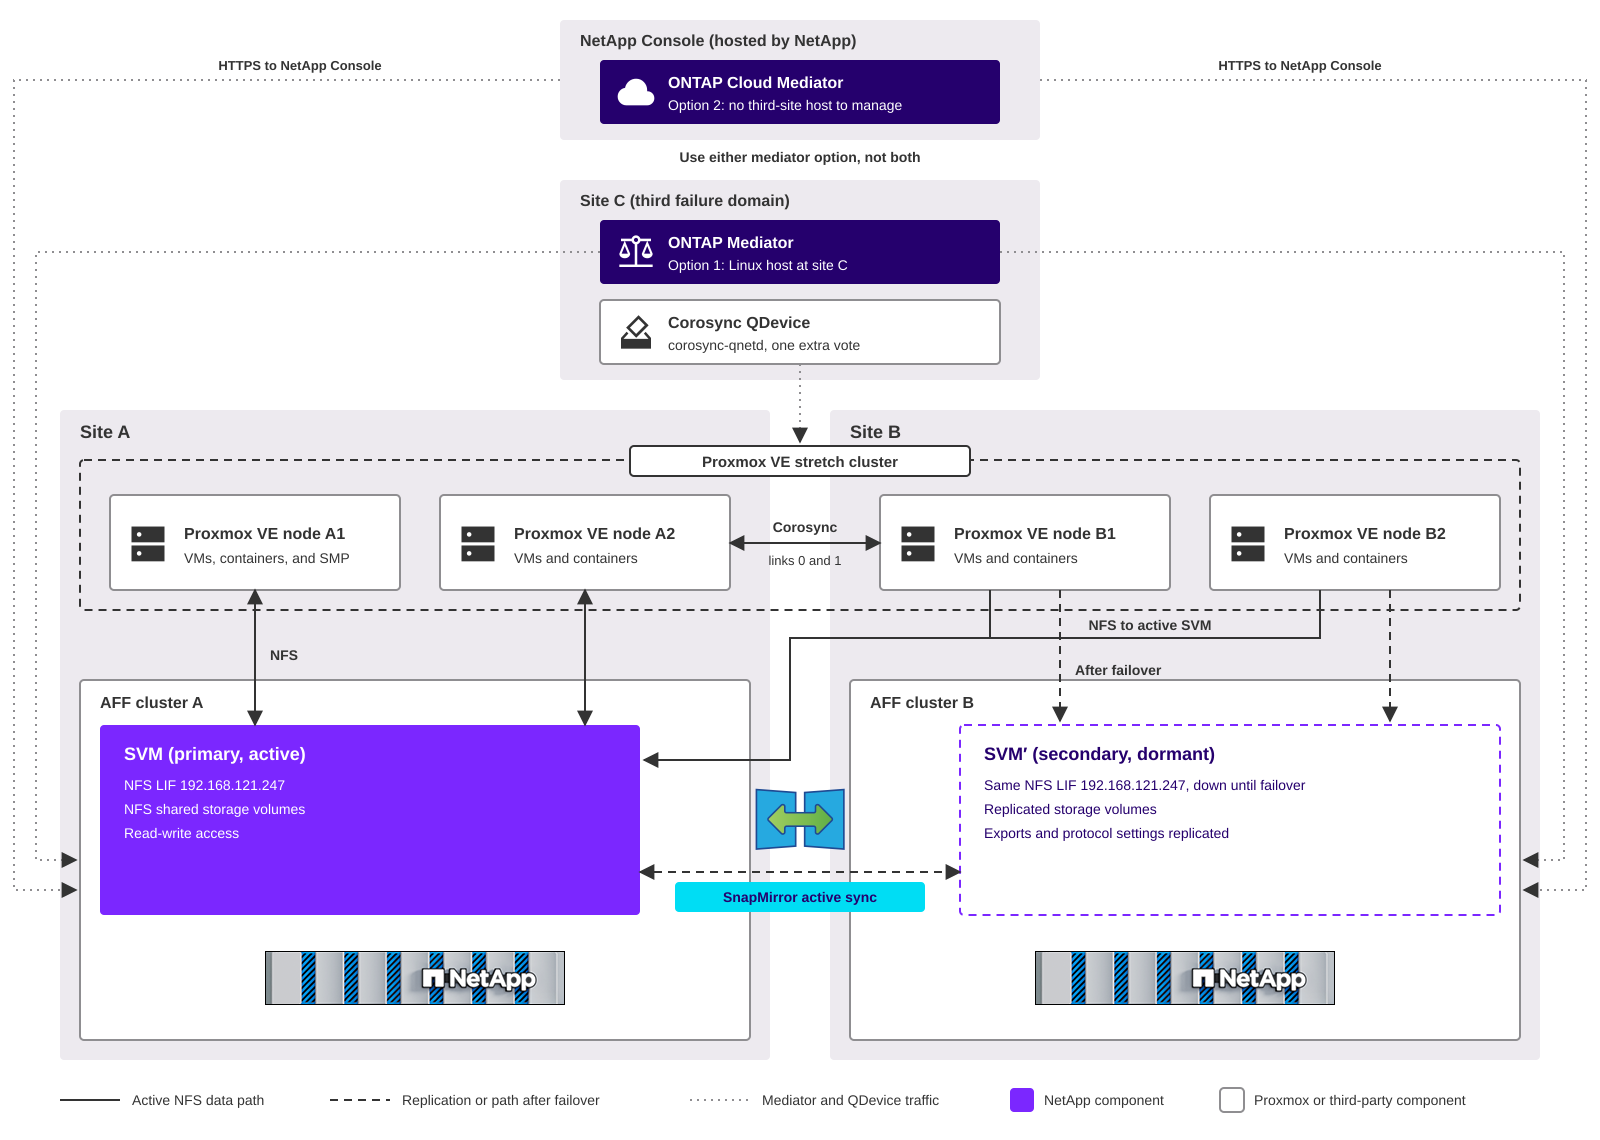
- Sitio A y sitio B
-
Cada sitio tiene un clúster AFF de dos nodos y la mitad de los nodos de Proxmox VE. El clúster primario del sitio A proporciona el almacenamiento compartido a todos los nodos de Proxmox VE. Los nodos del sitio B llegan al clúster primario a través de la red entre sitios. Con almacenamiento NFS, la SVM secundaria del sitio B permanece inactiva hasta que se produce una conmutación por error.
- Sitio C
-
Un tercer dominio de fallo alberga el daemon de QDevice de corosync (
corosync-qnetd) y, si eliges la opción 1, ONTAP Mediator. El QDevice proporciona un voto adicional para que el clúster de Proxmox VE mantenga el quórum cuando falla un sitio. - NetApp Console
-
Si eliges la opción 2, ONTAP Cloud Mediator se ejecuta como un servicio en NetApp Console, que NetApp aloja y gestiona. Ambos clústeres AFF se conectan a él a través de HTTPS, por lo que no necesitas instalar ni mantener un host mediador.
- Mediador
-
ONTAP Mediator u ONTAP Cloud Mediator ayudan a ONTAP a decidir qué clúster sirve los datos. Utiliza uno de ellos, no ambos. Para ver una comparación, consulta Opciones de Mediator.
- Clúster stretch de Proxmox VE
-
Todos los nodos de Proxmox VE pertenecen a un mismo clúster y comparten las mismas definiciones de almacenamiento. Proxmox VE HA reinicia las VMs de un sitio que ha sufrido un fallo en los nodos que siguen operativos. Storage Manager for Proxmox (SMP) se ejecuta como una VM de HA en el clúster para aprovisionar almacenamiento compartido y para hacer copias de seguridad, restaurar y clonar VMs.
Opciones de Mediator
SnapMirror active sync utiliza un mediador como testigo pasivo. Durante una partición de red o el fallo de un clúster, ONTAP utiliza el mediador para decidir qué copia sigue atendiendo las operaciones de E/S. El mediador no está en la ruta de datos y no inicia por sí mismo las conmutaciones por error. Puedes utilizar una de las siguientes opciones, pero no ambas a la vez.
| Consideración | Opción 1: ONTAP Mediator | Opción 2: ONTAP Cloud Mediator |
|---|---|---|
Dónde se ejecuta |
Un host Linux que instalas y gestionas en un tercer dominio de fallo, como el sitio C, con infraestructura eléctrica y de red independientes. |
Un servicio en la nube en NetApp Console. NetApp se encarga de alojarlo y gestionarlo, por lo que no necesitas un host mediador en un tercer sitio. |
Versión de ONTAP |
ONTAP 9.19.1 o posterior para SnapMirror active sync para NAS. |
ONTAP Cloud Mediator está disponible a partir de ONTAP 9.17.1. SnapMirror active sync para NAS requiere ONTAP 9.19.1 o una versión posterior. |
Conectividad del clúster |
Ambos clústeres se conectan al host del mediador. El puerto de servicio predeterminado es 31784. |
Ambos clústeres se conectan de forma saliente a través de HTTPS a la NetApp Console, ya sea directamente o a través de un proxy HTTP. La latencia de ping recomendada para la NetApp Console debe ser inferior a 200 ms. |
Configuración |
Instala el paquete en el host Linux y, a continuación, añádelo a los clústeres con la dirección del host y un usuario mediador. |
Crea una cuenta de servicio de NetApp Console con el ONTAP Mediator Setup Role y, a continuación, añade el mediador a los clústeres con el ID de organización, el ID de cliente y el secreto de cliente. |
Operaciones |
Aplicas parches y actualizaciones al host, y lo mantienes disponible. |
No hay ningún host que parchear ni actualizar. Dependes del acceso a internet desde ambos sitios y de la disponibilidad del servicio NetApp Console. |
La mejor opción |
Entornos que cuentan con una tercera sede o que no permiten que los clústeres de almacenamiento accedan a internet. |
Entornos que no cuentan con un tercer sitio para un mediador o que quieren evitar operarlo. |
Ten en cuenta lo siguiente a la hora de elegir:
-
El QDevice aún necesita una tercera ubicación. ONTAP Cloud Mediator elimina el host mediador, no el host QDevice de corosync. El QDevice necesita un pequeño host Linux al que todos los nodos de Proxmox VE puedan acceder por el puerto TCP 5403, y no tiene el requisito de baja latencia de corosync.
-
Ambos clústeres necesitan acceso a la NetApp Console. Si los clústeres utilizan un proxy, instala el certificado de la CA raíz del proxy en ambos clústeres. NetApp recomienda utilizar un servidor proxy diferente para cada clúster.
-
Planifica el mismo comportamiento ante fallos con cualquiera de las dos opciones. Cuando el mediador no está disponible, la replicación continúa sin pérdida de datos, pero no es posible realizar conmutaciones automáticas ni planificadas hasta que el mediador vuelva a estar disponible. Con ONTAP Cloud Mediator, esto incluye una pérdida de conectividad de los clústeres a NetApp Console.

|
Las opciones de mediador de esta sección se aplican a SnapMirror active sync. Para MetroCluster, esta solución utiliza ONTAP Mediator o MetroCluster Tiebreaker. Antes de implementar, comprueba que tu versión de ONTAP, la opción de mediador y la versión de Proxmox VE figuren juntas en "Herramienta de matriz de interoperabilidad (IMT) de NetApp". |
Ventajas para los proveedores de servicios
-
Disponibilidad de las VM más allá de la HA del host. Las VM de tenant siguen funcionando cuando falla el sistema de almacenamiento que aloja sus discos. ONTAP conmuta al segundo clúster AFF, y las VM reanudan la E/S en el mismo almacenamiento compartido sin reiniciarse.
-
Un nivel de disponibilidad premium. Puedes ofrecer un servicio de máquinas virtuales con RPO cero y resiliencia del almacenamiento como complemento, junto con los niveles estándar en almacenamiento no protegido dentro de los mismos clústeres.
-
Protección y conmutación por error por tenant. Con almacenamiento protegido independiente para cada tenant o nivel de servicio, puedes proteger, realizar la conmutación por error y probar la recuperación ante desastres de cada tenant de forma independiente, sin afectar a los demás tenants.
-
Mejor aprovechamiento de ambos sitios. Puedes configurar algunas cargas de trabajo como primarias en el sitio A y otras como primarias en el sitio B, de modo que ambos centros de datos sirvan cargas de trabajo activas.
Ventajas para las empresas
-
Cero pérdida de datos para VMs críticas para la empresa durante un fallo del almacenamiento o del sitio.
-
Recuperación automática sin scripts, sin volver a montar el almacenamiento ni realizar cambios en
/etc/pve/storage.cfg. -
Integrado en ONTAP, sin ninguna capa de software adicional en los nodos de Proxmox VE.
-
Operaciones del día a día desde una sola interfaz. Storage Manager para Proxmox aprovisiona el almacenamiento compartido protegido y realiza copias de seguridad, restaura y clona máquinas virtuales con instantáneas de ONTAP y la tecnología FlexClone.
Cómo responde la solución ante los fallos
ONTAP y Proxmox VE toman decisiones de quórum de forma independiente. El diseño los alinea para que ambos elijan el mismo sitio superviviente.
| Evento | Comportamiento de ONTAP | Comportamiento de Proxmox VE |
|---|---|---|
Falla el sitio A |
El mediador confirma el fallo y ONTAP realiza automáticamente la conmutación por error del almacenamiento compartido al clúster B. |
Los nodos del sitio B y el QDevice mantienen el quórum. HA aísla los nodos del sitio A y reinicia sus VMs en los nodos del sitio B. Las VMs que ya están en el sitio B reanudan la I/O tras la conmutación por error del almacenamiento. |
El clúster A de AFF falla, los nodos de Proxmox VE del sitio A siguen funcionando |
El mediador confirma que no se puede acceder al clúster A y ONTAP conmuta automáticamente el almacenamiento compartido al clúster B. |
No se produce ningún cambio en el quórum ni se reinicia ninguna máquina virtual. Las máquinas virtuales de todos los nodos reanudan las operaciones de E/S en el mismo almacenamiento compartido tras la conmutación por error del almacenamiento, y los nodos del sitio A se conectan al clúster B a través de la red entre sitios. |
Falla un controlador AFF en el sitio A |
El controlador asociado asume el control en una toma de control de alta disponibilidad local. No se produce ninguna conmutación por error de SnapMirror active sync. |
Sin repercusiones. Las VM detienen brevemente las operaciones de E/S durante la toma de control. |
Falla el sitio B |
El clúster A sigue proporcionando datos. La replicación se reanuda cuando el sitio B vuelve a estar operativo. |
Los nodos del sitio A y el QDevice mantienen el quórum. HA reinicia las máquinas virtuales del sitio B en los nodos del sitio A. |
Falla el enlace entre sitios |
El clúster A sigue proporcionando datos. No se produce ninguna conmutación por error. |
El QDevice otorga su voto a la partición del sitio A cuando el mecanismo de desempate está alineado con el clúster principal. Los nodos del sitio B pierden el quórum y se autoaíslan, y HA reinicia sus VMs en el sitio A. |
El sitio C falla o los clústeres pierden acceso a la NetApp Console |
La replicación continúa sin pérdida de datos, pero no es posible realizar conmutaciones por error automáticas ni planificadas hasta que el mediador esté disponible. Con ONTAP Cloud Mediator, un fallo del sitio C solo afecta al QDevice. |
El clúster mantiene el quórum con los votos de los cuatro nodos. No se ve afectada ninguna VM. |
Falla un nodo de Proxmox VE |
Sin impacto. |
HA reinicia las máquinas virtuales de ese nodo en otros nodos, dando prioridad a los nodos del mismo sitio. |
Fallo del sistema de almacenamiento
Un fallo del sistema de almacenamiento es un caso que la HA a nivel de host por sí sola no puede gestionar, y es el caso en el que SnapMirror active sync aporta el mayor valor a los proveedores de servicios. El siguiente diagrama muestra el estado después de que falle el clúster AFF A mientras todos los nodos de Proxmox VE siguen en línea, con almacenamiento compartido NFS.
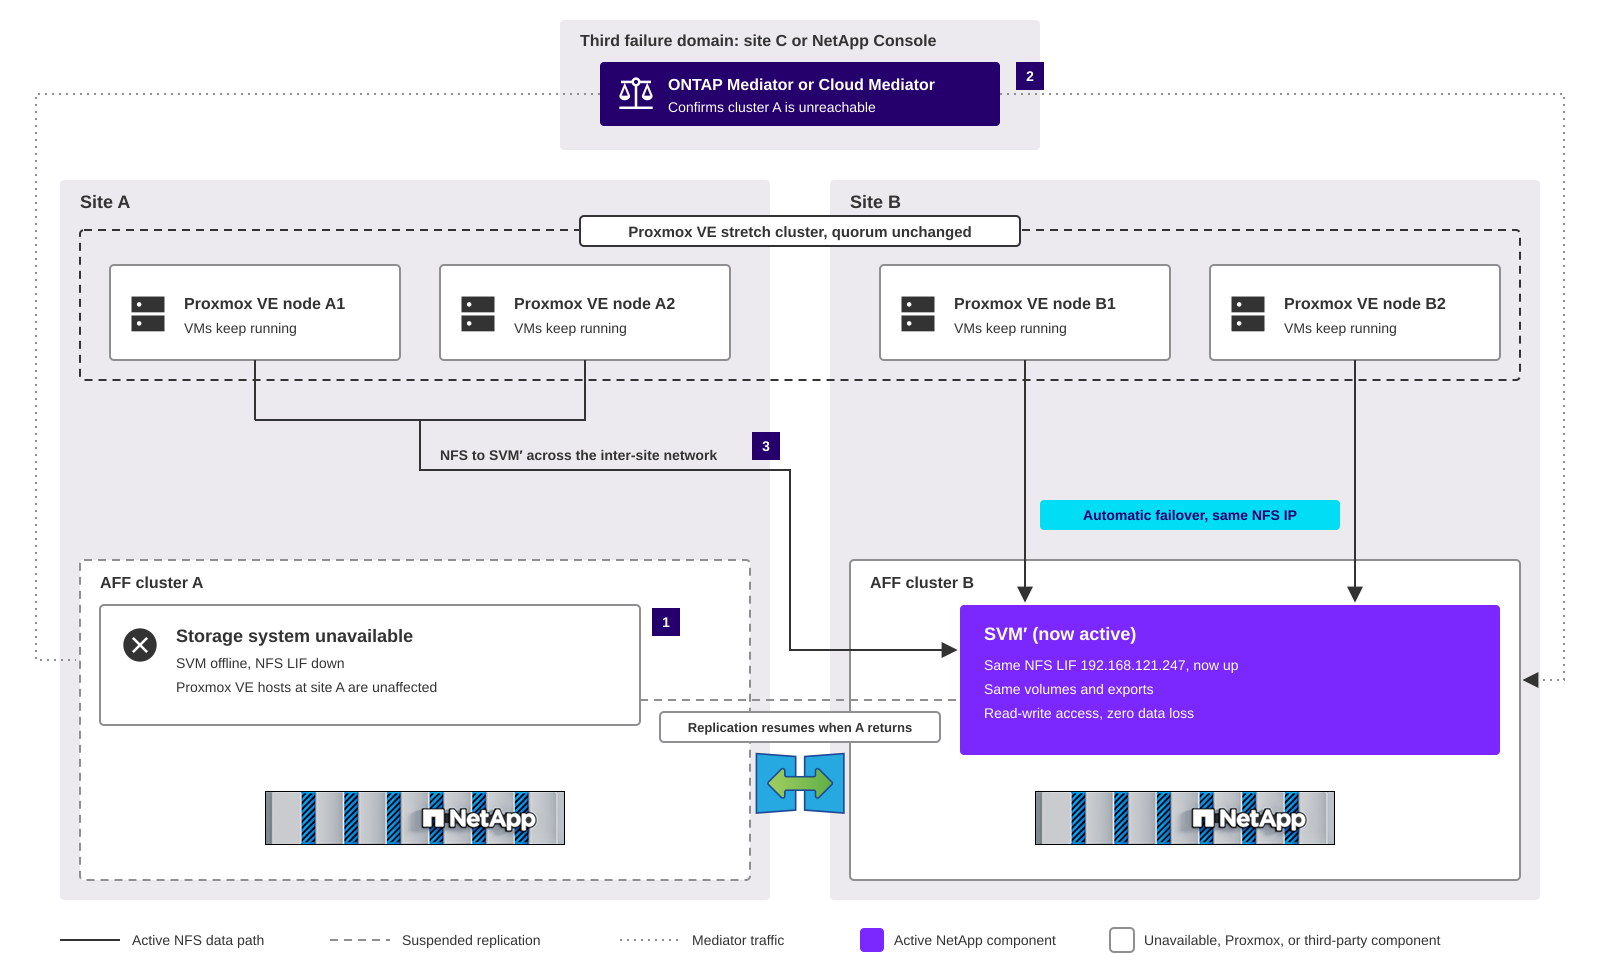
-
El clúster AFF A deja de estar disponible. Los nodos de Proxmox VE del sitio A siguen funcionando, por lo que el clúster no pierde el quórum y HA no aplica fencing a ningún nodo.
-
El mediador, ONTAP Mediator en el sitio C o ONTAP Cloud Mediator en la NetApp Console, confirma que no se puede acceder al clúster A, y ONTAP activa la SVM secundaria en el clúster B con la misma dirección LIF de NFS, los mismos volúmenes y las mismas políticas de exportación.
-
Todos los nodos de Proxmox VE reanudan las operaciones de E/S en el mismo almacenamiento compartido. Los nodos del sitio B acceden al clúster B de forma local, mientras que los del sitio A lo hacen a través de la red entre sitios. Las máquinas virtuales detienen temporalmente las operaciones de E/S durante la conmutación por error y continúan ejecutándose sin necesidad de reiniciarse.
Cuando el clúster A vuelva a estar operativo, la replicación se reanuda. Planifica el retorno al clúster A durante una ventana de mantenimiento para que las VMs del sitio A vuelvan a acceder al almacenamiento local.
Fallo del sitio
Durante un fallo del sitio, tanto el sistema de almacenamiento como los nodos de Proxmox VE de ese sitio quedan fuera de línea. ONTAP conmuta el almacenamiento compartido al clúster que sigue operativo, y Proxmox VE HA reinicia las VMs del sitio que ha fallado en los nodos que siguen operativos, tal como se describe en la tabla.
Elige entre SnapMirror active sync y MetroCluster
Las configuraciones de NetApp MetroCluster también ofrecen un RPO de cero y recuperación automática para un clúster stretch de Proxmox VE. Las dos soluciones se diferencian en lo que protegen:
-
MetroCluster protege todas las cargas de trabajo. MetroCluster combina la agrupación en clústeres basada en matrices con la replicación síncrona. Replica los datos de cada agregado reflejado, la NVRAM y la configuración de cada SVM en el sitio asociado, de modo que todo el almacenamiento compartido del clúster queda protegido sin necesidad de una configuración específica para cada carga de trabajo.
-
SnapMirror active sync protege un subconjunto de cargas de trabajo. Tú eliges qué SVM o volúmenes proteger, y puedes conmutar cada uno de forma independiente. Las cargas de trabajo no protegidas pueden compartir los mismos clústeres.
Ambas soluciones conservan una copia completa de los datos protegidos en cada sitio, requieren un testigo en un tercer dominio de fallo y añaden carga de replicación a los controladores de almacenamiento. Se diferencian en el alcance de la protección, la granularidad de la conmutación por error y el diseño del clúster.
|
|
Antes de implementar cualquiera de las dos soluciones, comprueba que tu versión de ONTAP, tu configuración de MetroCluster o de SnapMirror active sync y tu versión de Proxmox VE figuren juntas en "Herramienta de matriz de interoperabilidad (IMT) de NetApp". |
MetroCluster arquitectura con Proxmox VE
El siguiente diagrama muestra un clúster stretch de Proxmox VE con una configuración IP de MetroCluster de cuatro nodos y almacenamiento compartido NFS.
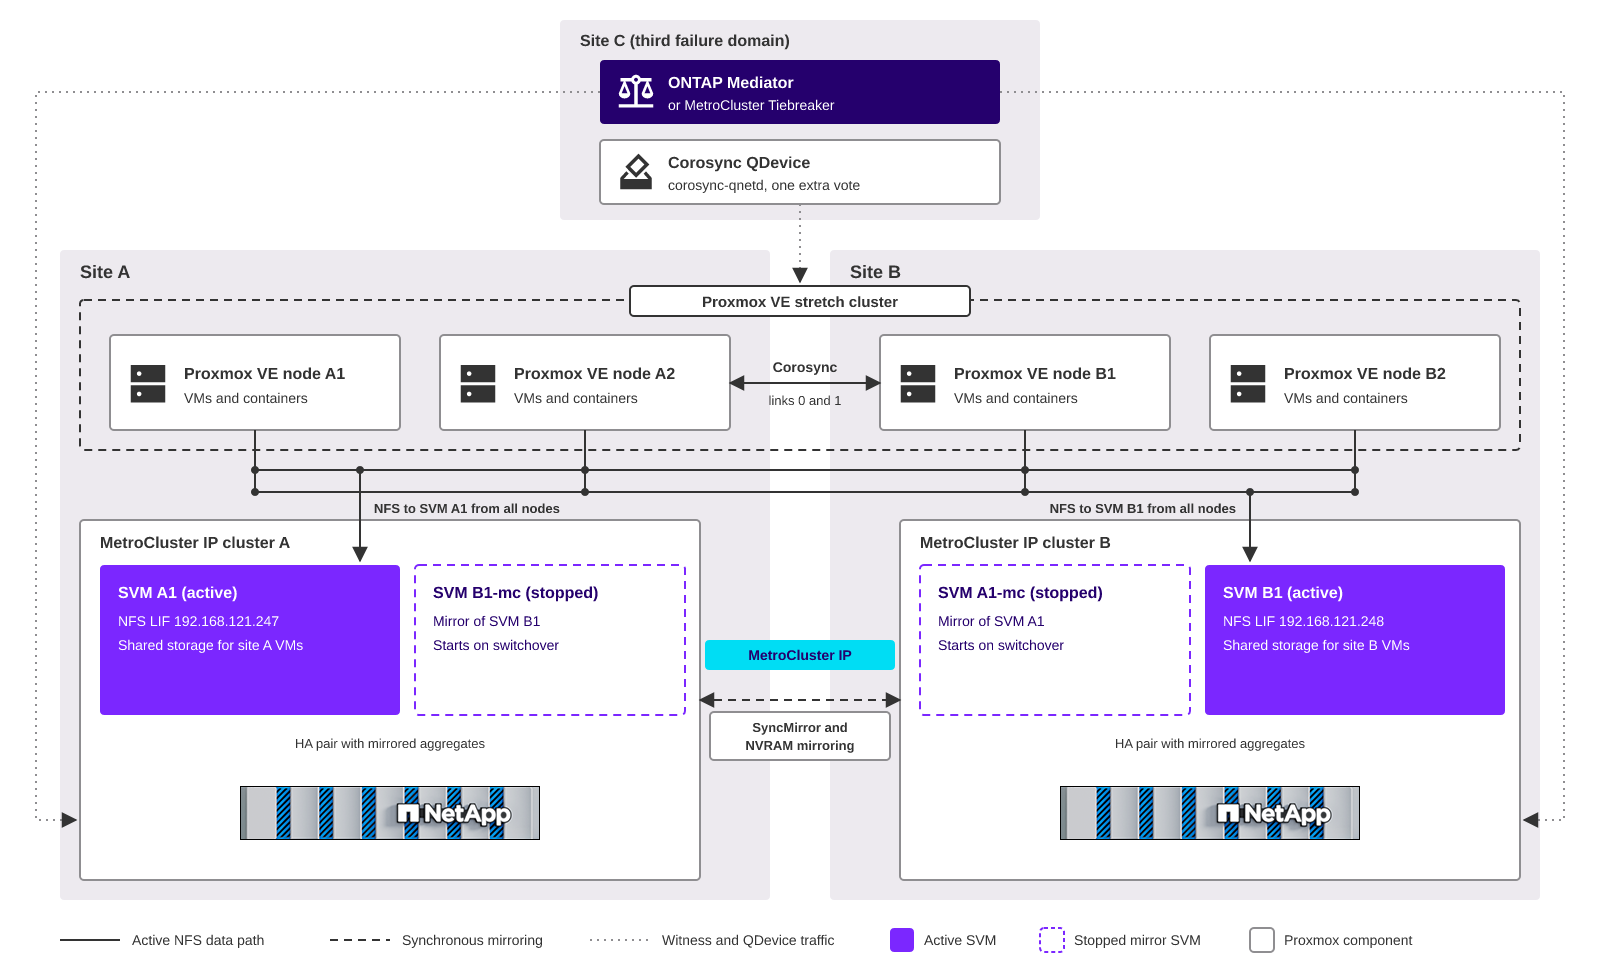
- MetroCluster clústeres IP
-
Cada sitio cuenta con un par de HA con agregados reflejados. La red back-end IP de MetroCluster refleja los datos (SyncMirror) y la NVRAM en el sitio del partner de forma síncrona.
- SVMs en ambos sitios
-
Cada sitio puede dar servicio a sus propias SVM. Para cada SVM, MetroCluster mantiene una SVM espejo detenida con el sufijo
-mcen el sitio del partner, con la misma configuración y las mismas direcciones LIF. - Acceso a NFS desde todos los nodos
-
Cada nodo de Proxmox VE monta el almacenamiento compartido de ambas SVM activas, SVM A1 y SVM B1, para que HA pueda reiniciar cualquier VM en cualquier nodo. Los nodos del sitio B acceden a SVM A1, y los nodos del sitio A acceden a SVM B1, a través de la red entre sitios. Este es el mismo modelo de acceso que SnapMirror active sync.
- Conmutación de sitios
-
Si un sitio falla, ONTAP Mediator o MetroCluster Tiebreaker en el sitio C permiten una conmutación de sitios automática. Las SVM reflejadas del sitio que sigue operativo se inician y prestan servicio a todo el almacenamiento compartido con las mismas direcciones NFS, y Proxmox VE HA reinicia las máquinas virtuales del sitio que falló. El fallo de un único controlador se gestiona mediante un takeover local de HA, sin una conmutación de sitios. Después de reparar el sitio que falló, recuperas los agregados y vuelves atrás.
Cómo responde MetroCluster ante los fallos
La siguiente tabla muestra cómo responden una configuración IP de MetroCluster y el clúster stretch de Proxmox VE a los mismos fallos que en Cómo responde la solución ante los fallos. En este ejemplo, SVM A1 está activa en el sitio A y SVM B1 está activa en el sitio B.
| Evento | Comportamiento de ONTAP | Comportamiento de Proxmox VE |
|---|---|---|
Falla el sitio A |
ONTAP Mediator o MetroCluster Tiebreaker confirman el fallo, y ONTAP realiza la conmutación de sitios del sitio A. SVM A1-mc se inicia en el sitio B con la misma dirección LIF de NFS. SVM B1 sigue sirviendo datos. |
Los nodos del sitio B y el QDevice mantienen el quórum. HA aísla los nodos del sitio A y reinicia sus máquinas virtuales en los nodos del sitio B. Las máquinas virtuales que ya se ejecutaban en los nodos del sitio B siguen ejecutándose, y las que estaban en SVM A1 reanudan las operaciones de E/S tras la conmutación de sitios. |
MetroCluster clúster IP A falla, los nodos de Proxmox VE del sitio A siguen funcionando |
ONTAP Mediator o MetroCluster Tiebreaker confirma que no se puede acceder al clúster A, y ONTAP conmuta el sitio A. SVM A1-mc se inicia en el sitio B con la misma dirección LIF de NFS. |
No se produce ningún cambio en el quórum ni se reinicia ninguna VM. Las VM en SVM A1 reanudan la E/S tras la conmutación de sitios, y los nodos del sitio A llegan al sitio B a través de la red entre sitios. |
Falla un controlador en el sitio A |
El partner de HA del sitio A asume el control en una toma de control local de HA. No hay ninguna conmutación de sitios. |
Sin repercusiones. Las VM detienen brevemente las operaciones de E/S durante la toma de control. |
Falla el sitio B |
ONTAP realiza la conmutación de sitios al sitio B. SVM B1-mc se inicia en el sitio A con la misma dirección de LIF de NFS. SVM A1 sigue sirviendo datos. |
Los nodos del sitio A y el QDevice mantienen el quórum. HA reinicia las máquinas virtuales del sitio B en los nodos del sitio A, desde donde acceden a la SVM B1 del sitio A. |
Falla el enlace entre sitios |
No se produce ninguna conmutación de sitios, ya que ambos clústeres siguen en funcionamiento. Cada sitio sigue prestando servicio a sus propias SVM, y el mirroring hacia el sitio asociado se suspende hasta que se restablezca el enlace. |
El QDevice da su voto a la partición del sitio A cuando el mecanismo de desempate está alineado con el sitio A. Los nodos del sitio B pierden el quórum y se aíslan automáticamente. HA reinicia las VMs en SVM A1 en los nodos del sitio A. Las VMs en SVM B1 no pueden reiniciarse hasta que vuelva el enlace, porque los nodos del sitio A no pueden acceder a SVM B1. |
Falla el sitio C |
El reflejo continúa sin pérdida de datos, pero la conmutación de sitios automática no es posible hasta que el testigo esté disponible. Aun así, puedes realizar la conmutación de sitios manualmente. |
El clúster mantiene el quórum con los votos de los cuatro nodos. No se ve afectada ninguna VM. |
Falla un nodo de Proxmox VE |
Sin impacto. |
HA reinicia las máquinas virtuales de ese nodo en otros nodos, dando prioridad a los nodos del mismo sitio. |
El fallo del enlace entre sitios es la principal diferencia con respecto a un diseño con un único sitio principal. Siempre que ambos sitios alojen SVM activas, ya sea con MetroCluster o con dos SVM de sincronización activa de SnapMirror en direcciones opuestas, el mecanismo de desempate de corosync solo puede favorecer a un sitio. Las máquinas virtuales cuyo SVM activo esté en el otro sitio permanecerán inactivas hasta que vuelva el enlace. Para limitar el impacto, usa enlaces redundantes entre sitios en rutas físicas separadas y coloca las máquinas virtuales más críticas en la SVM del sitio que favorece el mecanismo de desempate.
Comparativa de características
| Consideración | SnapMirror active sync para NAS | MetroCluster IP |
|---|---|---|
Ámbito de protección |
SVM y volúmenes seleccionados |
Todos los agregados reflejados y todas las SVM de la configuración |
Granularidad de la conmutación por error |
Cada SVM de manera independiente |
Todo el sitio, por conmutación de sitios |
Cargas de trabajo sin protección |
Ejecutar en SVM no protegidas en los mismos clústeres |
Se pueden utilizar agregados no reflejados, que quedan fuera de línea tras una conmutación de sitios hasta que se vuelven a poner en línea |
Diseño de clústeres |
Dos clústeres independientes, emparejados a través de una red IP |
Una configuración de dos clústeres asociados, con una red de back-end IP dedicada de MetroCluster |
Testigo en el sitio C |
ONTAP Mediator u ONTAP Cloud Mediator |
ONTAP Mediator o MetroCluster Tiebreaker |
Copias de datos protegidos |
Uno en cada sitio |
Uno en cada sitio, en agregados reflejados |
Ruta de replicación |
SnapMirror sincrónico a través de LIFs entre clústeres |
SyncMirror y la duplicación de NVRAM a través de la red back-end IP de MetroCluster |
Dirección NFS en ambos sitios |
VLAN de capa 2 extendida. LIF VIP con BGP pendientes de calificación |
VLAN de capa 2 extendida o LIF VIP con BGP |
Recuperación tras un fallo del sitio |
Realiza la conmutación por recuperación de cada SVM |
Recupera los agregados y, a continuación, vuelve a conmutar el sitio |
Guía de selección
-
Elige MetroCluster cuando todas o casi todas las cargas de trabajo del almacenamiento necesiten un RPO igual a cero, por ejemplo, cuando una empresa ejecute solo máquinas virtuales de misión crítica en el clúster o un proveedor de servicios ofrezca el mismo nivel de disponibilidad a cada inquilino. Obtienes un dominio de protección sin configuración por carga de trabajo.
-
Elige la sincronización activa de SnapMirror cuando solo un subconjunto de cargas de trabajo necesite un RPO nulo, por ejemplo, un nivel Premium para algunos inquilinos, o cuando necesites realizar una conmutación por error o probar la recuperación ante desastres de un inquilino o una aplicación cada vez.
-
SnapMirror active sync para NAS no es compatible con una configuración de MetroCluster. Utiliza una solución para cada par de clústeres.
-
Las directrices sobre corosync, QDevice y HA de esta solución se aplican a ambos. Con MetroCluster, alinea el interruptor de QDevice con el sitio que sigue sirviendo datos cuando falla el enlace entre sitios, y usa las reglas de afinidad de nodos de HA para mantener las VMs en el mismo sitio que su SVM activa.
-
MetroCluster IP también es compatible con VIP LIFs con BGP para redes de capa 3 entre sitios.
Consideraciones de Corosync para un clúster stretch de Proxmox VE
Proxmox VE utiliza corosync para la pertenencia al clúster y el quórum. Corosync es más sensible a la red entre sitios que SnapMirror active sync, por lo que conviene planificar primero la red del clúster.
Latencia y diseño de red
-
SnapMirror active sync requiere un tiempo de ida y vuelta (RTT) entre clústeres inferior a 10 ms. Proxmox recomienda una latencia de corosync inferior a 5 ms entre todos los nodos, por lo que el requisito de corosync establece el límite de distancia para la solución.
-
Corosync necesita una latencia baja y constante, más que un ancho de banda elevado. Utiliza una red dedicada para corosync, independiente del tráfico de almacenamiento y de migración en vivo, para que los picos de tráfico del almacenamiento no provoquen tiempos de espera en corosync.
-
Configura al menos dos enlaces de corosync (por ejemplo, el enlace 0 y el enlace 1) en rutas físicas independientes entre los sitios. Corosync utiliza Kronosnet para cambiar de enlace automáticamente si falla una ruta.
Quórum con un QDevice en un tercer sitio
Distribuye los nodos de Proxmox VE de forma equitativa entre el sitio A y el sitio B, y añade un QDevice en el sitio C. Con cuatro nodos y un QDevice, el clúster tiene cinco votos y necesita tres para alcanzar el quórum, por lo que cualquiera de los sitios puede fallar sin que se pierda el quórum. El QDevice se conecta al clúster a través del puerto TCP 5403 y no tiene el requisito de baja latencia de corosync, por lo que puede compartir el sitio C con ONTAP Mediator. Si usas ONTAP Cloud Mediator, sigues necesitando una tercera ubicación para el QDevice, pero puede ser un pequeño host Linux que no aloje también un mediador.
Alineación del desempate con el clúster principal
Cuando falla el enlace entre sitios, pero ambos sitios aún pueden acceder al sitio C, ONTAP mantiene el clúster principal del sitio A sirviendo datos. El QDevice debe dar su voto al mismo sitio. Por defecto, el QDevice elige la partición que contiene el ID de nodo más bajo.
BUENA PRÁCTICA: crea el clúster de Proxmox VE en un nodo del sitio A e incorpora los demás nodos del sitio A antes de incorporar los nodos del sitio B, de modo que el sitio A tenga los ID de nodo más bajos. Si el almacenamiento principal se traslada al sitio B durante un periodo prolongado, actualiza la configuración de QDevice tie_breaker con un ID de nodo del sitio B.
Si en cambio QDevice favoreciera el sitio B, los nodos del sitio A se autoaislarían y HA reiniciaría las VMs en los nodos del sitio B que no pueden acceder al almacenamiento activo del sitio A.
Comportamiento de HA y ubicación de las máquinas virtuales
-
Proxmox VE HA suele detectar un nodo que ha fallado y recuperar sus VMs en unos dos minutos, incluido un tiempo de espera de aislamiento watchdog de 60 segundos. Durante un fallo del sitio, la conmutación por error de sincronización activa de SnapMirror y la recuperación de Proxmox VE HA se ejecutan en paralelo.
-
Utiliza las reglas de afinidad de nodos HA con prioridades de nodo para colocar las VM en los nodos del mismo sitio que su almacenamiento primario y permitir que conmuten por error al otro sitio.
-
Tras una conmutación por error del sitio, configura la propiedad HA
failbacken0para las máquinas virtuales afectadas hasta que devuelvas el almacenamiento a su sitio original. De lo contrario, HA volverá a migrar las máquinas virtuales a los nodos del sitio A en cuanto vuelvan, mientras el almacenamiento activo siga en el sitio B. -
Asegúrate de que los tiempos de espera del disco del sistema operativo invitado sean más largos que el tiempo previsto para la conmutación por error, de modo que los sistemas invitados no notifiquen errores de E/S durante una conmutación por error del almacenamiento.
Integración con Storage Manager para Proxmox
Storage Manager for Proxmox (SMP) ofrece a los administradores de Proxmox VE una interfaz única para aprovisionar almacenamiento compartido de ONTAP y para hacer copias de seguridad, restaurar y clonar máquinas virtuales mediante snapshots de ONTAP y la tecnología FlexClone. SMP se conecta al clúster de Proxmox VE y a ONTAP a través de sus APIs, por lo que no necesita agentes en los nodos de Proxmox VE.
SMP y SnapMirror active sync te protegen contra distintos tipos de fallos. SnapMirror active sync mantiene las VMs en ejecución ante un fallo del almacenamiento o del sitio, pero replica cada escritura de forma síncrona, incluida una eliminación accidental, una actualización fallida del sistema invitado o datos cifrados por ransomware. Las snapshots de SMP te dan copias de momento específico para recuperarte de esos fallos lógicos. Juntas, te ofrecen disponibilidad continua y una rápida recuperación operativa desde el mismo almacenamiento ONTAP.
| Capa de protección | Protege contra | Punto de recuperación | Gestionado con |
|---|---|---|---|
Sincronización activa de SnapMirror |
Fallo del sistema de almacenamiento y fallo del sitio |
Sin pérdida de datos |
ONTAP |
Copias de seguridad SMP (instantáneas de ONTAP) |
Borrado accidental, corrupción de datos, actualizaciones fallidas y ransomware |
Última copia de seguridad programada o bajo demanda |
SMP |
SnapMirror distribución asíncrona o Proxmox Backup Server |
Pérdida de ambos sitios y retención a largo plazo |
Última replicación o copia de seguridad |
ONTAP o Proxmox Backup Server |
Copia de seguridad y recuperación
SMP crea copias de seguridad coherentes ante fallos o consistentes con los archivos como snapshots de ONTAP de los volúmenes de almacenamiento, bajo demanda o según una política, y restaura VM individuales, almacenamiento o grupos de recursos:
-
Utiliza grupos de recursos y políticas de backup para aplicar la misma programación y la misma retención a las máquinas virtuales de un inquilino o de una aplicación.
-
Utiliza copias de seguridad con coherencia de archivos para las máquinas virtuales que ejecutan el agente invitado de QEMU, para que los sistemas de archivos invitados queden en inactividad antes de que ONTAP cree la instantánea.
-
SMP gestiona el almacenamiento que está activo. Tras una conmutación por error de active sync de SnapMirror, ejecuta una detección en SMP para que asigne el almacenamiento al clúster B antes de realizar operaciones de copia de seguridad o restauración.
-
Si necesitas una tercera copia fuera de esos dos sitios o si quieres un periodo de retención más largo, añade una relación de distribución asíncrona de SnapMirror desde los volúmenes protegidos o usa Proxmox Backup Server.
-
Las instantáneas a prueba de manipulaciones no son compatibles con la sincronización activa de SnapMirror, por lo que no debes activar el bloqueo de instantáneas en SMP para los volúmenes protegidos.
Clonación de máquinas virtuales
SMP utiliza la tecnología ONTAP FlexClone para crear clones de VM con gestión eficiente del espacio para desarrollo, pruebas y aprovisionamiento rápido. Los clones que creas en el almacenamiento protegido consumen ancho de banda de replicación y capacidad en ambos sitios. Excluye de la protección de SnapMirror active sync los clones y el almacenamiento de prueba que no necesiten continuidad del negocio.
Ubicación de la SMP
-
Ejecuta la máquina virtual SMP como recurso de alta disponibilidad (HA) en un almacenamiento compartido protegido por sincronización activa de SnapMirror, de modo que SMP siga estando disponible tras un fallo del almacenamiento o del sitio.
-
Registra el clúster de Proxmox VE y los dos clústeres de ONTAP en SMP, de modo que SMP pueda acceder al almacenamiento activo en cualquiera de los dos sitios.
Almacenamiento compartido de NFS con SnapMirror active sync para NAS
A partir de ONTAP 9.19.1, la sincronización activa de SnapMirror protege las cargas de trabajo NAS. Las siguientes consideraciones se aplican únicamente al almacenamiento compartido de NFS. Para implementar la solución con almacenamiento de NFS, sigue las instrucciones de "Flujo de trabajo de configuración de NAS".
Protección a nivel de SVM e identidad de red
-
SnapMirror active sync para NAS protege toda una máquina virtual de almacenamiento (SVM). Puedes proteger todos los volúmenes de la SVM o excluir los volúmenes seleccionados. Solo se admiten volúmenes FlexVol, y la SVM no puede contener LUN.
-
La SVM secundaria permanece inactiva, con sus LIF desactivadas, hasta que se produce una conmutación por error. ONTAP replica la configuración de la SVM, incluidas las direcciones IP de las LIF, las políticas de exportación y la configuración de NFS, de modo que la SVM secundaria presenta el mismo punto final de NFS tras una conmutación por error.
-
La conmutación por error no provoca interrupciones en NFSv3 y versiones posteriores.
-
SnapMirror active sync para NAS es activo/pasivo, por lo que las VMs en los nodos del sitio B leen y escriben a través de la red entre sitios en la SVM principal. Para cargas de trabajo activas en ambos sitios, utiliza dos SVM con direcciones de replicación opuestas, una principal en cada sitio, y alinea la regla de afinidad de nodo de cada VM con el sitio de su SVM principal.
-
SnapMirror active sync para NAS es compatible con clústeres de dos nodos AFF A-Series y C-Series.
Configuración del cliente de NFS
Utiliza NFSv3 o NFSv4.1 para el almacenamiento NFS. Mantén el comportamiento predeterminado de montaje hard y no añadas la opción de montaje soft, para que las operaciones de E/S de NFS se reintenten en lugar de fallar durante una conmutación por error.
Utiliza varias conexiones TCP al almacenamiento para obtener un mejor rendimiento y tolerancia a fallos. Utiliza nConnect o session trunking, no ambos:
-
nConnect. Abre varias conexiones TCP a una sola dirección de LIF de NFS, por ejemplo
nconnect=4. nConnect funciona con NFSv3 y NFSv4.1 y con una sola dirección de LIF de VIP, por lo que es la opción recomendada para SnapMirror active sync para NAS, incluidas las redes de capa 3. -
Agrupación de sesiones. Agrupa varias LIF de datos en una sola sesión NFSv4.1, por ejemplo
vers=4.1,trunkdiscovery,max_connect=16. La agrupación de sesiones requiere NFSv4.1 o una versión posterior. Úsala solo cuando la SVM protegida tenga varias LIF de datos a las que los clientes puedan acceder desde ambos sitios, como en una red de capa 2 extendida. Para obtener más información, consulta "Trunking de NFS".
Para conocer los comandos de la opción mount y los pasos de verificación, consulta "Configurar el almacenamiento NFS para Proxmox VE".
Aprovisionamiento de almacenamiento de NFS con SMP
SMP aprovisiona un volumen ONTAP, crea o selecciona una política de exportación y monta el volumen como almacenamiento compartido NFS en los nodos de Proxmox VE que selecciones. Para el almacenamiento en una SVM protegida:
-
Aprovisiona el volumen en la SVM principal y selecciona la LIF de NFS, o la LIF VIP en una red de capa 3, como LIF preferida. La SVM secundaria usa la misma dirección después de una conmutación por error, por lo que la definición de almacenamiento sigue siendo válida.
-
Monta el almacenamiento en todos los nodos de Proxmox VE de ambas ubicaciones, de modo que la alta disponibilidad (HA) pueda reiniciar las máquinas virtuales en cualquier nodo.
-
Asegúrate de que la política de exportación permita el acceso a los nodos de Proxmox VE en ambas ubicaciones. ONTAP replica la política de exportación a la SVM secundaria.
-
Tras el aprovisionamiento, comprueba que el volumen esté incluido en la protección de SnapMirror active sync.
Redes de capa 3 con LIF VIP y BGP
SnapMirror active sync para NAS requiere la misma dirección IP en las SVM primaria y secundaria. Cuando la VLAN de NFS se extiende entre sitios, la dirección IP del LIF se mueve con la SVM. Cuando los sitios están conectados mediante una red enrutada de capa 3, la subred de un LIF del sitio A no existe en el sitio B.

|
En el momento de la publicación, NetApp no ha documentado las LIF VIP con BGP como una configuración válida para la sincronización activa de SnapMirror para NAS. Antes de planificar un diseño de capa 3, confirma la compatibilidad actual con NetApp. De lo contrario, extiende la VLAN de NFS entre los sitios. Las configuraciones IP de MetroCluster admiten LIF VIP con BGP. |
Las LIF de IP virtual (VIP) de ONTAP resuelven este problema. Una LIF VIP no pertenece a ninguna subred. ONTAP anuncia la dirección VIP a los routers homólogos como una ruta de host /32 mediante Border Gateway Protocol (BGP), de modo que la dirección puede moverse entre sitios sin una VLAN extendida.
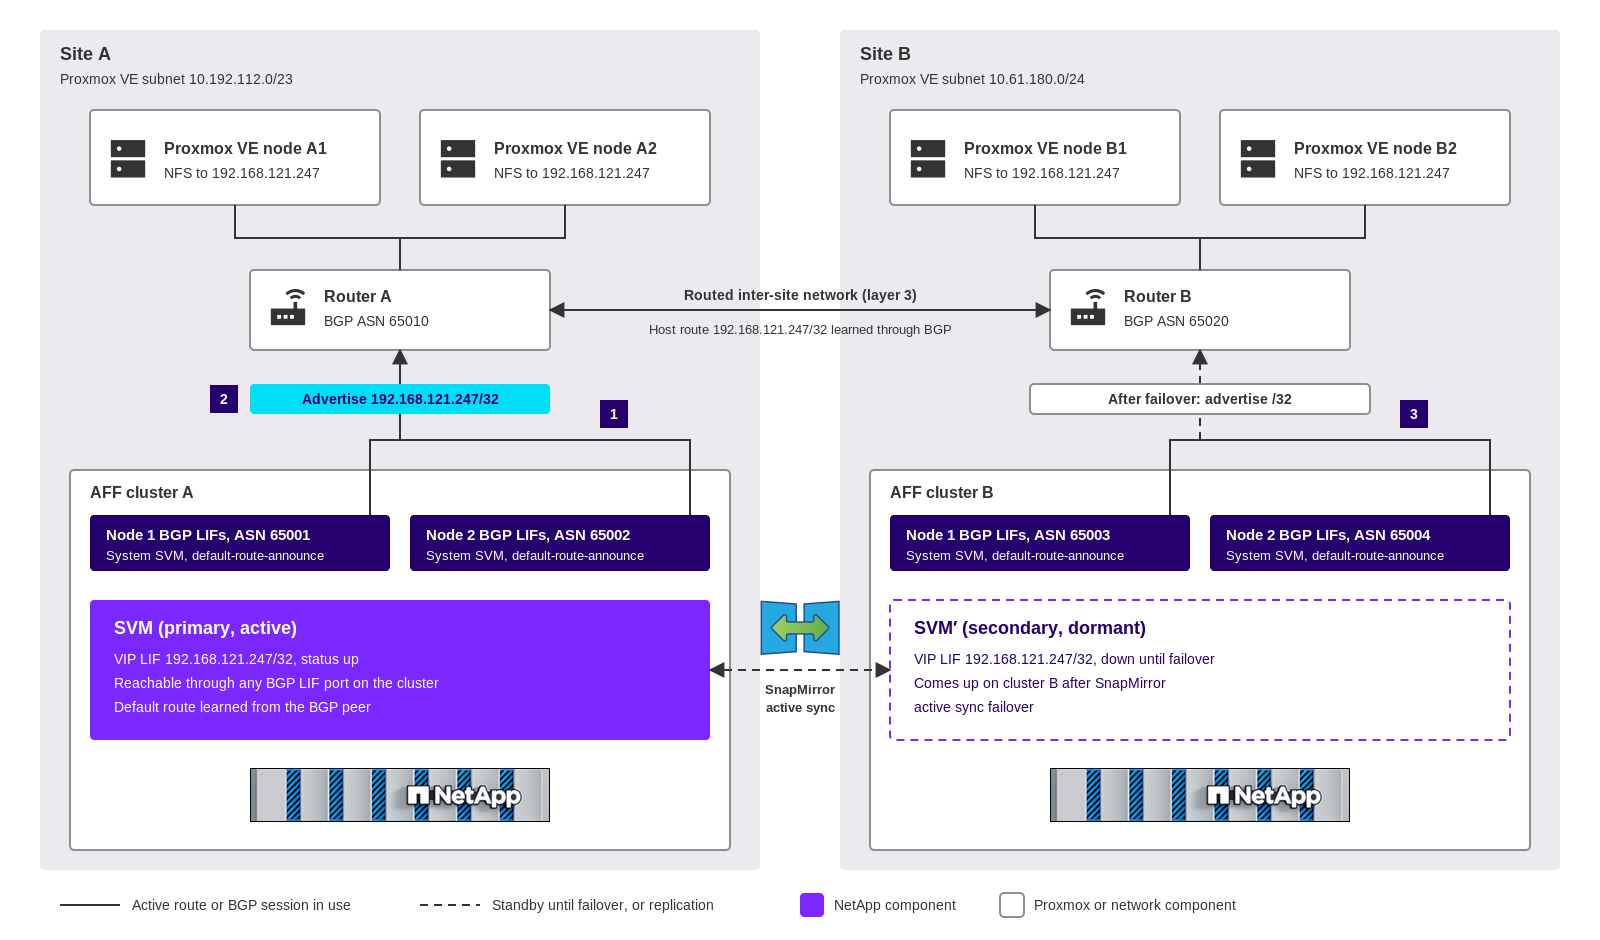
-
Cada nodo de ambos emplazamientos cuenta con LIF de BGP en el SVM del sistema que establecen relaciones de par con los routers de su emplazamiento. Las LIF de BGP son específicas de cada nodo y no se replican, por lo que debes configurarlas en ambos clústeres.
-
El SVM principal aloja el LIF VIP de NFS. El clúster A anuncia la ruta de host /32, y los nodos de Proxmox VE de ambos emplazamientos acceden al almacenamiento a través de la red enrutada.
-
Tras una conmutación por error de SnapMirror active sync, la LIF VIP se activa en el SVM secundario, el clúster B anuncia la ruta del host y los routers convergen en el sitio B.
Cuando configuras BGP en ONTAP por primera vez, te ayuda saber a qué SVM pertenece cada LIF. Los LIF de BGP pertenecen a la SVM del sistema del IPspace, no a las SVM de datos. Un conjunto de LIF de BGP en cada clúster da servicio a los LIF VIP de cada SVM de datos de ese IPspace, así que no creas LIF de BGP para cada tenant. El siguiente diagrama muestra la disposición de los LIF y los puertos en un clúster, con LIF de BGP en puertos VLAN.
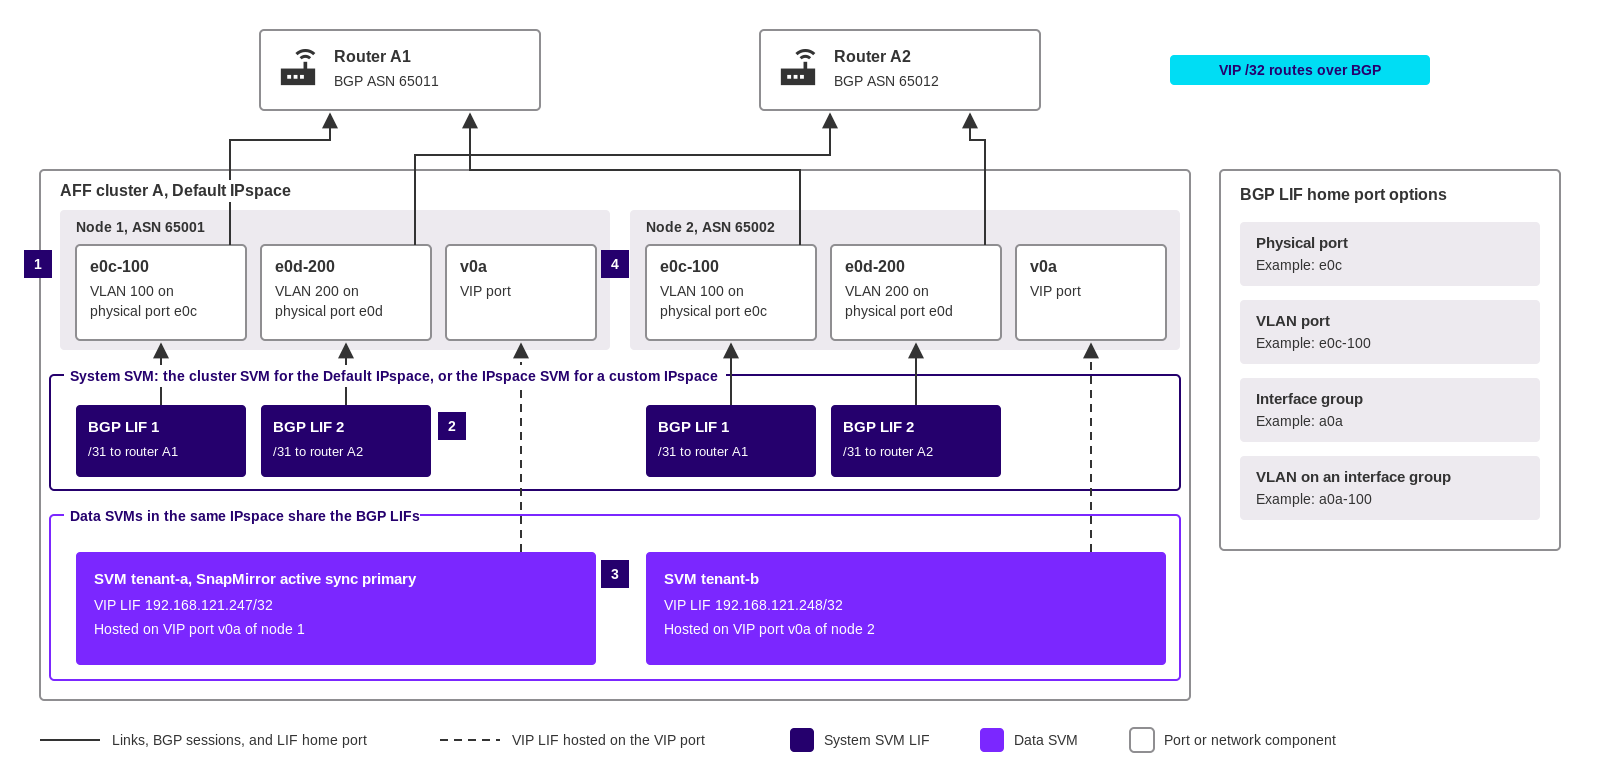
-
Cada nodo tiene dos puertos para BGP, en este ejemplo los puertos de VLAN
e0c-100ye0d-200. Cada puerto se conecta directamente a un router diferente. -
Cada nodo tiene dos LIF de BGP en la system SVM, una en cada puerto, con una subred /31 y un grupo de pares BGP con un router. Para el Default IPspace, la system SVM es la cluster SVM. Para un IPspace personalizado, es la SVM con el mismo nombre que el IPspace.
-
Las SVM de datos del mismo IPspace alojan LIF VIP y no necesitan LIF BGP propias. Los grupos de pares BGP anuncian las rutas VIP para todas las SVM del IPspace.
-
ONTAP crea un puerto VIP, por ejemplo
v0a, en cada nodo cuando creas el primer grupo de pares BGP. Las LIF VIP se alojan en el puerto VIP y son accesibles a través de cualquier puerto del nodo que aloja una LIF BGP en el IPspace.
El puerto de origen de un LIF de BGP puede ser un puerto físico, un puerto de VLAN, un grupo de interfaces o una VLAN en un grupo de interfaces. No es obligatorio disponer de un grupo de interfaces. NetApp informe técnico TR-4949 recomienda dos LIF de BGP en dos puertos distintos para cada IPspace, cada uno conectado directamente a un router de primer salto diferente.
Ten en cuenta las siguientes directrices:
-
Los LIF de BGP no se someten a conmutación por error. La redundancia proviene de dos LIF de BGP por nodo, cada uno emparejado con un router diferente. Si un nodo pierde todas sus sesiones de BGP para una SVM, ONTAP mueve el LIF VIP a otro nodo que tenga una sesión de BGP activa para esa SVM.
-
Utiliza BGP externo (eBGP) con un número de sistema autónomo (ASN) privado único para cada nodo ONTAP y cada router.
-
Utiliza una subred /31 (máscara de red 255.255.255.254) para cada LIF de BGP y su enrutador. Asigna la dirección impar al LIF de BGP y la dirección par al enrutador.
-
ONTAP no procesa las rutas procedentes de los routers. Configura los routers para que acepten rutas de host /32 procedentes de ONTAP y no envíen actualizaciones de rutas al clúster.
-
Los nodos de Proxmox VE no deben compartir una subred con la dirección VIP. Debe haber un router redundante de capa 3, por ejemplo con VRRP o HSRP, en la ruta entre los nodos y el almacenamiento.
-
Configura los grupos de pares BGP con
-use-peer-as-next-hop truepara que cada clúster aprenda su ruta predeterminada de sus routers locales. Las rutas que apuntan a una puerta de enlace del sitio A no son válidas en el sitio B tras una conmutación por error. -
Activa el enrutamiento multivía para que el tráfico VIP saliente utilice todos los puertos LIF de BGP disponibles.
-
Reduce el tiempo de retención de BGP respecto al valor predeterminado de 180 segundos. TR-4949 recomienda un tiempo de retención de 3 segundos. Un router retira la ruta de un clúster que ha fallado únicamente cuando expira el temporizador de retención y, durante un fallo del sistema de almacenamiento, el router del sitio A permanece en línea.