


Utilisez la latence de la charge de travail pour identifier les problèmes de performance dans Active IQ Unified Manager
 Suggérer des modifications

 PDF

La latence du workload (temps de réponse) correspond au temps nécessaire à un volume d'un cluster pour répondre aux requêtes d'E/S des applications clientes. Unified Manager utilise cette latence pour détecter les événements de performance et vous alerter.
Une latence élevée signifie que les requêtes des applications vers un volume sur un cluster prennent plus de temps que d'habitude. Cette latence élevée peut provenir du cluster lui-même, en raison d'une contention sur un ou plusieurs de ses composants. Elle peut également être causée par des problèmes externes au cluster, tels que des goulots d'étranglement réseau, des problèmes avec le client hébergeant les applications ou des problèmes avec les applications elles-mêmes.

|
Unified Manager surveille uniquement l’activité du workload sur le cluster. Il ne surveille pas les applications, les clients ni les chemins d’accès entre les applications et le cluster. |
Les opérations sur le cluster, telles que l’exécution de sauvegardes ou de la déduplication, qui augmentent leur demande en composants du cluster partagés par d’autres workloads peuvent également contribuer à une latence élevée. Si la latence réelle dépasse le seuil de performance dynamique de la plage attendue (prévision de latence), Unified Manager analyse l’événement afin de déterminer s’il s’agit d’un événement de performance que vous devrez peut-être résoudre. La latence est mesurée en millisecondes par opération (ms/op).
Sur le graphique « Latence totale » de la page « Analyse du workload », vous pouvez consulter une analyse des statistiques de latence afin de voir comment l'activité des processus individuels, tels que les requêtes de lecture et d'écriture, se compare aux statistiques de latence globales. Cette comparaison vous aide à déterminer quelles opérations présentent l'activité la plus élevée ou si certaines opérations présentent une activité anormale qui a un impact sur la latence d'un volume. Lors de l'analyse des événements de performance, vous pouvez utiliser les statistiques de latence pour déterminer si un événement a été causé par un problème sur le cluster. Vous pouvez également identifier les activités de workload spécifiques ou les composants du cluster impliqués dans l'événement.
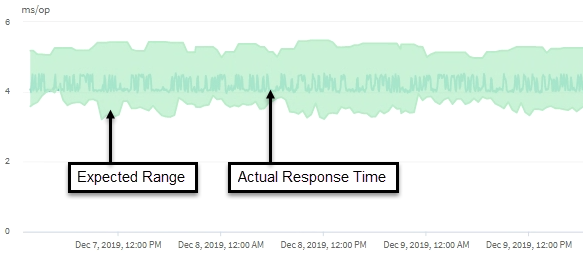
Cet exemple illustre le graphique de latence. Le temps de réponse réel (latence) est représenté par une ligne bleue et la prévision de latence (plage attendue) par une ligne verte.
|
|
Des interruptions peuvent apparaître sur la ligne bleue si Unified Manager n'a pas pu collecter les données. Cela peut se produire si le cluster ou le volume était inaccessible, si Unified Manager était arrêté pendant cette période ou si la collecte prenait plus de temps que la période de collecte de 5 minutes. |