


Créez un groupe de ressources dans NetApp Disaster Recovery


 Suggérer des modifications

 PDF

Après avoir ajouté des ressources à des sites dans NetApp Disaster Recovery, vous pouvez créer des groupes de ressources pour organiser les machines virtuelles, les banques de données ou les clusters Kubernetes en une seule unité. Les groupes de ressources vous permettent d’organiser les ressources dépendantes en groupes logiques répondant à vos besoins. Par exemple, vous pouvez regrouper les machines virtuelles d’une application ou les applications qui partagent des niveaux similaires. Les groupes de ressources peuvent également inclure des ordres de démarrage différé qui s’exécutent pendant la reprise afin de garantir que les ressources démarrent dans le bon ordre.
Rôle requis de la NetApp Console Le rôle de super administrateur, d’administrateur de reprise après sinistre ou d’administrateur d’application de reprise après sinistre est requis pour effectuer cette tâche. "En savoir plus sur les rôles et les autorisations des utilisateurs dans NetApp Disaster Recovery". "En savoir plus sur les rôles d'accès à la NetApp Console pour tous les services".
À propos de cette tâche
Vous pouvez regrouper les machines virtuelles elles-mêmes ou les machines virtuelles dans des magasins de données.
Vous pouvez créer des groupes de ressources à l’aide des méthodes suivantes :
-
À partir de l'option Groupes de ressources
-
Lors de la création d'un plan de reprise après sinistre ou de réplication. Si vous avez de nombreuses machines virtuelles hébergées par un cluster vCenter source, il peut être plus simple de créer les groupes de ressources lors de la création du plan de réplication. Pour obtenir des instructions sur la création de groupes de ressources lors de la création d'un plan de réplication, consultez "Créer un plan de réplication".

|
Chaque groupe de ressources peut inclure une ou plusieurs machines virtuelles, banques de données ou clusters Kubernetes. Les machines virtuelles seront mises sous tension selon l'ordre dans lequel vous les incluez dans le plan de réplication. Vous pouvez modifier l'ordre en faisant glisser les machines virtuelles ou les banques de données vers le haut ou vers le bas de la liste du groupe de ressources. |
À propos des groupes de ressources
Les groupes de ressources vous permettent de combiner des machines virtuelles, des banques de données ou des applications Kubernetes en une seule unité.
Par exemple, une application de point de vente peut utiliser plusieurs machines virtuelles pour les bases de données, la logique métier et les vitrines. Vous pouvez gérer toutes ces machines virtuelles avec un seul groupe de ressources. Configurez des groupes de ressources pour appliquer les règles du plan de réplication pour l’ordre de démarrage des machines virtuelles, la connexion réseau et la récupération de toutes les machines virtuelles nécessaires à l’application.
Comment fonctionnent les groupes de ressources
Disaster Recovery protège les machines virtuelles en répliquant les volumes ONTAP et les LUN sous-jacents qui hébergent les machines virtuelles dans le groupe de ressources. Pour ce faire, le système interroge vCenter pour obtenir le nom de chaque datastore hébergeant des machines virtuelles dans un groupe de ressources. Disaster Recovery identifie ensuite le volume ONTAP source ou la LUN source qui héberge ce datastore. Toute la protection est effectuée au niveau du volume ONTAP à l'aide de la réplication SnapMirror.
Si les VM du groupe de ressources sont hébergées sur différents datastores, la reprise après sinistre utilise l’une des méthodes suivantes pour créer un instantané cohérent des données des volumes ONTAP ou des LUN.
| Emplacement relatif des volumes FlexVol | Processus de réplication d'instantanés |
|---|---|
Plusieurs magasins de données - Volumes FlexVol dans le même SVM |
|
Plusieurs magasins de données - Volumes FlexVol dans plusieurs SVM |
|
Meilleures pratiques pour les groupes de ressources
Lorsque vous créez des groupes de ressources, tenez compte des scénarios suivants :
-
Avant d’ajouter des datastores ou des namespace à des groupes de ressources, lancez une découverte manuelle ou attendez qu’une découverte planifiée s’exécute. Cela garantit que les VM sont détectées et répertoriées dans le groupe de ressources. Si vous ne lancez pas de découverte manuelle, les ressources risquent de ne pas être répertoriées dans le groupe de ressources.
-
Assurez-vous qu'au moins une ressource (VM ou namespace) est présente dans la banque de données. S'il n'y a aucune ressource dans la banque de données, Disaster Recovery ne détecte pas la banque de données.
-
Un seul magasin de données ne doit pas héberger de machines virtuelles protégées par plusieurs plans de réplication.
-
N’hébergez pas de ressources protégées et non protégées sur le même datastore. Si des ressources protégées et non protégées sont hébergées sur le même datastore, les problèmes suivants pourraient survenir :
-
Étant donné que Disaster Recovery utilise SnapMirror et que le système réplique des volumes ONTAP entiers, la capacité utilisée de ce volume est prise en compte pour le calcul des licences. Dans ce cas, l’espace du volume consommé par les VM protégées et non protégées serait inclus dans ce calcul.
-
Si le groupe de ressources et ses entités associées doivent basculer vers le site de reprise d’activité après sinistre, toutes les ressources non protégées (VM ou namespace ne faisant pas partie du groupe de ressources, mais hébergés sur le volume ONTAP) n’existeront plus sur le site source du fait du processus de basculement, ce qui entraînera l’échec des VM non protégées sur le site source. De plus, Disaster Recovery ne démarrera pas ces ressources non protégées sur le site de basculement.
-
-
Pour protéger une ressource, elle doit être incluse dans un groupe de ressources.
BONNE PRATIQUE : Organisez vos machines virtuelles avant de déployer NetApp Disaster Recovery afin de minimiser la prolifération des datastores. Placez les machines virtuelles nécessitant une protection sur un sous-ensemble de datastores et celles qui ne seront pas protégées sur un autre sous-ensemble de datastores. Assurez-vous que les machines virtuelles d’un même datastore ne soient pas protégées par différents plans de réplication.
-
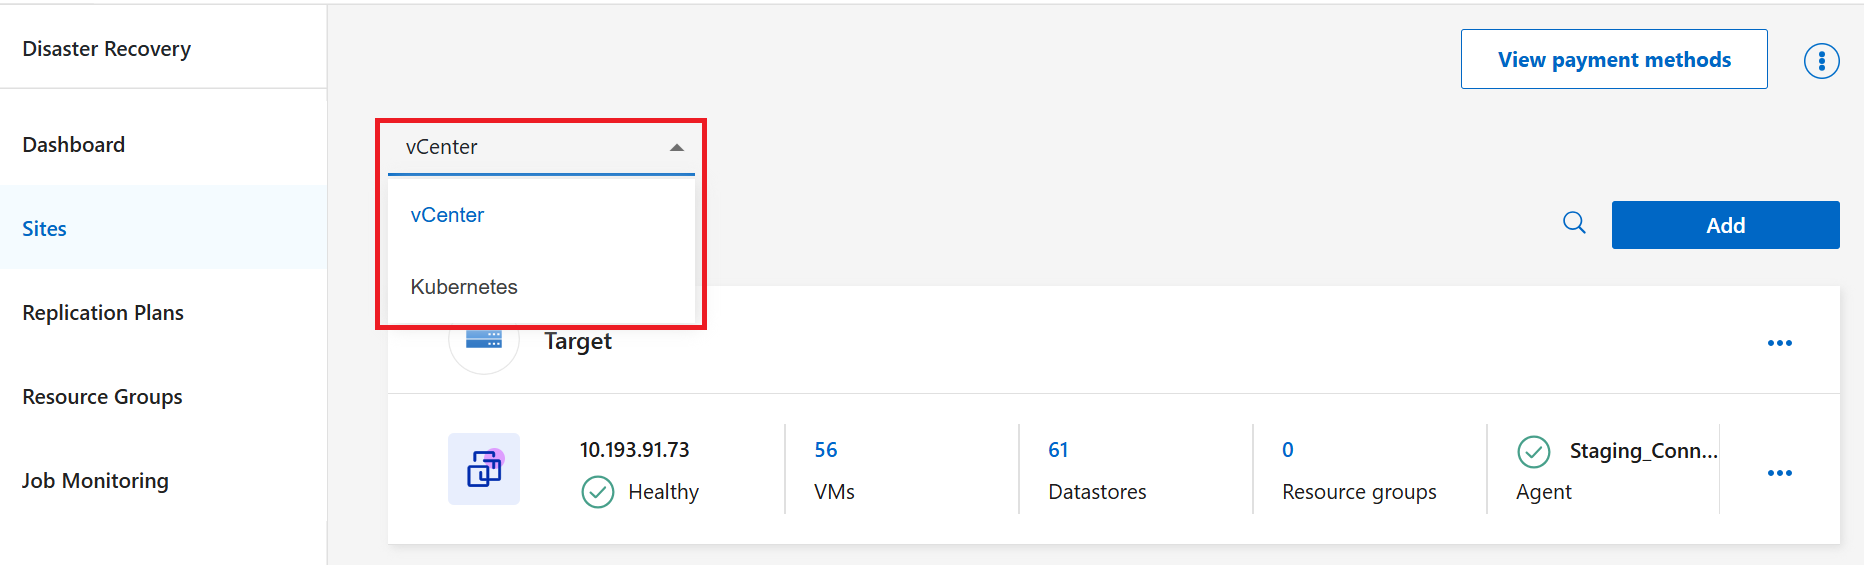
Dans la section Disaster Recovery, sélectionnez Groupes de ressources dans la barre latérale.
-
Dans le menu déroulant, filtrez par VMware.
-
Dans le menu Disaster Recovery, sélectionnez Groupes de ressources.
-
Sélectionnez Ajouter.
-
Saisissez un nom pour le groupe de ressources.
-
Sélectionnez le cluster vCenter source où se trouvent les machines virtuelles.
-
Sélectionnez Machines virtuelles ou Magasins de données selon la manière dont vous souhaitez effectuer la recherche.
-
Sélectionnez l’onglet Ajouter des groupes de ressources. Le système répertorie tous les magasins de données ou machines virtuelles du cluster vCenter sélectionné. Si vous avez sélectionné Datastores, le système répertorie tous les magasins de données du cluster vCenter sélectionné. Si vous avez sélectionné Machines virtuelles, le système répertorie toutes les machines virtuelles du cluster vCenter sélectionné.
-
Sur le côté gauche de la page Ajouter des groupes de ressources, sélectionnez les machines virtuelles que vous souhaitez protéger.


-
Vous pouvez également modifier l’ordre des machines virtuelles sur la droite en faisant glisser chaque machine virtuelle vers le haut ou vers le bas de la liste. Les machines virtuelles s'allumeront en fonction de la séquence dans laquelle vous les incluez.
-
Sélectionnez Ajouter.
-
Dans la section Disaster Recovery, sélectionnez Groupes de ressources dans la barre latérale.
-
Dans le menu déroulant, filtrez par Kubernetes.
-
Sélectionnez Ajouter.
-
Saisissez un nom pour le groupe de ressources et sélectionnez le cluster Kubernetes dans le menu déroulant.
-
Sélectionnez les espaces de noms à ajouter au groupe de ressources.
-
Classifiez les types de ressources. Par défaut, la sélection est « Tout inclure », ce qui désigne plusieurs types de ressources.
-
Vous pouvez éventuellement inclure des sélecteurs d'étiquettes.

-
Vous pouvez également sélectionner + Ressources à portée de cluster pour ajouter des ressources qui ne sont pas limitées à un espace de noms. Si vous choisissez cette option, sélectionnez le Groupe, la Version, le Type et ajoutez éventuellement des sélecteurs d'étiquettes. Sélectionnez Ajouter une ressource.

-
Sélectionnez Ajouter.