


Découvrez la continuité d’activité de Proxmox VE avec SnapMirror active sync

 Suggérer des modifications

 PDF

Les entreprises qui exécutent des machines virtuelles (VMs) stratégiques sur Proxmox Virtual Environment (VE), ainsi que les fournisseurs de services qui hébergent les VMs de leurs clients sur Proxmox VE, ont besoin que ces VMs restent opérationnelles lorsqu'un système de stockage ou un centre de données entier devient hors ligne. ONTAP SnapMirror active sync réplique de manière synchrone le stockage partagé d'un cluster Proxmox VE étendu sur deux sites et bascule automatiquement le stockage vers le site survivant. Vous bénéficiez d'un objectif de point de récupération (RPO) nul, d'une reprise automatisée sans scripts ni runbooks, et du même stockage partagé sur les deux sites, de sorte que la haute disponibilité (HA) de Proxmox VE peut redémarrer les VMs sans aucune reconfiguration du stockage. Pour le stockage partagé NFS, la solution utilise SnapMirror active sync pour NAS.
Défis des clients
Il est difficile de mettre en place un système de stockage et de résilience des sites pour Proxmox VE en utilisant uniquement les outils natifs :
-
Perte de données après une panne de site. La réplication du stockage Proxmox VE et Proxmox Backup Server sont asynchrones. Les modifications effectuées depuis la dernière réplication ou sauvegarde sont perdues en cas de panne du site principal.
-
Reprise manuelle et lente. La reprise sur un site secondaire implique généralement la promotion des réplicas, le montage du stockage sous une adresse différente, la mise à jour
/etc/pve/storage.cfg, et le redémarrage des machines virtuelles. Chaque étape manuelle augmente l'interruption et le risque d'erreur lors d'une panne. -
Stockage étendu en concurrence avec les machines virtuelles pour les ressources hôte. Le stockage étendu hyperconvergé, tel que Ceph en mode étendu, s'exécute sur les nœuds Proxmox VE et conserve deux répliques de chaque objet sur chaque site. Le trafic de réplication, de récupération et de rééquilibrage consomme des ressources CPU, mémoire et réseau sur les mêmes nœuds qui exécutent les machines virtuelles.
-
Deux décisions de quorum qui doivent être concordantes. Toute architecture à deux sites nécessite un témoin dans un troisième domaine de défaillance, à la fois pour le cluster Proxmox VE et pour le stockage. Si, après une panne de liaison entre sites, le cluster et le stockage choisissent des sites survivants différents, les machines virtuelles redémarrent sur des nœuds qui ne peuvent pas accéder au stockage actif.
-
Une adresse de stockage fonctionnelle sur les deux sites. Après un basculement du stockage, les nœuds Proxmox VE doivent pouvoir accéder au stockage partagé à la même adresse. Cette adresse doit être accessible sur les deux sites, ce qui implique généralement un VLAN de couche 2 étendu entre les sites.
Défis des fournisseurs de services
Les fournisseurs de services qui développent des services cloud sur Proxmox VE sont confrontés aux mêmes défis, auxquels s'ajoutent les contrats de niveau de service (SLAs) des locataires :
-
Le système de stockage constitue un point de défaillance partagé. Proxmox VE HA protège les VM des locataires contre une panne de l’hôte, mais pas contre une panne du système de stockage qui héberge leurs disques. Une panne de stockage affecte tous les locataires de ce système.
-
Impossible de vendre une disponibilité supérieure. Sans réplication synchrone et basculement automatique du stockage, un fournisseur ne peut pas proposer un niveau de disponibilité premium avec zéro perte de données et des engagements de disponibilité renforcés.
-
Isolation des locataires pendant la reprise. Les tests de reprise, de maintenance et de reprise après sinistre ne doivent affecter que les locataires concernés, et non l'ensemble de la plateforme.
Défis d'entreprise
Les entreprises qui migrent leurs charges de travail critiques d'autres hyperviseurs vers Proxmox VE s'attendent à conserver la même résilience du site qu'auparavant, notamment une absence totale de perte de données pour les bases de données et les applications métier, ainsi qu'une reprise sans procédure manuelle. Répondre à cette exigence avec les seuls outils natifs de Proxmox VE nécessite un effort considérable en matière de conception, de script et d'exploitation.
Présentation de la solution
La solution combine un cluster Proxmox VE stretch avec la synchronisation active SnapMirror sur des systèmes NetApp AFF sur deux sites :
-
RPO zéro. ONTAP réplique chaque écriture sur le stockage partagé de manière synchrone du cluster principal du site A vers le cluster secondaire du site B.
-
Même stockage partagé sur les deux sites. Après un basculement, le cluster secondaire présente le même stockage à Proxmox VE, de sorte que les définitions de stockage dans
/etc/pve/storage.cfgrestent valides. -
Basculement automatique. Un médiateur fait office de témoin en dehors des deux sites. Vous pouvez installer ONTAP Mediator sur un troisième site, ou utiliser ONTAP Cloud Mediator, un service hébergé dans NetApp Console. En cas de défaillance du stockage principal ou du site principal, ONTAP bascule vers le site B sans intervention manuelle.
-
Contrôle granulaire. Vous choisissez les charges de travail à protéger, et vous pouvez faire basculer les charges de travail individuellement, par exemple pour déplacer un locataire ou une application pour la maintenance du site.
-
Utilisation de la copie secondaire. Vous pouvez cloner la copie secondaire à des fins de développement, de test ou de test de reprise après sinistre sans affecter la réplication.
Comment la solution relève les défis
| Défi | Comment la solution vous aide | Ce que vous prévoyez encore |
|---|---|---|
Perte de données et récupération manuelle |
La réplication synchrone garantit un RPO nul. ONTAP bascule automatiquement, et le SVM secondaire présente la même adresse NFS, de sorte que |
Proxmox VE HA redémarre toujours les machines virtuelles depuis un site défaillant. |
Stockage étendu sur les hôtes |
La réplication s’exécute sur les contrôleurs AFF, et non sur les nœuds Proxmox VE. Le processeur hôte, la mémoire et le réseau restent donc disponibles pour les VM. ONTAP conserve une copie sur chaque site, et l’optimisation du stockage s’applique aux deux copies. |
Comme toute réplication synchrone, la solution nécessite une seconde copie complète sur le site B, et la réplication augmente la charge sur les deux clusters AFF. Dimensionnez les deux clusters en fonction de la charge de travail de réplication. |
Deux décisions de quorum |
ONTAP Mediator, ou ONTAP Cloud Mediator en tant que service dans la NetApp Console, est un témoin léger situé en dehors du chemin d'accès aux données. Cette solution montre comment aligner le QDevice corosync sur le cluster principal afin que les deux choisissent le même site. |
Un troisième emplacement est toujours requis pour le QDevice. Il est également requis pour ONTAP Mediator, mais pas pour ONTAP Cloud Mediator. Voir Options de Mediator. |
Une adresse de stockage sur les deux sites |
Le SVM secondaire prend en charge la même adresse LIF NFS, aucun remontage ni aucune reconfiguration du stockage n'est donc nécessaire. |
Le sous-réseau NFS doit être accessible sur les deux sites, généralement via un VLAN de couche 2 étendu. Consultez Réseaux de couche 3 avec LIF VIP et BGP pour connaître l'état de qualification des LIF VIP. |
Le schéma suivant illustre l'architecture de la solution avec stockage partagé NFS.
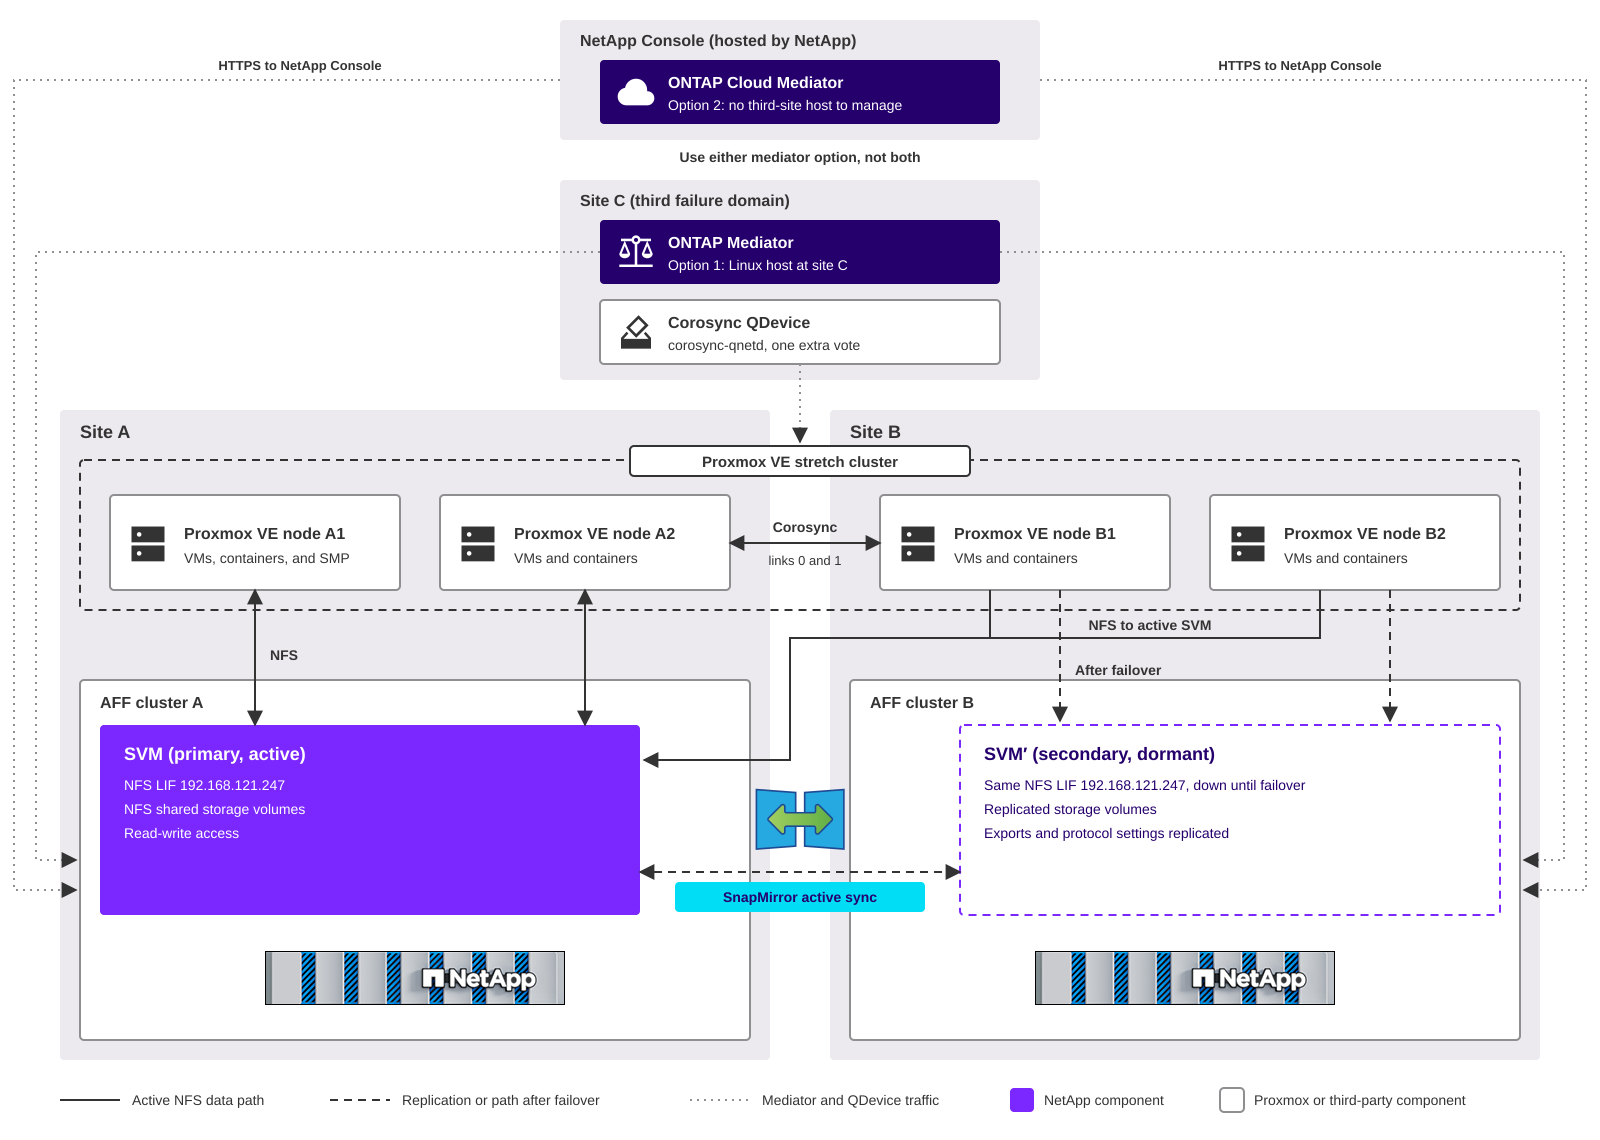
- Site A et site B
-
Chaque site dispose d'un cluster AFF à deux nœuds et de la moitié des nœuds Proxmox VE. Le cluster principal du site A fournit le stockage partagé à tous les nœuds Proxmox VE. Les nœuds du site B accèdent au cluster principal via le réseau intersites. Avec le stockage NFS, la SVM secondaire du site B reste en veille jusqu'à ce qu'un basculement se produise.
- Site C
-
Un troisième domaine de défaillance héberge le démon corosync QDevice (
corosync-qnetd) et, si vous choisissez l’option 1, ONTAP Mediator. Le QDevice fournit un vote supplémentaire afin que le cluster Proxmox VE conserve le quorum en cas de défaillance d’un site. - NetApp Console
-
Si vous choisissez l'option 2, ONTAP Cloud Mediator s'exécute en tant que service dans la NetApp Console, que NetApp héberge et gère. Les deux clusters AFF s'y connectent via HTTPS, vous n'avez donc pas besoin d'installer ni de gérer un hôte médiateur.
- Médiateur
-
ONTAP Mediator ou ONTAP Cloud Mediator aide ONTAP à déterminer quel cluster sert les données. Utilisez-en un, pas les deux. Pour une comparaison, consultez Options de Mediator.
- cluster étendu Proxmox VE
-
Tous les nœuds Proxmox VE appartiennent à un même cluster et partagent les mêmes définitions de stockage. La haute disponibilité (HA) de Proxmox VE redémarre les machines virtuelles d’un site défaillant sur les nœuds restants. Storage Manager for Proxmox (SMP) s’exécute en tant que machine virtuelle HA sur le cluster afin de provisionner le stockage partagé et de sauvegarder, restaurer et cloner les machines virtuelles.
Options de Mediator
SnapMirror active sync utilise un médiateur comme témoin passif. Lors d'une partition du réseau ou de la défaillance d'un cluster, ONTAP utilise le médiateur pour décider quelle copie continue à servir les E/S. Le médiateur n'est pas dans le chemin d'accès aux données et ne lance pas lui-même les basculements. Vous pouvez utiliser l'une des options suivantes, mais pas les deux en même temps.
| Considération | Option 1 : ONTAP Mediator | Option 2 : ONTAP Cloud Mediator |
|---|---|---|
Où il s'exécute |
Un hôte Linux que vous installez et gérez dans un troisième domaine de défaillance, tel que le site C, avec une infrastructure d'alimentation et de réseau indépendante. |
Un service cloud dans NetApp Console. NetApp l'héberge et le gère, vous n'avez donc pas besoin d'un hôte médiateur sur un troisième site. |
version ONTAP |
ONTAP 9.19.1 ou version ultérieure pour la synchronisation active SnapMirror pour NAS. |
ONTAP Cloud Mediator est disponible à partir de ONTAP 9.17.1. SnapMirror active sync pour NAS nécessite ONTAP 9.19.1 ou version ultérieure. |
Connectivité du cluster |
Les deux clusters se connectent à l'hôte médiateur. Le port de service par défaut est 31784. |
Les deux clusters se connectent en sortie via HTTPS à la NetApp Console, soit directement, soit par l'intermédiaire d'un proxy HTTP. La latence de ping recommandée vers la NetApp Console est inférieure à 200 ms. |
Configuration |
Installez le paquet sur l'hôte Linux, puis ajoutez-le aux clusters avec l'adresse de l'hôte et un utilisateur médiateur. |
Créez un compte de service NetApp Console avec le ONTAP Mediator Setup Role, puis ajoutez le médiateur aux clusters avec l’ID d’organisation, l’ID client et le secret client. |
Opérations |
Vous appliquez des correctifs au système hôte et le mettez à niveau, tout en le maintenant disponible. |
Aucun hôte à corriger ou à mettre à niveau. Vous dépendez de l'accès à Internet depuis les deux sites et de la disponibilité du service NetApp Console. |
Meilleure adaptation |
Environnements disposant d’un troisième site ou ne permettant pas aux clusters de stockage d’accéder à Internet. |
Environnements sans troisième site pour un médiateur, ou qui souhaitent éviter d’en exploiter un. |
Gardez les points suivants à l'esprit lors de votre choix :
-
Le QDevice nécessite toujours un troisième emplacement. ONTAP Cloud Mediator supprime l'hôte médiateur, et non l'hôte QDevice corosync. Le QDevice requiert un petit hôte Linux accessible par tous les nœuds Proxmox VE sur le port TCP 5403, et n'est pas soumis aux exigences de faible latence de corosync.
-
Les deux clusters doivent avoir accès à la NetApp Console. Si les clusters utilisent un proxy, installez le certificat d'autorité de certification racine du proxy sur les deux clusters. NetApp recommande d'utiliser un serveur proxy différent pour chaque cluster.
-
Prévoyez le même comportement en cas de défaillance avec l’une ou l’autre option. Lorsque le médiateur est indisponible, la réplication se poursuit sans perte de données, mais les basculements automatiques et planifiés ne sont pas possibles tant que le médiateur n’est pas de nouveau disponible. Avec ONTAP Cloud Mediator, cela inclut une perte de connectivité entre les clusters et la NetApp Console.

|
Les options de médiation de cette section s'appliquent à SnapMirror active sync. Pour MetroCluster, cette solution utilise ONTAP Mediator ou MetroCluster Tiebreaker. Avant de déployer, vérifiez que votre version d'ONTAP, l'option de médiation et la version de Proxmox VE sont répertoriées ensemble dans le "Outil de matrice d'interopérabilité (IMT) NetApp". |
Avantages pour les prestataires de services
-
Disponibilité des VM au-delà de la haute disponibilité de l’hôte. Les VM locataires continuent de fonctionner en cas de défaillance du système de stockage qui héberge leurs disques. ONTAP bascule vers le second cluster AFF, et les VM reprennent leurs E/S sur le même stockage partagé sans redémarrage.
-
Niveau de disponibilité premium. Vous pouvez proposer un service de VM à RPO zéro et à stockage résilient en option, en plus des niveaux standard sur un stockage non protégé dans les mêmes clusters.
-
Protection et basculement par locataire. Grâce à un stockage protégé distinct pour chaque locataire ou niveau de service, vous protégez, basculez et testez la reprise après sinistre pour chaque locataire indépendamment, sans affecter les autres locataires.
-
Meilleure utilisation des deux sites. Vous pouvez définir certaines charges de travail comme principales sur le site A et d'autres comme principales sur le site B, afin que les deux centres de données prennent en charge des charges de travail actives.
Avantages pour les entreprises
-
Aucune perte de données pour les VM stratégiques en cas de panne de stockage ou de site.
-
Récupération automatisée sans scripts, remontages du stockage ni modifications apportées à
/etc/pve/storage.cfg. -
Intégré à ONTAP, sans couche logicielle supplémentaire sur les nœuds Proxmox VE.
-
Opérations quotidiennes à partir d'une seule interface. Storage Manager pour Proxmox provisionne le stockage partagé protégé, et sauvegarde, restaure et clone les machines virtuelles grâce aux snapshots ONTAP et à la technologie FlexClone®.
Comment la solution réagit aux défaillances
ONTAP et Proxmox VE prennent des décisions de quorum indépendantes. Leur conception les aligne afin qu'ils choisissent tous deux le même site survivant.
| Événement | Comportement d’ONTAP | Comportement de Proxmox VE |
|---|---|---|
Le site A tombe en panne |
Le médiateur confirme la panne, et ONTAP bascule automatiquement le stockage partagé vers le cluster B. |
Les nœuds du site B et le QDevice maintiennent le quorum. HA isole les nœuds du site A et redémarre leurs machines virtuelles sur les nœuds du site B. Les machines virtuelles déjà présentes sur le site B reprennent les E/S après le basculement du stockage. |
Le cluster AFF A tombe en panne, les nœuds Proxmox VE du site A restent opérationnels |
Le médiateur confirme que le cluster A est inaccessible, et ONTAP bascule automatiquement le stockage partagé vers le cluster B. |
Aucun changement de quorum ni redémarrage de VM. Les VM de tous les nœuds reprennent leurs E/S sur le même stockage partagé après le basculement du stockage, les nœuds du site A atteignant le cluster B via le réseau intersites. |
Un contrôleur AFF du site A tombe en panne |
Le contrôleur partenaire prend le relais lors d’une reprise locale de haute disponibilité. Aucun basculement de synchronisation active SnapMirror n’a lieu. |
Aucun impact. Les machines virtuelles interrompent brièvement les E/S pendant le basculement. |
Le site B tombe en panne |
Le cluster A continue de fournir des données. La réplication reprendra lorsque le site B sera de nouveau opérationnel. |
Les nœuds du site A et le QDevice maintiennent le quorum. HA redémarre les machines virtuelles du site B sur les nœuds du site A. |
Échec de la liaison inter-sites |
Le cluster A continue de servir des données. Aucun basculement n'a lieu. |
Le QDevice donne son vote à la partition du site A lorsque le départage est aligné sur le cluster principal. Les nœuds du site B perdent le quorum et s’isolent eux-mêmes, et la haute disponibilité redémarre leurs machines virtuelles sur le site A. |
Le site C tombe en panne ou les clusters perdent l’accès à la NetApp Console |
La réplication se poursuit sans aucune perte de données, mais les basculements automatiques et planifiés sont impossibles tant que le médiateur n'est pas disponible. Avec ONTAP Cloud Mediator, une panne du site C n'affecte que le QDevice. |
Le cluster maintient le quorum grâce aux votes des quatre nœuds. Aucune machine virtuelle n'est affectée. |
Un nœud Proxmox VE tombe en panne |
Aucun impact. |
HA redémarre les VMs de ce nœud sur d'autres nœuds, en privilégiant les nœuds du même site. |
Défaillance du système de stockage
Une panne du système de stockage est un cas que la haute disponibilité au niveau de l’hôte ne peut pas gérer à elle seule, et c’est le cas où SnapMirror active sync apporte le plus de valeur aux fournisseurs de services. Le schéma suivant montre l’état après la panne du cluster AFF A, tandis que tous les nœuds Proxmox VE restent en ligne, avec le stockage partagé NFS.
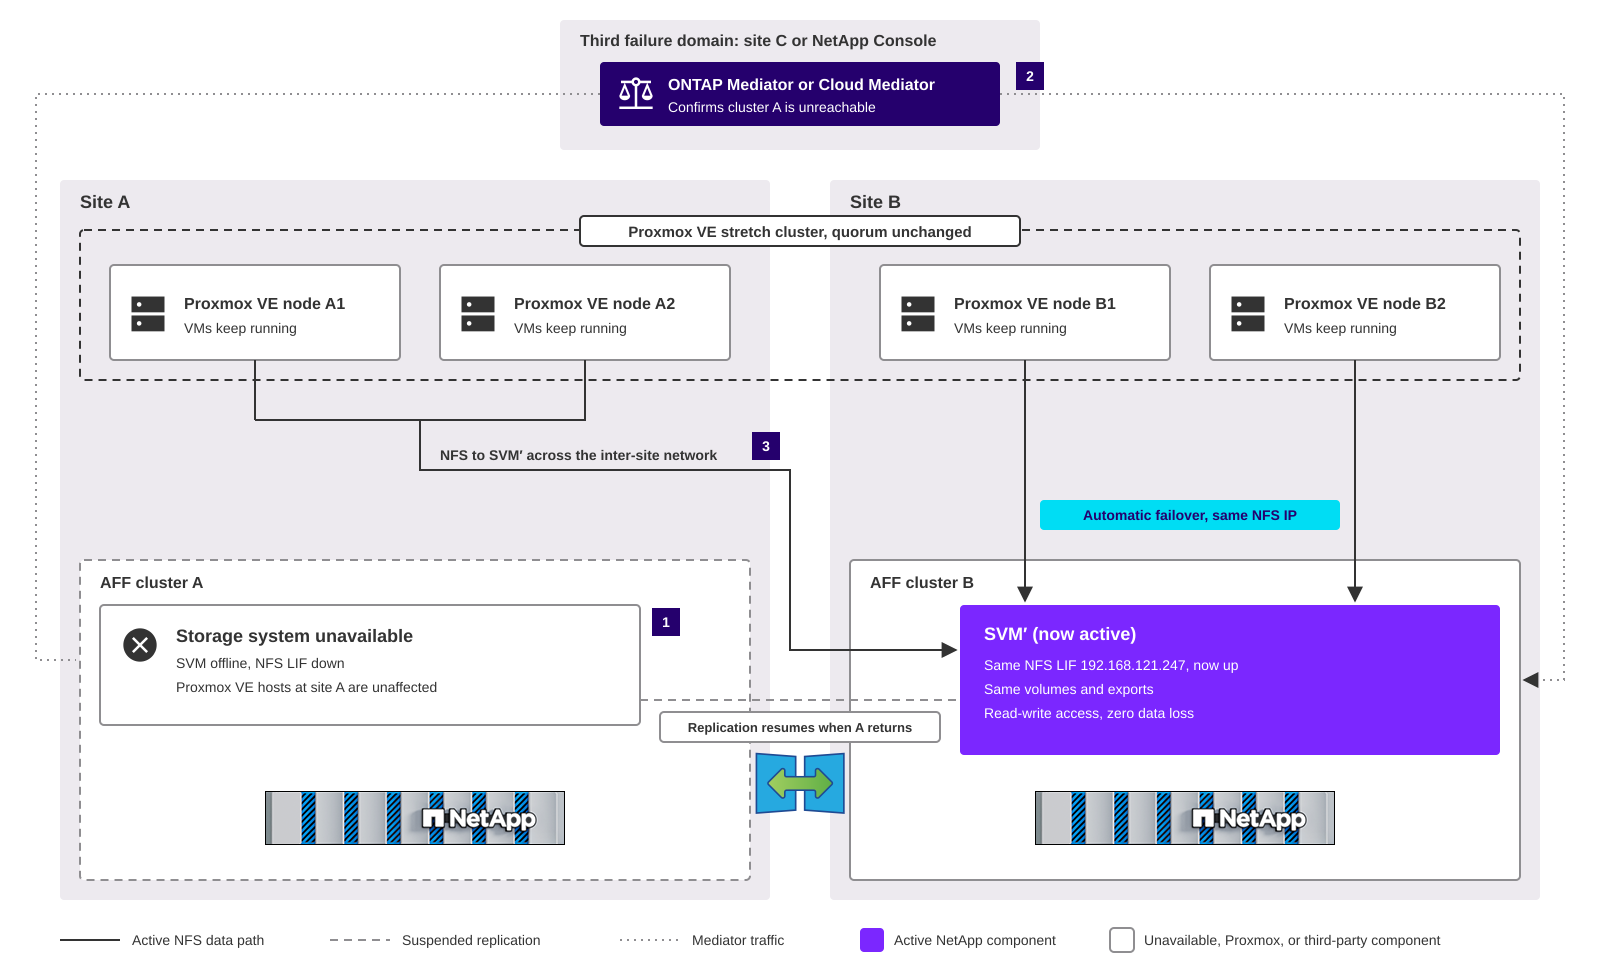
-
Le cluster AFF A devient indisponible. Les nœuds Proxmox VE du site A restent opérationnels, le cluster conserve donc son quorum et HA n’isole aucun nœud.
-
Le médiateur, ONTAP Mediator sur le site C ou ONTAP Cloud Mediator dans la NetApp Console, confirme que le cluster A est inaccessible, et ONTAP active la SVM secondaire sur le cluster B avec la même adresse LIF NFS, les mêmes volumes et les mêmes politiques d'exportation.
-
Tous les nœuds Proxmox VE reprennent leurs E/S sur le même stockage partagé. Les nœuds du site B accèdent localement au cluster B, tandis que ceux du site A y accèdent via le réseau inter-sites. Les machines virtuelles suspendent leurs E/S pendant le basculement et continuent de fonctionner sans redémarrage.
Lorsque le cluster A est de nouveau opérationnel, la réplication reprend. Planifiez le basculement de retour vers le cluster A pendant une fenêtre de maintenance afin que les machines virtuelles du site A puissent à nouveau accéder au stockage local.
Défaillance du site
Lors d'une panne de site, le système de stockage et les nœuds Proxmox VE de ce site deviennent indisponibles. ONTAP bascule le stockage partagé vers le cluster survivant, et Proxmox VE HA redémarre les machines virtuelles du site défaillant sur les nœuds survivants, comme indiqué dans le tableau.
Choisissez entre SnapMirror active sync et MetroCluster
NetApp MetroCluster configurations offrent également un RPO nul et une récupération automatique pour un cluster étendu Proxmox VE. Les deux solutions diffèrent par ce qu'elles protègent :
-
MetroCluster protège toutes les charges de travail. MetroCluster combine le clustering basé sur des baies avec la réplication synchrone. Il réplique les données de chaque agrégat mis en miroir, la mémoire non volatile (NVRAM) et la configuration de chaque SVM sur le site partenaire, de sorte que tout le stockage partagé du cluster est protégé sans configuration par charge de travail.
-
SnapMirror active sync protège un sous-ensemble de charges de travail. Vous choisissez les SVM ou les volumes à protéger, et vous pouvez effectuer le basculement de chacun indépendamment. Les charges de travail non protégées peuvent partager les mêmes clusters.
Les deux solutions conservent une copie complète des données protégées sur chaque site, nécessitent un témoin dans un troisième domaine de défaillance et augmentent la charge de réplication sur les contrôleurs de stockage. Elles diffèrent par l'étendue de la protection, la granularité et la conception du cluster.
|
|
Avant de déployer l'une ou l'autre solution, vérifiez que votre version d'ONTAP, votre configuration de synchronisation active MetroCluster ou SnapMirror, et votre version de Proxmox VE sont répertoriées ensemble dans le "Outil de matrice d'interopérabilité (IMT) NetApp". |
MetroCluster architecture avec Proxmox VE
Le schéma suivant illustre un cluster Proxmox VE étendu avec une configuration IP MetroCluster à quatre nœuds et un stockage partagé NFS.
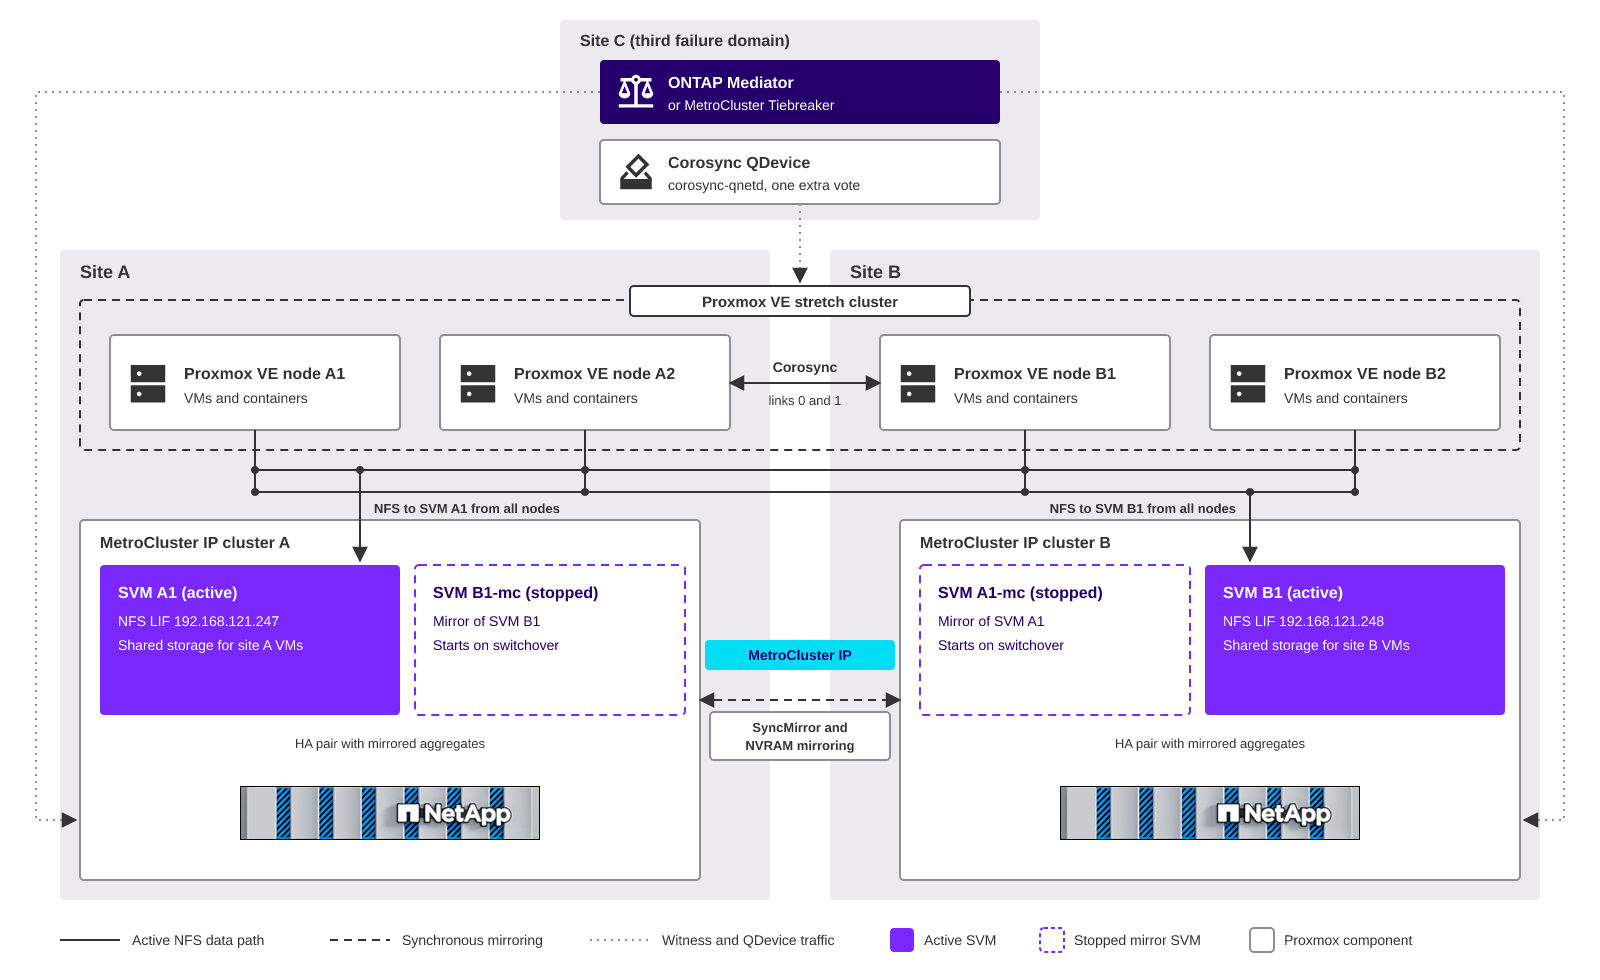
- Clusters IP MetroCluster
-
Chaque site dispose d'une paire haute disponibilité avec des agrégats en miroir. Le MetroCluster réseau back-end IP réplique les données (SyncMirror) et la NVRAM vers le site partenaire de manière synchrone.
- SVM sur les deux sites
-
Chaque site peut gérer ses propres SVM. Pour chaque SVM, MetroCluster conserve sur le site partenaire une SVM miroir arrêtée avec le suffixe
-mc, ainsi que la même configuration et les mêmes adresses LIF. - Accès NFS depuis tous les nœuds
-
Chaque nœud Proxmox VE monte le stockage partagé des deux SVM actives, SVM A1 et SVM B1, afin que la haute disponibilité puisse redémarrer n'importe quelle VM sur n'importe quel nœud. Les nœuds du site B accèdent à SVM A1, et les nœuds du site A accèdent à SVM B1, via le réseau intersites. Il s'agit du même modèle d'accès que SnapMirror active sync.
- Basculement
-
En cas de défaillance d'un site, ONTAP Mediator ou MetroCluster Tiebreaker sur le site C active un basculement automatique. Les SVM miroirs du site survivant démarrent et assurent l'ensemble du stockage partagé avec les mêmes adresses NFS, et Proxmox VE HA redémarre les VM du site défaillant. La défaillance d'un seul contrôleur est gérée par une prise de contrôle HA locale, sans basculement. Après avoir réparé le site défaillant, vous rétablissez les agrégats et revenez en arrière.
Comment MetroCluster réagit aux pannes
Le tableau suivant montre comment une configuration IP MetroCluster et le cluster étendu Proxmox VE réagissent aux mêmes pannes que dans Comment la solution réagit aux défaillances. Dans cet exemple, la SVM A1 est active sur le site A et la SVM B1 est active sur le site B.
| Événement | Comportement d’ONTAP | Comportement de Proxmox VE |
|---|---|---|
Le site A tombe en panne |
ONTAP Mediator ou MetroCluster Tiebreaker confirme la panne, et ONTAP effectue le basculement du site A. La SVM A1-mc démarre sur le site B avec la même adresse LIF NFS. La SVM B1 continue de servir les données. |
Les nœuds du site B et le QDevice maintiennent le quorum. HA isole les nœuds du site A et redémarre leurs machines virtuelles sur les nœuds du site B. Les machines virtuelles déjà exécutées sur les nœuds du site B continuent de fonctionner, et celles du SVM A1 reprennent leurs E/S après le basculement. |
MetroCluster Le cluster IP A tombe en panne, les nœuds Proxmox VE du site A continuent de fonctionner |
ONTAP Mediator ou MetroCluster Tiebreaker confirme que le cluster A est inaccessible, et ONTAP effectue le basculement du site A. La SVM A1-mc démarre sur le site B avec la même adresse NFS LIF. |
Aucun changement de quorum ni redémarrage de VM. Les VM du SVM A1 reprennent leurs E/S après le basculement, les nœuds du site A atteignant le site B via le réseau inter-sites. |
Un contrôleur du site A tombe en panne |
Le partenaire HA du site A prend le relais lors d'une reprise HA locale. Aucun basculement n'a lieu. |
Aucun impact. Les machines virtuelles interrompent brièvement les E/S pendant le basculement. |
Le site B tombe en panne |
ONTAP bascule sur le site B. Le SVM B1-mc démarre sur le site A avec la même adresse LIF NFS. Le SVM A1 continue de fournir des données. |
Les nœuds du site A et le QDevice maintiennent le quorum. HA redémarre les VM du site B sur les nœuds du site A, où elles accèdent à la SVM B1 du site A. |
Échec de la liaison inter-sites |
Aucun basculement n'a lieu, car les deux clusters restent opérationnels. Chaque site continue de gérer ses propres SVM, et la réplication vers le site partenaire est suspendue jusqu'au rétablissement de la connexion. |
En cas d’égalité, le QDevice vote en faveur de la partition du site A lorsque le départage est aligné sur le site A. Les nœuds du site B perdent alors le quorum et s’isolent eux-mêmes. La haute disponibilité redémarre les machines virtuelles sur le SVM A1 sur les nœuds du site A. Les machines virtuelles sur le SVM B1 ne peuvent pas redémarrer tant que la liaison n’est pas rétablie, car les nœuds du site A ne peuvent pas atteindre le SVM B1. |
Le site C tombe en panne |
La mise en miroir se poursuit sans aucune perte de données, mais le basculement automatique n'est possible que lorsque le témoin est disponible. Vous pouvez toutefois effectuer le basculement manuellement. |
Le cluster maintient le quorum grâce aux votes des quatre nœuds. Aucune machine virtuelle n'est affectée. |
Un nœud Proxmox VE tombe en panne |
Aucun impact. |
HA redémarre les VMs de ce nœud sur d'autres nœuds, en privilégiant les nœuds du même site. |
La défaillance de la liaison inter-sites constitue la principale différence par rapport à une conception avec un seul site principal. Lorsque les deux sites hébergent des SVM actives, avec MetroCluster ou avec deux SVM de synchronisation active SnapMirror dans des directions opposées, le mécanisme de départage corosync ne peut favoriser qu'un seul site. Les VM dont la SVM active se trouve sur l'autre site restent arrêtées jusqu'au rétablissement de la liaison. Pour limiter l'impact, utilisez des liaisons inter-sites redondantes sur des chemins physiques distincts et placez les VM les plus critiques sur la SVM du site favorisé par le mécanisme de départage.
Comparaison des fonctionnalités
| Considération | SnapMirror active sync pour NAS | MetroCluster IP |
|---|---|---|
Portée de la protection |
SVM et volumes sélectionnés |
Tous les agrégats mis en miroir et toutes les SVM de la configuration |
Granularité du basculement |
Chaque SVM de manière indépendante |
L'ensemble du site, par basculement |
Charges de travail non protégées |
Exécutez sur des SVMs non protégées dans les mêmes clusters |
Vous pouvez utiliser des agrégats non mis en miroir, qui se mettent hors ligne après une bascule jusqu'à ce que vous les remettiez en ligne |
Conception du cluster |
Deux clusters indépendants, interconnectés via un réseau IP |
Une configuration de deux clusters partenaires, avec un réseau back-end IP MetroCluster dédié |
Témoin sur le site C |
ONTAP Mediator ou ONTAP Cloud Mediator |
ONTAP Mediator ou MetroCluster Tiebreaker |
Copies de données protégées |
Un sur chaque site |
Un sur chaque site, dans des agrégats en miroir |
Chemin de réplication |
SnapMirror synchrone sur les LIF intercluster |
SyncMirror et la mise en miroir de NVRAM sur le réseau IP back-end MetroCluster |
Adresse NFS sur les deux sites |
VLAN de couche 2 étendu. Interfaces LIF VIP avec qualification BGP en cours |
VLAN de couche 2 étendu, ou LIF VIP avec BGP |
Récupération après une panne de site |
Retour à la normale pour chaque SVM |
Réparez les agrégats, puis rétablissez le site |
Guide de sélection
-
Choisissez MetroCluster lorsque la totalité, ou presque, des charges de travail sur le stockage nécessitent un RPO nul, par exemple lorsqu'une entreprise exécute uniquement des machines virtuelles critiques sur le cluster, ou lorsqu'un fournisseur de services propose le même niveau de disponibilité à tous ses clients. Vous bénéficiez d'un domaine de protection unique, sans configuration par charge de travail.
-
Choisissez SnapMirror active sync lorsqu'une partie seulement des charges de travail nécessite un RPO nul, par exemple un niveau premium pour certains locataires, ou lorsque vous devez effectuer un basculement ou tester la reprise après sinistre pour un locataire ou une application à la fois.
-
SnapMirror active sync pour NAS n'est pas pris en charge sur une configuration MetroCluster. Utilisez une solution pour chaque paire de clusters.
-
Les recommandations relatives à corosync, QDevice et HA dans cette solution s'appliquent aux deux. Avec MetroCluster, alignez le départage QDevice sur le site qui continue à servir les données lorsque la liaison inter-sites tombe en panne, et utilisez les règles d'affinité des nœuds HA pour maintenir les machines virtuelles sur le même site que leur SVM actif.
-
MetroCluster IP prend également en charge les LIF VIP avec BGP pour les réseaux de couche 3 entre les sites.
Considérations relatives à Corosync pour un cluster étendu Proxmox VE
Proxmox VE utilise corosync pour la gestion des membres du cluster et le quorum. Corosync est plus sensible au réseau intersite que SnapMirror active sync, alors planifiez d'abord le réseau du cluster.
Latence et conception du réseau
-
SnapMirror active sync nécessite un temps d'aller-retour inter-cluster (RTT) inférieur à 10 ms. Proxmox recommande une latence corosync inférieure à 5 ms entre tous les nœuds, de sorte que l'exigence corosync fixe la limite de distance pour la solution.
-
Corosync nécessite une latence faible et constante plutôt qu'une bande passante élevée. Utilisez un réseau dédié à corosync, distinct du trafic de stockage et de migration en direct, afin que les pics d'activité du stockage n'entraînent pas de délais d'attente pour corosync.
-
Configurez au moins deux liaisons corosync (par exemple, liaison 0 et liaison 1) sur des chemins physiques distincts entre les sites. Corosync utilise Kronosnet pour basculer automatiquement entre les liaisons en cas de défaillance d'un chemin.
Quorum avec un QDevice sur un troisième site
Répartissez les nœuds Proxmox VE de manière égale entre les sites A et B, et ajoutez un QDevice sur le site C. Avec quatre nœuds et un QDevice, le cluster dispose de cinq votes et nécessite trois votes pour le quorum ; ainsi, la défaillance de l’un ou l’autre site n’entraîne pas de perte de quorum. Le QDevice se connecte au cluster via le port TCP 5403 et n’est pas soumis aux exigences de faible latence de corosync ; il peut donc partager le site C avec ONTAP Mediator. Si vous utilisez ONTAP Cloud Mediator, un troisième emplacement reste nécessaire pour le QDevice, mais il peut s’agir d’un petit hôte Linux qui n’héberge pas aussi un médiateur.
Alignement du mécanisme de départage avec le cluster principal
En cas de défaillance de la liaison inter-sites, alors que les deux sites peuvent toujours atteindre le site C, ONTAP maintient le cluster principal du site A en service pour fournir les données. Le QDevice doit attribuer son vote au même site. Par défaut, le QDevice choisit la partition qui contient l'identifiant de nœud le plus faible.
BONNES PRATIQUES : Créez le cluster Proxmox VE sur un nœud du site A et joignez les autres nœuds du site A avant de joindre ceux du site B, afin que le site A ait les ID de nœud les plus bas. Si le stockage principal est déplacé vers le site B pendant une période prolongée, mettez à jour le paramètre QDevice tie_breaker avec un ID de nœud du site B.
Si le QDevice privilégiait plutôt le site B, les nœuds du site A s'auto-isoleraient, et HA redémarrerait les machines virtuelles sur les nœuds du site B qui ne peuvent pas atteindre le stockage actif du site A.
Comportement HA et placement des VM
-
Proxmox VE HA détecte généralement une défaillance de nœud et récupère ses machines virtuelles en environ deux minutes, y compris un délai d'expiration de fencing du watchdog de 60 secondes. Lors d'une défaillance de site, le basculement de SnapMirror active sync et la récupération de Proxmox VE HA s'exécutent en parallèle.
-
Utilisez les règles d'affinité de nœud HA avec des priorités de nœud pour placer les machines virtuelles sur les nœuds du même site que leur stockage principal, et pour leur permettre de basculer vers l'autre site.
-
Après un basculement de site, définissez la propriété HA
failbacksur0pour les VM concernées jusqu'à ce que vous rétablissiez le stockage. Sinon, HA remigre les VM vers les nœuds du site A dès qu'ils reviennent, alors que le stockage actif se trouve toujours sur le site B. -
Assurez-vous que les délais d'expiration des disques du système d'exploitation invité sont plus longs que le temps de basculement prévu, afin que les systèmes invités ne signalent pas d'erreurs d'E/S lors d'un basculement du stockage.
Intégration avec Storage Manager pour Proxmox
Storage Manager for Proxmox (SMP) offre aux administrateurs de Proxmox VE une interface unique pour provisionner le stockage partagé ONTAP et pour sauvegarder, restaurer et cloner des machines virtuelles à l’aide des snapshots ONTAP et de la technologie FlexClone. SMP se connecte au cluster Proxmox VE et à ONTAP via leurs API, ce qui évite d’installer des agents sur les nœuds Proxmox VE.
SMP et SnapMirror active sync protègent contre différents types de défaillances. SnapMirror active sync maintient les VM en fonctionnement en cas de défaillance du stockage ou du site, mais réplique chaque écriture de manière synchrone, y compris une suppression accidentelle, une mise à jour défaillante du système invité ou des données chiffrées par un ransomware. Les snapshots SMP vous offrent des copies instantanées à un moment précis pour récupérer après ces défaillances logiques. Ensemble, ils assurent une disponibilité continue et une récupération opérationnelle rapide à partir du même stockage ONTAP.
| Couche de protection | Protège contre | Point de récupération | Géré avec |
|---|---|---|---|
Synchronisation active de SnapMirror |
Panne du système de stockage et panne du site |
Aucune perte de données |
ONTAP |
Sauvegardes SMP (snapshots ONTAP) |
Suppression accidentelle, corruption des données, échecs de mise à jour et ransomware |
Dernière sauvegarde programmée ou à la demande |
SMP |
SnapMirror fan-out asynchrone ou Proxmox Backup Server |
Perte des deux sites, et rétention à long terme |
Dernière réplication ou sauvegarde |
ONTAP ou Proxmox Backup Server |
Sauvegarde et récupération
SMP crée, à la demande ou selon une stratégie, des sauvegardes cohérentes en cas de panne ou cohérentes au niveau des fichiers sous forme d'instantanés ONTAP des volumes de stockage, et restaure des VM, du stockage ou des groupes de ressources individuels :
-
Utilisez les groupes de ressources et les stratégies de sauvegarde pour appliquer la même planification et la même durée de conservation aux machines virtuelles d'un locataire ou d'une application.
-
Utilisez des sauvegardes cohérentes au niveau des fichiers pour les machines virtuelles qui exécutent l'agent invité QEMU, afin que les systèmes de fichiers invités soient figés avant qu'ONTAP ne crée l'instantané.
-
SMP gère le stockage actif. Après un basculement de la synchronisation active SnapMirror, effectuez une découverte dans SMP afin qu'il mappe le stockage sur le cluster B avant d'exécuter des opérations de sauvegarde ou de restauration.
-
Pour une troisième copie en dehors des deux sites, ou pour une conservation plus longue, ajoutez une relation de diffusion asynchrone SnapMirror à partir des volumes protégés, ou utilisez Proxmox Backup Server.
-
Les snapshots inviolables ne sont pas pris en charge avec SnapMirror active sync, alors n’activez pas le verrouillage des snapshots dans SMP pour les volumes protégés.
Clonage de machines virtuelles
SMP utilise la technologie ONTAP FlexClone pour créer des clones de machines virtuelles économes en espace pour le développement, les tests et le provisionnement rapide. Les clones que vous créez dans un stockage protégé consomment de la bande passante de réplication et de la capacité sur les deux sites. Excluez de la protection de synchronisation active SnapMirror les clones et le stockage de test qui ne nécessitent pas de continuité d'activité.
Placement SMP
-
Exécutez la VM SMP en tant que ressource HA sur un stockage partagé protégé par SnapMirror active sync, afin que SMP reste disponible après une panne du stockage ou du site.
-
Enregistrez le cluster Proxmox VE et les deux clusters ONTAP dans SMP, afin que SMP puisse accéder au stockage actif sur l'un ou l'autre site.
Stockage partagé NFS avec SnapMirror active sync pour NAS
À partir de ONTAP 9.19.1, SnapMirror active sync protège les charges de travail NAS. Les considérations suivantes s'appliquent uniquement au stockage partagé NFS. Pour déployer la solution avec un stockage NFS, suivez les instructions "Workflow de configuration NAS".
Protection au niveau SVM et identité du réseau
-
SnapMirror active sync pour NAS protège l’intégralité d’une machine virtuelle de stockage (SVM). Vous pouvez protéger tous les volumes de la SVM ou exclure certains volumes. Seuls les volumes FlexVol® sont pris en charge, et la SVM ne peut pas contenir de LUN.
-
Le SVM secondaire reste inactif, ses LIF étant hors service, jusqu'à un basculement. ONTAP réplique la configuration du SVM, y compris les adresses IP des LIF, les règles d'export et les paramètres NFS, afin que le SVM secondaire présente le même point de terminaison NFS après un basculement.
-
Le basculement s’effectue sans interruption pour NFSv3 et les versions ultérieures.
-
SnapMirror active sync pour NAS est actif/passif, de sorte que les machines virtuelles sur les nœuds du site B lisent et écrivent via le réseau intersite vers la SVM principale. Pour les charges de travail actives sur les deux sites, utilisez deux SVM avec des directions de réplication opposées, une principale sur chaque site, et alignez la règle d'affinité de nœud de chaque machine virtuelle sur le site de sa SVM principale.
-
SnapMirror la synchronisation active pour NAS est prise en charge sur les clusters AFF A-Series et C-Series à deux nœuds.
Paramètres du client NFS
Utilisez NFSv3 ou NFSv4.1 pour le stockage NFS. Conservez le comportement de montage hard par défaut et n'ajoutez pas l' `soft`option de montage, afin que les E/S NFS soient relancées au lieu d'échouer lors d'un basculement.
Utilisez plusieurs connexions TCP au stockage pour de meilleures performances et une tolérance aux pannes. Utilisez soit nConnect, soit le trunking de session, mais pas les deux :
-
nConnect. Ouvre plusieurs connexions TCP vers une seule adresse de LIF NFS, par exemple
nconnect=4. nConnect fonctionne avec NFSv3 et NFSv4.1 ainsi qu'avec une seule adresse de LIF VIP, ce qui en fait l'option recommandée pour SnapMirror active sync pour NAS, y compris les réseaux de couche 3. -
Agrégation de sessions. Regroupe plusieurs LIF de données dans une seule session NFSv4.1, par exemple
vers=4.1,trunkdiscovery,max_connect=16. L'agrégation de sessions requiert NFSv4.1 ou une version ultérieure. Utilisez-la uniquement lorsque la SVM protégée possède plusieurs LIF de données auxquelles les clients peuvent accéder sur les deux sites, comme dans un réseau de couche 2 étendu. Pour plus de détails, consultez "Trunking NFS".
Pour les commandes d'options de montage et les étapes de vérification, consultez "Configurer le stockage NFS pour Proxmox VE".
Provisionnement du stockage NFS avec SMP
SMP provisionne un volume ONTAP, crée ou sélectionne des règles d'export et monte le volume en tant que stockage partagé NFS sur les nœuds Proxmox VE que vous sélectionnez. Pour le stockage dans une SVM protégée :
-
Provisionnez le volume dans la SVM principale et sélectionnez la LIF NFS, ou la LIF VIP dans un réseau de couche 3, comme LIF préférée. La SVM secondaire utilise la même adresse après un basculement, de sorte que la définition du stockage reste valide.
-
Montez le stockage sur tous les nœuds Proxmox VE des deux sites afin que HA puisse redémarrer les VMs sur n'importe quel nœud.
-
Vérifiez que les règles d'export autorisent les nœuds Proxmox VE sur les deux sites. ONTAP réplique les règles d'export sur la SVM secondaire.
-
Après la mise en service, vérifiez que le volume est inclus dans la protection de synchronisation active SnapMirror.
Réseaux de couche 3 avec LIF VIP et BGP
SnapMirror active sync pour NAS nécessite la même adresse IP sur les SVM principale et secondaire. Lorsque le VLAN NFS est étendu entre les sites, l'adresse IP de la LIF se déplace avec la SVM. Lorsque les sites sont connectés par un réseau routé de couche 3, le sous-réseau d'une LIF du site A n'existe pas sur le site B.

|
Au moment de la publication, NetApp n'a pas documenté les LIF VIP avec BGP comme configuration qualifiée pour SnapMirror active sync pour NAS. Avant de planifier une conception de couche 3, confirmez la prise en charge actuelle auprès de NetApp. Sinon, étendez le VLAN NFS entre les sites. Les configurations IP MetroCluster prennent en charge les LIF VIP avec BGP. |
Les LIFs d’adresses IP virtuelles (VIP) ONTAP résolvent ce problème. Une LIF VIP n’appartient à aucun sous-réseau. ONTAP annonce l’adresse VIP aux routeurs homologues sous la forme d’une route hôte /32 à l’aide du protocole BGP (Border Gateway Protocol), ce qui permet à l’adresse de passer d’un site à l’autre sans VLAN étendu.
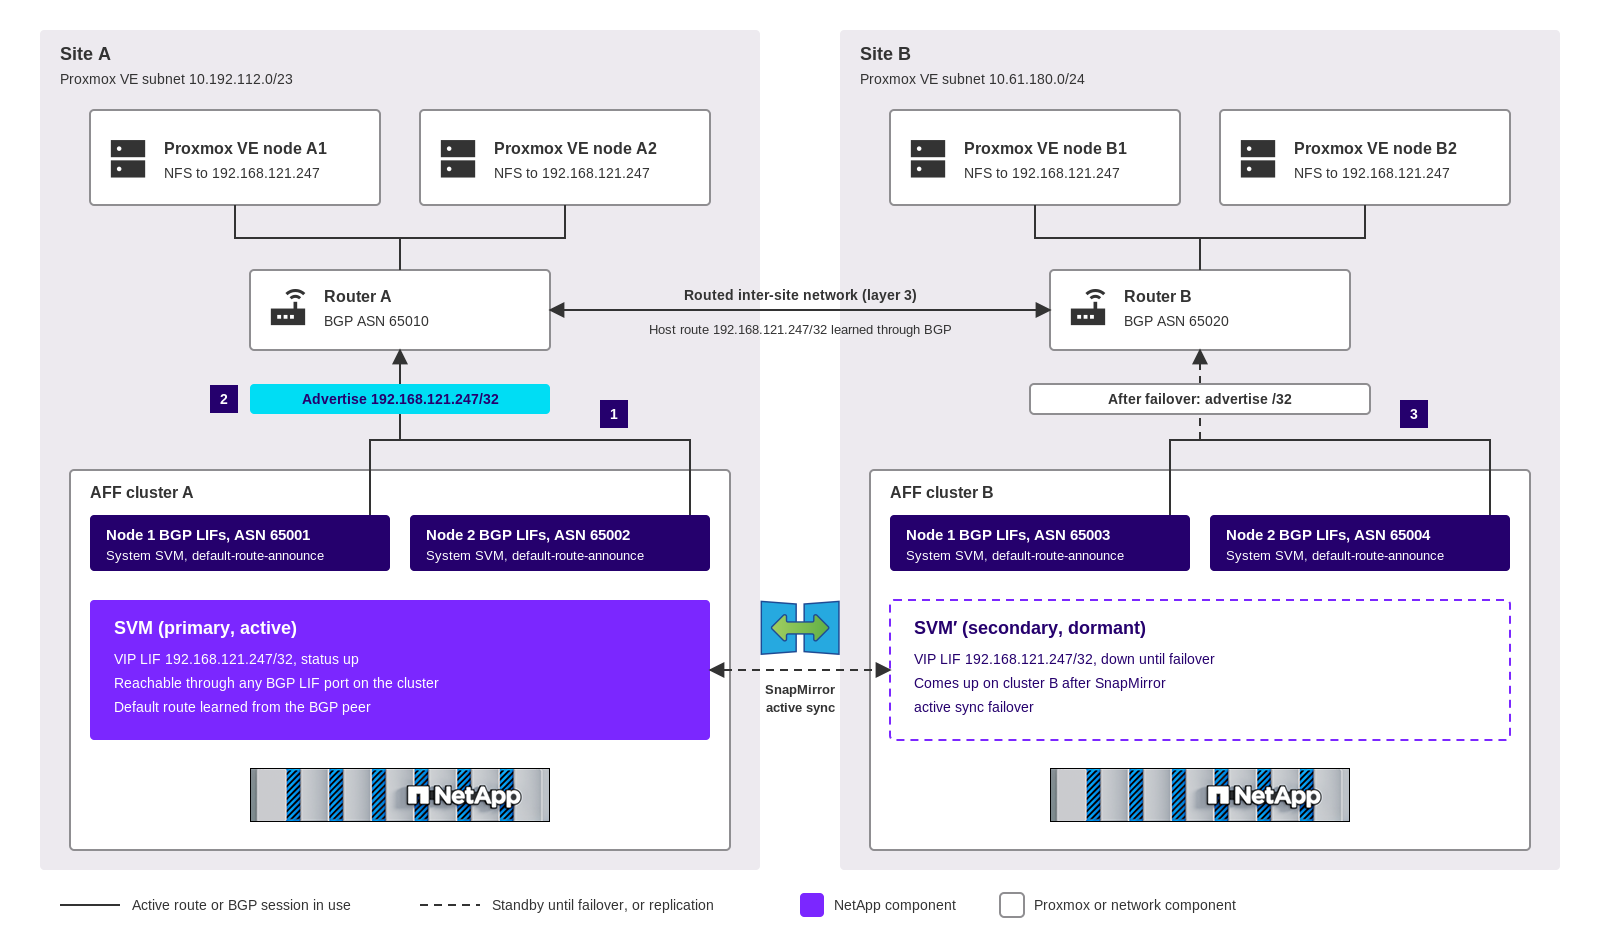
-
Chaque nœud des deux sites possède des interfaces logiques BGP (LIF) dans la SVM système, qui s'apparient avec les routeurs de son site. Les LIF BGP sont spécifiques à chaque nœud et ne sont pas répliquées ; il faut donc les configurer sur les deux clusters.
-
Le SVM principal héberge la NFS VIP LIF. Le cluster A annonce la route hôte /32, et les nœuds Proxmox VE des deux sites atteignent le stockage via le réseau routé.
-
Après un basculement de SnapMirror active sync, la LIF VIP apparaît sur la SVM secondaire, le cluster B annonce la route hôte et les routeurs convergent sur le site B.
Lorsque vous planifiez BGP dans ONTAP pour la première fois, il est utile de savoir à quelle SVM appartient chaque LIF. Les LIF BGP appartiennent à la SVM système de l'IPspace, et non aux SVM de données. Un ensemble de LIF BGP sur chaque cluster dessert les LIF VIP de chaque SVM de données dans cet IPspace, il n'est donc pas nécessaire de créer des LIF BGP pour chaque locataire. Le schéma suivant montre la disposition des LIF et des ports sur un cluster, avec des LIF BGP sur des ports VLAN.
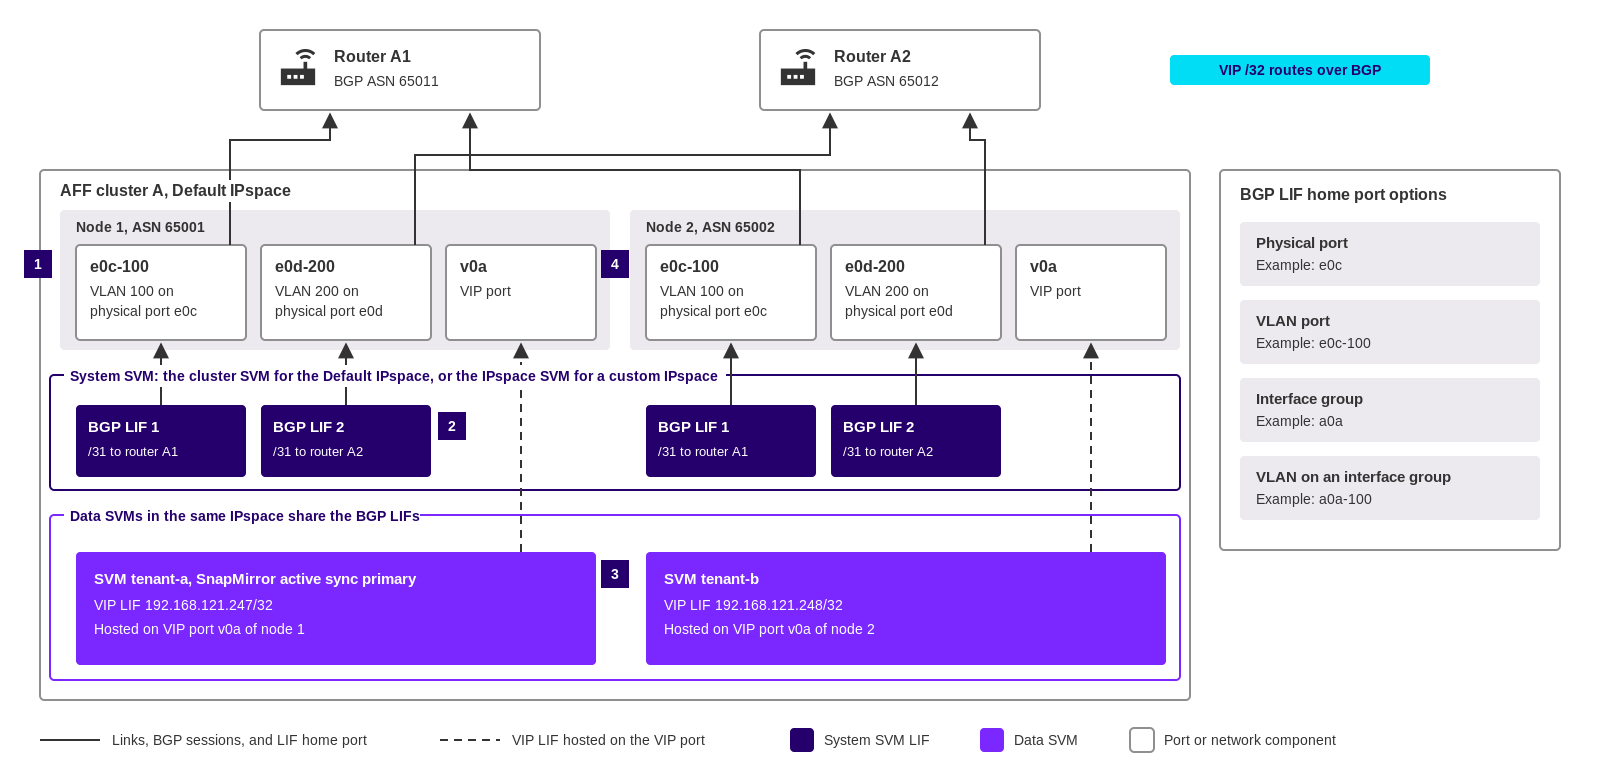
-
Chaque nœud possède deux ports pour BGP, dans cet exemple les ports VLAN
e0c-100ete0d-200. Chaque port se connecte directement à un routeur différent. -
Chaque nœud possède deux interfaces logiques BGP (LIF) dans la SVM système, une sur chaque port, avec un sous-réseau /31 et un groupe de pairs BGP vers un routeur. Pour le Default IPspace, la SVM système est la SVM du cluster. Pour un IPspace personnalisé, il s'agit de la SVM portant le même nom que l'IPspace.
-
Les SVM de données dans le même IPspace hébergent des LIF VIP et n'ont pas besoin de leurs propres LIF BGP. Les groupes de pairs BGP annoncent les routes VIP pour tous les SVM de l'IPspace.
-
ONTAP crée un port VIP, par exemple
v0a, sur chaque nœud lorsque vous créez le premier groupe de pairs BGP. Les LIF VIP sont hébergées sur le port VIP et sont accessibles via tous les ports du nœud qui héberge une LIF BGP dans l'espace IP.
Le port d'attache d'une interface logique BGP (LIF) peut être un port physique, un port VLAN, un groupe d'interfaces ou un VLAN sur un groupe d'interfaces. Un groupe d'interfaces n'est pas obligatoire. Le rapport technique TR-4949 de NetApp recommande deux interfaces logiques BGP (LIF) sur deux ports distincts pour chaque IPspace, chacune étant directement connectée à un routeur de premier saut différent.
Gardez à l'esprit les directives suivantes :
-
Les interfaces logiques BGP (LIF) ne prennent pas en charge le basculement automatique. La redondance est assurée par deux LIF BGP par nœud, chacune établissant une session avec un routeur différent. Si un nœud perd toutes ses sessions BGP pour une SVM, ONTAP déplace la LIF VIP vers un autre nœud disposant d'une session BGP active pour cette SVM.
-
Utilisez le protocole BGP externe (eBGP) avec un numéro de système autonome privé unique (ASN) pour chaque nœud ONTAP et chaque routeur.
-
Utilisez un sous-réseau /31 (masque de sous-réseau 255.255.255.254) pour chaque LIF BGP et son routeur. Attribuez l'adresse impaire à la LIF BGP et l'adresse paire au routeur.
-
ONTAP ne traite pas les routes provenant des routeurs. Configurez les routeurs pour qu'ils acceptent les routes hôtes /32 d'ONTAP et qu'ils n'envoient pas de mises à jour de routage au cluster.
-
Les nœuds Proxmox VE ne doivent pas partager le même sous-réseau que l'adresse VIP. Un routeur de couche 3 redondant, par exemple avec VRRP ou HSRP, doit être présent sur le chemin entre les nœuds et le stockage.
-
Configurez les groupes de pairs BGP avec
-use-peer-as-next-hop trueafin que chaque cluster apprenne sa route par défaut à partir de ses routeurs locaux. Les routes pointant vers une passerelle du site A ne sont pas valides sur le site B après un basculement. -
Activez le routage multipath afin que le trafic VIP sortant utilise tous les ports LIF BGP disponibles.
-
Réduisez le délai de maintien BGP par défaut de 180 secondes. TR-4949 recommande un délai de maintien de 3 secondes. Un routeur retire la route d'un cluster défaillant uniquement lorsque le temporisateur de maintien expire, et pendant une panne du système de stockage, le routeur du site A reste en ligne.