


Utilizza la latenza del carico di lavoro per identificare i problemi di prestazioni in Active IQ Unified Manager
 Suggerisci modifiche

 PDF

La latenza del carico di lavoro (tempo di risposta) è il tempo necessario affinché un volume su un cluster risponda alle richieste di I/O provenienti dalle applicazioni client. Unified Manager utilizza la latenza per rilevare gli eventi relativi alle prestazioni e avvisarti.
Una latenza elevata significa che le richieste delle applicazioni a un volume su un cluster impiegano più tempo del solito. La causa della latenza elevata potrebbe trovarsi nel cluster stesso, a causa della contesa su uno o più componenti del cluster. La latenza elevata potrebbe anche essere causata da problemi esterni al cluster, come colli di bottiglia della rete, problemi con il client che ospita le applicazioni o problemi con le applicazioni stesse.

|
Unified Manager monitora esclusivamente l'attività dei carichi di lavoro sul cluster. Non monitora le applicazioni, i client o i percorsi tra le applicazioni e il cluster. |
Le operazioni sul cluster, come l'esecuzione di backup o la deduplicazione, che aumentano la richiesta di componenti del cluster condivisi da altri carichi di lavoro, possono contribuire a un'elevata latenza. Se la latenza effettiva supera la soglia di prestazioni dinamica dell'intervallo previsto (previsione della latenza), Unified Manager analizza l'evento per determinare se si tratta di un evento di prestazioni che potresti dover risolvere. La latenza si misura in millisecondi per operazione (ms/op).
Nel grafico Latenza totale nella pagina Analisi del carico di lavoro, puoi visualizzare un'analisi delle statistiche sulla latenza per vedere come l'attività dei singoli processi, come le richieste di lettura e scrittura, si confronta con le statistiche complessive sulla latenza. Il confronto ti aiuta a determinare quali operazioni hanno l'attività più elevata o se operazioni specifiche presentano un'attività anomala che influisce sulla latenza di un volume. Quando analizzi gli eventi relativi alle prestazioni, puoi usare le statistiche sulla latenza per determinare se un evento è stato causato da un problema nel cluster. Puoi anche identificare le attività specifiche del carico di lavoro o i componenti del cluster coinvolti nell'evento.
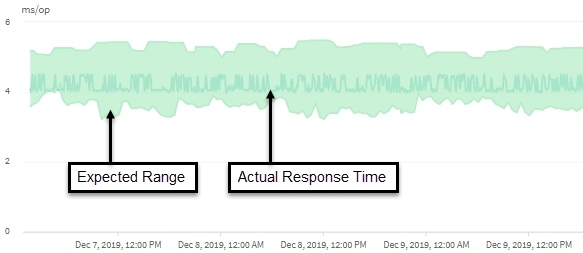
Questo esempio mostra il grafico della latenza. Il tempo di risposta effettivo (latenza) è rappresentato da una linea blu, mentre la latenza prevista (intervallo atteso) è rappresentata da una linea verde.
|
|
La linea blu potrebbe presentare delle interruzioni se Unified Manager non è riuscito a raccogliere i dati. Ciò può verificarsi perché il cluster o il volume non erano raggiungibili, Unified Manager era spento durante quel periodo oppure la raccolta richiedeva più tempo del periodo di raccolta di 5 minuti. |