


SnapMirror active syncを使用したProxmox VEのビジネス継続性について学ぶ

 変更を提案

 PDF

Proxmox Virtual Environment(VE)でビジネス クリティカルな仮想マシン(VM)を実行する企業や、Proxmox VEで顧客のVMをホストするサービスプロバイダは、ストレージシステムやデータセンター全体がオフラインになった場合でも、それらのVMを稼働させ続ける必要があります。ONTAP SnapMirror active syncは、2つのサイトに拡張されたProxmox VEクラスタの共有ストレージを同期レプリケーションし、ストレージを自動的に稼働中のサイトにフェイルオーバーします。目標復旧時点(RPO)ゼロ、スクリプトやランブックなしの自動復旧、両サイトでの同一の共有ストレージを実現できるため、Proxmox VEの高可用性(HA)により、ストレージを再構成することなくVMを再起動できます。NFS共有ストレージの場合、このソリューションはNAS向けのSnapMirror active syncを使用します。
顧客の課題
Proxmox VEのストレージとサイトの耐障害性をネイティブツールだけで構築するのは困難です:
-
*サイト障害後のデータ損失。*Proxmox VEのストレージレプリケーションとProxmox Backup Serverは非同期です。プライマリサイトに障害が発生すると、前回のレプリケーションまたはバックアップ以降に加えられた変更は失われます。
-
*手動による時間のかかるリカバリ。*セカンダリサイトでの復旧は通常、レプリカの昇格、別のアドレスでのストレージのマウント、 `/etc/pve/storage.cfg`の更新、およびVMの再起動を伴います。手作業による各手順は、ダウンタイムを増加させ、システム停止中のエラーのリスクを高めます。
-
*ホストリソースをめぐってVMと競合するストレッチドストレージ*ハイパーコンバージド・ストレッチド・ストレージ(たとえば、ストレッチモードのCephなど)は、Proxmox VEノード上で動作し、各サイトにすべてのオブジェクトのレプリカを2つ保持します。レプリケーション、リカバリ、およびリバランスのトラフィックは、VMを実行する同じノード上のCPU、メモリ、およびネットワーク リソースを消費します。
-
*2つのクォーラムの決定が一致する必要があります。*どのような2サイト設計でも、Proxmox VEクラスタとストレージ用に、第3の障害ドメインにウィットネスが必要です。サイト間リンクの障害後にクラスタとストレージが異なる存続サイトを選択した場合、VMはアクティブなストレージに到達できないノード上で再起動します。
-
*両方のサイトで有効なストレージアドレス。*ストレージのフェイルオーバー後、Proxmox VEノードは同じアドレスで共有ストレージにアクセスできる必要があります。そのアドレスは両方のサイトからアクセス可能である必要があり、通常はサイト間に拡張されたレイヤ2 VLANを意味します。
サービスプロバイダーの課題
Proxmox VE上でクラウド サービスを構築するサービスプロバイダーは、テナントのサービスレベル契約(SLA)に加えて、同様の課題に直面します:
-
*ストレージシステムは共通障害点です。*Proxmox VE HAは、テナントVMをホストの障害から保護しますが、VMのディスクをホストするストレージシステムの障害からは保護しません。ストレージの障害が1件発生すると、そのシステムを利用しているすべてのテナントに影響が及びます。
-
*より高い可用性を販売する方法はありません。*同期レプリケーションと自動ストレージフェイルオーバーがなければ、プロバイダーはデータ損失ゼロで稼働率の保証がより強力なプレミアム可用性ティアを提供することはできません。
-
*復旧中のテナント分離。*復旧、保守、および災害復旧テストは、プラットフォーム全体ではなく、関係するテナントにのみ影響するようにする必要があります。
企業の課題
ミッションクリティカルなワークロードを他のハイパーバイザーからProxmox VEに移行する企業は、データベースや基幹業務アプリケーションのデータ損失ゼロ、手動の手順書なしでの復旧など、以前と同様のサイトの回復力を期待しています。Proxmox VEのネイティブツールだけでその期待に応えるには、相当な設計、スクリプト作成、および運用上の労力が必要となります。
ソリューションの概要
このソリューションは、2つのサイトにあるNetApp AFF システム上のSnapMirrorアクティブ同期と、Proxmox VEストレッチクラスタを組み合わせています:
-
*RPOゼロ。*ONTAPは、サイトAのプライマリクラスタからサイトBのセカンダリクラスタへ、共有ストレージへのすべての書き込みを同期的に複製します。
-
*両サイトで同じ共有ストレージ*フェイルオーバー後、セカンダリクラスタはProxmox VEに同じストレージを提供するため、 `/etc/pve/storage.cfg`内のストレージ定義は有効なままです。
-
*自動フェイルオーバー。*メディエーターは、2つのサイトの外部で監視役として機能します。ONTAP Mediatorを3つ目のサイトにインストールするか、NetApp ConsoleでホストされるサービスであるONTAP Cloud Mediatorを使用できます。プライマリ ストレージまたはサイトに障害が発生した場合、ONTAPは手動での介入なしにサイトBにフェイルオーバーします。
-
*きめ細かな制御。*保護するワークロードを選択し、サイトのメンテナンスのために1つのテナントやアプリケーションを移動する場合など、ワークロードを個別にフェイルオーバーできます。
-
*セカンダリコピーの使用。*レプリケーションに影響を与えることなく、開発、テスト、またはディザスタリカバリのテスト用にセカンダリコピーのクローンを作成できます。
このソリューションが課題にどのように対処するか
| 課題 | このソリューションがどのように役立つか | まだ計画が必要な事項 |
|---|---|---|
データ損失と手動復旧 |
同期レプリケーションではRPOはゼロになります。ONTAPは自動的にフェイルオーバーし、セカンダリSVMは同じNFSアドレスを提示するため、 `/etc/pve/storage.cfg`は有効なままです。 |
Proxmox VE HAは、引き続き障害が発生したサイトから仮想マシンを再起動します。 |
ホスト上の拡張ストレージ |
レプリケーションはProxmox VEノードではなくAFFコントローラ上で実行されるため、ホストCPU、メモリ、ネットワークは引き続きVMで利用できます。ONTAPは各サイトにコピーを1つずつ保持し、ストレージ効率化は両方のコピーに適用されます。 |
他の同期レプリケーションと同様に、このソリューションではサイトBに完全な2つ目のコピーが必要であり、レプリケーションによって両方のAFFクラスタに負荷がかかります。レプリケーションのワークロードに合わせて、両方のクラスタのサイジングを行ってください。 |
定足数に関する2つの決定 |
ONTAP Mediator、またはNetApp ConsoleのサービスであるONTAP Cloud Mediatorは、データ パス外の軽量なウィットネスです。このソリューションは、corosync QDeviceをプライマリクラスタと連携させ、両方が同じサイトを選択するようにする方法を示しています。 |
QDeviceには、3つ目の設置場所が引き続き必要です。ONTAP Mediatorにも必要ですが、ONTAP Cloud Mediatorには必要ありません。Mediatorオプションを参照してください。 |
両サイトのストレージアドレス |
セカンダリSVMは同じNFS LIFアドレスを引き継ぐため、再マウントやストレージの再構成は必要ありません。 |
NFSサブネットは両方のサイトからアクセス可能である必要があり、通常は拡張レイヤ2 VLANを使用します。VIP LIFの資格ステータスについては、VIP LIFとBGPを備えたレイヤ3ネットワークを参照してください。 |
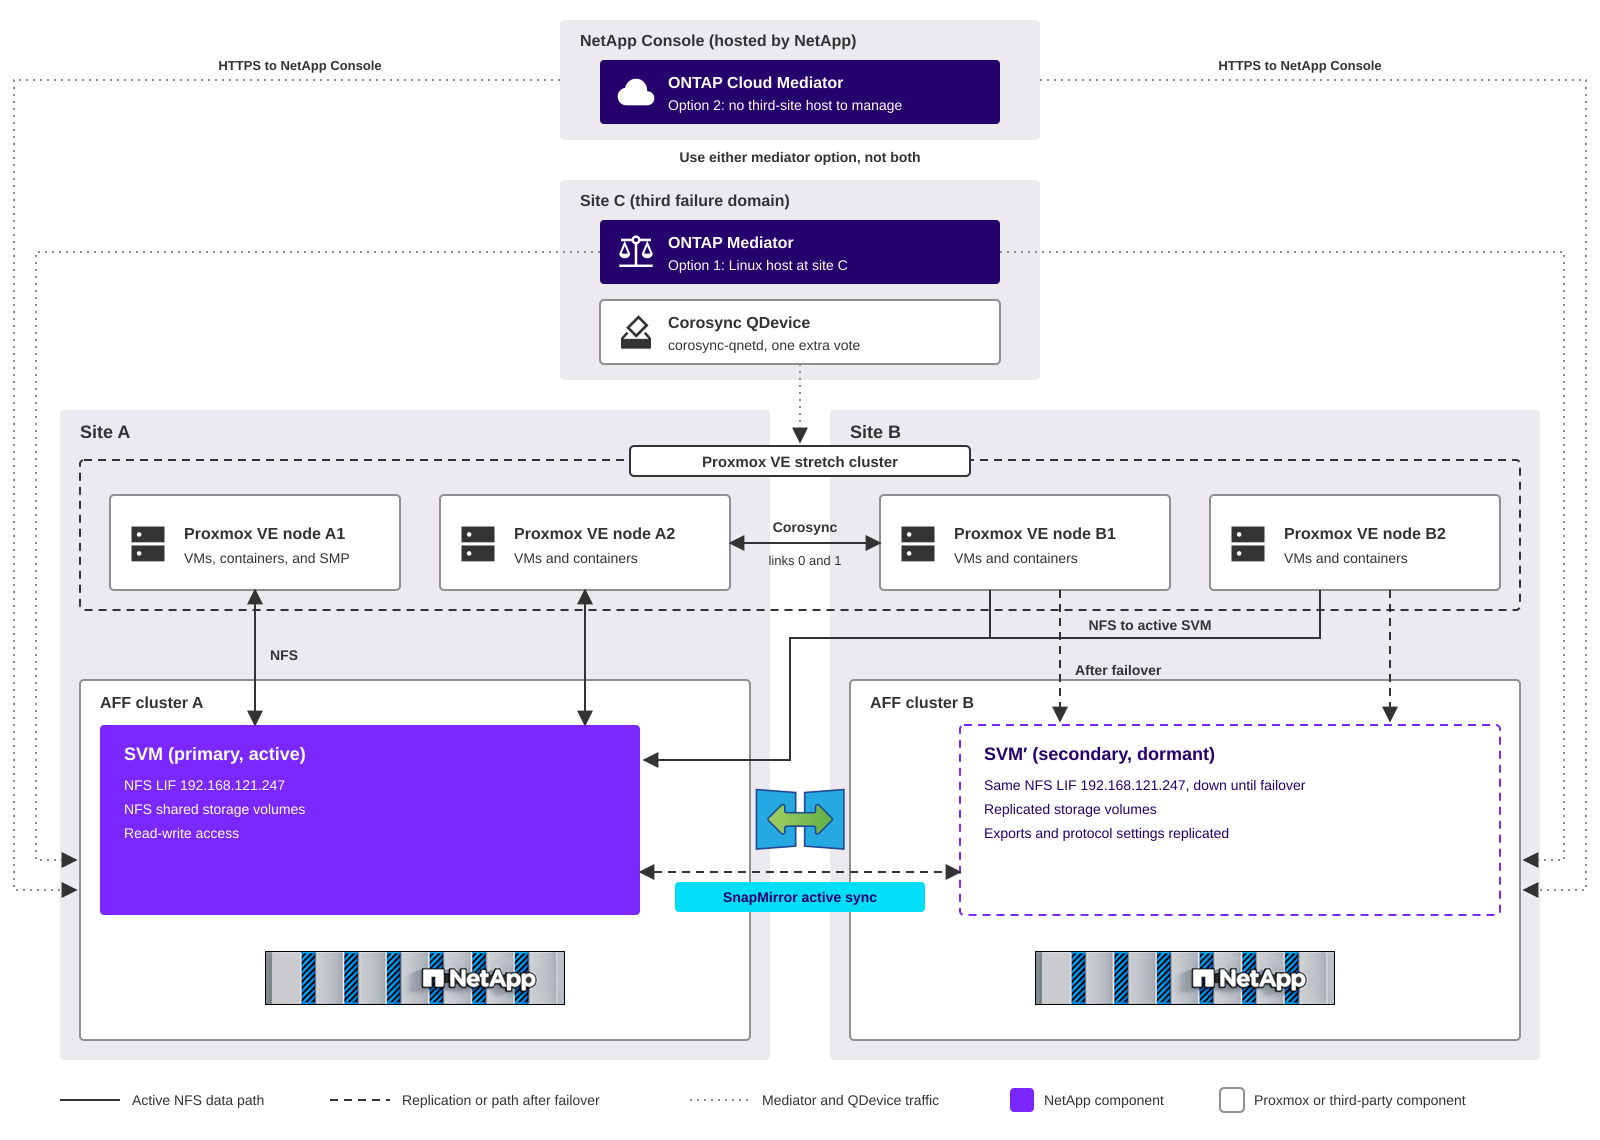
次の図は、NFS共有ストレージを使用したソリューション アーキテクチャを示しています。
- サイトAとサイトB
-
各サイトには、AFF 2ノードクラスタとProxmox VEノードの半分が配置されています。サイトAにあるプライマリクラスタは、すべてのProxmox VEノードに共有ストレージを提供します。サイトBのノードは、サイト間ネットワークを介してプライマリクラスタに接続します。NFSストレージを使用する場合、サイトBのセカンダリSVMはフェイルオーバーが発生するまで休止状態を維持します。
- サイトC
-
3番目の障害ドメインは、corosync QDeviceデーモン(
corosync-qnetd)と、オプション1を選択した場合はONTAP Mediatorをホストします。QDeviceは追加の投票権を提供することで、いずれかのサイトに障害が発生した場合でもProxmox VEクラスタがクォーラムを維持できるようにします。 - NetApp Console
-
オプション2を選択した場合、ONTAP Cloud Mediatorは、NetAppがホストおよび管理するNetApp Consoleでサービスとして実行されます。両方のAFFクラスタがHTTPS経由で接続するため、メディエーター ホストをインストールしたり保守したりする必要はありません。
- メディエーター
-
ONTAP MediatorまたはONTAP Cloud Mediatorは、ONTAPがどのクラスタからデータを提供するかを決定するのに役立ちます。両方ではなく、いずれか一方を使用してください。比較については、Mediatorオプションを参照してください。
- Proxmox VE ストレッチクラスタ
-
すべてのProxmox VEノードは1つのクラスタに属し、同じストレージ定義を共有します。Proxmox VE HAは、障害が発生したサイトのVMを、稼働中のノード上で再起動します。Storage Manager for Proxmox(SMP)は、クラスタ上でHA VMとして動作し、共有ストレージのプロビジョニング、VMのバックアップ、リストア、クローン作成を行います。
Mediatorオプション
SnapMirrorアクティブ同期は、受動的な監視役としてメディエーターを使用します。ネットワークの分断や1つのクラスタの障害が発生した場合、ONTAPはメディエーターを使用して、どのコピーが引き続きI/Oを処理するかを決定します。メディエーターはデータ パスには存在せず、メディエーター自体がフェイルオーバーを開始することはありません。以下のいずれかのオプションを使用できますが、両方を同時に使用することはできません。
| 考慮事項 | オプション1:ONTAP Mediator | オプション2:ONTAP Cloud Mediator |
|---|---|---|
稼働場所 |
独立した電源とネットワーク インフラを備えた、サイトCなどの第3の障害ドメインにインストールして管理するLinuxホスト |
NetApp Consoleのクラウド サービスです。NetAppがホストおよび管理するため、第3のサイトに仲介ホストを用意する必要はありません。 |
ONTAPのバージョン |
NAS向けSnapMirrorアクティブ同期用のONTAP 9.19.1以降。 |
ONTAP Cloud Mediatorは、ONTAP 9.17.1以降で利用可能です。SnapMirrorのNAS向けアクティブ同期には、ONTAP 9.19.1以降が必要です。 |
クラスタ接続 |
両方のクラスタはメディエータホストに接続します。デフォルトのサービスポートは31784です。 |
どちらのクラスタも、直接またはHTTPプロキシ経由で、HTTPSを使用してNetApp Consoleにアウトバウンド接続します。NetApp Consoleへの推奨pingレイテンシは200 ms未満です。 |
セットアップ |
パッケージをLinuxホストにインストールし、ホストアドレスとメディエーターユーザを使用してクラスタに追加します。 |
*ONTAP Mediator Setup Role*を持つNetApp Consoleサービスアカウントを作成し、組織ID、クライアントID、およびクライアントシークレットを使用して、メディエーターをクラスタに追加します。 |
操作 |
ホストにパッチを適用してアップグレードし、利用可能な状態を維持します。 |
パッチ適用やアップグレードを行うホストはありません。両方のサイトからのインターネットアクセスと、NetApp Consoleサービスの可用性に依存します。 |
ベストフィット |
第三サイトが存在する環境、またはストレージクラスタがインターネットに接続できない環境。 |
メディエーター用の第3サイトがない環境、またはメディエーターの運用を避けたい環境。 |
選択する際には、以下の点に留意してください:
-
*QDeviceには引き続き3つ目の設置場所が必要です。*ONTAP Cloud Mediatorは、corosync QDeviceホストではなく、メディエーターホストを削除します。QDeviceには、すべてのProxmox VEノードがTCPポート5403でアクセスできる小規模なLinuxホストが必要ですが、corosyncの低レイテンシ要件はありません。
-
*両方のクラスタはNetApp Consoleにアクセスできる必要があります。*クラスタでプロキシを使用する場合は、プロキシのルートCA証明書を両方のクラスタにインストールします。NetAppでは、クラスタごとに異なるプロキシ サーバを使用することを推奨しています。
-
*どちらのオプションでも同じ障害時の動作を想定して計画してください。*メディエーターが利用できない場合、レプリケーションはデータ損失なく継続されますが、メディエーターが再び利用可能になるまで、自動および計画的なフェイルオーバーは実行できません。ONTAP Cloud Mediatorを使用する場合、これにはクラスタからNetApp Consoleへの接続の喪失が含まれます。

|
このセクションのメディエーターオプションは、SnapMirrorアクティブ同期に適用されます。MetroClusterの場合、このソリューションではONTAP MediatorまたはMetroCluster Tiebreakerを使用します。デプロイする前に、ご使用のONTAPバージョン、メディエーターオプション、およびProxmox VEバージョンが"NetApp Interoperability Matrix Tool(IMT)"に一緒に記載されていることを確認してください。 |
サービスプロバイダにとってのメリット
-
*ホストHAを超えるVMの可用性。*テナントVMは、ディスクをホストするストレージシステムに障害が発生しても稼働し続けます。ONTAPは2番目のAFFクラスタにフェイルオーバーし、VMは再起動することなく同じ共有ストレージ上でI/Oを再開します。
-
*プレミアム可用性ティア*同じクラスタ内の保護されていないストレージ上の標準ティアと並行して、RPOゼロでストレージ耐障害性に優れたVMサービスをアドオンとして提供できます。
-
*テナントごとの保護とフェイルオーバー*テナントまたはサービス階層ごとに個別の保護ストレージを使用することで、他のテナントに影響を与えることなく、各テナントの保護、フェイルオーバー、およびディザスタリカバリのテストを個別に実行できます。
-
*両サイトをより有効活用する。*一部のワークロードをサイトAでプライマリにし、他のワークロードをサイトBでプライマリにすることで、両方のデータセンターがアクティブなワークロードに対応できるようになります。
企業にとってのメリット
-
ストレージ障害またはサイト障害の発生時における、ビジネス クリティカルなVMのデータ損失ゼロ。
-
スクリプト、ストレージの再マウント、または `/etc/pve/storage.cfg`への変更を必要としない*自動リカバリ*。
-
ONTAPに組み込まれており、Proxmox VEノード上に追加のソフトウェアレイヤは不要です。
-
*1つのインターフェイスで日常業務を管理。*Storage Manager for Proxmoxは、保護された共有ストレージをプロビジョニングし、ONTAPスナップショットとFlexCloneテクノロジを使用してVMのバックアップ、リストア、クローン作成を行います。
ソリューションが障害にどのように対応するか
ONTAPとProxmox VEは、独立してクォーラムの決定を行います。この設計により、両者が同じ存続サイトを選択するように調整されています。
| イベント | ONTAPの動作 | Proxmox VEの動作 |
|---|---|---|
サイトAに障害が発生 |
メディエーターが障害を確認すると、ONTAPは自動的に共有ストレージをクラスタBにフェイルオーバーします。 |
サイトBのノードとQDeviceはクォーラムを維持します。HAはサイトAのノードをフェンスし、サイトBのノード上でそれらのVMを再起動します。ストレージの |
AFFクラスタAに障害が発生しても、サイトAのProxmox VEノードは引き続き稼働する |
メディエーターはクラスタAに到達できないことを確認し、ONTAPは共有ストレージを自動的にクラスタBにフェイルオーバーします。 |
クォーラムの変更やVMの再起動はありません。ストレージのフェイルオーバー後、すべてのノード上のVMは同じ共有ストレージ上でI/Oを再開し、サイトAのノードはサイト間ネットワークを介してクラスタBに接続します。 |
サイトAのAFFコントローラ1台に障害が発生する |
ローカルHAテイクオーバーでは、パートナー コントローラがテイクオーバーします。SnapMirrorアクティブ同期のフェイルオーバーは発生しません。 |
影響なし。VMはテイクオーバー中にI/Oを一時的に停止します。 |
サイトBに障害が発生 |
クラスタAは引き続きデータを提供します。サイトBが復旧すると、レプリケーションが再開されます。 |
サイトAのノードとQDeviceはクォーラムを維持します。HAは、サイトAのノード上でサイトBのVMを再起動します。 |
サイト間リンクの障害 |
クラスタAは引き続きデータを提供します。フェイルオーバーは発生しません。 |
タイブレーカーがプライマリクラスタと一致した場合、QDeviceはサイトAパーティションに投票します。サイトBのノードはクォーラムを失って自己フェンシングを行い、HAはサイトAでそれらのVMを再起動します。 |
サイトCに障害が発生するか、クラスタがNetApp Consoleへのアクセスを失う |
レプリケーションはデータ損失なしで継続されますが、メディエーターが利用可能になるまでは、自動および計画的なフェイルオーバーは実行できません。ONTAP Cloud Mediatorを使用する場合、サイトCの障害はQDeviceにのみ影響します。 |
クラスターは、4つのノードの投票によってクォーラムを維持します。影響を受けるVMはありません。 |
1つのProxmox VEノードで障害が発生 |
影響はありません。 |
HAは、そのノード上のVMを他のノード上で再起動し、同じサイト内のノードを優先します。 |
ストレージシステム障害
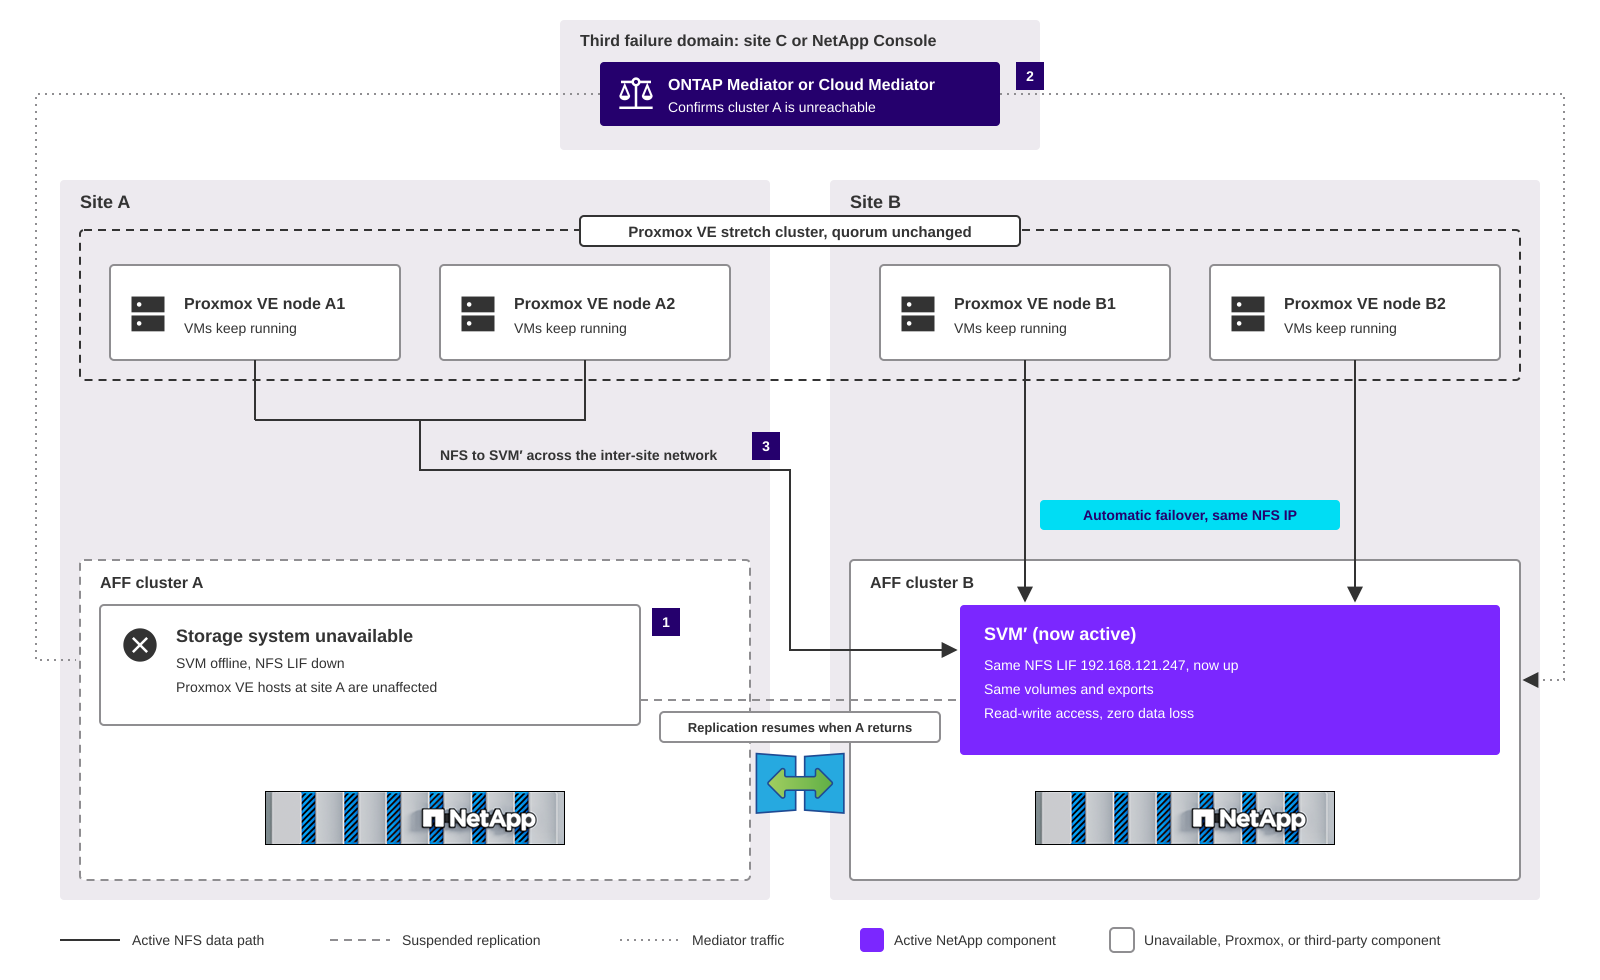
ストレージシステム障害は、ホストレベルのHAだけでは対処できないケースであり、SnapMirrorアクティブ同期がサービスプロバイダに最大の価値をもたらすケースでもあります。次の図は、NFS共有ストレージを使用するすべてのProxmox VEノードがオンライン状態を維持している間にAFFクラスタAに障害が発生したあとの状態を示しています。
-
AFFクラスタAが利用できなくなります。サイトAのProxmox VEノードは稼働し続けるため、クラスタはクォーラムを失わず、HAもどのノードもフェンスしません。
-
メディエーター(サイトCのONTAP Mediator、またはNetApp ConsoleのONTAP Cloud Mediator)がクラスタAに到達できないことを確認すると、ONTAPは同じNFS LIFアドレス、ボリューム、エクスポートポリシーを使用してクラスタBのセカンダリSVMをアクティブ化します。
-
すべてのProxmox VEノードは、同じ共有ストレージ上でI/Oを再開します。サイトBのノードはローカルでクラスターBに接続し、サイトAのノードはサイト間ネットワークを介してクラスターBに接続します。VMはフェイルオーバー中にI/Oを一時停止し、再起動せずに実行を継続します。
クラスタAが復旧すると、レプリケーションが再開されます。サイトAのVMが再びローカルストレージにアクセスできるように、メンテナンス期間中にクラスタAへのフェイルバックを計画してください。
サイト障害
サイト障害時には、そのサイトのストレージシステムとProxmox VEノードの両方がオフラインになります。ONTAPは共有ストレージを稼働中のクラスタにフェイルオーバーし、Proxmox VE HAは表に示されているように、障害が発生したサイトのVMを稼働中のノードで再起動します。
SnapMirror active sync と MetroCluster の選択
NetApp MetroCluster構成は、Proxmox VEストレッチクラスタに対してRPOゼロと自動リカバリも提供します。この2つのソリューションは、保護する対象が異なります:
-
*MetroClusterはすべてのワークロードを保護します。*MetroClusterは、アレイベースのクラスタリングと同期レプリケーションを組み合わせます。ミラーリングされたすべてのアグリゲート内のデータ、不揮発性メモリ(NVRAM)、および各SVMの構成をパートナーサイトにミラーリングするため、ワークロードごとのセットアップなしでクラスタ上のすべての共有ストレージが保護されます。
-
*SnapMirror active syncは、ワークロードの一部を保護します。*保護するSVMまたはボリュームを選択し、それぞれを独立してフェイルオーバーできます。保護されていないワークロードは、同じクラスタを共有できます。
どちらのソリューションも、保護対象データの完全なコピーを各サイトに保持し、第3の障害ドメインに監視サーバーを必要とし、ストレージコントローラにレプリケーション負荷を追加します。これらは、保護範囲、フェイルオーバーの粒度、およびクラスタ設計において異なります。
|
|
いずれかのソリューションを導入する前に、ONTAPのバージョン、MetroClusterまたはSnapMirrorアクティブ同期構成、およびProxmox VEのバージョンが"NetApp Interoperability Matrix Tool(IMT)"に一緒に記載されていることを確認してください。 |
Proxmox VEを使用したMetroClusterアーキテクチャ
次の図は、4ノードのMetroCluster IP構成とNFS共有ストレージを備えたProxmox VEストレッチクラスタを示しています。
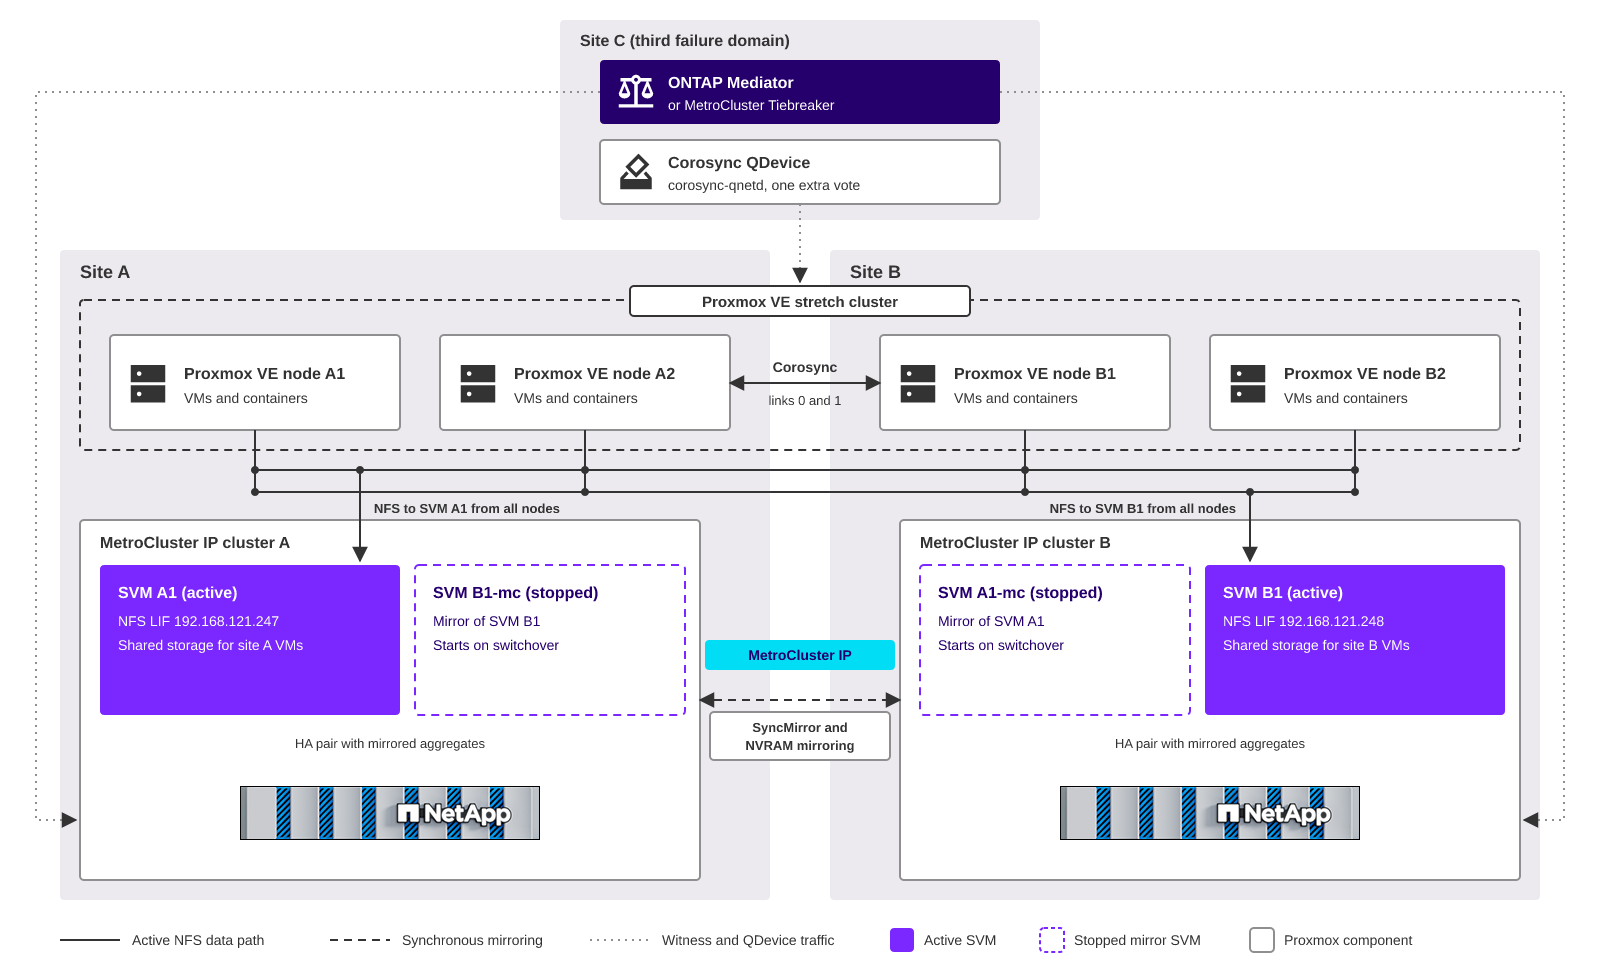
- MetroCluster IPクラスタ
-
各サイトには、ミラーリングされたアグリゲートを備えたHAペアがあります。MetroCluster IPバックエンドネットワークは、データ(SyncMirror)とNVRAMをパートナーサイトに同期的にミラーリングします。
- 両サイトのSVM
-
各サイトは独自のSVMを提供できます。各SVMについて、MetroClusterは、パートナーサイトに同じ構成とLIFアドレスを持つ、 `-mc`サフィックスが付いた停止状態のミラーSVMを保持します。
- すべてのノードからのNFSアクセス
-
Proxmox VEの各ノードは、アクティブなSVMであるSVM A1とSVM B1の両方の共有ストレージをマウントするため、HA機能によりどのノード上のどのVMでも再起動できます。サイトBのノードはサイト間ネットワークを介してSVM A1に到達し、サイトAのノードはSVM B1に到達します。これは、SnapMirrorアクティブ同期と同じアクセスモデルです。
- スイッチオーバー
-
サイト障害が発生した場合、サイトCのONTAP MediatorまたはMetroCluster Tiebreakerによって自動スイッチオーバーが有効になります。稼働中のサイトのミラーSVMが起動して同じNFSアドレスですべての共有ストレージを提供し、Proxmox VE HAが障害が発生したサイトのVMを再起動します。単一のコントローラ障害は、スイッチオーバーを行わずに、ローカルHAのテイクオーバーによって処理されます。障害が発生したサイトを修復したあと、アグリゲートを修復してスイッチバックします。
MetroClusterが障害に対応する仕組み
次の表は、MetroCluster IP構成とProxmox VEストレッチクラスタが、[ソリューションが障害にどのように対応するか] と同じ障害にどのように対応するかを示しています。この例では、SVM A1はサイトAでアクティブであり、SVM B1はサイトBでアクティブです。
| イベント | ONTAPの動作 | Proxmox VEの動作 |
|---|---|---|
サイトAに障害が発生 |
ONTAP MediatorまたはMetroCluster Tiebreakerが障害を確認し、ONTAPがサイトAをスイッチオーバーします。SVM A1-mcは、同じNFS LIFアドレスを使用してサイトBで起動します。SVM B1はデータの提供を継続します。 |
サイトBのノードとQDeviceはクォーラムを維持します。HAはサイトAのノードをフェンスし、サイトBのノード上でそれらのVMを再起動します。サイトBのノードで既に稼働していたVMは引き続き稼働し、SVM A1上のVMは切り替え後にI/Oを再開します。 |
MetroCluster IPクラスタAに障害が発生しても、サイトAのProxmox VEノードは引き続き稼働する |
ONTAP MediatorまたはMetroCluster Tiebreakerは、クラスターAに到達できないことを確認し、ONTAPはサイトAをスイッチオーバーします。SVM A1-mcは、同じNFS LIFアドレスでサイトBで起動します。 |
クォーラムの変更もVMの再起動もありません。SVM A1上のVMはスイッチオーバー後にI/Oを再開し、サイトAのノードはサイト間ネットワークを介してサイトBに到達します。 |
サイトAのコントローラ1台が故障 |
サイトAのHAパートナーがローカルHAテイクオーバーでテイクオーバーします。スイッチオーバーは発生しません。 |
影響なし。VMはテイクオーバー中にI/Oを一時的に停止します。 |
サイトBに障害が発生 |
ONTAPはサイトBをスイッチオーバーします。SVM B1-mcは、同じNFS LIFアドレスを使用してサイトAで起動します。SVM A1はデータの提供を続けます。 |
サイトAのノードとQDeviceはクォーラムを維持します。HAはサイトAノード上でサイトBのVMを再起動し、サイトAにあるSVM B1にアクセスします。 |
サイト間リンクの障害 |
両方のクラスタがまだ稼働しているため、スイッチオーバーは発生しません。各サイトは引き続き独自のSVMを提供し、リンクが復旧するまでパートナーサイトへのミラーリングは一時停止されます。 |
タイブレーカーがサイトAと一致した場合、QDeviceはサイトAパーティションに投票します。サイトBノードはクォーラムを失い、自己フェンス状態になります。HAは、サイトAノード上のSVM A1でVMを再起動します。サイトAのノードがSVM B1に到達できないため、リンクが復旧するまでSVM B1上のVMは再起動できません。 |
サイトCで障害が発生 |
ミラーリングはデータ損失なしで継続されますが、Witnessが利用可能になるまで自動スイッチオーバーはできません。手動でスイッチオーバーすることは可能です。 |
クラスターは、4つのノードの投票によってクォーラムを維持します。影響を受けるVMはありません。 |
1つのProxmox VEノードで障害が発生 |
影響はありません。 |
HAは、そのノード上のVMを他のノード上で再起動し、同じサイト内のノードを優先します。 |
サイト間のリンク障害は、プライマリサイトが1つだけの設計との主な違いです。両方のサイトでアクティブなSVMがホストされている場合、MetroClusterまたは2つのSnapMirrorアクティブ同期SVMが反対方向に動作している場合、corosyncタイブレーカーは1つのサイトのみを優先できます。アクティブなSVMが別のサイトにあるVMは、リンクが復旧するまでダウンしたままになります。影響を最小限に抑えるため、冗長なサイト間リンクを別々の物理パスで使用し、最も重要なVMを、タイブレーカーが優先するサイトのSVM上に配置してください。
機能比較
| 考慮事項 | SnapMirror NAS 向けアクティブ シンク | MetroCluster IP |
|---|---|---|
保護範囲 |
選択されたSVMとボリューム |
構成内のすべてのミラーリングされたアグリゲートとすべてのSVM |
フェイルオーバーの粒度 |
各SVMは独立して |
スイッチオーバーによるサイト全体 |
保護されていないワークロード |
同じクラスタ内の保護されていないSVM上で実行する |
ミラーリングされていないアグリゲートを使用できます。これらは切り替え後にオフラインになり、オンラインに戻すまでオフライン状態になります。 |
クラスタ設計 |
IPネットワークを介してピアリングされた2つの独立したクラスタ |
専用のMetroCluster IPバックエンド ネットワークを備えた2つのパートナー クラスターの1つの構成 |
サイトCのWitness |
ONTAP MediatorまたはONTAP Cloud Mediator |
ONTAP MediatorまたはMetroCluster Tiebreaker |
保護されたデータのコピー |
各サイトに1つずつ |
各サイトに1つずつ、ミラーリングされたアグリゲート内 |
レプリケーションパス |
クラスタ間LIFを介したSnapMirror同期 |
SyncMirror と NVRAM ミラーリング(MetroCluster IP バックエンド ネットワーク経由) |
両サイトのNFSアドレス |
拡張レイヤ2 VLAN。BGP対応VIP LIF(認定待ち) |
拡張レイヤー2 VLAN、またはBGPを使用したVIP LIF |
サイト障害後のリカバリ |
各SVMをフェイルバックする |
アグリゲートを修復してから、サイトをスイッチバックしてください |
選定ガイダンス
-
ストレージ上のすべての、またはほぼすべてのワークロードでRPOをゼロにする必要がある場合は、MetroClusterを選択してください。たとえば、企業がクラスタ上でミッションクリティカルなVMのみを実行している場合や、サービスプロバイダがすべてのテナントに同じ可用性階層を提供している場合などです。ワークロードごとの設定なしで、1つの保護ドメインが提供されます。
-
一部のテナント向けのプレミアム階層など、ワークロードのサブセットのみにRPOゼロが必要な場合、または一度に1つのテナントまたはアプリケーションに対してフェイルオーバーやディザスタリカバリのテストを行う必要がある場合は、SnapMirror active syncを選択してください。
-
NAS向けのSnapMirrorアクティブ同期は、MetroCluster構成ではサポートされていません。クラスタの各ペアには、いずれか1つのソリューションを使用してください。
-
このソリューションにおけるcorosync、QDevice、およびHAに関するガイダンスは、どちらにも適用されます。MetroClusterを使用する場合、サイト間リンクに障害が発生したときにデータの提供を継続するサイトにQDeviceタイブレーカーを合わせ、HAノードアフィニティルールを使用してVMをアクティブなSVMと同じサイトに維持します。
-
MetroCluster IPは、サイト間のレイヤ3ネットワーク向けにBGPを使用したVIP LIFもサポートしています。
Proxmox VEストレッチクラスターにおけるCorosyncに関する考慮事項
Proxmox VEは、クラスタメンバーシップとクォーラムにcorosyncを使用します。Corosyncは、SnapMirror active syncよりもサイト間ネットワークの影響を受けやすいため、まずクラスタネットワークを計画してください。
レイテンシとネットワーク設計
-
SnapMirrorアクティブ同期には、クラスタ間の往復時間(RTT)が10 ms未満である必要があります。Proxmoxは、すべてのノード間のcorosyncレイテンシを5 ms未満にすることを推奨しているため、corosyncの要件がソリューションの距離制限を決定します。
-
Corosyncは、高い帯域幅よりも、低く安定したレイテンシを必要とします。ストレージのバーストによってcorosyncのタイムアウトが発生しないように、ストレージやライブマイグレーションのトラフィックとは別に、corosync専用のネットワークを使用してください。
-
サイト間の別々の物理パス上に、少なくとも2つのcorosyncリンク(例えば、リンク0とリンク1)を設定してください。CorosyncはKronosnetを使用して、いずれかのパスに障害が発生した場合に自動的にリンクを切り替えます。
第三サイトのQDeviceとのクォーラム
Proxmox VEノードをサイトAとサイトBに均等に分散させ、サイトCにQDeviceを追加します。4つのノードと1つのQDeviceでクラスタは5票を持ち、クォーラムには3票が必要となるため、どちらかのサイトで障害が発生してもクォーラムは失われません。QDeviceはTCPポート5403経由でクラスタに接続し、corosyncのような低レイテンシの要件がないため、サイトCをONTAP Mediatorと共有できます。ONTAP Cloud Mediatorを使用する場合でも、QDevice用に3つ目の場所が必要になりますが、Mediatorをホストしない小規模なLinuxホストを使用することもできます。
プライマリクラスタとのタイブレーカーアライメント
サイト間リンクに障害が発生しても、両方のサイトがサイトCに到達できる場合、ONTAPはサイトAのプライマリクラスタでデータの提供を継続します。QDeviceは同じサイトに投票する必要があります。デフォルトでは、QDeviceはノードIDが最も小さいパーティションを選択します。
ベストプラクティス: サイトAのノードでProxmox VEクラスタを作成し、サイトBのノードを参加させる前に他のサイトAのノードを参加させて、サイトAが最も小さいノードIDを保持するようにします。プライマリストレージが長期間サイトBに移動する場合は、QDevice `tie_breaker`の設定をサイトBのノードIDに更新します。
QDeviceがサイトBを優先した場合、サイトAのノードは自己フェンスを行い、HAはサイトAのアクティブストレージにアクセスできないサイトBノード上のVMを再起動します。
HAの動作とVMの配置
-
Proxmox VE HAは通常、障害が発生したノードを検出し、60秒のウォッチドッグフェンシングタイムアウトを含めて約2分でVMを復旧します。サイト障害時には、SnapMirror active syncのフェイルオーバーとProxmox VE HAのリカバリが並行して実行されます。
-
HA ノードアフィニティルールとノード優先度を使用して VM をプライマリストレージと同じサイトのノードに配置し、別のサイトにフェイルオーバーできるようにします。
-
サイトのフェイルオーバー後、ストレージをフェイルバックするまで、影響を受けるVMのHA `failback`プロパティを `0`に設定します。そうしないと、アクティブなストレージがまだサイトBにあるにもかかわらず、サイトAのノードが復旧し次第、HAがVMをサイトAのノードに移行してしまいます。
-
ゲストOSのディスクタイムアウトを、想定されるフェイルオーバー時間よりも長く設定してください。そうすることで、ストレージフェイルオーバー中にゲストOSがI/Oエラーを報告しなくなります。
Proxmox用ストレージマネージャーとの統合
Storage Manager for Proxmox (SMP) は、Proxmox VE 管理者に、ONTAP 共有ストレージをプロビジョニングし、ONTAP スナップショットと FlexClone テクノロジを使用して VM のバックアップ、リストア、クローン作成を行うための単一のインターフェイスを提供します。SMP は API を介して Proxmox VE クラスタおよび ONTAP に接続するため、Proxmox VE ノードにエージェントを配置する必要はありません。
SMPとSnapMirror active syncは、異なる種類の障害から保護します。SnapMirror active syncは、ストレージ障害やサイト障害が発生してもVMの実行を継続させますが、誤った削除、ゲストの更新失敗、ランサムウェアによって暗号化されたデータなど、すべての書き込みを同期的にレプリケートします。SMPスナップショットは、これらの論理障害からリカバリするためのポイントインタイムコピーを提供します。これらを組み合わせることで、同じONTAPストレージから継続的な可用性と迅速な運用リカバリを提供します。
| 保護層 | から保護します | リカバリ ポイント | 管理元 |
|---|---|---|---|
SnapMirrorアクティブ同期 |
ストレージシステム障害およびサイト障害 |
データ損失ゼロ |
ONTAP |
SMPバックアップ(ONTAPスナップショット) |
誤削除、データ破損、アップデートの失敗、ランサムウェア |
最後にスケジュールされた、またはオンデマンドのバックアップ |
SMP |
SnapMirror非同期ファンアウトまたはProxmox Backup Server |
両サイトの喪失と長期保持 |
最後のレプリケーションまたはバックアップ |
ONTAPまたはProxmox Backup Server |
バックアップとリカバリ
SMPは、オンデマンドまたはポリシーに基づいて、ストレージボリュームのONTAPスナップショットとして「crash consistent state(障害など予期しないシャットダウン時と同様)」の状態またはファイル整合性のあるバックアップを作成し、個々のVM、ストレージ、またはリソースグループを復元します:
-
リソースグループとバックアップポリシーを使用して、テナントまたはアプリケーションの仮想マシンに同じスケジュールと保持期間を適用します。
-
QEMUゲストエージェントを実行するVMにはファイル整合性バックアップを使用し、ONTAPがスナップショットを作成する前にゲストファイルシステムが静止されるようにします。
-
SMPはアクティブなストレージを管理します。SnapMirrorアクティブ同期のフェイルオーバー後、バックアップまたはリストア操作を実行する前に、SMPで検出を実行してストレージをクラスタBにマッピングします。
-
2つのサイト以外の3番目のコピー、またはより長い保存期間が必要な場合は、保護対象ボリュームからSnapMirror非同期ファンアウト関係を追加するか、Proxmox Backup Serverを使用してください。
-
改ざん防止スナップショットはSnapMirrorアクティブ同期ではサポートされていないため、保護対象ボリュームのSMPでスナップショットロックを有効にしないでください。
VMのクローニング
SMPは、ONTAP FlexCloneテクノロジを使用して、開発、テスト、および迅速なプロビジョニングのためのスペース効率に優れたVMクローンを作成します。保護されたストレージに作成したクローンは、両方のサイトでレプリケーションの帯域幅と容量を消費します。ビジネス継続性を必要としないクローンやテストストレージは、SnapMirrorアクティブ同期保護から除外してください。
SMPの配置
-
ストレージまたはサイト障害の発生後もSMPを引き続き利用できるように、SnapMirrorアクティブ同期で保護された共有ストレージ上のHAリソースとしてSMP VMを実行します。
-
SMPがどちらのサイトのアクティブストレージにもアクセスできるように、SMPにProxmox VEクラスタと両方のONTAPクラスタを登録します。
NAS向けSnapMirror active syncを備えたNFS共有ストレージ
ONTAP 9.19.1以降、SnapMirrorアクティブ同期はNASワークロードを保護します。以下の考慮事項は、NFS共有ストレージにのみ適用されます。NFSストレージを使用してソリューションを導入するには、"NASの設定ワークフロー"に従ってください。
SVMレベルの保護とネットワークID
-
SnapMirror active sync for NASは、ストレージVM(SVM)全体を保護します。SVM内のすべてのボリュームを保護することも、選択したボリュームを除外することもできます。サポートされるのはFlexVolボリュームのみであり、SVMにLUNを含めることはできません。
-
セカンダリSVMは、フェイルオーバーが発生するまで、LIFがダウンした状態で休止状態を維持します。ONTAPは、LIF IPアドレス、エクスポートポリシー、NFS設定などのSVM構成を複製するため、フェイルオーバー後もセカンダリSVMは同じNFSエンドポイントを提供します。
-
NFSv3以降では、フェイルオーバーは中断を伴いません。
-
SnapMirror NASのアクティブ同期はアクティブ / パッシブであるため、サイトBノード上のVMは、サイト間ネットワークを介してプライマリSVMとの間で読み書きを行います。両サイトでアクティブなワークロードを実行する場合は、レプリケーション方向が逆の2つのSVMを使用し、各サイトに1つずつプライマリSVMを配置し、各VMのノードアフィニティルールをプライマリSVMのサイトに合わせます。
-
NAS向けSnapMirrorアクティブ同期は、AFF AシリーズおよびCシリーズの2ノードクラスタでサポートされています。
NFSクライアント設定
NFSストレージにはNFSv3またはNFSv4.1を使用してください。デフォルトのハードマウント動作を維持し、フェイルオーバー中にNFS I/Oが失敗する代わりに再試行されるように、 `soft`マウントオプションは追加しないでください。
パフォーマンスと耐障害性を向上させるため、ストレージへのTCP接続を複数使用してください。nConnectまたはセッショントランキングのいずれかを使用し、両方は使用しないでください:
-
*nConnect.*単一の NFS LIF アドレスへの複数の TCP 接続を開きます(例:
nconnect=4)。nConnect は NFSv3 および NFSv4.1 と単一の VIP LIF アドレスで動作するため、レイヤ 3 ネットワークを含む NAS 向け SnapMirror アクティブ同期に推奨されるオプションです。 -
*セッショントランキング。*複数のデータLIFを1つのNFSv4.1セッションにグループ化します(たとえば
vers=4.1,trunkdiscovery,max_connect=16)。セッショントランキングにはNFSv4.1以降が必要です。保護対象のSVMに、拡張レイヤー2ネットワークなど、クライアントが両方のサイトからアクセスできる複数のデータLIFがある場合にのみ使用してください。詳細については、"NFSトランキング"を参照してください。
マウントオプションのコマンドと検証手順については、"Proxmox VEのNFSストレージを構成する"を参照してください。
SMPを使用したNFSストレージ プロビジョニング
SMPはONTAPボリュームをプロビジョニングし、エクスポートポリシーを作成または選択して、選択したProxmox VEノードにNFS共有ストレージとしてボリュームをマウントします。保護されたSVM内のストレージの場合:
-
プライマリSVMにボリュームをプロビジョニングし、NFS LIF、またはレイヤー3ネットワークの場合はVIP LIFを優先LIFとして選択します。セカンダリSVMはフェイルオーバー後も同じアドレスを使用するため、ストレージ定義は有効なまま維持されます。
-
HAがどのノードでもVMを再起動できるように、両サイトのすべてのProxmox VEノードにストレージをマウントしてください。
-
エクスポートポリシーで、両サイトのProxmox VEノードが許可されていることを確認してください。ONTAPはエクスポートポリシーをセカンダリSVMに複製します。
-
プロビジョニング後、ボリュームがSnapMirrorアクティブ同期保護に含まれていることを確認します。
VIP LIFとBGPを備えたレイヤ3ネットワーク
SnapMirrorのNAS向けアクティブ同期には、プライマリSVMとセカンダリSVMで同じIPアドレスが必要です。NFS VLANがサイト間で拡張されている場合、LIF IPアドレスはSVMとともに移動します。サイトがルーティングされたレイヤ3ネットワークで接続されている場合、サイトAのLIFのサブネットはサイトBには存在しません。

|
発行時点では、NetApp は NAS 向け SnapMirror アクティブ同期の認定構成として、BGP を使用した VIP LIF を文書化していません。レイヤ 3 設計を計画する前に、NetApp に現在のサポート状況を確認してください。それ以外の場合は、サイト間で NFS VLAN を拡張してください。MetroCluster IP 構成は、BGP を使用した VIP LIF をサポートしています。 |
ONTAP仮想IP(VIP)LIFはこの問題を解決します。VIP LIFはどのサブネットにも属しません。ONTAPは、ボーダーゲートウェイプロトコル(BGP)を使用してVIPアドレスを/32ホストルートとしてピアルータにアドバタイズするため、VLANを拡張することなくアドレスをサイト間で移動させることができます。
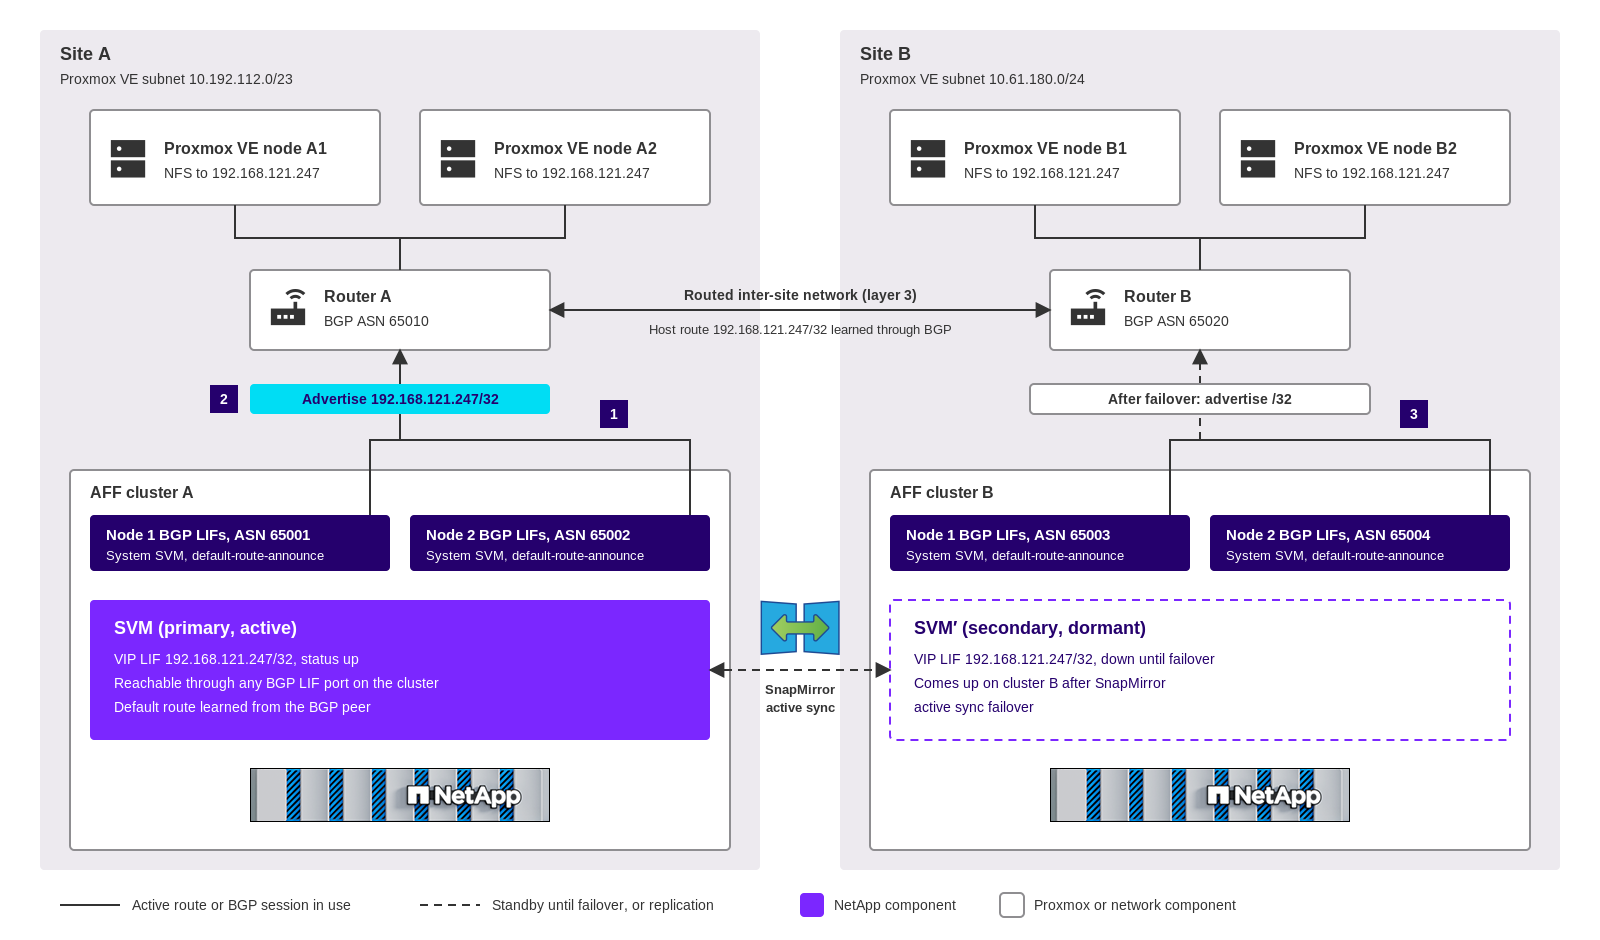
-
両サイトの各ノードは、システムSVM内にBGP LIFを持ち、それぞれのサイトのルーターとピアリング接続を確立しています。BGP LIFはノード固有のものであり、複製されないため、両方のクラスタで設定する必要があります。
-
プライマリSVMはNFS VIP LIFをホストします。クラスターAは/32ホストルートをアドバタイズし、両サイトのProxmox VEノードはルーティングされたネットワークを介してストレージにアクセスします。
-
SnapMirrorアクティブ同期フェイルオーバーが発生したあと、セカンダリSVM上でVIP LIFが起動し、クラスタBがホストルートをアドバタイズし、ルーターがサイトBに収束します。
ONTAPで初めてBGPを計画する際、どのSVMが各LIFを所有しているかを知っておくと役立ちます。BGP LIFは、データSVMではなく、IPspaceのシステムSVMに属します。各クラスタ上の1組のBGP LIFが、そのIPspace内のすべてのデータSVMのVIP LIFを処理するため、テナントごとにBGP LIFを作成する必要はありません。次の図は、VLANポート上にBGP LIFが配置された、1つのクラスタにおけるLIFとポートのレイアウトを示しています。
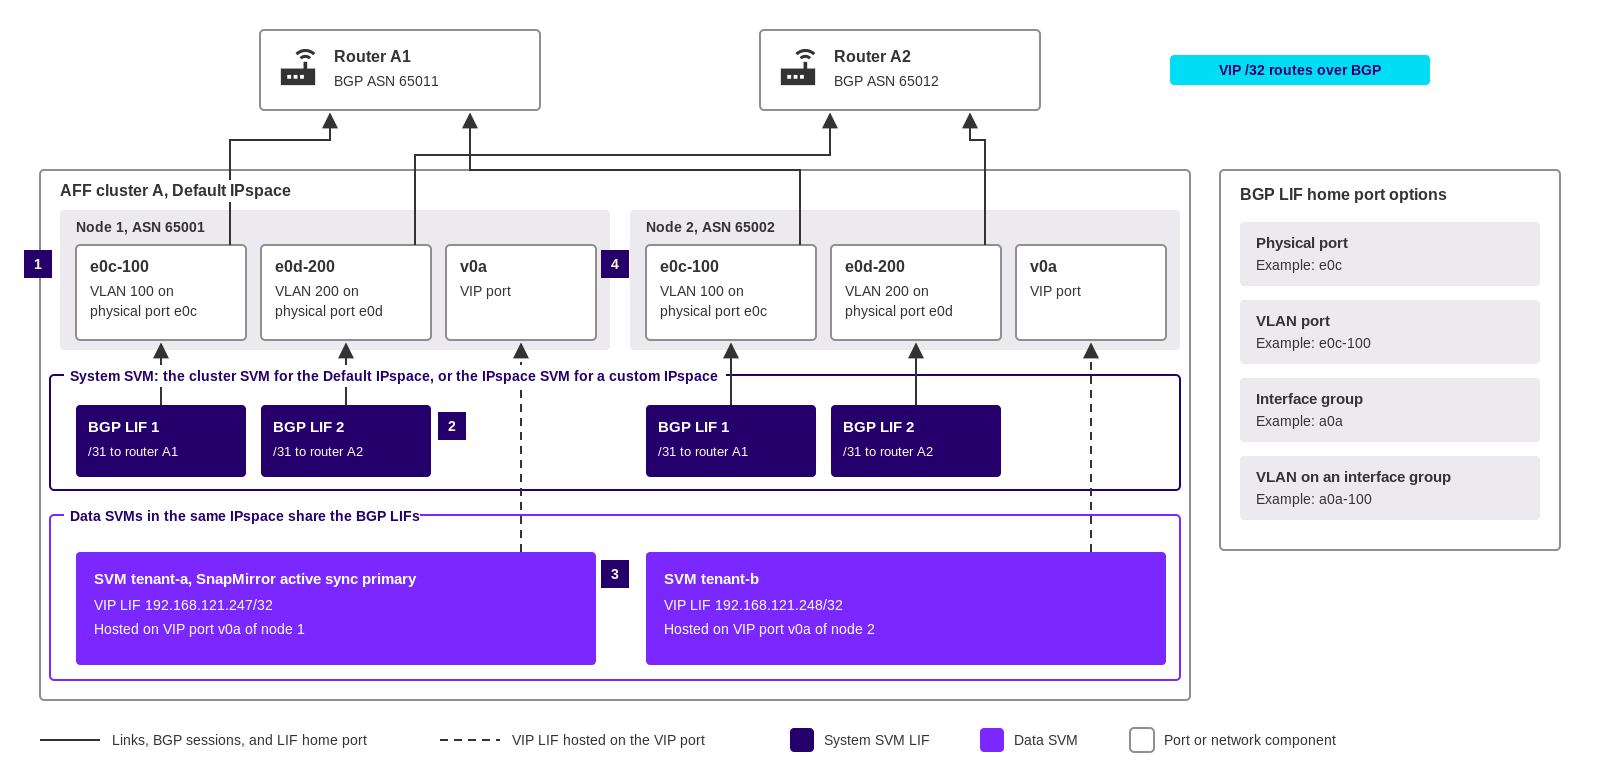
-
各ノードにはBGP用のポートが2つあります。この例ではVLANポート `e0c-100`および `e0d-200`です。各ポートはそれぞれ異なるルーターに直接接続されます。
-
各ノードはシステムSVM内に2つのBGP LIFを持ち、各ポートに1つずつ配置され、/31サブネットと1つのルータへのBGPピアグループが設定されています。デフォルトのIPspaceの場合、システムSVMはクラスタSVMです。カスタムIPspaceの場合、IPspaceと同じ名前のSVMです。
-
同じIPspace内のデータSVMはVIP LIFをホストし、独自のBGP LIFは必要ありません。BGPピアグループは、IPspace内のすべてのSVMに対してVIPルートをアドバタイズします。
-
最初のBGPピアグループを作成すると、ONTAPは各ノードにVIPポート(たとえば `v0a`など)を作成します。VIP LIFはVIPポートでホストされ、IPspace内でBGP LIFをホストするノード上のすべてのポートからアクセスできます。
BGP LIFのホームポートは、物理ポート、VLANポート、インターフェースグループ、またはインターフェースグループ上のVLANのいずれかになります。インターフェースグループは必須ではありません。NetApp技術報告書TR-4949では、各IPspaceに対して2つの別々のポートに2つのBGP LIFを設定し、それぞれを異なるファーストホップルータに直接接続することを推奨しています。
次のガイドラインに注意してください。
-
BGP LIFはフェイルオーバーしません。冗長性は、ノードごとに2つのBGP LIFが存在し、それぞれが異なるルーターとピアリングすることで実現されます。ノードがSVMのすべてのBGPセッションを失った場合、ONTAPはVIP LIFを、そのSVMに対してアクティブなBGPセッションを持つ別のノードに移動します。
-
各ONTAPノードと各ルーターに、固有のプライベート自律システム番号(ASN)を持つ外部BGP(eBGP)を使用します。
-
各BGP LIFとそのルーターには、/31サブネット(ネットマスク255.255.255.254)を使用してください。奇数番のアドレスをBGP LIFに、偶数番のアドレスをルーターに割り当ててください。
-
ONTAPはルーターからのルートを処理しません。ONTAPからの/32ホストルートを受け入れ、クラスタにルート更新を送信しないようにルーターを設定します。
-
Proxmox VEノードは、VIPアドレスと同じサブネットを共有してはなりません。ノードとストレージ間の経路には、例えばVRRPやHSRPを備えた冗長なレイヤー3ルーターを設置する必要があります。
-
各クラスタがローカルルータからデフォルトルートを学習するように、 `-use-peer-as-next-hop true`を使用してBGPピアグループを設定します。サイトAのゲートウェイを指すルートは、フェイルオーバー後のサイトBでは無効になります。
-
マルチパスルーティングを有効にして、送信VIPトラフィックが利用可能なすべてのBGP LIFポートを使用するようにします。
-
BGPのホールド時間をデフォルトの180秒から短縮します。TR-4949では、3秒のホールド時間を推奨しています。ルーターが障害の発生したクラスターからルートを取り消すのは、ホールドタイマーが満了したときのみであり、ストレージシステム障害の発生中もサイトAのルーターはオンライン状態を維持します。