


Active IQ Unified Manager에서 클러스터의 MetroCluster 성능 이벤트 분석
 변경 제안

 PDF

Unified Manager를 사용하여 성능 이벤트가 감지된 MetroCluster 구성의 클러스터를 분석할 수 있습니다. 클러스터 이름, 이벤트 감지 시간, 그리고 관련된 가해 및 피해 워크로드를 확인할 수 있습니다.
-
운영자, 애플리케이션 관리자 또는 스토리지 관리자 역할이 있어야 합니다.
-
MetroCluster 구성에 대한 신규, 확인된 또는 사용되지 않는 성능 이벤트가 있어야 합니다.
-
MetroCluster 구성의 두 클러스터 모두 동일한 Unified Manager 인스턴스에서 모니터링되어야 합니다.
-
이벤트에 대한 정보를 보려면 이벤트 상세 정보 페이지를 표시하십시오.
-
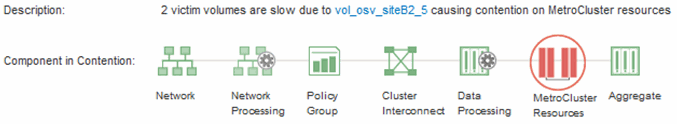
이벤트 설명을 검토하여 관련된 워크로드 이름과 워크로드 수를 확인하십시오.
이 예시에서 MetroCluster 리소스 아이콘이 빨간색으로 표시된 것은 MetroCluster 리소스에 경합이 발생했음을 나타냅니다. 아이콘 위에 커서를 놓으면 아이콘에 대한 설명이 표시됩니다.
-
클러스터 이름과 이벤트 감지 시간을 기록해 두면 파트너 클러스터의 성능 이벤트를 분석하는 데 사용할 수 있습니다.
-
차트에서 피해 워크로드를 검토하여 응답 시간이 성능 임계값보다 높은지 확인하십시오.
이 예시에서는 마우스 오버 시 텍스트에 피해 워크로드가 표시됩니다. 지연 시간 차트는 관련된 피해 워크로드의 일관된 지연 시간 패턴을 개략적으로 보여줍니다. 피해 워크로드의 비정상적인 지연 시간이 이벤트 발생의 원인이 되었더라도, 일관된 지연 시간 패턴은 워크로드가 예상 범위 내에서 작동하고 있음을 나타낼 수 있으며, 단지 I/O 급증으로 인해 지연 시간이 증가하여 이벤트가 발생했을 가능성을 시사합니다.
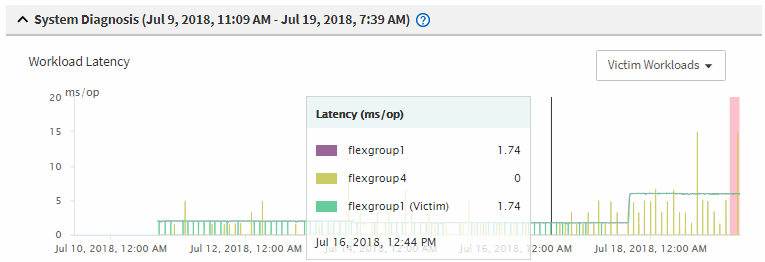
최근 이러한 볼륨 워크로드에 액세스하는 클라이언트에 애플리케이션을 설치했고 해당 애플리케이션이 워크로드에 많은 양의 I/O를 전송하는 경우, 지연 시간이 증가할 것으로 예상할 수 있습니다. 워크로드의 지연 시간이 예상 범위 내로 돌아오고 이벤트 상태가 폐기됨으로 변경되어 이 상태로 30분 이상 유지되는 경우, 해당 이벤트를 무시해도 됩니다. 이벤트가 계속 진행 중이고 새 상태로 유지되는 경우, 추가로 조사하여 다른 문제로 인해 이벤트가 발생했는지 확인할 수 있습니다.
-
워크로드 처리량 차트에서 *Bully Workloads*를 선택하여 Bully 워크로드를 표시합니다.
과부하 워크로드가 존재한다는 것은 로컬 클러스터의 하나 이상의 워크로드가 MetroCluster 리소스를 과도하게 사용하여 이벤트가 발생했을 수 있음을 나타냅니다. 과부하 워크로드는 쓰기 처리량(MB/s)에서 높은 편차를 보입니다.
이 차트는 워크로드의 쓰기 처리량(MB/s) 패턴을 개략적으로 보여줍니다. 쓰기 MB/s 패턴을 검토하여 비정상적인 처리량을 파악할 수 있으며, 이는 워크로드가 MetroCluster 리소스를 과도하게 사용하고 있음을 나타낼 수 있습니다.
이벤트에 과도한 워크로드가 관련되어 있지 않다면, 클러스터 간 링크의 상태 문제 또는 파트너 클러스터의 성능 문제로 인해 발생했을 수 있습니다. Unified Manager를 사용하여 MetroCluster 구성에서 두 클러스터의 상태를 확인할 수 있습니다. 또한 Unified Manager를 사용하여 파트너 클러스터의 성능 이벤트를 확인하고 분석할 수 있습니다.