


了解使用 SnapMirror 主动同步的 Proxmox VE 业务连续性

 建议更改

 PDF

在 Proxmox 虚拟环境(VE)上运行关键业务虚拟机(VM)的企业,以及在 Proxmox VE 上托管客户 VM 的服务提供商,都需要这些 VM 在存储系统或整个数据中心离线时继续运行。ONTAP SnapMirror 活动同步会同步复制跨两个站点的 Proxmox VE 集群的共享存储,并自动将存储故障转移到正常运行的站点。您可以获得零恢复点目标(RPO)、无需脚本或 runbook 的自动恢复,以及两个站点上相同的共享存储,因此 Proxmox VE 高可用性(HA)可以在不进行任何存储重新配置的情况下重新启动 VM。对于 NFS 共享存储,该解决方案使用用于 NAS 的 SnapMirror 活动同步。
客户挑战
仅使用原生工具为 Proxmox VE 构建存储和站点弹性非常困难:
-
*站点故障后数据丢失。*Proxmox VE 存储复制和 Proxmox Backup Server 是异步的。主站点发生故障时,自上次复制或备份以来所做的更改将丢失。
-
*手动,恢复速度慢。*在辅助站点恢复通常意味着提升副本,在不同地址下挂载存储,更新
/etc/pve/storage.cfg,以及重新启动虚拟机。每个手动步骤都会增加停机时间以及在中断期间出错的风险。 -
*与虚拟机竞争主机资源的延伸存储。*超融合延伸存储(例如处于延伸模式的 Ceph)在 Proxmox VE 节点上运行,并在每个站点保留每个对象的两个副本。复制、恢复和重新平衡流量会消耗运行虚拟机的相同节点上的 CPU、内存和网络资源。
-
*必须保持一致的两个仲裁决策。*任何双站点设计都需要在第三个故障域中为 Proxmox VE 集群和存储提供见证节点。如果集群和存储在站点间链路故障后选择了不同的幸存站点,则 VM 将在无法访问活动存储的节点上重新启动。
-
*必须在两个站点上都可用的存储地址。*在存储故障切换后,Proxmox VE 节点必须通过相同地址访问共享存储。该地址必须在两个站点上都可访问,这通常意味着在站点之间延伸的第 2 层 VLAN。
服务提供商面临的挑战
在 Proxmox VE 上构建云服务的服务提供商也面临同样的挑战,此外还要满足租户服务级别协议(SLA):
-
*存储系统是共享的故障点。*Proxmox VE HA 保护租户虚拟机免受主机故障的影响,但不能使其免受托管其磁盘的存储系统故障的影响。一次存储中断会影响该系统上的每个租户。
-
*无法销售更高的可用性。*如果没有同步复制和自动存储故障转移,提供商就无法提供零数据丢失和更强正常运行时间承诺的高级可用性层。
-
*恢复过程中的租户隔离。*恢复、维护和灾难恢复测试必须仅影响相关租户,而不是整个平台。
企业挑战
将关键任务工作负载从其他虚拟机管理程序转移到 Proxmox VE 的企业希望拥有与以前相同的站点弹性,例如数据库和业务线应用程序的零数据丢失以及无需手动运行手册的恢复。仅使用 Proxmox VE 原生工具满足这一期望就需要大量的设计、脚本和运维工作。
解决方案概述
该解决方案将 Proxmox VE 延伸集群与 SnapMirror 主动同步(位于两个站点的 NetApp AFF 系统上)相结合:
-
*零 RPO。*ONTAP 将对共享存储的每次写入从站点 A 的主集群同步复制到站点 B 的辅助集群。
-
*两个站点使用相同的共享存储。*故障转移后,辅助集群向 Proxmox VE 提供相同的存储,因此
/etc/pve/storage.cfg中的存储定义保持有效。 -
*自动故障转移。*调解器在两个站点之外充当见证者。您可以在第三个站点安装 ONTAP Mediator,也可以使用托管在 NetApp Console 中的 ONTAP Cloud Mediator 服务。当主存储或站点发生故障时,ONTAP 会故障转移到站点 B,而无需人工干预。
-
*精细控制。*您可以选择要保护的工作负载,并且可以单独故障转移工作负载,例如移动一个租户或应用程序进行站点维护。
-
*二级副本的使用。*您可以克隆二级副本以进行开发、测试或灾难恢复测试,而不会影响复制。
解决方案如何应对挑战
| 挑战 | 解决方案如何提供帮助 | 您仍在计划的内容 |
|---|---|---|
数据丢失和手动恢复 |
同步复制可实现零 RPO。ONTAP 会自动进行故障转移,并且辅助 SVM 会提供相同的 NFS 地址,因此 `/etc/pve/storage.cfg`保持有效。 |
Proxmox VE HA 仍会从故障站点重新启动虚拟机。 |
主机上的延伸存储 |
复制在 AFF 控制器上运行,而不是在 Proxmox VE 节点上运行,因此主机 CPU、内存和网络仍然可用于虚拟机。ONTAP 在每个站点保留一个副本,存储效率适用于两个副本。 |
与任何同步复制一样,解决方案需要在站点 B 提供完整的第二个副本,并且复制会向两个 AFF 群集添加负载。为复制工作负载调整两个群集的大小。 |
两个仲裁决定 |
ONTAP Mediator 或 ONTAP Cloud Mediator 作为 NetApp Console 中的服务,是数据路径之外的轻量级见证。此解决方案演示如何将 corosync QDevice 与主集群对齐,以便两者都选择相同的站点。 |
QDevice 仍然需要第三个位置。ONTAP Mediator 也需要它,但 ONTAP Cloud Mediator 不需要。请参阅 [调解器选项]。 |
两个站点的存储地址 |
辅助 SVM 接管相同的 NFS LIF 地址,因此无需重新挂载或重新配置存储。 |
NFS 子网必须在两个站点都可访问,通常使用延伸的第 2 层 VLAN。有关 VIP LIF 的资格状态,请参阅 具有 VIP LIF 和 BGP 的第 3 层网络。 |
下图显示了使用 NFS 共享存储的解决方案架构。
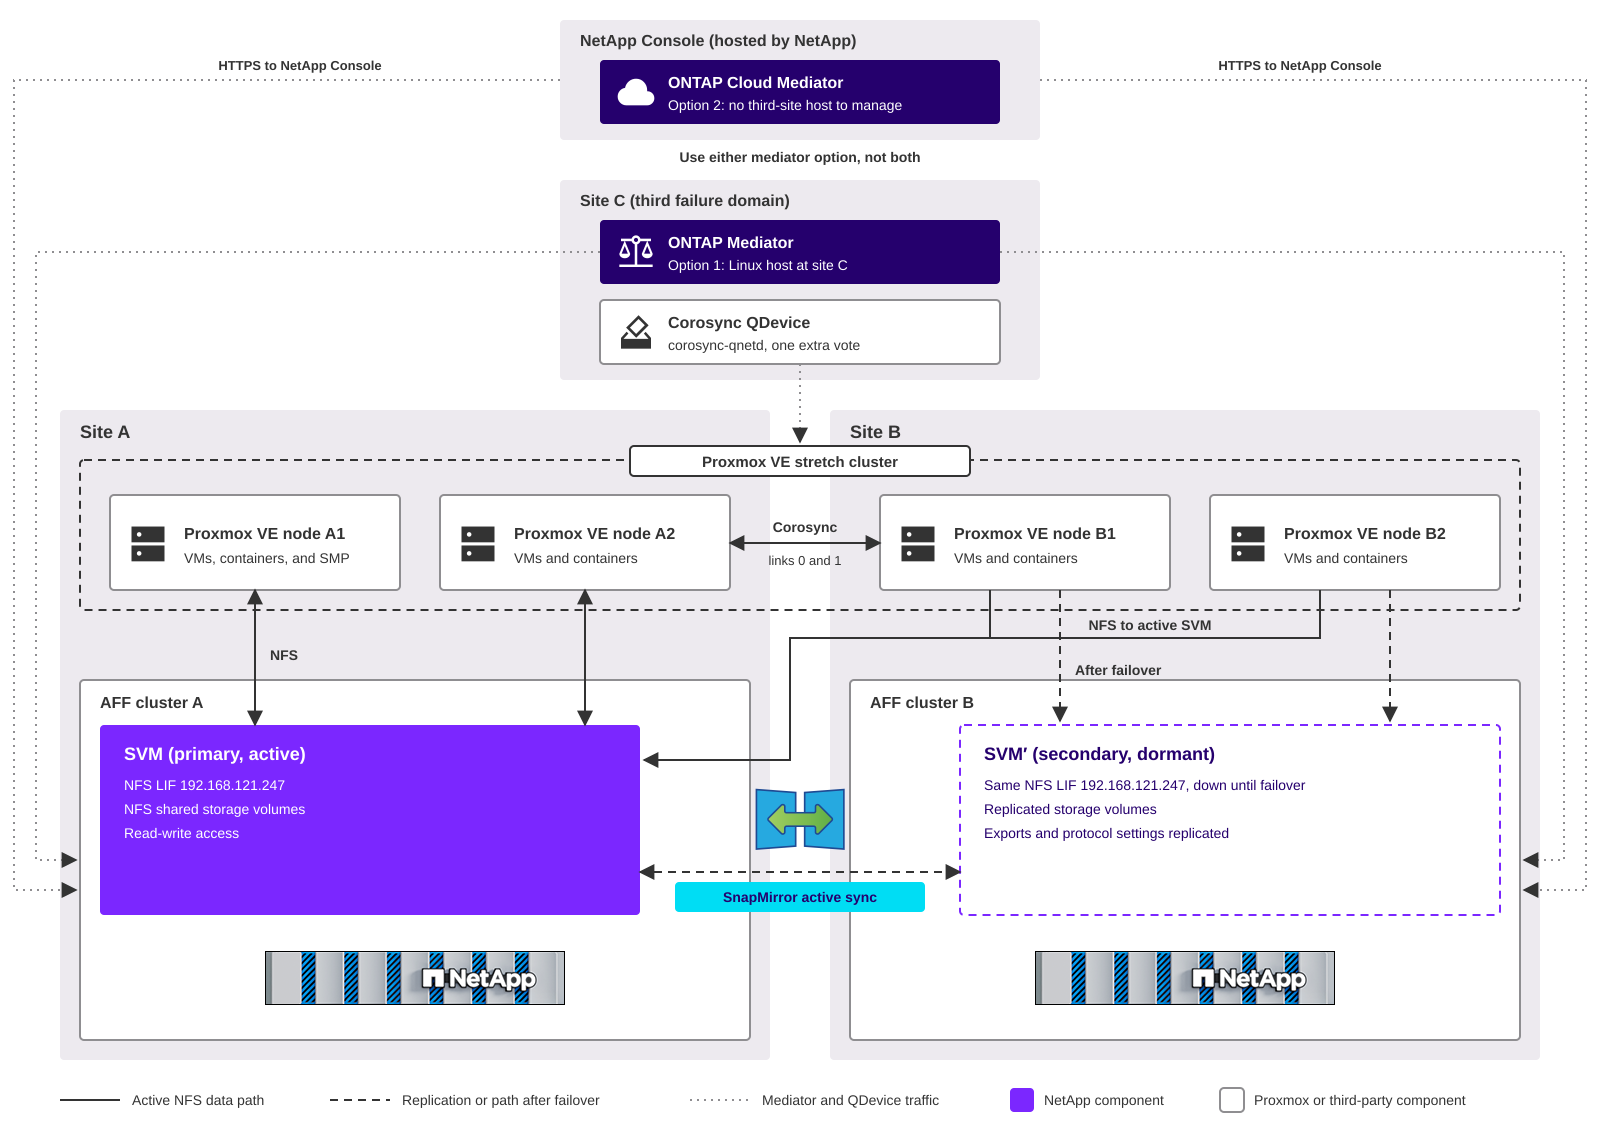
- 站点 A 和站点 B
-
每个站点都有一个 AFF 双节点集群和一半的 Proxmox VE 节点。站点 A 的主集群为所有 Proxmox VE 节点提供共享存储。站点 B 的节点通过站点间网络访问主集群。使用 NFS 存储,站点 B 的辅助 SVM 保持休眠状态,直到发生故障转移。
- 站点 C
-
第三个故障域托管 corosync QDevice 守护进程(
corosync-qnetd),如果选择选项 1,还托管 ONTAP Mediator。QDevice 提供额外的投票,以便 Proxmox VE 集群在一个站点出现故障时保持法定人数。 - NetApp Console
-
如果选择选项 2,ONTAP Cloud Mediator 将在 NetApp Console 中作为服务运行,该控制台由 NetApp 托管和管理。两个 AFF 集群均通过 HTTPS 连接到它,因此您无需安装或维护中介主机。
- 调解器
-
ONTAP 调解器或 ONTAP 云调解器可帮助 ONTAP 确定由哪个集群提供数据。请使用其中之一,而不是同时使用两者。有关比较,请参见 [调解器选项]。
- Proxmox VE 延伸集群
-
所有 Proxmox VE 节点都属于一个集群,并共享相同的存储定义。Proxmox VE HA 在幸存节点上重新启动来自故障站点的虚拟机。Storage Manager for Proxmox (SMP)在集群上作为 HA 虚拟机运行,以配置共享存储并备份、还原和克隆虚拟机。
调解器选项
SnapMirror 主动同步使用调解器作为被动见证。在网络分区或一个集群发生故障期间,ONTAP 使用调解器来决定哪个副本继续提供 I/O 服务。调解器不在数据路径中,也不会自行启动故障转移。您可以使用以下选项之一,但不能同时使用这两个选项。
| 注意事项 | 选项 1:ONTAP Mediator | 选项 2:ONTAP Cloud Mediator |
|---|---|---|
运行位置 |
您在第三个故障域(例如站点 C)中安装和管理的具有独立电源和网络基础架构的 Linux 主机。 |
NetApp Console 中的云服务。NetApp 托管和管理该服务,因此您不需要在第三个站点配置中介主机。 |
ONTAP 版本 |
适用于 NAS 的 SnapMirror 活动同步的 ONTAP 9.19.1 或更高版本。 |
ONTAP Cloud Mediator 从 ONTAP 9.17.1 开始提供。用于 NAS 的 SnapMirror 活动同步需要 ONTAP 9.19.1 或更高版本。 |
集群连接 |
这两个集群都连接到调解器主机。默认服务端口为 31784。 |
这两个集群都直接或通过 HTTP 代理,通过 HTTPS 出站连接到 NetApp Console。到 NetApp Console 的建议 ping 延迟低于 200 毫秒。 |
设置 |
在 Linux 主机上安装该软件包,然后使用主机地址和调解器用户将其添加到集群中。 |
创建具有 ONTAP Mediator Setup Role 的 NetApp Console 服务帐户,然后使用组织 ID、客户端 ID 和客户端密钥将 Mediator 添加到集群中。 |
操作 |
您对主机进行修补和升级,并保持其可用性。 |
没有要修补或升级的主机。您依赖于从两个站点访问互联网以及 NetApp Console 服务的可用性。 |
最佳匹配 |
具有第三个站点或不允许存储集群访问 Internet 的环境。 |
没有第三个站点用于部署调解器,或者希望避免运行调解器的环境。 |
选择时请记住以下几点:
-
*QDevice 仍然需要第三个位置。*ONTAP 云中介移除了中介主机,而不是 corosync QDevice 主机。QDevice 需要一个所有 Proxmox VE 节点都可以在 TCP 端口 5403 上访问的小型 Linux 主机,并且它没有 corosync 的低延迟要求。
-
*两个群集都需要访问 NetApp Console。*如果群集使用代理,请在两个群集上安装代理的根 CA 证书。NetApp 建议为每个群集使用不同的代理服务器。
-
*使用任一选项计划相同的故障行为。*当中介程序不可用时,复制将继续而不会丢失数据,但在中介程序再次可用之前,无法进行自动和计划的故障转移。使用 ONTAP Cloud Mediator,这包括从集群到 NetApp Console 的连接断开。

|
本节中的调解器选项适用于 SnapMirror 活动同步。对于 MetroCluster,此解决方案使用 ONTAP Mediator 或 MetroCluster Tiebreaker。在部署之前,请确认您的 ONTAP 版本、调解器选项和 Proxmox VE 版本一起列在 "NetApp 互操作性矩阵工具 (IMT)" 中。 |
服务提供商的优势
-
*虚拟机可用性超出了主机 HA。*当托管其磁盘的存储系统出现故障时,租户虚拟机会继续运行。ONTAP 故障转移到第二个 AFF 集群,并且虚拟机在不重启的情况下恢复相同共享存储上的 I/O。
-
*高级可用性层。*您可以提供零 RPO、具有存储弹性的虚拟机服务作为附加服务,同时在相同集群中未受保护的存储上提供标准层。
-
*每租户保护和故障转移。*通过为每个租户或服务层提供单独的受保护存储,您可以独立地为每个租户进行保护、故障转移和灾难恢复测试,而不会影响其他租户。
-
*更好地利用这两个站点。*您可以将站点 A 的某些工作负载设置为主工作负载,将站点 B 的其他工作负载设置为主工作负载,以便两个数据中心都能处理活动工作负载。
对企业的益处
-
在存储或站点故障期间,业务关键型虚拟机零数据丢失。
-
自动恢复,无需脚本、存储重新挂载或更改
/etc/pve/storage.cfg。 -
内置于 ONTAP,Proxmox VE 节点上没有额外的软件层。
-
*从一个界面进行日常操作。*Storage Manager for Proxmox 提供受保护的共享存储,并使用 ONTAP 快照和 FlexClone 技术备份、恢复和克隆虚拟机。
解决方案如何应对故障
ONTAP 和 Proxmox VE 做出独立的法定人数决定。该设计使它们保持一致,以便两者选择相同的幸存站点。
| 事件 | ONTAP 行为 | Proxmox VE 行为 |
|---|---|---|
站点 A 故障 |
调解器确认故障,ONTAP 自动将共享存储故障转移到集群 B。 |
站点 B 节点和 QDevice 保持仲裁。HA 将站点 A 节点隔离,并在站点 B 节点上重新启动其虚拟机。已在站点 B 的虚拟机在存储故障转移后恢复 I/O。 |
AFF 集群 A 发生故障,站点 A 的 Proxmox VE 节点继续运行 |
调解器确认集群 A 不可达,ONTAP 自动将共享存储故障转移到集群 B。 |
没有仲裁更改,也不会重新启动虚拟机。所有节点上的虚拟机在存储故障转移后恢复同一共享存储上的 I/O,站点 A 节点通过站点间网络到达群集 B。 |
A 站点的一个 AFF 控制器出现故障 |
配对控制器在本地 HA 接管中接管。未发生 SnapMirror 活动同步故障转移。 |
无影响。虚拟机在接管期间会短暂暂停 I/O。 |
站点 B 发生故障 |
集群 A 继续提供数据。当站点 B 恢复时,复制恢复。 |
站点 A 节点和 QDevice 保持仲裁。HA 在站点 A 节点上重新启动站点 B 虚拟机。 |
站点间链路失败 |
集群 A 继续提供数据。不会发生故障转移。 |
当仲裁器与主集群对齐时,QDevice 会将其选票投给站点 A 分区。站点 B 节点失去仲裁并自我隔离,HA 会在站点 A 上重新启动其虚拟机。 |
站点 C 发生故障,或集群无法访问 NetApp Console |
复制在零数据丢失的情况下继续进行,但在中介可用之前,无法进行自动和计划的故障转移。使用 ONTAP Cloud Mediator,站点 C 故障仅影响 QDevice。 |
集群通过四个节点的投票保持法定人数。没有 VM 受到影响。 |
一个 Proxmox VE 节点发生故障 |
无影响。 |
HA 会在其他节点上重新启动该节点上的虚拟机,首选同一站点的节点。 |
存储系统故障
存储系统故障是主机级 HA 无法单独处理的情况,也是 SnapMirror 活动同步为服务提供商带来最大价值的情况。下图显示了在使用 NFS 共享存储的情况下,AFF 集群 A 发生故障而每个 Proxmox VE 节点保持在线后的状态。
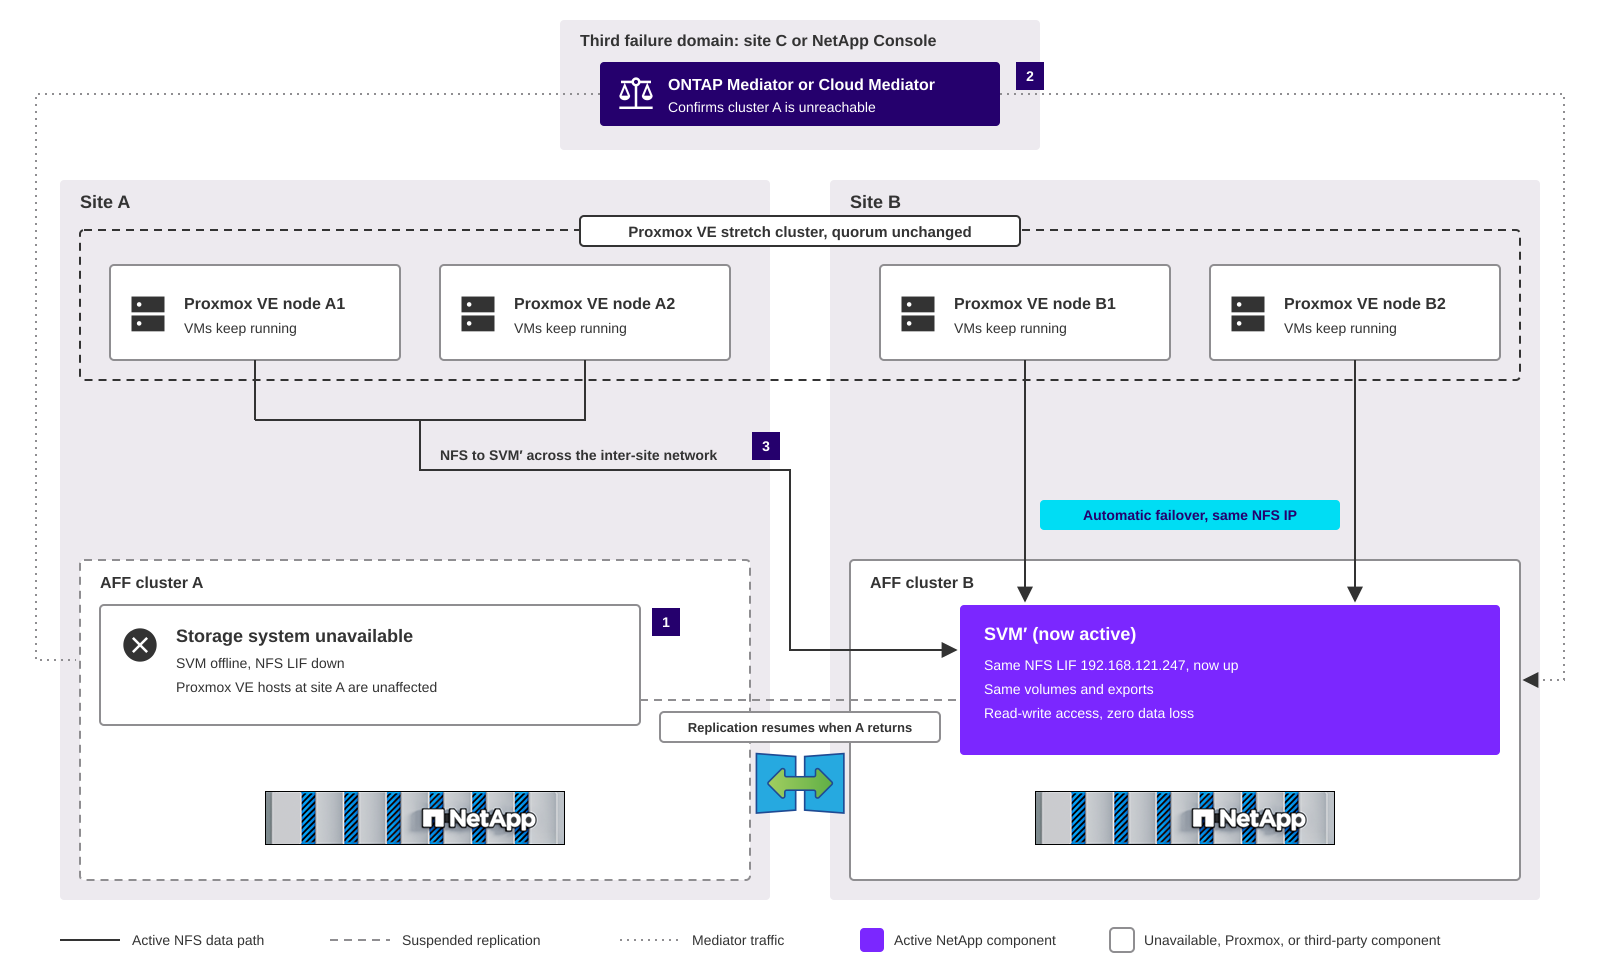
-
AFF 集群 A 变得不可用。站点 A 的 Proxmox VE 节点继续运行,因此集群不会丢失仲裁,HA 也不会隔离任何节点。
-
调解器,即站点 C 的 ONTAP 调解器或 NetApp Console 中的 ONTAP 云调解器,确认集群 A 不可访问,并且 ONTAP 在集群 B 上激活具有相同 NFS LIF 地址、卷和导出策略的辅助 SVM。
-
所有 Proxmox VE 节点都在同一共享存储上恢复 I/O。站点 B 节点在本地到达群集 B,站点 A 节点通过站点间网络到达群集 B。虚拟机在故障转移期间暂停 I/O,并在不重新启动的情况下继续运行。
当群集 A 返回时,复制恢复。在维护窗口期间计划对群集 A 的回切,以便站点 A 虚拟机再次访问本地存储。
站点故障
在站点故障期间,该站点的存储系统和 Proxmox VE 节点都会脱机。ONTAP 将共享存储故障转移到幸存的集群,并且 Proxmox VE HA 在幸存节点上重新启动来自故障站点的虚拟机,如表中所述。
在 SnapMirror 活动同步和 MetroCluster 之间进行选择
NetApp MetroCluster 配置还为 Proxmox VE stretch 集群提供零 RPO 和自动恢复。这两种解决方案在保护内容上有所不同:
-
*MetroCluster 保护所有工作负载。*MetroCluster 将基于阵列的集群与同步复制相结合。它将每个镜像聚合中的数据、非易失性内存(NVRAM)以及每个 SVM 的配置镜像到伙伴站点,因此无需按工作负载设置即可保护集群上的所有共享存储。
-
*SnapMirror 活动同步可保护一部分工作负载。*您可以选择要保护的 SVM 或卷,并且可以独立地对每个 SVM 或卷进行故障切换。未受保护的工作负载可以共享相同的群集。
这两种解决方案都会在每个站点上保留受保护数据的完整副本,需要在第三个故障域中有见证,并将复制负载添加到存储控制器。它们在保护范围、故障转移粒度和群集设计方面有所不同。
|
|
在部署任一解决方案之前,请验证您的 ONTAP 版本、MetroCluster 或 SnapMirror 活动同步配置以及 Proxmox VE 版本是否一起列在 "NetApp 互操作性矩阵工具 (IMT)" 中。 |
采用 Proxmox VE 的 MetroCluster 架构
下图显示了具有四节点 MetroCluster IP 配置和 NFS 共享存储的 Proxmox VE stretch 集群。
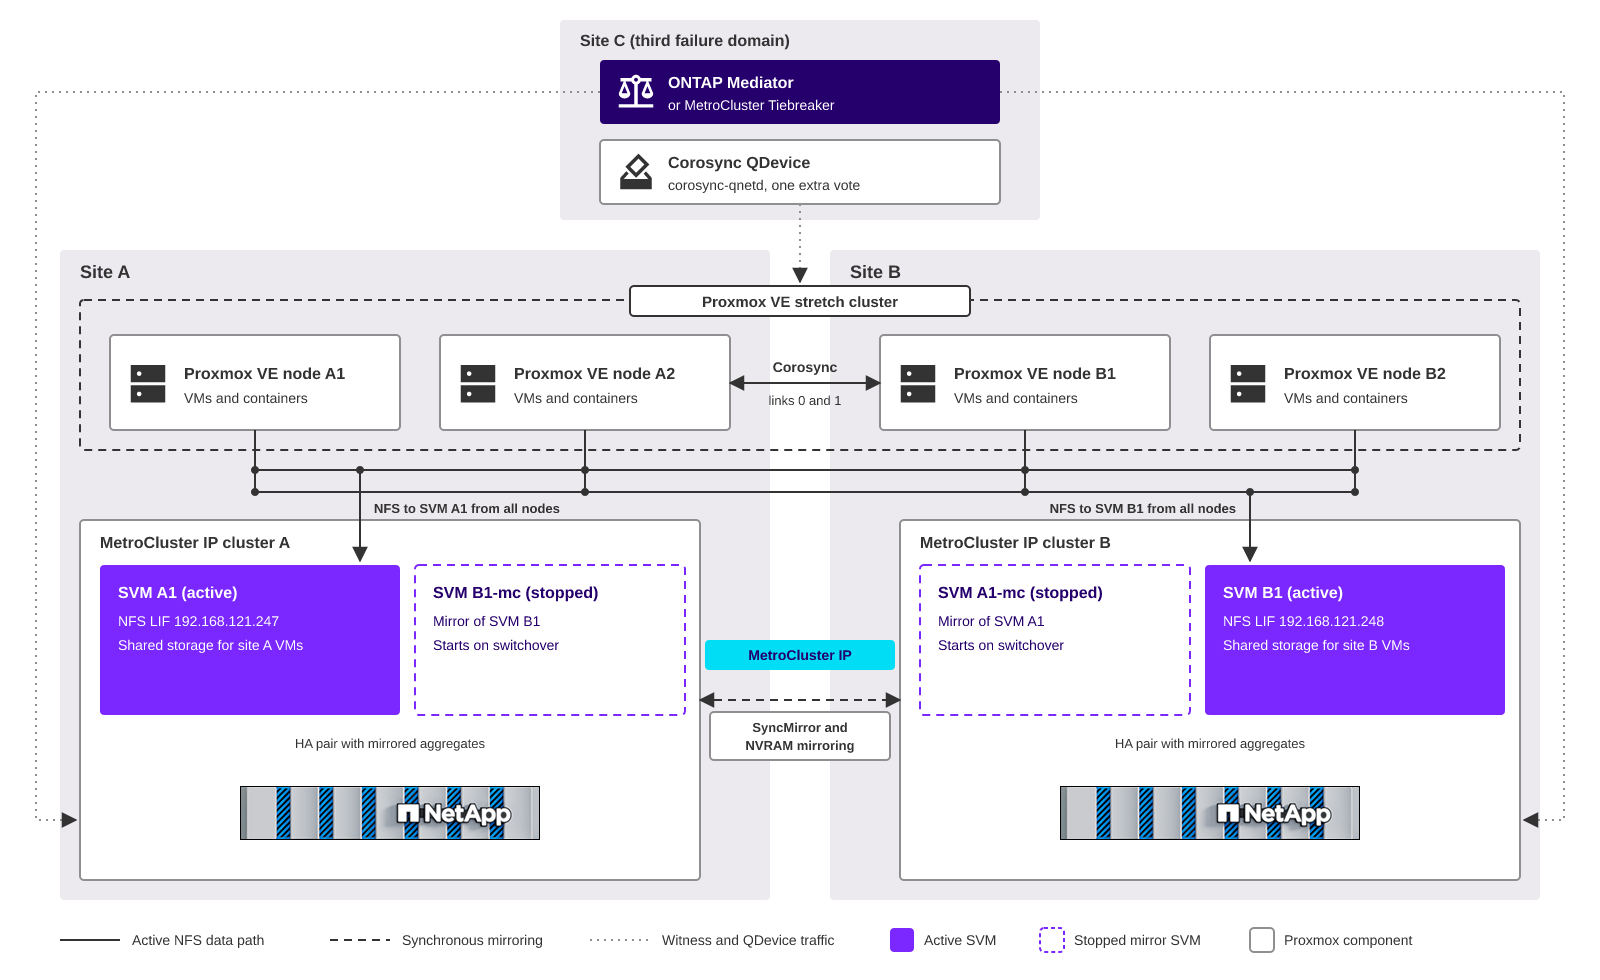
- MetroCluster IP 集群
-
每个站点都有一个具有镜像聚合的 HA 对。MetroCluster IP 后端网络将数据(SyncMirror)和 NVRAM 同步镜像到伙伴站点。
- 两个站点的 SVM
-
每个站点都可以为自己的 SVM 提供服务。对于每个 SVM,MetroCluster 会在配对站点保留一个带有 `-mc`后缀的已停止镜像 SVM,并具有相同的配置和 LIF 地址。
- 从所有节点进行 NFS 访问
-
每个 Proxmox VE 节点都挂载两个活动 SVM(SVM A1 和 SVM B1)的共享存储,以便 HA 可以在任何节点上重新启动任何虚拟机。站点 B 的节点通过站点间网络访问 SVM A1,站点 A 的节点通过站点间网络访问 SVM B1。这与 SnapMirror 活动同步的访问模式相同。
- 切换
-
如果站点发生故障,站点 C 的 ONTAP Mediator 或 MetroCluster Tiebreaker 会启用自动切换。幸存站点上的镜像 SVM 启动并使用相同的 NFS 地址提供所有共享存储服务,并且 Proxmox VE HA 会重新启动故障站点上的虚拟机。单个控制器故障由本地 HA 接管处理,无需切换。修复故障站点后,您将修复聚合并切回。
MetroCluster 如何应对故障
下表显示了 MetroCluster IP 配置和 Proxmox VE stretch 集群如何响应与 [解决方案如何应对故障] 中相同的故障。在此示例中,SVM A1 在站点 A 处于活动状态,SVM B1 在站点 B 处于活动状态。
| 事件 | ONTAP 行为 | Proxmox VE 行为 |
|---|---|---|
站点 A 故障 |
ONTAP Mediator 或 MetroCluster Tiebreaker 确认故障,ONTAP 切换站点 A。SVM A1-mc 在站点 B 使用相同的 NFS LIF 地址启动。SVM B1 继续提供数据。 |
站点 B 节点和 QDevice 保持仲裁。HA 将站点 A 节点隔离,并在站点 B 节点上重新启动其虚拟机。已在站点 B 节点上运行的虚拟机继续运行,并且 SVM A1 上的虚拟机在切换后恢复 I/O。 |
MetroCluster IP 群集 A 发生故障,站点 A 的 Proxmox VE 节点继续运行 |
ONTAP Mediator 或 MetroCluster Tiebreaker 确认集群 A 不可达,ONTAP 切换站点 A。SVM A1-mc 在站点 B 启动,并使用相同的 NFS LIF 地址。 |
不会更改仲裁,也不会重新启动虚拟机。SVM A1 上的虚拟机在切换后恢复 I/O,站点 A 节点通过站点间网络到达站点 B。 |
站点 A 的一个控制器出现故障 |
站点 A 的 HA 合作伙伴在本地 HA 接管中进行接管。不会发生切换。 |
无影响。虚拟机在接管期间会短暂暂停 I/O。 |
站点 B 发生故障 |
ONTAP 切换站点 B。SVM B1-mc 在站点 A 以相同的 NFS LIF 地址启动。SVM A1 继续提供数据。 |
站点 A 节点和 QDevice 保持仲裁。HA 在站点 A 节点上重新启动站点 B 虚拟机,这些虚拟机在站点 A 访问 SVM B1。 |
站点间链路失败 |
不会发生切换,因为两个群集仍在运行。每个站点继续为其自己的 SVM 提供服务,并暂停向配对站点的镜像,直到链路恢复。 |
当仲裁器与站点 A 对齐时,QDevice 将其投票权授予站点 A 分区。站点 B 节点失去仲裁并自我隔离。HA 在站点 A 节点上的 SVM A1 上重新启动虚拟机。SVM B1 上的虚拟机在链路恢复之前无法重新启动,因为站点 A 节点无法访问 SVM B1。 |
站点 C 发生故障 |
镜像继续进行,零数据丢失,但在见证可用之前无法自动切换。您仍然可以手动切换。 |
集群通过四个节点的投票保持法定人数。没有 VM 受到影响。 |
一个 Proxmox VE 节点发生故障 |
无影响。 |
HA 会在其他节点上重新启动该节点上的虚拟机,首选同一站点的节点。 |
站点间链路故障是与单主站点设计的主要区别。每当两个站点都托管活动 SVM 时,无论是使用 MetroCluster 还是在相反方向上使用两个 SnapMirror active sync SVM,corosync tie breaker 都只能偏向一个站点。活动 SVM 位于另一个站点的虚拟机将保持停机状态,直到链路恢复。为了限制影响,请在单独的物理路径上使用冗余的站点间链路,并将最关键的虚拟机放置在 tie breaker 所偏向站点的 SVM 上。
功能对比
| 注意事项 | SnapMirror 适用于 NAS 的活动同步 | MetroCluster IP |
|---|---|---|
保护范围 |
选定的 SVM 和卷 |
配置中的所有镜像聚合和所有 SVM |
故障转移粒度 |
每个 SVM 独立 |
整个站点,通过切换 |
未受保护的工作负载 |
在相同集群中未受保护的 SVM 上运行 |
可以使用未镜像的聚合,这些聚合在切换后离线,直到您将其上线 |
集群设计 |
两个独立的集群,通过 IP 网络建立对等关系 |
包含两个配对集群的一种配置,具有专用的 MetroCluster IP 后端网络 |
站点 C 的见证 |
ONTAP Mediator 或 ONTAP Cloud Mediator |
ONTAP Mediator 或 MetroCluster Tiebreaker |
受保护数据的副本 |
每个站点一个 |
每个站点一个,位于镜像聚合中 |
复制路径 |
基于集群间 LIF 的 SnapMirror 同步 |
SyncMirror 和 NVRAM 通过 MetroCluster IP 后端网络进行镜像 |
两个站点的 NFS 地址 |
延伸的第 2 层 VLAN。具有待认证 BGP 的 VIP LIF |
延伸第 2 层 VLAN,或使用 BGP 的 VIP LIF |
站点故障后恢复 |
故障回复每个 SVM |
修复聚合,然后切换回站点 |
甄选指南
-
当存储上的所有或几乎所有工作负载都需要零 RPO 时,请选择 MetroCluster,例如,当企业仅在集群上运行任务关键型虚拟机时,或者服务提供商为每个租户提供相同的可用性层时。您无需按工作负载配置即可获得一个保护域。
-
仅当工作负载的子集需要零 RPO(例如,某些租户的高级层)时,或者需要一次为一个租户或应用程序进行故障转移或测试灾难恢复时,请选择 SnapMirror 主动同步。
-
SnapMirror 主动同步不支持 MetroCluster 配置上的 NAS。每对集群使用一种解决方案。
-
此解决方案中的 corosync、QDevice 和 HA 指南适用于两者。使用 MetroCluster 时,将 QDevice 仲裁器与在站点间链路发生故障时继续提供数据的站点对齐,并使用 HA 节点亲和性规则将虚拟机与其活动 SVM 保持在同一站点。
-
MetroCluster IP 还支持带有 BGP 的 VIP LIF,用于站点之间的第 3 层网络。
Proxmox VE 延伸集群的 Corosync 注意事项
Proxmox VE 将 corosync 用于集群成员身份和仲裁。Corosync 对站点间网络比 SnapMirror 主动同步更敏感,因此请先规划集群网络。
延迟和网络设计
-
SnapMirror 活动同步要求群集间往返时间(RTT)小于 10 毫秒。Proxmox 建议所有节点之间的 corosync 延迟小于 5 毫秒,因此 corosync 要求为解决方案设置了距离限制。
-
Corosync 需要低且一致的延迟,而不是高带宽。为 corosync 使用专用网络,将其与存储和实时迁移流量分开,以免存储突发导致 corosync 超时。
-
在站点之间的单独物理路径上配置至少两个 corosync 链路(例如,链路 0 和链路 1)。如果一条路径出现故障,Corosync 会使用 Kronosnet 自动切换链路。
在第三个站点使用 QDevice 的法定人数
在站点 A 和站点 B 之间均匀分配 Proxmox VE 节点,并在站点 C 添加 QDevice。凭借四个节点和一个 QDevice,集群拥有五票,需要三票才能达到法定人数,因此任何一个站点发生故障都不会丢失法定人数。QDevice 通过 TCP 端口 5403 连接到集群,并且没有 corosync 的低延迟要求,因此它可以与 ONTAP Mediator 共享站点 C。如果您使用 ONTAP Cloud Mediator,您仍然需要为 QDevice 提供第三个位置,但它可以是一台不托管 Mediator 的小型 Linux 主机。
仲裁器与主集群对齐
当站点间链路发生故障但两个站点仍然可以到达站点 C 时,ONTAP 会让站点 A 的主集群继续提供数据服务。QDevice 必须将其选票投给同一个站点。默认情况下,QDevice 会选择包含最低节点 ID 的分区。
*最佳实践:*在加入站点 B 节点之前,在站点 A 节点上创建 Proxmox VE 集群并加入其他站点 A 节点,以便站点 A 拥有最低的节点 ID。如果主存储长时间移动到站点 B,则将 QDevice tie_breaker 设置更新为站点 B 节点 ID。
如果 QDevice 转而倾向于站点 B,则站点 A 节点将自我隔离,并且 HA 会在无法访问站点 A 活动存储的站点 B 节点上重新启动虚拟机。
HA 行为和 VM 放置
-
Proxmox VE HA 通常会检测到故障节点,并在大约两分钟内恢复其虚拟机,包括 60 秒的监视器隔离超时。在站点故障期间,SnapMirror 活动同步故障转移和 Proxmox VE HA 恢复并行运行。
-
使用具有节点优先级的 HA 节点关联规则,将虚拟机放置在与其主存储位于同一站点的节点上,并允许它们故障切换到其他站点。
-
在站点故障切换后,将受影响虚拟机的 HA
failback属性设置为0,直到存储故障恢复。否则,HA 会在站点 A 节点恢复后立即将虚拟机迁移回这些节点,而活动存储仍在站点 B。 -
确保来宾操作系统磁盘超时时间长于预期的故障转移时间,以便来宾在存储故障转移期间不会报告 I/O 错误。
与 Storage Manager for Proxmox 集成
Storage Manager for Proxmox (SMP) 为 Proxmox VE 管理员提供了一个界面,可通过使用 ONTAP 快照和 FlexClone 技术来配置 ONTAP 共享存储以及备份、还原和克隆虚拟机。SMP 通过其 API 连接到 Proxmox VE 集群和 ONTAP,因此不需要在 Proxmox VE 节点上安装代理。
SMP 和 SnapMirror 主动同步可防止不同类型的故障。SnapMirror 主动同步可使虚拟机在存储或站点故障期间保持运行,但它会同步复制每次写入,包括意外删除、来宾更新失败或由勒索软件加密的数据。SMP 快照为您提供了从这些逻辑故障中恢复的时间点副本。它们结合在一起,可从相同的 ONTAP 存储中提供连续的可用性和快速的操作恢复。
| 保护层 | 防止 | 恢复点 | 通过以下方式管理 |
|---|---|---|---|
SnapMirror主动同步 |
存储系统故障和站点故障 |
零数据丢失 |
ONTAP |
SMP 备份(ONTAP 快照) |
意外删除、数据损坏、更新失败和勒索软件 |
上次计划备份或按需备份 |
SMP |
SnapMirror 异步扇出或 Proxmox Backup Server |
两个站点的丢失和长期保留 |
上次复制或备份 |
ONTAP 或 Proxmox 备份服务器 |
备份和恢复
SMP 按需或按策略将崩溃一致性或文件一致性备份创建为存储卷的 ONTAP 快照,并恢复单个虚拟机、存储或资源组:
-
使用资源组和备份策略将相同的计划和保留应用于租户或应用程序的虚拟机。
-
对运行 QEMU 访客代理的虚拟机使用文件一致性备份,以便在 ONTAP 创建快照之前使访客文件系统静默。
-
SMP 管理处于活动状态的存储。在 SnapMirror 活动同步故障转移后,在 SMP 中运行发现,以便在运行备份或还原操作之前将存储映射到集群 B。
-
对于两个站点之外的第三个副本,或为了更长的保留时间,请从受保护卷中添加 SnapMirror 异步扇出关系,或使用 Proxmox Backup Server。
-
SnapMirror 活动同步不支持防篡改快照,因此请勿在 SMP 中为受保护卷启用快照锁定。
VM 克隆
SMP 使用 ONTAP FlexClone 技术创建节省空间的 VM 克隆,用于开发、测试和快速配置。您在受保护的存储中创建的克隆会消耗两个站点上的复制带宽和容量。将不需要业务连续性的克隆和测试存储从 SnapMirror 活动同步保护中排除。
SMP 放置
-
将 SMP VM 作为 HA 资源在受 SnapMirror 活动同步保护的共享存储上运行,以便在存储或站点发生故障后 SMP 保持可用。
-
在 SMP 中注册 Proxmox VE 集群和两个 ONTAP 集群,以便 SMP 可以访问任一站点的活动存储。
具有适用于 NAS 的 SnapMirror 活动同步功能的 NFS 共享存储
从 ONTAP 9.19.1 开始,SnapMirror 主动同步保护 NAS 工作负载。以下注意事项仅适用于 NFS 共享存储。要使用 NFS 存储部署解决方案,请按照"NAS 配置工作流"进行操作。
SVM 级保护和网络身份
-
用于 NAS 的 SnapMirror 活动同步可保护整个存储虚拟机(SVM)。您可以保护 SVM 中的所有卷或排除选定的卷。仅支持 FlexVol 卷,并且 SVM 不能包含 LUN。
-
辅助 SVM 保持休眠状态,其 LIF 处于关闭状态,直到发生故障转移。ONTAP 复制 SVM 配置,包括 LIF IP 地址、导出策略和 NFS 设置,因此辅助 SVM 在故障转移后呈现相同的 NFS 端点。
-
对于 NFSv3 及更高版本,故障转移是无中断的。
-
SnapMirror NAS 的主动同步是主动/被动的,因此站点 B 节点上的虚拟机通过站点间网络读取和写入主 SVM。对于两个站点的活动工作负载,请使用两个具有相反复制方向的 SVM,每个站点一个主 SVM,并将每个 VM 的节点关联规则与其主 SVM 的站点对齐。
-
AFF A 系列和 C 系列双节点集群支持适用于 NAS 的 SnapMirror 主动同步。
NFS 客户端设置
对 NFS 存储使用 NFSv3 或 NFSv4.1。保留默认的硬挂载行为,不要添加 `soft`挂载选项,以便 NFS I/O 在故障转移期间重试而不是失败。
使用多个 TCP 连接到存储,以获得更好的性能和容错。请使用 nConnect 或会话中继,而不是同时使用两者:
-
*nConnect.*打开到单个 NFS LIF 地址的多个 TCP 连接,例如
nconnect=4。nConnect 适用于 NFSv3 和 NFSv4.1,以及单个 VIP LIF 地址,因此是 NAS 的 SnapMirror 主动同步(包括第 3 层网络)的推荐选项。 -
*会话中继。*将多个数据 LIF 分组到一个 NFSv4.1 会话中,例如
vers=4.1,trunkdiscovery,max_connect=16。会话中继需要 NFSv4.1 或更高版本。仅当受保护的 SVM 具有客户端可以在两个站点(例如在延伸的第 2 层网络中)访问的多个数据 LIF 时,才使用它。有关详细信息,请参见"NFS 中继"。
有关挂载选项命令和验证步骤,请参见 "为 Proxmox VE 配置 NFS 存储"。
使用 SMP 进行 NFS 存储资源调配
SMP 配置 ONTAP 卷,创建或选择导出策略,并将该卷作为 NFS 共享存储挂载到您选择的 Proxmox VE 节点上。对于受保护 SVM 中的存储:
-
在主 SVM 中配置卷,并选择 NFS LIF 或第 3 层网络中的 VIP LIF 作为首选 LIF。辅助 SVM 在故障转移后使用相同的地址,因此存储定义保持有效。
-
在两个站点的所有 Proxmox VE 节点上挂载存储,以便 HA 可以在任何节点上重新启动虚拟机。
-
确保导出策略允许两个站点上的 Proxmox VE 节点。ONTAP 将导出策略复制到辅助 SVM。
-
配置后,请验证卷是否包含在 SnapMirror 活动同步保护中。
具有 VIP LIF 和 BGP 的第 3 层网络
NAS 的 SnapMirror 主动同步要求主 SVM 和辅助 SVM 上的 IP 地址相同。当 NFS VLAN 在站点之间延伸时,LIF IP 地址会随 SVM 一起移动。当站点通过路由的第 3 层网络连接时,站点 B 上不存在站点 A LIF 的子网。

|
在发布时,NetApp 尚未将具有 BGP 的 VIP LIF 记录为 NAS 的 SnapMirror 活动同步的合格配置。在规划第 3 层设计之前,请向 NetApp 确认当前的支持情况。否则,请在站点之间延伸 NFS VLAN。MetroCluster IP 配置支持具有 BGP 的 VIP LIF。 |
ONTAP 虚拟 IP(VIP)LIF 解决了这个问题。VIP LIF 不属于任何子网。ONTAP 通过使用边界网关协议(BGP),将 VIP 地址作为 /32 主机路由通告给对等路由器,因此该地址可以在没有延伸 VLAN 的情况下在站点之间移动。
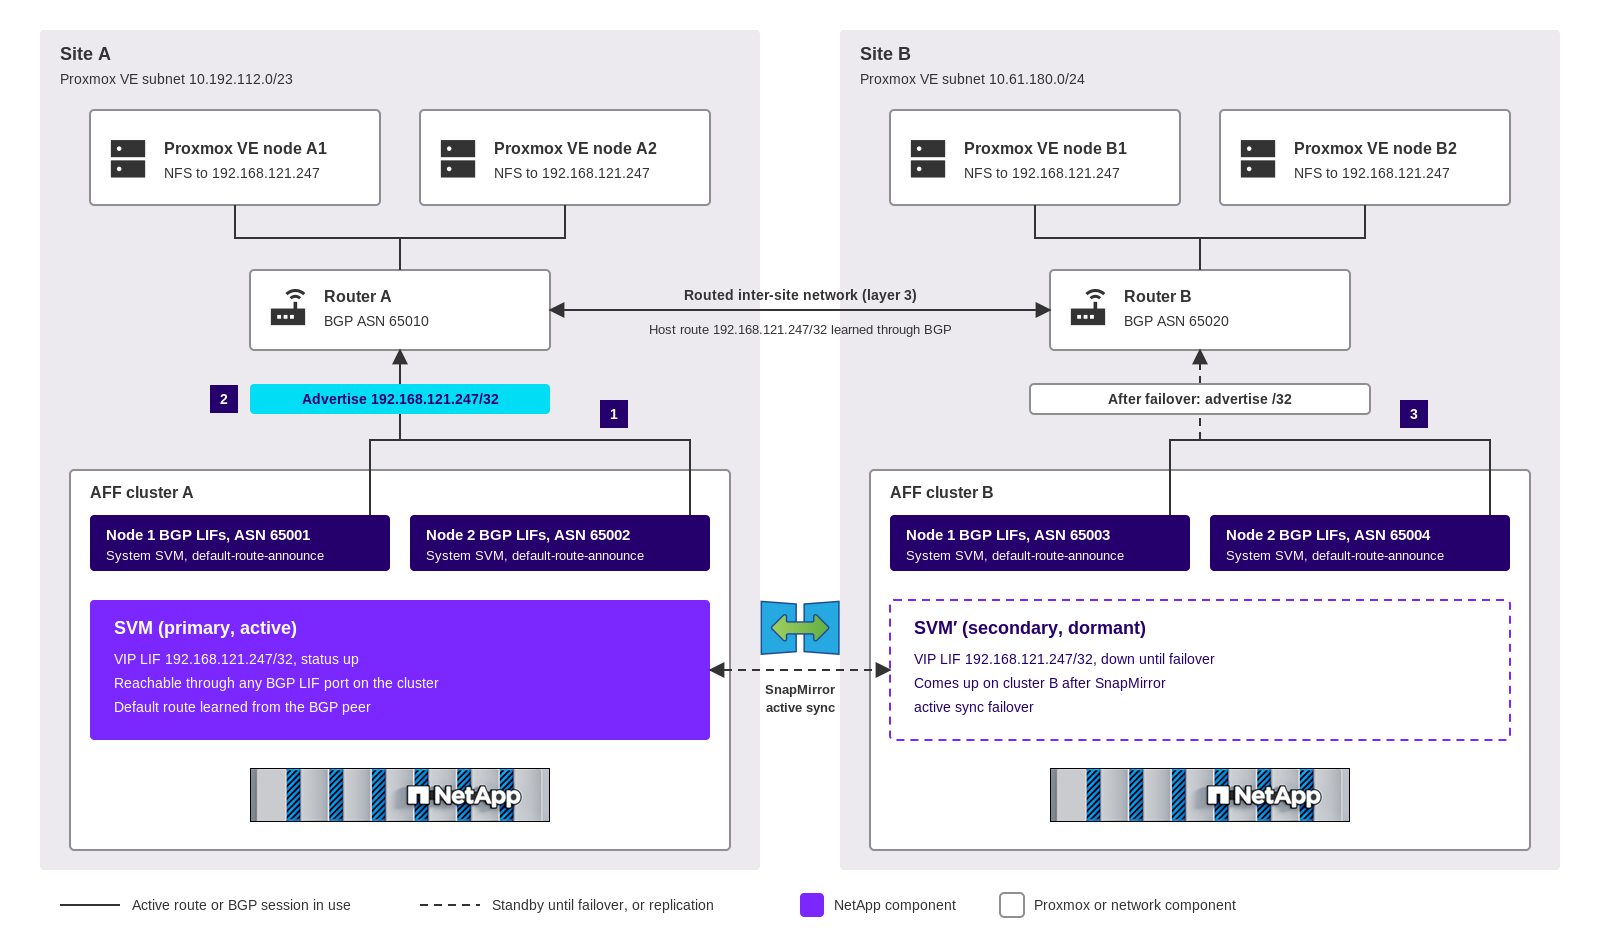
-
两个站点的每个节点在系统 SVM 中都有 BGP LIF,与其所在站点的路由器建立对等关系。BGP LIF 是特定于节点的,不会进行复制,因此您需要在两个集群上配置它们。
-
主 SVM 托管 NFS VIP LIF。群集 A 通告 /32 主机路由,两个站点的 Proxmox VE 节点通过路由网络到达存储。
-
在 SnapMirror 主动同步故障转移后,VIP LIF 出现在辅助 SVM 上,集群 B 通告主机路由,路由器在站点 B 上收敛。
首次在 ONTAP 中规划 BGP 时,了解哪个 SVM 拥有每个 LIF 会有所帮助。BGP LIF 属于 IPspace 的系统 SVM,而不是数据 SVM。每个集群上的一组 BGP LIF 为该 IPspace 中每个数据 SVM 的 VIP LIF 提供服务,因此您无需为每个租户创建 BGP LIF。下图显示了一个集群上的 LIF 和端口布局,以及 VLAN 端口上的 BGP LIF。
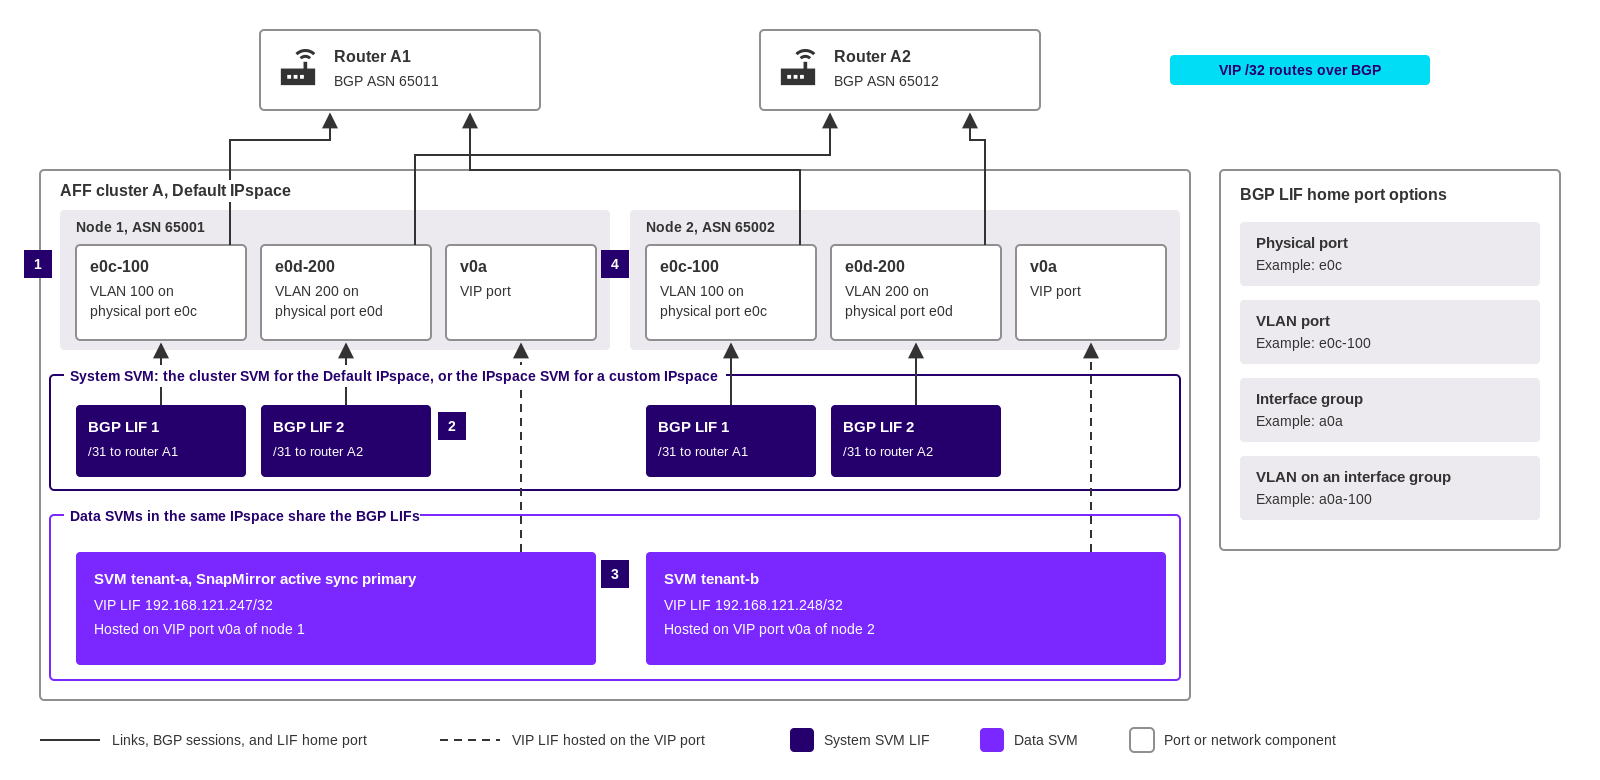
-
每个节点都有两个 BGP 端口,在本示例中为 VLAN 端口
e0c-100`和 `e0d-200。每个端口直接连接到不同的路由器。 -
每个节点在系统 SVM 中有两个 BGP LIF,每个端口一个,具有一个 /31 子网和一个连接到一个路由器的 BGP 对等组。对于默认 IPspace,系统 SVM 是集群 SVM。对于自定义 IPspace,它是与 IPspace 同名的 SVM。
-
同一个 IPspace 中的数据 SVM 托管 VIP LIF,并且不需要自己的 BGP LIF。BGP 对等组为 IPspace 中的所有 SVM 通告 VIP 路由。
-
当您创建第一个 BGP 对等组时,ONTAP 会在每个节点上创建一个 VIP 端口,例如
v0a。VIP LIF 托管在 VIP 端口上,可通过 IPspace 中托管 BGP LIF 的节点上的每个端口进行访问。
BGP LIF 的主端口可以是物理端口、VLAN 端口、接口组或接口组上的 VLAN。不需要接口组。NetApp 技术报告 TR-4949 建议为每个 IPspace 在两个独立的端口上配置两个 BGP LIF,每个端口直接连接到不同的第一跳路由器。
请记住以下准则:
-
BGP LIF 不会故障转移。冗余来自每个节点的两个 BGP LIF,每个节点与不同的路由器对等。如果节点丢失了 SVM 的所有 BGP 会话,ONTAP 会将 VIP LIF 移动到具有该 SVM 的活动 BGP 会话的另一个节点。
-
为每个 ONTAP 节点和每个路由器使用具有唯一专用自治系统编号(ASN)的外部 BGP(eBGP)。
-
为每个 BGP LIF 及其路由器使用 /31 子网(网络掩码 255.255.255.254)。将奇数地址分配给 BGP LIF,将偶数地址分配给路由器。
-
ONTAP 不会处理来自路由器的路由。将路由器配置为接受来自 ONTAP 的 /32 主机路由,并且不向集群发送路由更新。
-
Proxmox VE 节点不得与 VIP 地址共享子网。冗余的第 3 层路由器(例如使用 VRRP 或 HSRP)必须位于节点和存储之间的路径中。
-
使用 `-use-peer-as-next-hop true`配置 BGP 对等组,以便每个集群从其本地路由器学习其默认路由。故障转移后,指向站点 A 网关的路由在站点 B 无效。
-
启用多路径路由,以便传出 VIP 流量使用所有可用的 BGP LIF 端口。
-
将 BGP 保持时间从默认的 180 秒缩短。TR-4949 建议保持时间为 3 秒。只有当保持计时器到期时,路由器才会从出现故障的集群中撤回路由,而在存储系统出现故障期间,站点 A 的路由器将保持在线状态。