


了解 Proxmox VE 搭配 SnapMirror 作用中同步的業務連續性

 建議變更

 PDF

在 Proxmox 虛擬環境(VE)上執行業務關鍵型虛擬機器(VM)的企業,以及在 Proxmox VE 上託管客戶 VM 的服務供應商,都需要這些 VM 在儲存系統或整個資料中心離線時保持運作。ONTAP SnapMirror 作用中同步可同步複寫跨兩個站台的 Proxmox VE 叢集的共享儲存設備,並自動將儲存設備容錯移轉到存活的站台。您可以獲得零恢復點目標(RPO)、無需指令碼或 Runbook 的自動恢復,以及在兩個站台相同的共享儲存設備,因此 Proxmox VE 高可用度(HA)可以在無需任何儲存設備重新組態的情況下重新啟動 VM。對於 NFS 共享儲存設備,此解決方案使用適用於 NAS 的 SnapMirror 作用中同步。
客戶挑戰
僅使用原生工具為 Proxmox VE 建立儲存設備和站台彈性是困難的:
-
*站台故障後資料遺失。*Proxmox VE 儲存設備複寫和 Proxmox Backup Server 是非同步的。主站台發生故障時,自上次複寫或備份以來所做的變更將會遺失。
-
*手冊、緩慢的恢復。*在次要站台恢復通常意味著提升複本、在不同的位址掛載儲存設備、更新
/etc/pve/storage.cfg,以及重新啟動 VM。每個手冊步驟都會增加停機與停電期間發生錯誤的風險。 -
*與虛擬機器爭奪主機資源的延伸儲存設備。*超融合延伸儲存設備(例如延伸模式下的 Ceph)在 Proxmox VE 節點上執行,並在每個站台保留每個物件的兩個複本。複寫、恢復和重新平衡流量會使用執行虛擬機器的相同節點上的 CPU、記憶體容量和網路資源。
-
*兩個必須達成一致的法定人數決定。*任何雙站台設計都需要在第三個故障網域中設立見證,分別用於 Proxmox VE 叢集和儲存設備。如果在站台間連結故障後,叢集和儲存設備選擇了不同的存活站台,虛擬機器將在無法連線至作用中儲存設備的節點上重新啟動。
-
*必須在兩個站台都能正常運作的儲存設備位址。*儲存設備容錯移轉後,Proxmox VE 節點必須能夠存取相同位址的共享儲存設備。該位址必須在兩個站台都能連線,這通常代表在兩個站台之間延伸的第 2 階層 VLAN。
服務供應商面臨的挑戰
在 Proxmox VE 上建置雲端服務的服務供應商面臨同樣的挑戰,此外還要遵守租戶服務層級協定(SLA):
-
*儲存系統是共享的故障點。*Proxmox VE HA 可保護租戶虛擬機器免受主機故障的影響,但無法保護其免受託管其磁碟的儲存系統故障的影響。一次儲存設備停電會影響該系統上的每個租戶。
-
*無法銷售更高的可用度。*如果沒有同步複寫和自動儲存設備容錯移轉,供應商就無法提供具備零資料遺失和更強大正常運作時間承諾的高級可用度分層。
-
*恢復期間的租戶隔離。*恢復、維護和災難恢復測試必須只影響相關的租戶,而不能影響整個平台。
企業挑戰
將關鍵業務工作負載從其他虛擬機器管理程式遷移到 Proxmox VE 的企業期望獲得與先前相同的站台彈性,例如資料庫和業務線應用程式零資料遺失,以及無需手冊 runbook 的恢復。僅使用 Proxmox VE 原生工具來滿足該期望需要大量的設計、指令碼編寫和維運工作。
解決方案概述
此解決方案將 Proxmox VE 延伸叢集與兩個站台上 NetApp AFF 系統上的 SnapMirror 主動同步相結合:
-
*零 RPO。*ONTAP 會將每次對共享儲存設備的寫入,從站台 A 的主要叢集同步複寫到站台 B 的次要叢集。
-
*兩個站台使用相同的共享儲存設備。*容錯移轉後,次要叢集向 Proxmox VE 提供相同的儲存設備,因此 `/etc/pve/storage.cfg`中的儲存設備定義仍然有效。
-
*自動容錯移轉。*Mediator 在兩個站台之外作為見證。您可以將 ONTAP Mediator 安裝在第三個站台,或使用 ONTAP Cloud Mediator ,這是一項託管在 NetApp Console 中的服務。當主儲存設備或站台發生故障時, ONTAP 會容錯移轉至站台 B ,無需手冊干預。
-
*精細控制。*您可以選擇要保護的工作負載,並且可以單獨容錯移轉工作負載,例如,為了進行站台維護而移動一個租戶或應用程式。
-
*輔助複本的使用。*您可以 Clone 輔助複本以進行開發、測試或災難恢復測試,而不會影響複寫。
解決方案如何應對挑戰
| 挑戰 | 該解決方案如何提供協助 | 您仍需規劃的事項 |
|---|---|---|
資料遺失及手冊恢復 |
同步複寫可提供零 RPO。ONTAP 會自動容錯移轉,且次要 SVM 會提供相同的 NFS 位址,因此 `/etc/pve/storage.cfg`保持有效。 |
Proxmox VE HA 仍然會從故障站台重新啟動虛擬機器。 |
主機上的延伸儲存設備 |
複寫在 AFF 控制器上執行,而不是在 Proxmox VE 節點上執行,因此主機 CPU、記憶體容量和網路可繼續供虛擬機器使用。ONTAP 在每個站台保留一份複本,且儲存效率適用於這兩份複本。 |
與任何同步複寫一樣,此解決方案需要在站台 B 保留完整的第二份複本,並且複寫會為兩個 AFF 叢集都增加負載。請根據複寫工作負載調整兩個叢集的容量。 |
兩項法定人數決定 |
ONTAP Mediator,或 NetApp Console 中以服務形式提供的 ONTAP Cloud Mediator,是資料路徑之外的輕量級見證。此解決方案顯示如何讓 corosync QDevice 與主叢集遵守,以便兩者選擇同一站台。 |
QDevice 仍然需要第三個位置。ONTAP Mediator 也需要它,但 ONTAP Cloud Mediator 則不需要。請參閱 [中介選項]。 |
兩個站台的儲存設備位址 |
輔助 SVM 接管相同的 NFS LIF 位址,因此無需重新掛載或重新配置儲存設備。 |
NFS 子網路必須在兩個站台均可連線,通常使用延伸的階層 2 VLAN。有關 VIP LIF 的資格判斷狀態,請參閱 具有 VIP LIF 和 BGP 的第 3 階層網路。 |
下圖顯示採用 NFS 共享儲存設備的解決方案架構。
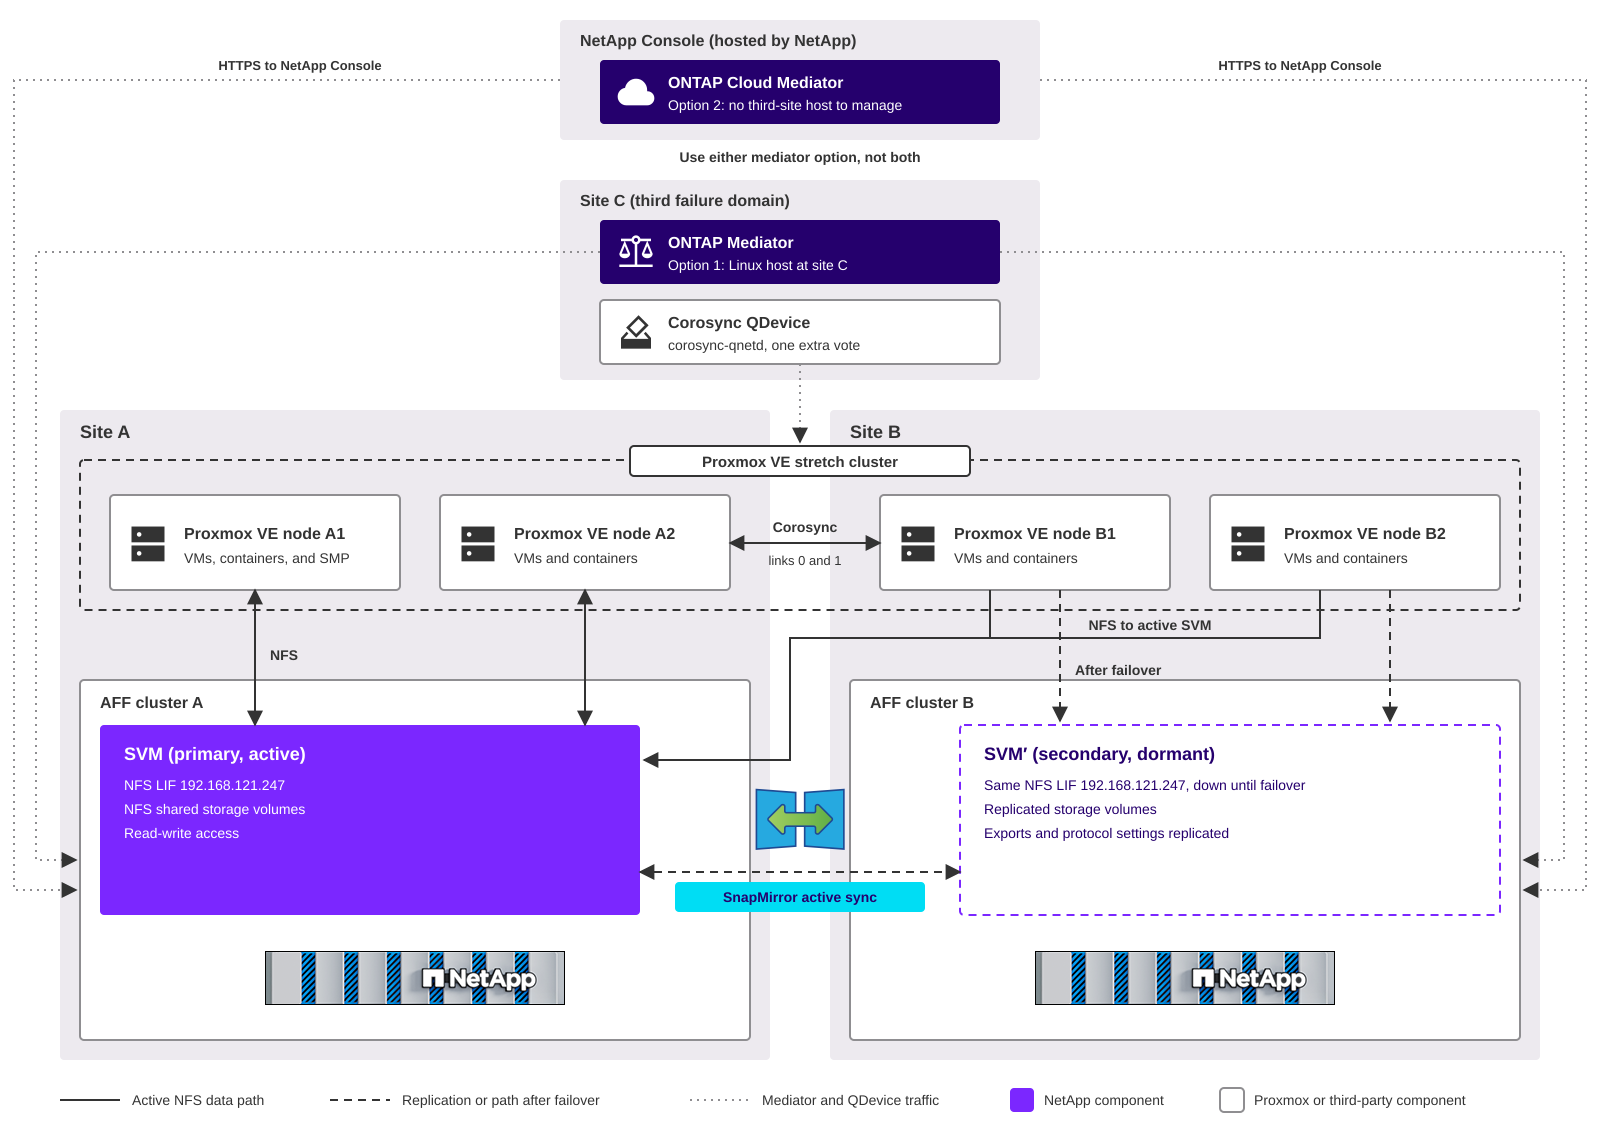
- 站台 A 和站台 B
-
每個站台都配備一個 AFF 雙節點叢集和一半的 Proxmox VE 節點。站台 A 的主叢集為所有 Proxmox VE 節點提供共享儲存設備。站台 B 的節點透過站台間網路存取主叢集。使用 NFS 儲存設備時,站台 B 的輔助 SVM 在發生容錯移轉之前保持休眠狀態。
- 站台 C
-
第三個故障網域託管 corosync QDevice 系統程式 (
corosync-qnetd),如果您選擇選項 1,則也託管 ONTAP Mediator。QDevice 提供額外的投票權,以便在一個站台故障時,Proxmox VE 叢集仍能保持仲裁。 - NetApp Console
-
如果選擇選項 2,ONTAP Cloud Mediator 將以服務形式在 NetApp Console 中執行,由 NetApp 託管和管理。兩個 AFF 叢集都透過 HTTPS 連接到它,因此您無需安裝或維護中介器主機。
- 中介程式
-
ONTAP Mediator 或 ONTAP Cloud Mediator 協助 ONTAP 決定哪個叢集負責資料服務。請僅使用其中一個,不要同時使用兩個。如需比較,請參閱 [中介選項]。
- Proxmox VE 延伸叢集
-
所有 Proxmox VE 節點都屬於同一個叢集,並共享相同的儲存設備定義。Proxmox VE HA 會在存活的節點上重新啟動來自故障站台的虛擬機器。Storage Manager for Proxmox(SMP)在叢集上作為 HA 虛擬機器執行,以資源配置共享儲存設備,並備份、還原和 Clone 虛擬機器。
中介選項
SnapMirror 作用中同步使用中介伺服器作為被動見證。在網路分割或單一叢集故障期間,ONTAP 會使用中介伺服器來決定由哪個複本繼續提供 I/O 服務。中介伺服器不在資料路徑中,也不會自行啟動容錯移轉。您可以使用下列其中一個選項,但不能同時使用兩者。
| 考慮 | 選項 1:ONTAP 中介 | 選項 2:ONTAP Cloud 中介 |
|---|---|---|
執行位置 |
在第三個故障域(例如站台 C)中安裝和管理的 Linux 主機,具有獨立的電源和網路基礎架構。 |
NetApp Console 中的雲端服務。NetApp 負責託管與管理,因此您不需要第三個站台的中介主機。 |
ONTAP 版本 |
ONTAP 9.19.1 或更新版本,用於 NAS 的 SnapMirror 作用中同步。 |
ONTAP Cloud Mediator 從 ONTAP 9.17.1 開始提供。NAS 的 SnapMirror 作用中同步需要 ONTAP 9.19.1 或更新版本。 |
叢集連線 |
兩個叢集都連接到中介主機。預設服務連接埠為 31784。 |
兩個叢集都直接或透過 HTTP Proxy,透過 HTTPS 傳出連線至 NetApp Console。建議至 NetApp Console 的 ping 延遲低於 200 毫秒。 |
設定 |
在 Linux 主機上安裝該套件,然後使用主機位址和中介使用者將其新增至叢集。 |
建立具有 ONTAP 中介器設定角色 的 NetApp Console 服務帳戶,然後使用組織 ID、用戶端 ID 和用戶端密碼將中介器新增至叢集。 |
營運 |
您對主機進行修補和升級,並保持其可用狀態。 |
沒有主機可供修補或升級。您需要依賴兩個站台的網際網路存取以及 NetApp Console 服務的可用度。 |
最佳匹配 |
具有第三個站台,或不允許儲存設備叢集存取網際網路的環境。 |
沒有第三個站台可供調解器使用,或想要避免營運調解器的環境。 |
選擇時請記住以下幾點:
-
*QDevice 仍然需要第三個位置。*ONTAP Cloud Mediator 移除的是中介主機,而不是 corosync QDevice 主機。QDevice 需要一台所有 Proxmox VE 節點都可以透過 TCP 連接埠 5403 存取的小型 Linux 主機,而且它沒有像 corosync 那樣的低延遲要求。
-
*兩個叢集都需要存取 NetApp Console。*如果叢集使用 Proxy,請在兩個叢集上安裝 Proxy 的根目錄 CA 憑證。NetApp 建議每個叢集使用不同的 Proxy 伺服器。
-
*無論選擇哪一種選項,都應規劃相同的故障行為。*當中介器無法使用時,複寫會繼續進行且無資料遺失,但在中介器再次可用之前,無法進行自動和計畫性的容錯移轉。使用 ONTAP Cloud Mediator 時,這包括從叢集到 NetApp Console 的連線遺失。

|
本節中的中介器選項適用於 SnapMirror 作用中同步。對於 MetroCluster,此解決方案使用 ONTAP 中介器或 MetroCluster Tiebreaker。部署前,請確認您的 ONTAP 版本、中介器選項和 Proxmox VE 版本是否一起列在 "NetApp 互作業性矩陣工具(IMT)" 中。 |
服務提供者的效益
-
*超越主機 HA 的虛擬機器可用度。*當裝載其磁碟的儲存系統發生故障時,租戶虛擬機器仍可繼續運作。ONTAP 容錯移轉至第二個 AFF 叢集,且虛擬機器無需重新啟動即可在同一個共享儲存設備上恢復 I/O。
-
*進階可用度分層。*您可以在同一個叢集中,將零 RPO、具備儲存彈性的 VM 服務作為附加服務,與未受保護儲存設備上的標準分層一起提供。
-
*按租戶保護與容錯移轉。*透過為每個租戶或服務分層提供分隔的受保護儲存設備,您可以獨立保護、容錯移轉及測試每個租戶的災難恢復,而不會影響其他租戶。
-
*更好地利用兩個站台。*您可以將某些工作負載主要放在站台 A,而將其他工作負載主要放在站台 B,這樣兩個資料中心都可以服務作用中的工作負載。
企業效益
-
在儲存設備或站台故障期間,業務關鍵型 VMs 零資料遺失。
-
自動恢復,無需腳本、儲存設備重新掛載或變更
/etc/pve/storage.cfg。 -
內建於 ONTAP 中,Proxmox VE 節點上無需額外的軟體階層。
-
*透過單一介面進行日常操作。*Storage Manager for Proxmox 配置受保護的共享儲存設備,並使用 ONTAP 快照與 FlexClone 技術來備份、還原及複製虛擬機器。
解決方案如何應對故障
ONTAP 和 Proxmox VE 各自獨立做出法定人數決定。該設計使它們保持一致,以便兩者都選擇同一個存活站台。
| 事件 | ONTAP 行為 | Proxmox VE 行為 |
|---|---|---|
站台 A 故障 |
中介器確認故障後,ONTAP 會自動將共享儲存設備容錯移轉至叢集 B。 |
站台 B 節點和 QDevice 保持仲裁。HA 隔離站台 A 節點,並在站台 B 節點上重新啟動其虛擬機器。儲存設備容錯移轉後,已在站台 B 上的虛擬機器恢復 I/O。 |
AFF 叢集 A 發生故障,站台 A 上的 Proxmox VE 節點繼續運作 |
中介器確認叢集 A 無法連線,ONTAP 會自動將共享儲存設備容錯移轉至叢集 B。 |
無需更改仲裁,也無需重新啟動虛擬機器。儲存設備容錯移轉後,所有節點上的虛擬機器都在同一共享儲存設備上恢復 I/O,而站台 A 的節點透過站台間網路連接到叢集 B。 |
A 站台的一台 AFF 控制器發生故障 |
合作夥伴控制器在本地 HA 接管中接管。不會發生 SnapMirror 作用中同步容錯移轉。 |
無影響。虛擬機器在接管期間會短暫暫停 I/O。 |
站台 B 故障 |
叢集 A 繼續提供資料。當站台 B 恢復運作時,複寫將恢復。 |
站台 A 的節點和 QDevice 保持仲裁。HA 在站台 A 的節點上重新啟動站台 B 的虛擬機器。 |
站台間連結故障 |
叢集 A 繼續提供資料。未發生容錯移轉。 |
當決勝斷路器與主要叢集一致時,QDevice 會將其選票投給站台 A 分割區。站台 B 節點失去仲裁並自我隔離,HA 會在站台 A 上重新啟動其虛擬機器。 |
站台 C 故障,或叢集失去對 NetApp Console 的存取 |
複寫持續進行且零資料遺失,但在中介器可用之前,無法進行自動和計畫性的容錯移轉。使用 ONTAP Cloud 中介器時,站台 C 故障只會影響 QDevice。 |
叢集透過四個節點的投票維持法定人數。沒有虛擬機器受到影響。 |
一個 Proxmox VE 節點發生故障 |
無影響。 |
HA 會在其他節點上重新啟動該節點的虛擬機,優先選擇同一站台的節點。 |
儲存系統故障
儲存系統故障是僅靠主機層級 HA 無法應對的情況,也是 SnapMirror 作用中同步能為服務提供者帶來最大價值的情況。下圖展示了 AFF 叢集 A 故障後的狀態,此時所有 Proxmox VE 節點仍保持線上,並使用 NFS 共享儲存設備。
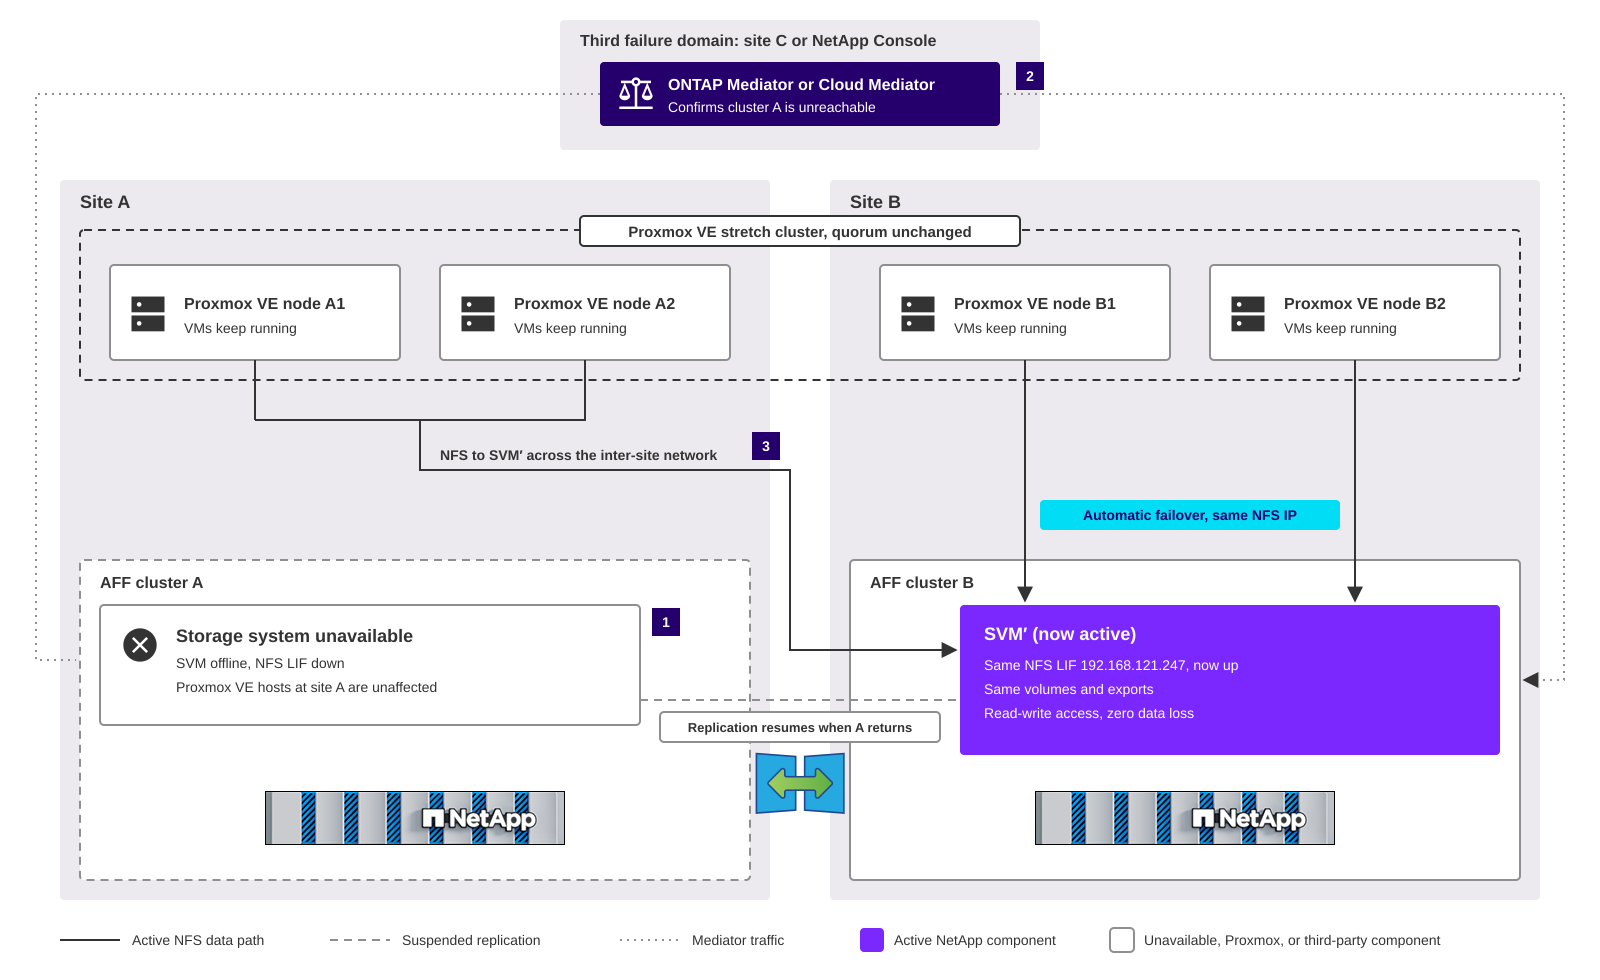
-
AFF 叢集 A 無法使用。站台 A 上的 Proxmox VE 節點繼續運作,因此叢集不會失去仲裁,HA 也不會隔離任何節點。
-
中介軟體(位於站台 C 的 ONTAP Mediator 或 NetApp Console 中的 ONTAP Cloud Mediator)確認叢集 A 無法連線,然後 ONTAP 會啟動叢集 B 上的次要 SVM,其具有相同的 NFS LIF 位址、磁碟區與匯出原則。
-
所有 Proxmox VE 節點在同一共享儲存設備上恢復 I/O。站台 B 的節點在本地存取叢集 B,站台 A 的節點透過站台間網路存取叢集 B。虛擬機器在容錯移轉期間暫停 I/O,無需重新啟動即可繼續運作。
當叢集 A 恢復後,複寫將繼續進行。請規劃在維護所需時間內容錯回復至叢集 A,以便站台 A 的虛擬機器能夠再次存取本機儲存設備。
站台故障
在站台故障期間,該站台的儲存系統和 Proxmox VE 節點都會離線。ONTAP 會將共享儲存設備容錯移轉至存活的叢集,而 Proxmox VE HA 會在存活的節點上重新啟動來自故障站台的 VM,如表中所述。
在 SnapMirror 作用中同步與 MetroCluster 之間進行選擇
NetApp MetroCluster 組態也能為 Proxmox VE 延伸叢集交付零 RPO 和自動恢復。這兩種解決方案的差異在於它們所保護的對象:
-
*MetroCluster 保護所有工作負載。*MetroCluster 結合了陣列型叢集與同步複寫。它會將每個鏡射 Aggregate 中的資料、非揮發性記憶體容量(NVRAM)以及每個 SVM 的組態鏡射到合作夥伴站台,因此叢集上的所有共享儲存設備都會受到保護,而無需針對每個工作負載進行設定。
-
*SnapMirror 作用中同步保護部分工作負載。*您可以選擇要保護的 SVM 或磁碟區,並且可以獨立對每個項目進行容錯移轉。未受保護的工作負載可以共享相同的叢集。
兩種方案都在每個站台保留受保護資料的完整複本,都需要在第三個故障域中設定見證,並且都會增加儲存設備控制器的複寫負載。它們的區別在於保護範圍、容錯移轉精細度和叢集設計。
|
|
在部署任一解決方案之前,請確認您的 ONTAP 版本、MetroCluster 或 SnapMirror 作用中同步組態,以及 Proxmox VE 版本是否一起列在 "NetApp 互作業性矩陣工具(IMT)" 中。 |
MetroCluster 搭配 Proxmox VE 的架構
下圖顯示具有四節點 MetroCluster IP 組態和 NFS 共享儲存設備的 Proxmox VE stretch 叢集。
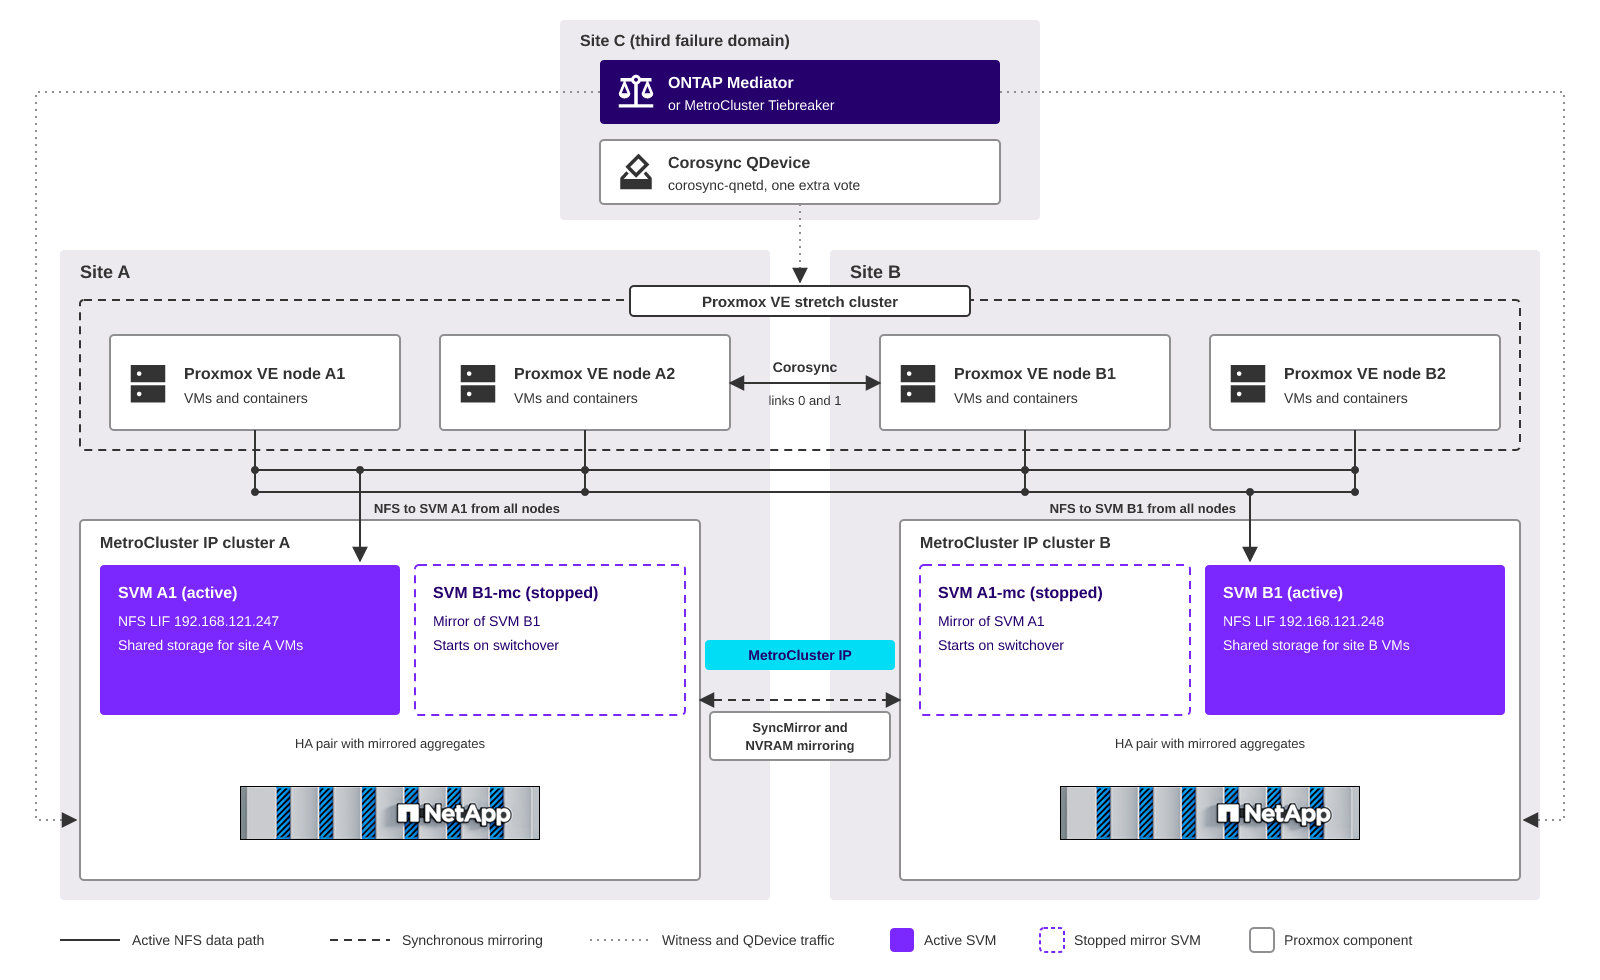
- MetroCluster IP 叢集
-
每個站台都有一個具備鏡射 Aggregate 的 HA 配對。MetroCluster IP 後端網路會將資料(SyncMirror)和 NVRAM 同步鏡射到合作夥伴站台。
- 兩個站台的 SVM
-
每個站台都可以運行自己的 SVM。對於每個 SVM,MetroCluster 會在合作夥伴站台保留一個帶有
-mc後綴的已停止鏡射 SVM,並具有相同的組態和 LIF 位址。 - 來自所有節點的 NFS 存取
-
每個 Proxmox VE 節點都會掛載兩個作用中 SVM(SVM A1 和 SVM B1)的共享儲存設備,以便 HA 可以重新啟動任何節點上的任何 VM。站台 B 的節點可透過站台間網路存取 SVM A1,站台 A 的節點可透過站台間網路存取 SVM B1。這與 SnapMirror 主動同步的存取模型相同。
- 切換
-
如果站台發生故障,站台 C 的 ONTAP Mediator 或 MetroCluster Tiebreaker 會啟用自動切換。倖存站台上的鏡射 SVM 會啟動,並使用相同的 NFS 位址為所有共享儲存設備提供服務,而 Proxmox VE HA 會從故障站台重新啟動 VM。單一控制器故障會由本機 HA 接管來處理,無需進行切換。修理故障站台後,您需要修復 Aggregate 並切換回來。
MetroCluster 如何應對故障
下表顯示 MetroCluster IP 組態和 Proxmox VE 延伸叢集如何回應與 [解決方案如何應對故障] 中相同的故障。在本例中,SVM A1 在站台 A 處於作用中,SVM B1 在站台 B 處於作用中。
| 事件 | ONTAP 行為 | Proxmox VE 行為 |
|---|---|---|
站台 A 故障 |
ONTAP 調解器或 MetroCluster 決勝器確認故障,且 ONTAP 切換站台 A。SVM A1-mc 在站台 B 啟動,並使用相同的 NFS LIF 位址。SVM B1 繼續提供資料。 |
站台 B 節點和 QDevice 保持仲裁。HA 隔離站台 A 節點,並在站台 B 節點上重新啟動其 VM。已在站台 B 節點上執行的 VM 繼續執行,而 SVM A1 上的 VM 在切換後恢復 I/O。 |
MetroCluster IP 叢集 A 發生故障,站台 A 上的 Proxmox VE 節點繼續運作 |
ONTAP Mediator 或 MetroCluster Tiebreaker 確認叢集 A 無法連線,且 ONTAP 切換站台 A。SVM A1-mc 在站台 B 啟動,並使用相同的 NFS LIF 位址。 |
無需更改仲裁,也無需重新啟動虛擬機器。切換後,SVM A1 上的虛擬機器恢復 I/O,站台 A 的節點透過站台間網路連線至站台 B。 |
A 站台的一個控制器發生故障 |
A 站台的 HA 合作夥伴在本地 HA 接管中接管。不會發生切換。 |
無影響。虛擬機器在接管期間會短暫暫停 I/O。 |
站台 B 故障 |
ONTAP 切換站台 B。SVM B1-mc 在站台 A 啟動,並使用相同的 NFS LIF 位址。SVM A1 繼續提供資料。 |
站台 A 節點和 QDevice 保持仲裁。HA 在站台 A 節點上重新啟動站台 B 的 VM,它們在該處存取站台 A 的 SVM B1。 |
站台間連結故障 |
由於兩個叢集仍在運行,因此不會發生切換。每個站台繼續運行各自的 SVM,與合作夥伴站台的鏡射將暫停,直到連結恢復。 |
當決勝斷路器與站台 A 一致時,QDevice 會將其選票投給站台 A 分割區。站台 B 節點會失去仲裁並自我隔離。HA 會在站台 A 節點上的 SVM A1 上重新啟動虛擬機器。由於站台 A 節點無法連線至 SVM B1,因此 SVM B1 上的虛擬機器必須等到連結恢復後才能重新啟動。 |
站台 C 故障 |
鏡射會繼續進行,且零資料遺失,但在見證可用之前,無法進行自動切換。您仍然可以手動切換。 |
叢集透過四個節點的投票維持法定人數。沒有虛擬機器受到影響。 |
一個 Proxmox VE 節點發生故障 |
無影響。 |
HA 會在其他節點上重新啟動該節點的虛擬機,優先選擇同一站台的節點。 |
站台間連結故障是與單一主要站台設計的主要差異。每當兩個站台都裝載作用中 SVM 時(無論是使用 MetroCluster,還是使用兩個方向相反的 SnapMirror 作用中同步 SVM),corosync 判定斷路器只能偏好一個站台。其作用中 SVM 位於另一個站台的虛擬機器將保持停機狀態,直到連結恢復為止。為了限制影響,請在分隔的實體路徑上使用備援的站台間連結,並將最關鍵的虛擬機器放置在判定斷路器偏好之站台的 SVM 上。
功能比較
| 考慮 | 適用於 NAS 的 SnapMirror active sync | MetroCluster IP |
|---|---|---|
保護範圍 |
選定的 SVM 和磁碟區 |
組態中的所有鏡射 Aggregate 和所有 SVM |
容錯移轉精細度 |
每個 SVM 獨立 |
整個站台,透過切換 |
未受保護的工作負載 |
在同一叢集中未受保護的 SVM 上執行 |
可以使用未鏡射的 Aggregate,這些 Aggregate 在切換後會離線,直到您將其設為線上 |
叢集設計 |
兩個獨立的叢集,透過 IP 網路對等連接 |
兩個合作夥伴叢集的一種組態,具有專用的 MetroCluster IP 後端網路 |
站台 C 的見證 |
ONTAP Mediator 或 ONTAP Cloud Mediator |
ONTAP Mediator 或 MetroCluster Tiebreaker |
受保護資料的複本 |
每個站台一台 |
每個站台一個,位於鏡射的 Aggregate 中 |
複寫路徑 |
SnapMirror 透過叢集間 LIF 同步 |
SyncMirror 以及透過 MetroCluster IP 後端網路進行的 NVRAM 鏡射 |
兩個站台的 NFS 位址 |
擴展的第 2 階層 VLAN。搭配 BGP 的 VIP LIF 待定資格判斷 |
擴展的階層 2 VLAN,或搭配 BGP 的 VIP LIF |
站台故障後的恢復 |
容錯回復每個 SVM |
修復集合體,然後切換回復站台 |
選擇指南
-
當儲存設備上的所有或幾乎所有工作負載都需要零 RPO 時,請選擇 MetroCluster,例如當企業僅在叢集上執行任務關鍵型 VM,或服務供應商為每個租戶提供相同的可用度分層時。您將獲得一個保護網域,無需進行每個工作負載的組態。
-
當只有一部分工作負載需要零 RPO 時(例如某些租戶的高階分層),或者當您需要一次對一個租戶或應用程式進行容錯移轉或測試災難恢復時,請選擇 SnapMirror 作用中同步。
-
SnapMirror 適用於 NAS 的作用中同步不支援於 MetroCluster 組態。請為每對叢集使用一種解決方案。
-
本解決方案中的 corosync、QDevice 和 HA 指南同樣適用於這兩種情況。使用 MetroCluster 時,遵守將 QDevice 斷路器與在站台間連結故障時仍持續提供資料的站台保持一致,並使用 HA 節點親和性規則將虛擬機器與其作用中 SVM 保持在同一站台。
-
MetroCluster IP 也支援搭配 BGP 的 VIP LIF,用於站台之間的第 3 階層網路。
Proxmox VE 擴展叢集的 Corosync 注意事項
Proxmox VE 使用 corosync 進行叢集成員管理和仲裁。Corosync 對站台間網路的敏感度高於 SnapMirror 作用中同步,因此請先規劃叢集網路。
延遲和網路設計
-
SnapMirror 作用中同步要求叢集間往返時間(RTT)小於 10 毫秒。Proxmox 建議所有節點之間的 corosync 延遲小於 5 毫秒,因此 corosync 要求設定了解決方案的距離限制。
-
Corosync 需要的是低且一致的延遲,而不是高頻寬。請使用專用網路運行 Corosync,將其與儲存設備和即時移轉流量分隔,以避免儲存設備突發流量導致 Corosync 逾時。
-
在站台之間的分隔實體路徑上設定至少兩個 corosync 連結(例如,連結 0 和連結 1)。如果一條路徑發生故障,Corosync 會使用 Kronosnet 自動切換連結。
在第三個站台使用 QDevice 進行仲裁
將 Proxmox VE 節點平均分配到站台 A 和站台 B,並在站台 C 新增 QDevice。有了四個節點和一個 QDevice,叢集就有五票,而法定人數需要三票,因此任何一個站台發生故障都不會失去法定人數。QDevice 透過 TCP 連接埠 5403 連接到叢集,並且沒有 corosync 的低延遲要求,因此它可以與 ONTAP Mediator 共享站台 C。如果您使用 ONTAP Cloud Mediator,則仍需要第三個位置來放置 QDevice,但它可以是未同時託管 Mediator 的小型 Linux 主機。
與主叢集的斷路器對齊
當站台間連結發生故障,但兩個站台仍可連線至站台 C 時,ONTAP 會讓站台 A 的主要叢集繼續提供資料。QDevice 必須將其選票投給同一個站台。預設情況下,QDevice 會選擇包含最低節點 ID 的分割區。
最佳實務: 在站台 A 的節點上建立 Proxmox VE 叢集,並在參加站台 B 的節點之前,先將站台 A 的其他節點參加叢集,以確保站台 A 擁有最低的節點 ID。如果主儲存設備長時間移轉至站台 B,請將 QDevice tie_breaker 設定更新為站台 B 的節點 ID。
如果 QDevice 改為偏好站台 B,則站台 A 節點將會自我隔離,而 HA 將會在無法存取站台 A 作用中儲存設備的站台 B 節點上重新啟動虛擬機器。
HA 行為和虛擬機器放置
-
Proxmox VE HA 通常會在大約兩分鐘內偵測到故障節點並恢復其虛擬機器,其中包括 60 秒的看門狗隔離逾時。在站台故障期間,SnapMirror 作用中同步容錯移轉和 Proxmox VE HA 恢復並行運作。
-
使用具有節點優先權的 HA 節點親和性規則,將虛擬機器放置在與其主儲存設備位於相同站台的節點上,並允許它們容錯移轉到另一個站台。
-
站台容錯移轉後,請將受影響 VM 的 HA
failback屬性設為0,直到您將儲存設備容錯回復為止。否則,HA 會在站台 A 節點恢復後,立即將 VM 移轉回該節點,而作用中儲存設備仍位於站台 B。 -
確保客體作業系統磁碟逾時時間長於預期的容錯移轉時間,以便客體在儲存設備容錯移轉期間不會報告 I/O 錯誤。
與 Storage Manager for Proxmox 整合
Storage Manager for Proxmox(SMP)為 Proxmox VE 管理員提供單一介面,以資源配置 ONTAP 共享儲存設備,並透過使用 ONTAP 快照與 FlexClone 技術來備份、還原及 Clone 虛擬機器。SMP 透過其 API 連線至 Proxmox VE 叢集與 ONTAP,因此在 Proxmox VE 節點上不需要代理程式。
SMP 和 SnapMirror 作用中同步可防範不同類型的故障。SnapMirror 作用中同步可在儲存設備或站台故障期間保持 VM 運作,但它會同步複寫每次寫入,包括意外刪除、客體更新失敗或被勒索軟體加密的資料。SMP 快照提供時間點複本,以便從這些邏輯故障中恢復。兩者結合使用,可從相同的 ONTAP 儲存設備提供持續可用度和快速的作業恢復。
| 保護階層 | 保護免受 | 恢復點 | 管理工具 |
|---|---|---|---|
SnapMirror主動同步 |
儲存系統故障和站台故障 |
零資料遺失 |
ONTAP |
SMP 備份(ONTAP 快照) |
意外刪除、資料毀損、更新失敗和勒索軟體 |
上次排程或隨需備份 |
SMP |
SnapMirror 非同步連出或 Proxmox Backup Server |
兩個站台遺失以及長期保留 |
上次複寫或備份 |
ONTAP 或 Proxmox Backup Server |
備份與還原
SMP 隨需或依原則建立儲存設備 Volume 的損毀狀況一致或檔案一致備份(做為 ONTAP 快照),並還原個別 VM、儲存設備或資源群組:
-
使用資源群組和備份原則,將相同的排程與保留套用至租戶或應用程式的虛擬機器。
-
對於執行 QEMU 客體代理程式的虛擬機器,請使用檔案一致的備份,以便在 ONTAP 建立快照之前使客體檔案系統處於靜止狀態。
-
SMP 管理作用中的儲存設備。在 SnapMirror 作用中同步容錯移轉之後,請在 SMP 中執行探索,以便將儲存設備對應到叢集 B,然後再執行備份或還原作業。
-
如需兩個站台之外的第三個複本,或需要更長時間的保留,請從受保護的 Volume 新增 SnapMirror 非同步連出關係,或使用 Proxmox Backup Server。
-
SnapMirror 作用中同步不支援防篡改快照,因此請勿在 SMP 中為受保護的 Volume 啟用快照鎖定。
虛擬機器 Clone
SMP 使用 ONTAP FlexClone 技術建立極具空間效率的 VM Clone,用於開發、測試和快速資源配置。在受保護儲存設備中建立的 Clone 會使用兩個站台的複寫頻寬和容量。請將不需要業務連續性的 Clone 和測試儲存設備從 SnapMirror 作用中同步保護中排除。
SMP 放置
-
將 SMP VM 作為 HA 資源執行於受 SnapMirror 作用中同步保護的共享儲存設備上,以便 SMP 在儲存設備或站台故障後仍然可用。
-
在 SMP 中註冊 Proxmox VE 叢集和兩個 ONTAP 叢集,以便 SMP 可以存取任一站台的作用中儲存設備。
適用於 NAS 的 NFS 共享儲存設備,支援 SnapMirror 作用中同步
從 ONTAP 9.19.1 開始,SnapMirror 作用中同步可保護 NAS 工作負載。下列注意事項僅適用於 NFS 共享儲存設備。若要使用 NFS 儲存設備部署解決方案,請遵循 "NAS 組態工作流程"。
SVM 層級保護與網路身分
-
NAS 的 SnapMirror 作用中同步可保護整個儲存設備虛擬機器(SVM)。您可以保護 SVM 中的所有 Volume,也可以排除選取的 Volume。僅支援 FlexVol Volume,且 SVM 不能包含 LUN。
-
次要 SVM 會保持休眠狀態,其 LIF 處於關閉狀態,直到發生容錯移轉為止。ONTAP 會複寫 SVM 組態,包括 LIF IP 位址、匯出原則和 NFS 設定,因此次要 SVM 在容錯移轉後會提供相同的 NFS 端點。
-
對於 NFSv3 及更高版本,容錯移轉不會造成中斷。
-
NAS 的 SnapMirror 作用中同步為作用中/被動,因此站台 B 節點上的虛擬機器會透過站台間網路對主 SVM 進行讀取與寫入。對於兩個站台上的作用中工作負載,請使用兩個複寫方向相反的 SVM,每個站台各一個主 SVM,並讓每個虛擬機器的節點親和性規則遵守其主 SVM 所在的站台。
-
AFF A 系列和 C 系列雙節點叢集支援 NAS 的 SnapMirror 作用中同步。
NFS 用戶端設定
NFS 儲存設備請使用 NFSv3 或 NFSv4.1。保持預設的硬裝載行為,不要新增 soft 裝載選項,以便在容錯移轉期間 NFS I/O 會重試而不是失敗。
為了提高效能和容錯能力,請使用多個 TCP 連線連接到儲存設備。請使用 nConnect 或工作階段中繼,不要同時使用兩者:
-
*nConnect。*對單一 NFS LIF 位址開啟多個 TCP 連線,例如
nconnect=4。nConnect 可與 NFSv3 和 NFSv4.1 以及單一 VIP LIF 位址搭配使用,因此是適用於 NAS 的 SnapMirror 主動式同步的建議選項,包括第 3 階層網路。 -
*工作階段中繼。*將多個資料 LIF 群組為一個 NFSv4.1 工作階段,例如
vers=4.1,trunkdiscovery,max_connect=16。工作階段中繼需要 NFSv4.1 或更新版本。僅當受保護的 SVM 具有多個用戶端可在兩個站台存取的資料 LIF 時才使用,例如在延伸的第 2 層網路中。如需詳細資訊,請參閱 "NFS 中繼"。
有關裝載選項命令和驗證步驟,請參閱"為 Proxmox VE 配置 NFS 存儲"。
使用 SMP 進行 NFS 儲存資源配置
SMP 會資源配置 ONTAP Volume,建立或選擇匯出原則,並將該 Volume 作為 NFS 共享儲存設備裝載到您選擇的 Proxmox VE 節點上。對於受保護的 SVM 中的儲存設備:
-
在主 SVM 中資源配置 Volume,並選擇 NFS LIF 或第 3 階層網路中的 VIP LIF 作為偏好的 LIF。容錯移轉後,次要 SVM 會使用相同的位址,因此儲存設備定義仍然有效。
-
在兩個站台的所有 Proxmox VE 節點上裝載儲存設備,以便 HA 可以在任何節點上重新啟動虛擬機器。
-
請確保匯出原則允許兩個站台上的 Proxmox VE 節點。ONTAP 會將匯出原則複寫至次要 SVM。
-
資源配置完成後,驗證該 Volume 是否包含在 SnapMirror 作用中同步保護中。
具有 VIP LIF 和 BGP 的第 3 階層網路
SnapMirror NAS 的作用中同步要求主要和次要 SVM 具有相同的 IP 位址。當 NFS VLAN 跨站台擴展時,LIF IP 位址會隨 SVM 一起移動。當站台透過路由的階層 3 網路連接時,站台 A LIF 的子網路在站台 B 中不存在。

|
在發行之時,NetApp 尚未記錄將搭配 BGP 的 VIP LIF 作為 NAS 的 SnapMirror 作用中同步的合格組態。在規劃第 3 層設計之前,請向 NetApp 確認目前的支援情況。否則,請在站台之間延伸 NFS VLAN。MetroCluster IP 組態支援搭配 BGP 的 VIP LIF。 |
ONTAP 虛擬 IP(VIP)LIF 解決了這個問題。VIP LIF 不屬於任何子網路。ONTAP 使用邊界閘道協定(BGP)將 VIP 位址作為 /32 主機路由通告給對等路由器,因此該位址可以在站台之間移動而無需擴展 VLAN。
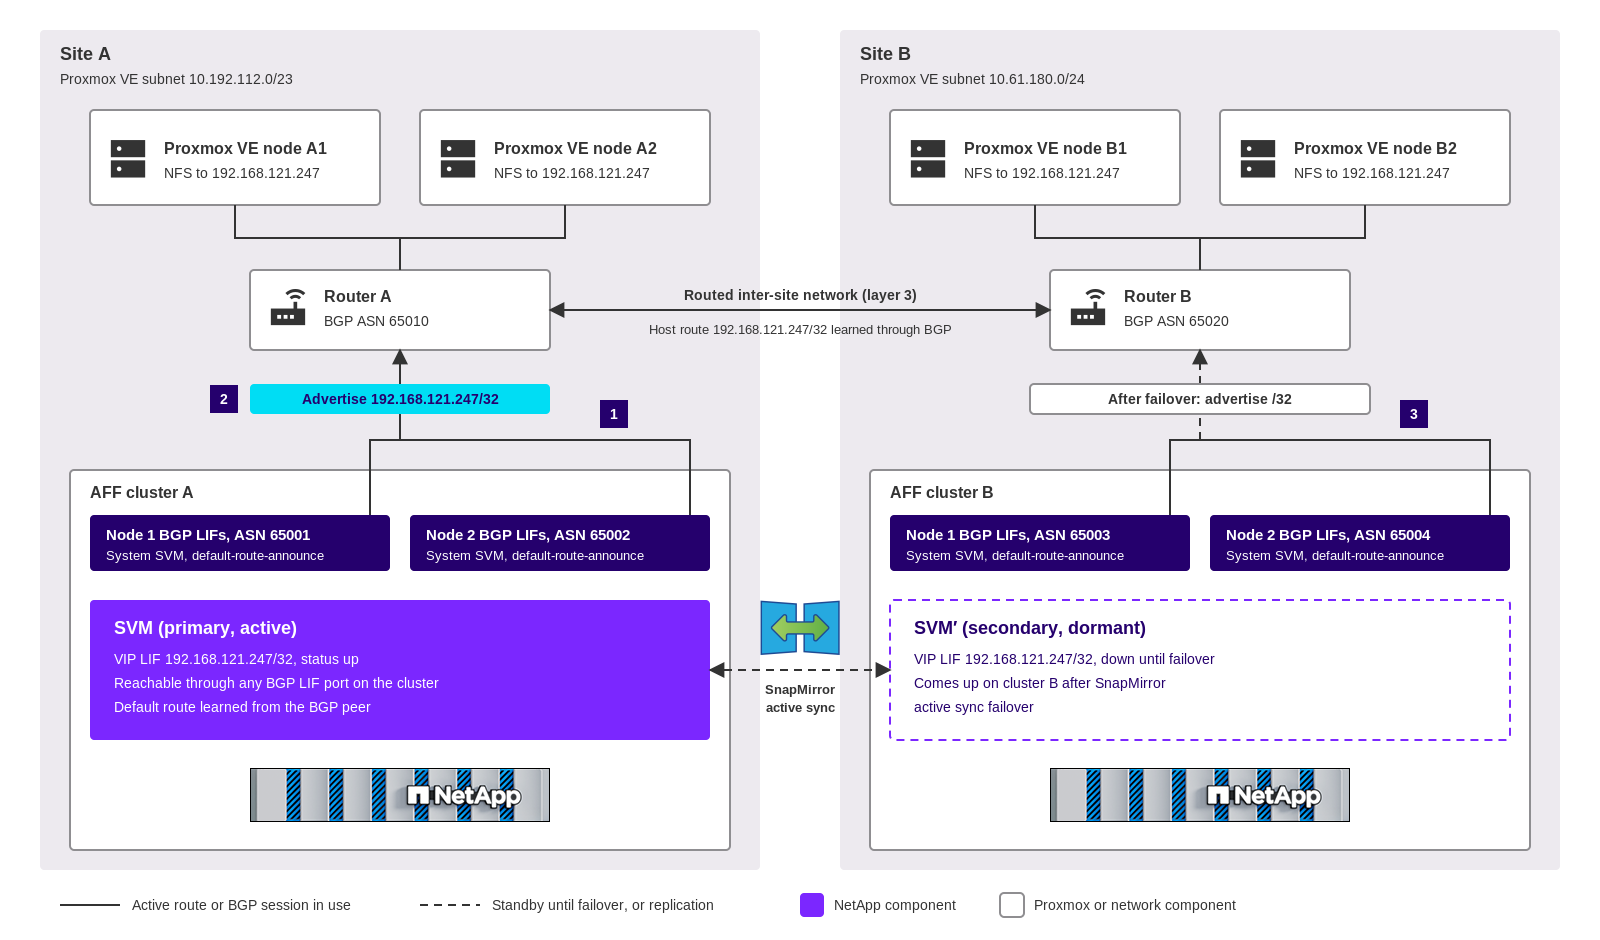
-
兩個站台上的每個節點在系統 SVM 中都有 BGP LIF,這些 LIF 與其站台的路由器建立對等連線。BGP LIF 是節點特定的且不會進行複寫,因此您需要在兩個叢集上設定它們。
-
主 SVM 託管 NFS VIP LIF。叢集 A 通告 /32 主機路由,兩個站台的 Proxmox VE 節點透過路由網路存取儲存設備。
-
在 SnapMirror 作用中同步容錯移轉之後,VIP LIF 在次要 SVM 上啟動,叢集 B 通告主機路由,路由器在站台 B 上收斂。
首次在 ONTAP 中規劃 BGP 時,了解每個 LIF 所屬的 SVM 會有所幫助。BGP LIF 屬於 IPspace 的系統 SVM,而非資料 SVM。每個叢集上的一組 BGP LIF 可服務該 IPspace 中每個資料 SVM 的 VIP LIF,因此您不需要為每個租戶建立 BGP LIF。下圖顯示一個叢集上的 LIF 與連接埠配置,其中 BGP LIF 位於 VLAN 連接埠上。
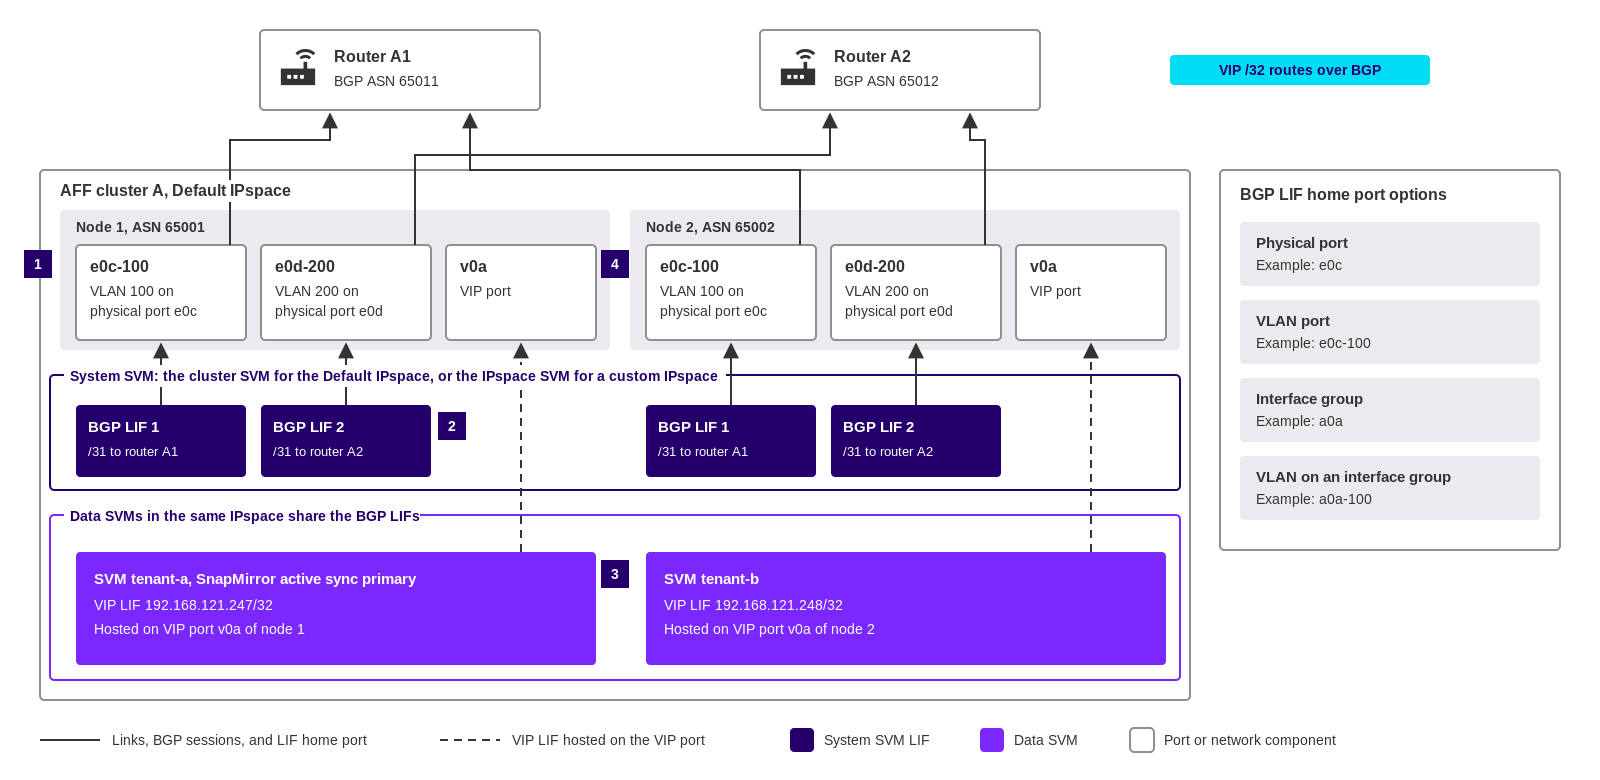
-
每個節點都有兩個用於 BGP 的連接埠,在本例中為 VLAN 連接埠
e0c-100和e0d-200。每個連接埠直接連接到不同的路由器。 -
每個節點在系統 SVM 中都有兩個 BGP LIF,分別位於每個連接埠上,使用 /31 子網路並與一部路由器建立 BGP 對等群組。對於預設 IPspace,系統 SVM 即為叢集 SVM。對於自訂 IPspace,它是與 IPspace 同名的 SVM。
-
同一 IPspace 中的資料 SVM 代管 VIP LIF,且不需要自己的 BGP LIF。BGP 對等群組會通告 IPspace 中所有 SVM 的 VIP 路由。
-
當您建立第一個 BGP 對等群組時, ONTAP 會在每個節點上建立一個 VIP 連接埠,例如
v0a。VIP LIF 託管在 VIP 連接埠上,並且可透過在 IPspace 中託管 BGP LIF 的節點上的每個連接埠來存取。
BGP LIF 的主連接埠可以是實體連接埠、VLAN 連接埠、介面群組或介面群組上的 VLAN。介面群組並非必需。NetApp 技術報告 TR-4949 建議每個 IPspace 使用兩個 BGP LIF,分別位於兩個分隔的連接埠上,每個 LIF 直接連接到不同的第一跳路由器。
請牢記以下準則:
-
BGP LIF 不會容錯移轉。備援機制來自每個節點的兩個 BGP LIF,每個 LIF 分別與不同的路由器建立對等關係。如果某個節點遺失了所有與某個 SVM 相關的 BGP 工作階段,ONTAP 會將該 VIP LIF 移至另一個與該 SVM 具有作用中 BGP 工作階段的節點。
-
使用外部 BGP (eBGP),為每個 ONTAP 節點和每個路由器指派唯一的私有自治系統編號 (ASN)。
-
每個 BGP LIF 及其路由器使用 /31 子網路(子網路遮罩 255.255.255.254)。將奇數位址指派給 BGP LIF,將偶數位址指派給路由器。
-
ONTAP 不處理來自路由器的路由。請設定路由器,使其接受來自 ONTAP 的 /32 主機路由,並且不要向叢集發送路由更新。
-
Proxmox VE 節點不得與 VIP 位址共享子網路。節點與儲存設備之間的路徑上必須有備援的階層 3 路由器,例如支援 VRRP 或 HSRP 的路由器。
-
設定 BGP 對等群組
-use-peer-as-next-hop true,以便每個叢集都能從其本機路由器學習到預設路由。容錯移轉後,指向站台 A 閘道的路由在站台 B 將失效。 -
啟用多重路徑路由,使出站 VIP 流量使用所有可用的 BGP LIF 連接埠。
-
將 BGP 保持時間從預設的 180 秒降低。TR-4949 建議保持時間為 3 秒。路由器僅在保持定時器逾時時才會從故障叢集中撤迴路由,並且在儲存系統故障期間,站台 A 的路由器將保持線上。