


Analyse eines MetroCluster Leistungsereignisses auf einem Cluster in Active IQ Unified Manager
 Änderungen vorschlagen

 PDFs

Mit Unified Manager lässt sich der Cluster in einer MetroCluster Konfiguration analysieren, auf dem ein Performance Ereignis erkannt wurde. Dabei lassen sich der Cluster-Name, der Zeitpunkt der Ereigniserkennung sowie die beteiligten bully und victim Workloads identifizieren.
-
Sie benötigen die Rolle „Operator“, „Application Administrator“ oder „Storage Administrator“.
-
Für eine MetroCluster Konfiguration müssen neue, bestätigte oder veraltete Performance Ereignisse vorliegen.
-
Beide Cluster in der MetroCluster Konfiguration müssen von derselben Instanz des Unified Manager überwacht werden.
-
Die Seite Ereignisdetails enthält Informationen zum Ereignis.
-
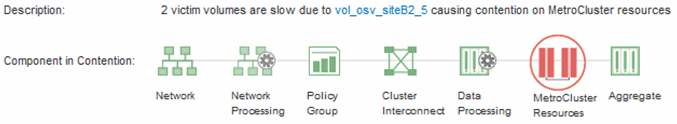
Die Ereignisbeschreibung enthält die Namen der beteiligten Workloads und deren Anzahl.
In diesem Beispiel ist das Symbol MetroCluster Resources rot, was darauf hinweist, dass die MetroCluster Ressourcen umkämpft sind. Wenn sich der Mauszeiger über dem Symbol befindet, wird eine Beschreibung des Symbols angezeigt.
-
Der Clustername und der Zeitpunkt der Ereigniserkennung können zur Analyse von Performance Ereignissen auf dem Partnercluster verwendet werden.
-
In den Diagrammen ist zu prüfen, ob die Antwortzeiten der victim-Workloads über dem Performance-Schwellenwert liegen.
In diesem Beispiel wird die betroffene Arbeitslast im Hover-Text angezeigt. Die Latenzdiagramme zeigen auf hoher Ebene ein konsistentes Latenzmuster für die betroffenen Arbeitslasten. Obwohl die anormale Latenz der betroffenen Arbeitslasten das Ereignis ausgelöst hat, könnte ein konsistentes Latenzmuster darauf hindeuten, dass die Arbeitslasten innerhalb ihres erwarteten Bereichs arbeiten, ein I/O-Spitzenwert jedoch die Latenz erhöht und das Ereignis ausgelöst hat.
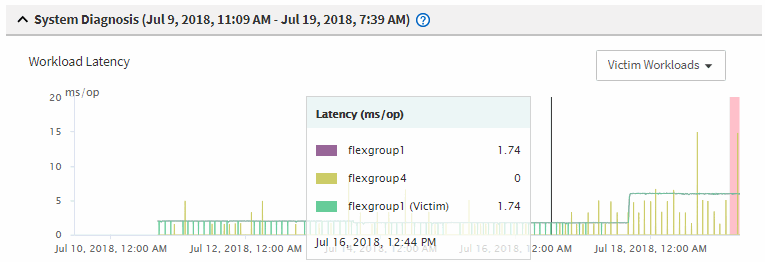
Wenn Sie kürzlich eine Applikation auf einem Client installiert haben, die auf diese Volume Workloads zugreift und diese Applikation eine hohe Anzahl von E/A-Operationen an sie sendet, ist möglicherweise mit einem Anstieg ihrer Latenzzeiten zu rechnen. Wenn die Latenz für die Workloads wieder in den erwarteten Bereich zurückkehrt, der Ereignisstatus in „veraltet“ wechselt und länger als 30 Minuten in diesem Status verbleibt, kann das Ereignis wahrscheinlich ignoriert werden. Wenn das Ereignis weiterhin besteht und im neuen Status verbleibt, kann es weiter untersucht werden, um festzustellen, ob andere Probleme das Ereignis verursacht haben.
-
Im Diagramm „Workload Throughput“ wird mit der Auswahl der Option Bully Workloads die Anzeige der Bully Workloads aktiviert.
Das Vorhandensein von besonders ressourcenintensiven Workloads deutet darauf hin, dass das Ereignis möglicherweise durch einen oder mehrere Workloads im lokalen Cluster verursacht wurde, die die MetroCluster Ressourcen übermäßig beanspruchten. Diese Workloads weisen eine hohe Abweichung im Schreibdurchsatz (MB/s) auf.
Dieses Diagramm zeigt auf hoher Ebene das Schreibdurchsatzmuster (MB/s) für die Workloads. Anhand des Schreibdurchsatzmusters in MB/s lassen sich ungewöhnliche Durchsatzraten erkennen, die darauf hindeuten können, dass ein Workload die MetroCluster Ressourcen übermäßig nutzt.
Wenn keine rechenintensiven Workloads an dem Ereignis beteiligt sind, könnte die Ursache ein Systemstatusproblem mit der Verbindung zwischen den Clustern oder ein Performance Problem auf dem Partnercluster sein. Mit Unified Manager kann der Systemstatus beider Cluster in einer MetroCluster Konfiguration überprüft werden. Außerdem kann Unified Manager verwendet werden, um Performance Ereignisse auf dem Partnercluster zu prüfen und zu analysieren.