


Best Practices für NAS-Workloads mit hoher Dateianzahl

 Änderungen vorschlagen

 PDFs

Bei der Auslegung von Workloads mit hoher Dateianzahl müssen die Gesamtzahl der öffentlichen Inodes, die Einträge im größten Verzeichnis, die Metadaten-Operationsrate und die Lebenszyklusaufgaben berücksichtigt werden. Diese Informationen werden wie in "Planungsansatz" beschrieben erfasst, anschließend sind diese Empfehlungen heranzuziehen. Die Dateianzahl darf nicht als alleiniger Grenzwert betrachtet werden, und die Datenkapazität allein ist keine ausreichende Grundlage.
Erstellen eines Profils des Namespace vor der Dimensionierung des Speichers
Erfassung oder Schätzung:
-
Aktuelle und maximale Gesamtzahl an Dateien, Verzeichnissen, Datenströmen und ACL-Objekten
-
Jährliches oder Wachstum nach Projektphase
-
Maximale Anzahl pro Sekunde erstellter und gelöschter Dateien
-
Spitzeneinträge in einem Verzeichnis
-
Verteilung der Dateinamenlängen und Zeichensätze
-
Verwendung von SMB DOS 8.3 oder alternativen NFS-Namen
-
Lese-, Schreib-, Such-, Attribut-, Enumerations-, Umbenennungs- und Löschraten
-
Snapshot Zeitplan und Aufbewahrung
-
Häufigkeit von Backup, Replikation, Migration, Analysen und Sicherheitsüberprüfungen
Es empfiehlt sich, Höchstwerte anstelle von Tagesdurchschnitten zu verwenden. Build Pipelines, Analyseaufträge, Migrationen und temporäre Scratch-Workflows erstellen oft für kurze Zeit ihren größten Namespace und bereinigen ihn anschließend, aber die Inode- und Verzeichnisdateien können nach der Bereinigung Höchststände beibehalten.
Die Größen von maxfiles und maxdir-size können unabhängig voneinander festgelegt werden.
Zwei separate Prognosen werden beibehalten:
-
Volume Inode Vorhersage: alle öffentlichen Dateisystemobjekte, die im FlexVol oder in jedem FlexGroup Bestandteil erwartet werden.
-
Prognose für das größte Verzeichnis: Verzeichnisdatei-Bytes auf dem Datenträger für das Verzeichnis mit den meisten oder größten Namen.
Ein Wert darf nicht vom anderen abgeleitet werden. Ein Sharded Namespace (Dateien verteilt auf viele Verzeichnisse) kann `maxfiles`auch ohne Erstellung eines großen Verzeichnisses an seine Grenzen stoßen. Ein einzelnes flaches Verzeichnis kann die `maxdir-size`Grenze erreichen, obwohl das Volume Millionen freier Inodes aufweist.
Die Größe sollte bei NTFS oder stark durch ACLs eingeschränkten Namensräumen nicht allein anhand der Anzahl sichtbarer Dateien berechnet werden maxfiles. Verzeichnisse, ACL-Inodes, benannte Datenströme und andere öffentliche Objekte sollten in die Prognosen einbezogen werden. Bei starker ACL-Nutzung sollte als konservative Ausgangsschätzung für `files`bis zum Doppelten der prognostizierten Anzahl von Dateien und Verzeichnissen angesetzt und dies anschließend mit repräsentativen Daten validiert werden, da die gemeinsame Nutzung von ACLs die tatsächliche Nutzung reduzieren kann.
-
Bei Volumes mit einer hohen Anzahl an Dateien sollte
filesauf den aktuellenfiles-maximum-possiblegesetzt werden, sofern Volume-Größe und Protokollbeschränkungen dies zulassen. Diese Obergrenze reserviert keinen Speicherplatz im Voraus; sie ermöglicht esfiles-used, bis zur zulässigen Grenze zu wachsen, statt wiederholte Erhöhungen zu erfordern. -
Eine Erhöhung `maxdir-size`ist nur bei nachgewiesenem Bedarf für ein einzelnes Verzeichnis erforderlich, typischerweise in Schritten von ca. 2 %. Siehe "Steuerung von maxfiles" und "Was passiert, wenn maxdir-size überschritten wird?".
Eine Sharded-Verzeichnisstruktur ist vorzuziehen.
Es gibt drei gängige Namespace-Layouts.
-
Flat: Ein oder wenige Verzeichnisse enthalten viele Dateien auf derselben Ebene.
-
Breit: Viele Verzeichnisse der obersten Ebene unterteilen die Dateien.
-
Tief: Weniger Verzeichnisse der obersten Ebene führen zu mehreren Ebenen von Unterverzeichnissen.
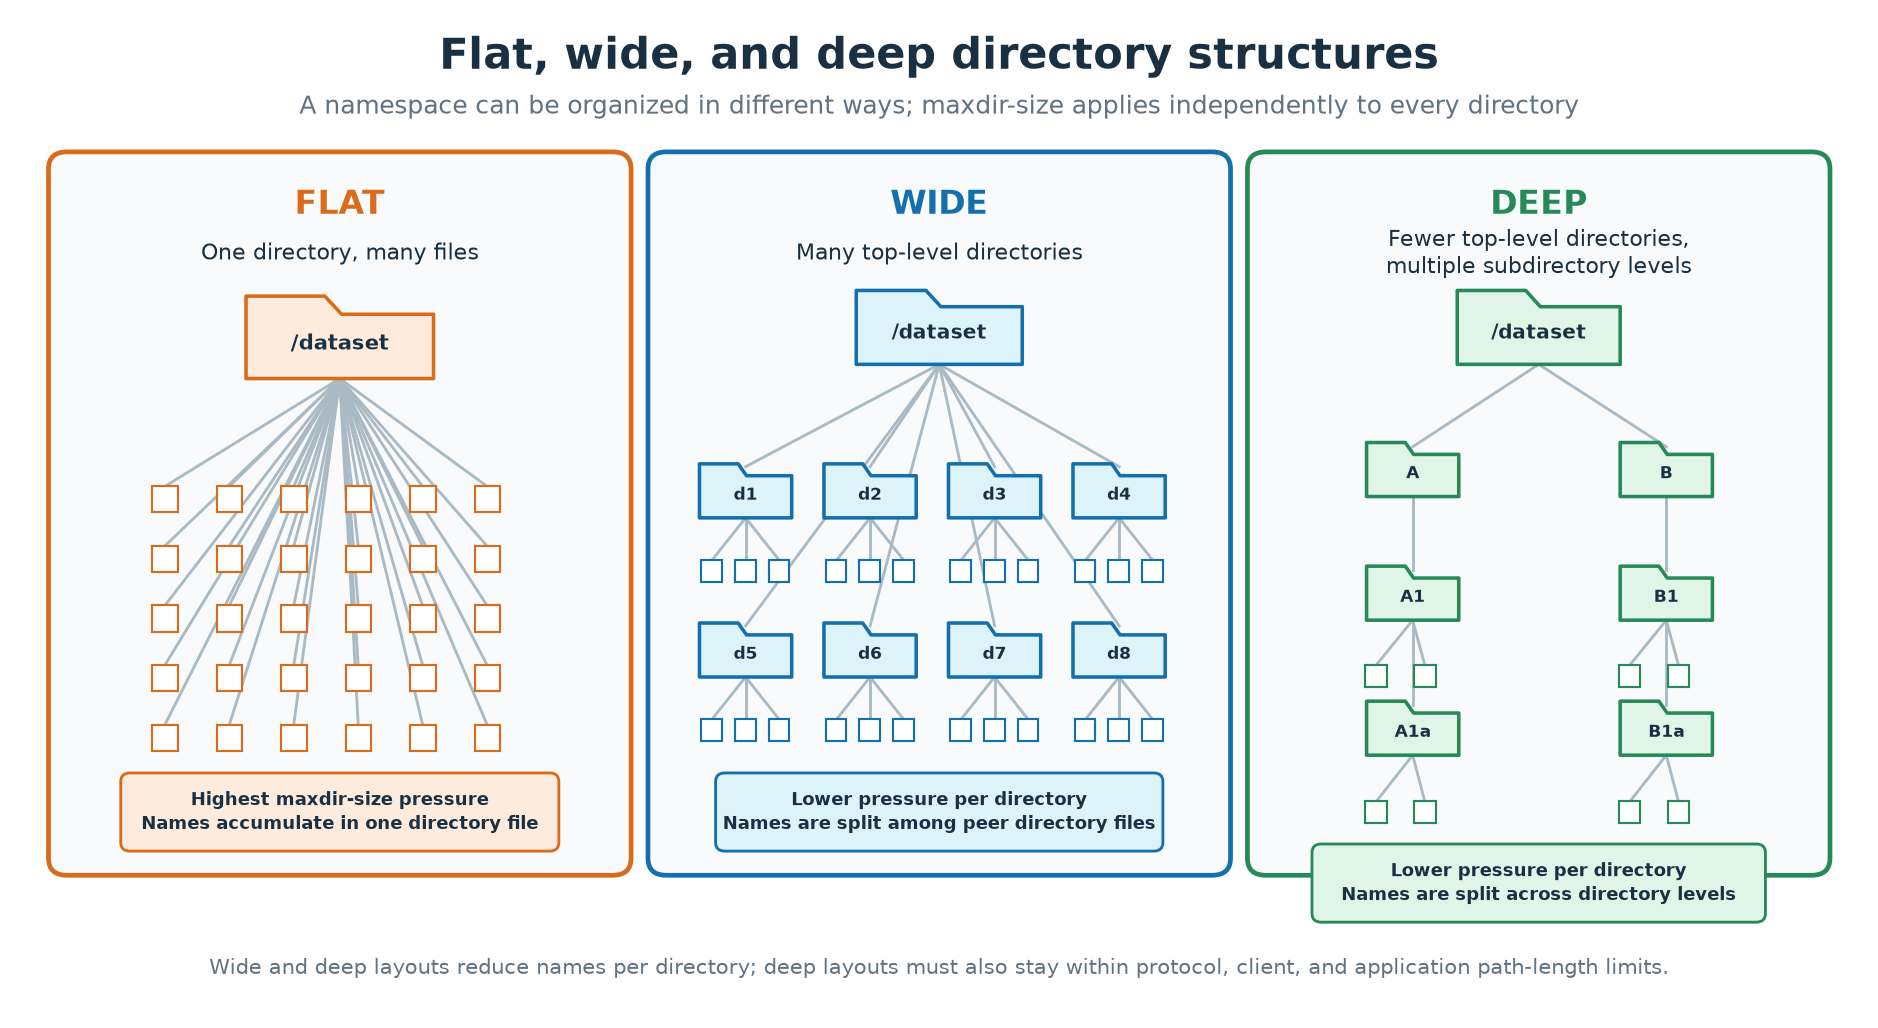
Wenn möglich, sollte vermieden werden, Millionen von Namen auf einer einzigen flachen Verzeichnisebene zu speichern, falls die Anwendung eine breite oder tiefe Hierarchie nutzen kann. Flache Verzeichnisstrukturen konzentrieren Speicher- und CPU-Last und können die Latenz bei Massen GETATTR, READDIR, Such- und Löschvorgängen erhöhen. In einem FlexGroup Volume kann ein großes flaches Verzeichnis außerdem mehr entfernte Einträge erzeugen, wodurch sich die Verzeichnisdatei `maxdir-size`früher annähert als bei derselben Anzahl sichtbarer Namen in einem FlexVol.
FlexGroup Volumes funktionieren im Allgemeinen besser mit vielen kleineren Verzeichnissen als mit einem großen, flachen Verzeichnis. Verzeichnisse mit weniger als etwa 2 MiB bleiben auf dem einfachen Scanpfad. Ab ONTAP 9.2 werden größere Verzeichnisse automatisch indiziert, was gezielte Suchvorgänge erleichtert. Die Indizierung macht ein sehr großes Verzeichnis jedoch nicht mit einer Sharded-Hierarchie gleichwertig: Enumeration, Wildcard-Scans und die Serialisierung beim Erstellen in einem einzelnen Verzeichnis gelten weiterhin. ONTAP kann FlexGroup untergeordnete Verzeichnisse remote platzieren und dabei die Dateilokalität zum übergeordneten Verzeichnis bevorzugen, wodurch die Remote-Latenz für diese Dateien reduziert wird.
Die Verteilung von Dateien über eine Hierarchie hinweg bedeutet die Verwendung von mehr Verzeichnissen mit jeweils weniger Dateien in jedem Verzeichnis.
Gängige Sharding-Schlüssel sind:
-
Ein Hash Präfix
-
Kunde, Projekt oder Mandant
-
Datums- oder Zeitfenster
-
Datensatz, Job oder Workflow-Phase
-
Objekttyp oder Lebenszyklusstatus
Es sollten genügend Shards gewählt werden, um die Verzeichnisoperationen überschaubar zu halten, aber nicht so viele nahezu leere Verzeichnisse erstellt werden, dass die Verzeichnisanzahl selbst übermäßig wird. Ein deterministisches Schema macht die Platzierung vorhersehbar und ermöglicht es Clients, Dateien zu finden, ohne jeden Shard durchsuchen zu müssen.
Sowohl breite als auch tiefe Layouts können funktionieren. Die vollständigen Pfadlängen sollten innerhalb der Grenzen des NAS-Protokolls, des Client-Betriebssystems und der Anwendung bleiben. Wenn ein flaches Layout unvermeidbar ist, sollten die aktuelle Größe und der verfügbare Spielraum der größten Verzeichnisdatei wie in `maxdir-size`"maxdir-size und aktuelles Verzeichnis Größe anzeigen" beschrieben überwacht und geprüft werden, ob eine kontrollierte Vergrößerung angemessen ist.
Auswahl der geeigneten Volume-Architektur
FlexVol
Ein FlexVol Volume ist zu verwenden, wenn die Kapazität eines Volumes (weniger als 1 TB), die Inode-Skalierung (weniger als 2 Milliarden) und die Performance-Domäne für den Workload ausreichen (geringere Aufnahme, weniger Clients). FlexVol Volumes sollten auch für Workloads in Betracht gezogen werden, bei denen im Cluster viele Volumes/Dateisysteme erstellt werden müssen und dadurch das Risiko besteht, die Gesamtzahl der Volumes zu erreichen (z. B. bei Kubernetes PVCs), oder für VMware Datastores.
FlexGroup
Verwenden Sie FlexGroup, wenn der Workload von größerer Gesamtkapazität (>300TB), Dateianzahl im großen Maßstab (>2 Milliarden) und Parallelität über Constituents und Nodes hinweg profitiert.
Planung für:
-
Inode Grenzwerte und Verteilung pro Bestandteil
-
NFS 64-Bit-Dateibezeichner, wenn die FlexGroup etwa zwei Milliarden Dateien überschreiten kann (siehe "NFS 64-Bit-Dateikennungen und FlexGroup Dateianzahlen")
-
Gesamt- und Teilkapazitätsbilanz (Hinweis: Für NetApp AFX ist dies nicht erforderlich)
-
Verhalten bei der Workload-Platzierung
-
FlexGroup spezifische Verzeichniseintragsdarstellung
-
Kompatibilität des Datenschutzes
-
Anwendungsverhalten bei verteilter Ablage von Dateien
Eine FlexGroup parallelisiert Operationen in einem logischen Verzeichnis nicht automatisch. Sharding über Verzeichnisse hinweg bleibt für eine ausgewogene Leistungsbalance wertvoll.
Betriebsmarge beibehalten
Ein Dauerbetrieb mit 100 % ausgelasteten Inodes oder der größten Verzeichnisdatei sollte nicht eingeplant werden. Es sollte Marge für unerwartetes Wachstum, temporäre Objekte, in Snapshots gespeicherte Metadaten, ACLs und Streams, Migrationsüberschneidungen, Backup-Arbeiten, FlexGroup Platzierungsungleichgewichte und Softwareänderungen, die Dateinamen verändern, vorgesehen werden.
Die Einstellung files auf den aktuellen Maximalwert stellt eine Obergrenze dar und erlaubt nicht, den Betrieb bis zum Verbrauch des letzten Inodes fortzusetzen. Eine Warnung sollte files-used deutlich vor dieser Obergrenze erfolgen. Für maxdir-size die Anleitung zur Erhöhung um ca. 2 % in "Was passiert, wenn maxdir-size überschritten wird?" gilt, dass sie beschreibt, wie die Obergrenze erhöht wird, und keine allgemeine Betriebsmarge darstellt.
Metadatenkapazität berücksichtigen
Inode-Datei, Verzeichnisdatei, Index, Snapshot und Aggregat-Metadaten sind separat zu budgetieren. Als Basisschätzung für die Inode-Datei sind 288 Byte pro zugewiesenem öffentlichen Inode zu verwenden; siehe "Kapazitätsauswirkungen". Eine Erhöhung files weist diesen Speicherplatz nicht sofort zu. Die maximale zugewiesene Inode-Datei-Kapazität ist als persistent zu behandeln.
Verwenden Sie volume show-space, um die Inode- und Metadatenkapazität zu überprüfen, anstatt jeden CLI-Zähler so umzuwandeln, als wäre er ein Byte-Wert.
Verwendung realistischer Dateinamenszenarien
Mindestens zu testen:
-
Kurze Namen nur mit ASCII-Zeichen
-
Median und hohe Perzentile der Dateinamenlängen des Workloads
-
Nicht-ASCII- oder zusätzliche Unicode-Zeichen bei Verwendung
-
SMB Workloads, die DOS 8.3-Aliase erzeugen
-
Multiprotokollzugriff, der alternative Namen erfordern kann
-
FlexGroup Platzierung repräsentativ für die Produktion
Pfadlänge und Basisnamenslänge sind nicht austauschbar. Ein langer Pfad, der sich über mehrere Verzeichnisse erstreckt, beeinflusst Protokollgrenzen und die Anzahl der Inodes, während jedes Verzeichnis nur seine unmittelbare Komponente speichert.
Tests von Metadatenoperationen, nicht nur des Durchsatzes
Sequenzielle Bandbreitentests sagen das Verhalten bei einer hohen Anzahl von Dateien nicht voraus. Folgendes ist zu berücksichtigen:
-
Datei- und Verzeichniserstellung
-
Suche nach vorhandenen und fehlenden Namen
-
statoder Attributoperationen -
Öffnen und schließen
-
Umbenennen innerhalb und zwischen Verzeichnissen
-
Verknüpfung aufheben und rekursives Löschen
-
Vollständige und partielle Verzeichnisaufzählung
-
Wildcard-Suchen
-
Kalt-Cache- und Warm-Cache-Läufe
-
Gemischter NFS und SMB Zugriff, falls zutreffend
Latenzverteilungen, CPU-Auslastung, Cache-Verhalten, Netzwerklast und Abschlusszeiten werden gemessen. Tests werden während Snapshot-, Replikations-, Analyse-, Backup- und Sicherheitsscan-Vorgängen wiederholt, falls diese Prozesse in der Produktionsumgebung gleichzeitig stattfinden.
Validierung von Lebenszyklusoperationen
Mehr als nur die erste Aufnahme wird getestet:
-
Ausweitung auf die prognostizierte Spitzenzahl
-
Große Löschvorgänge und asynchrone Löschvorgänge
-
Sicherung und Wiederherstellung
-
SnapMirror Initialisierung, Aktualisierung, Failover und Resynchronisierung
-
Workflows mit hohem Clone- oder Snapshot-Aufkommen
-
Volume move oder Storage Failover
-
ONTAP Upgrade und, falls erforderlich, Prüfungen für das Zurücksetzen
-
Migration von FlexVol zu FlexGroup oder zwischen Protokollumgebungen
Verzeichnisindizes müssen möglicherweise am Zielort erstellt oder übertragen werden. Die Übertragung öffentlicher Indizes sollte nur dann aktiviert werden, wenn die Vermeidung von Neuaufbauten die Wiederherstellung wesentlich verbessert; die lokale Suche wird dadurch nicht verbessert. Siehe "Zeitpunkt für die Aktivierung öffentlicher Verzeichnisindexübertragungen".
Überwachen von Inode-Grenzwerten und -Zuweisung
Verfolgung von files-used im Vergleich zu files und inodefile-public-capacity, wie in "Überwachung von Maxfiles, EMS-Ereignissen und ONTAP Erweiterungen" beschrieben. Warnung, bevor files-used files erreicht. Bei FlexGroup Volumes sollten Ereignisse auf Constituent-Ebene untersucht werden, selbst wenn die Gesamtsumme noch Spielraum zu haben scheint.
Überwachung großer Verzeichnisse
Die Verzeichnisdateigröße ist zu messen und EMS-Datei-IDs sind wie in "maxdir-size und aktuelles Verzeichnis Größe anzeigen" beschrieben aufzulösen. Bekannte flache oder Verzeichnisse mit hoher Änderungsrate sind zu inventarisieren, bevor sie Warnungen generieren.
Auf Warnungen reagieren, bevor es zu Ausfällen kommt
Für Inode-Warnungen:
-
Prüfung von
files-used,files,files-maximum-possible, Volumengröße und Kapazität. -
Stellen Sie fest, ob das Wachstum erwartet oder anomal ist.
-
Erhöhen Sie
files, vergrößern Sie das Volume oder entfernen Sie gegebenenfalls unnötige Objekte. -
Bei FlexGroup sind der betroffene Bestandteil und die Platzierungsbilanz zu prüfen.
Bei Warnungen bezüglich der Verzeichnisgröße:
-
Auflösung des Verzeichnis-Inode in einen Pfad.
-
Mithilfe der Messung der aktuellen Verzeichnisdateigröße und der Analyse des Dateinamenverhaltens.
-
Begrenzen Sie das unbegrenzte Wachstum flacher Verzeichnisstrukturen.
-
Namen sollten nach Möglichkeit in neue Verzeichnisse aufgeteilt oder migriert werden.
-
Nur erhöhen
maxdir-size, wenn die Anwendung nicht umstrukturiert werden kann und das Leistungsrisiko bekannt ist.
Warten Sie nicht auf callhome.no.inodes oder wafl.dir.size.max; zu diesem Zeitpunkt schlagen Client-Erstellungsvorgänge bereits fehl.
Löschverhalten verwalten
Das Löschen von Dateien gibt öffentliche Inodes zur Wiederverwendung frei, verkleinert aber nicht die öffentliche Inode-Datei. Ebenso macht das Löschen von Namen aus einem Verzeichnis Verzeichniseinträge wiederverwendbar, reduziert aber normalerweise nicht die Höchstgröße der Verzeichnisdatei.
Große Löschvorgänge können metadatenintensiv sein und vorübergehend private Zombie-Inodes erhöhen. Eine Begrenzung von Client-seitig rekursiven Löschvorgängen (rm -rf ist sinnvoll, wenn diese mit dem Produktionsdatenverkehr konkurrieren.
Ab ONTAP 9.8 wird ein Verzeichnis volume file async-delete direkt aus dem Cluster entfernt, anstatt über NFS oder SMB, wodurch Client- und Netzwerkkonflikte vermieden werden. Dies gilt für FlexVol- und FlexGroup-Volumes. ONTAP scannt den Pfad, löscht zuerst die Inhalte der Unterverzeichnisse und führt anschließend parallele Löschvorgänge aus (standardmäßig 5.000 gleichzeitige Vorgänge; konfigurierbar von 50 bis 100.000). In den Tests gemäß TR-4571 war dies bei einem Verzeichnisbaum mit 24.000 Einträgen etwa 10× schneller als ein einzelner Thread rm -rf.
volume file async-delete start -vserver <svm> -volume <volume> -path /relative/dir
volume file async-delete show
Einschränkungen: Das Volume muss online und eingebunden sein, der Pfad muss ein Verzeichnis (nicht eine einzelne Datei) sein, und es kann jeweils nur ein Job für asynchrones Löschen ausgeführt werden.
Falls ein großes, spärlich bestücktes Verzeichnis weiterhin Probleme bereitet, sollten die verbleibenden Einträge in ein neues Verzeichnis kopiert werden. Das Verkleinern maxdir-size führt nicht zu einer Komprimierung. Siehe "Dünn besetzte Verzeichnisse und Hole Punching".
Knoten und HA-Spielraum planen
Operationen mit einer hohen Anzahl an Dateien beanspruchen CPU, Arbeitsspeicher, Cache und Speicher-E/A auch bei geringem Datendurchsatz. Es sollte ausreichend Reserve für Folgendes vorhanden sein:
-
Metadaten Bursts
-
Cold-Cache-Suche und -Aufzählung
-
Scanner und Datensicherung
-
Storage Failover oder Takeover
-
FlexGroup Remote-Vorgänge
-
Andere Volumes, die sich den Knoten teilen
Arbeitslasten sollten anhand des beobachteten Metadatenbedarfs und nicht nur anhand der Kapazität oder des Durchsatzes ausgeglichen werden. Ein Knoten kann durch Metadaten begrenzt sein, obwohl Netzwerk- und Festplatten-Bandbreite scheinbar verfügbar sind.
Verteilung von Clientverbindungen über Daten-LIFs und Knoten
NAS-Systeme mit vielen Dateien sind oft durch Metadaten gebunden. Eine NFS- oder SMB-Einbindung nutzt typischerweise eine TCP-Verbindung zu einem Daten-LIF, und dieses LIF befindet sich auf einem einzelnen Knoten. Wenn viele Clients, Scanner oder Backup-Aufträge dieselbe Adresse einbinden, verbraucht dieser Knoten CPU-Leistung für die Protokollverarbeitung, selbst wenn der Rest des Clusters im Leerlauf ist. Eine FlexGroup kann Dateivorgänge über das Clusternetzwerk umleiten, dies entlastet jedoch nicht den Knoten, dem die Client-Verbindung gehört.
-
In der SVM werden mehrere Daten-LIFs (Datennetzwerkschnittstellen) erstellt, wobei auf jedem Knoten, der die Workload bedient, mehr als eine LIF vorhanden ist, sodass Clients mehrere Pfade zu jedem Knoten haben.
-
Es muss bestätigt werden, dass jeder Knoten, der teilnehmen soll, mindestens einen Daten-LIF in dieser SVM besitzt.
-
Die Einbindungen sollten gleichmäßig auf diese LIFs und Knoten verteilt sein. Bei der Einbindung per IP-Adresse sollten die Adressen gleichmäßig ausgewählt werden. Wenn Clients per Namen einbinden, sollten mehrere LIF-Adressen hinter einem FQDN bereitgestellt und DNS-Lastverteilung verwendet werden.
-
Die gesamte Workload sollte nicht an eine einzelne LIF oder einen einzelnen Node gebunden werden.
Ein einzelner Client, der NFS nconnect oder SMB Multichannel unterstützt, kann zusätzliche Verbindungen auf einem Mount öffnen. Das hilft diesem Client; es ersetzt jedoch nicht die Verteilung vieler Clients auf LIFs und Knoten.
Aktuelle ONTAP Versionen verwenden
Spätere ONTAP Versionen beinhalten Verzeichnisindizierung, Verbesserungen im Inode-Management, Optimierungen für Sparse-Verzeichnisse, Verzeichnisindexübertragung und weitere Verbesserungen für hohe Dateianzahlen. Bei Upgrade-Entscheidungen müssen weiterhin Plattformunterstützung, Datenschutzkompatibilität und Anwendungsqualifizierung berücksichtigt werden.
Aktivieren Sie eine Funktion nicht allein deshalb, weil sie mit einer hohen Dateianzahl zusammenhängt:
-
Nur bei nachgewiesener Anforderung eines einzelnen Verzeichnisses `maxdir-size`auslösen.
-
Festlegen von
filesauf den aktuellen Maximalwert, wenn dies angebracht ist; siehe "Steuerung von maxfiles". -
Die Verzeichnisindexübertragung sollte nur aktiviert werden, wenn bei der Replikation oder Wiederherstellung Indizes erhalten bleiben sollen.
-
Die Dateisystemanalyse sollte nur aktiviert werden, wenn die gewonnenen Erkenntnisse den Scanaufwand rechtfertigen.
-
Behandeln Sie
-has-dir-index-publicund-has-optimized-sparse-directoriesals Status, nicht als Aktivierungsschalter.
Ab ONTAP 9.17.1 kann die File System Analytics standardmäßig auf neuen Volumes in einer neu erstellten NAS SVM aktiviert sein. Es sollte `-analytics-state`geprüft werden, anstatt anzunehmen, dass sie deaktiviert ist, und ihr Namespace-Scan sollte bei der Qualifizierung einer Arbeitslast mit hoher Dateianzahl berücksichtigt werden.
Dokumentierte Annahmen und Schwellenwerte
Datensatz:
-
Annahmen zu Workload und Dateinamen
-
Maximale Anzahl von Dateien und Verzeichnissen
-
Ausgewählte Ränder
-
Volume und Layout der Bestandteile
-
Data LIF und Client-Mount-Layout
-
filesund `maxdir-size`Werte -
Warnschwellen und zuständige Verantwortliche für die Reaktion
-
Erwartete Aufnahme- und Löschraten
-
Ziele der Wiederherstellung und Migration
-
ONTAP Version und Plattformabhängigkeiten
Das Modell sollte erneut überprüft werden, wenn sich Anwendungsversionen, Dateinamenformate, Aufbewahrungsfristen, Protokolle oder Datenschutz-Workflows ändern.