


Scopri la continuità operativa di Proxmox VE con SnapMirror sincronizzazione attiva

 Suggerisci modifiche

 PDF

Le aziende che eseguono macchine virtuali (VM) business-critical su Proxmox Virtual Environment (VE) e i service provider che ospitano le VM dei clienti su Proxmox VE hanno bisogno che queste VM continuino a funzionare quando un sistema storage o un intero data center va offline. ONTAP SnapMirror active sync replica in modo sincrono lo storage condiviso di un cluster Proxmox VE esteso su due siti ed esegue automaticamente il failover dello storage al sito superstite. Ottieni un recovery point objective (RPO) pari a zero, un ripristino automatizzato senza script o runbook e lo stesso storage condiviso in entrambi i siti, così l'alta disponibilità (HA) di Proxmox VE può riavviare le VM senza alcuna riconfigurazione dello storage. Per lo storage condiviso NFS, la soluzione utilizza SnapMirror active sync per NAS.
Sfide dei clienti
Implementare la resilienza dello storage e del sito per Proxmox VE utilizzando esclusivamente strumenti nativi è difficile:
-
Perdita di dati in seguito a un guasto del sito. La replica dello storage di Proxmox VE e Proxmox Backup Server sono asincroni. Le modifiche apportate dall'ultima replica o dall'ultimo backup andranno perse in caso di guasto del sito primario.
-
Ripristino manuale e lento. Il ripristino in un sito secondario di solito implica la promozione delle repliche, il montaggio dello storage con un indirizzo diverso, l'aggiornamento
/etc/pve/storage.cfge il riavvio delle macchine virtuali. Ogni passaggio manuale aggiunge tempo di inattività e il rischio di errori durante un'interruzione. -
Storage esteso che compete con le VM per le risorse host. Lo storage esteso iperconvergente, come Ceph in modalità stretch, viene eseguito sui nodi Proxmox VE e mantiene due repliche di ogni oggetto in ciascun sito. Il traffico di replica, ripristino e ribilanciamento consuma CPU, memoria e risorse di rete sugli stessi nodi che eseguono le VM.
-
Due decisioni di quorum che devono concordare. Qualsiasi architettura a due siti richiede un witness in un terzo dominio di errore, sia per il cluster sia per lo storage. Se il cluster e lo storage scelgono siti sopravvissuti diversi dopo un guasto del collegamento tra i siti, le VM si riavviano su nodi che non riescono a raggiungere lo storage attivo.
-
Un indirizzo di storage che deve funzionare in entrambi i siti. Dopo un failover dello storage, i nodi Proxmox VE devono raggiungere lo storage condiviso allo stesso indirizzo. Tale indirizzo deve essere raggiungibile in entrambi i siti, il che di solito significa una VLAN di livello 2 estesa tra i siti.
Sfide per i fornitori di servizi
I fornitori di servizi che sviluppano servizi cloud su Proxmox VE si trovano ad affrontare le stesse sfide, con in più gli accordi sul livello di servizio (SLA) dei tenant:
-
Il sistema storage rappresenta un punto di guasto condiviso. Proxmox VE HA protegge le VM dei tenant da un guasto dell'host, ma non da un guasto del sistema storage che ospita i loro dischi. Un'interruzione del sistema storage influisce su tutti i tenant presenti su tale sistema.
-
Impossibile vendere una maggiore disponibilità. Senza replica sincrona e il failover automatico dello storage, un provider non può offrire un livello di disponibilità premium con zero perdita di dati e maggiori garanzie di uptime.
-
Isolamento dei tenant durante il ripristino. I test di ripristino, manutenzione e disaster recovery devono interessare solo i tenant coinvolti, non l'intera piattaforma.
Sfide aziendali
Le aziende che migrano carichi di lavoro mission-critical da altri hypervisor a Proxmox VE si aspettano la stessa resilienza del sito di prima, come ad esempio l'assenza di perdita di dati per database e applicazioni aziendali e il ripristino senza un runbook manuale. Soddisfare tale aspettativa utilizzando esclusivamente gli strumenti nativi di Proxmox VE richiede un notevole impegno in termini di progettazione, scripting e gestione operativa.
Panoramica della soluzione
La soluzione combina un cluster stretch Proxmox VE con la sincronizzazione attiva di SnapMirror sui sistemi NetApp AFF in due siti:
-
RPO zero. ONTAP replica ogni scrittura sullo storage condiviso in modo sincrono dal cluster primario nel sito A al cluster secondario nel sito B.
-
Stesso storage condiviso in entrambi i siti. Dopo un failover, il cluster secondario presenta lo stesso storage a Proxmox VE, quindi le definizioni di storage in
/etc/pve/storage.cfgrestano valide. -
Failover automatico. Un mediatore funge da testimone esterno ai due siti. Puoi installare ONTAP Mediator in un terzo sito oppure utilizzare ONTAP Cloud Mediator, un servizio ospitato in NetApp Console. Quando lo storage primario o il sito si guasta, ONTAP esegue il failover al sito B senza intervento manuale.
-
Controllo granulare. Puoi scegliere quali carichi di lavoro proteggere e puoi eseguire il failover dei carichi di lavoro singolarmente, ad esempio per spostare un tenant o un'applicazione per la manutenzione del sito.
-
Utilizzo della copia secondaria. Puoi clonare la copia secondaria per lo sviluppo, i test o i test di disaster recovery senza compromettere la replica.
Come la soluzione affronta le sfide
| Sfida | Come ti aiuta la soluzione | Cosa hai ancora in programma |
|---|---|---|
Perdita di dati e recupero manuale |
La replica sincrona offre un RPO pari a zero. ONTAP esegue il failover automaticamente e l'SVM secondario presenta lo stesso indirizzo NFS, quindi |
Proxmox VE HA continua a riavviare le VM da un sito guasto. |
Storage esteso sugli host |
La replica viene eseguita sui controller AFF, non sui nodi Proxmox VE, quindi CPU host, memoria e rete rimangono disponibili per le VM. ONTAP mantiene una copia in ogni sito e l'efficienza dello storage si applica a entrambe le copie. |
Come qualsiasi replica sincrona, la soluzione richiede una seconda copia completa nel sito B e la replica aggiunge carico a entrambi i cluster AFF. Dimensiona entrambi i cluster in base al carico di lavoro della replica. |
Due decisioni del quorum |
ONTAP Mediator, o ONTAP Cloud Mediator come servizio nella NetApp Console, è un witness leggero esterno al percorso dei dati. Questa soluzione mostra come allineare il QDevice corosync con il cluster primario in modo che entrambi scelgano lo stesso sito. |
Per il QDevice è ancora necessaria una terza posizione. È necessaria anche per ONTAP Mediator, ma non per ONTAP Cloud Mediator. Vedi Opzioni del mediatore. |
Un indirizzo di storage in entrambe le sedi |
L'SVM secondario assume lo stesso indirizzo NFS LIF, quindi non è necessario alcun rimontaggio o riconfigurazione dello storage. |
La sottorete NFS deve essere raggiungibile in entrambi i siti, in genere tramite una VLAN di livello 2 estesa. Consulta Reti di livello 3 con VIP LIFs e BGP per lo stato di qualificazione delle VIP LIF. |
Il diagramma seguente mostra l'Architettura della soluzione con storage condiviso NFS.
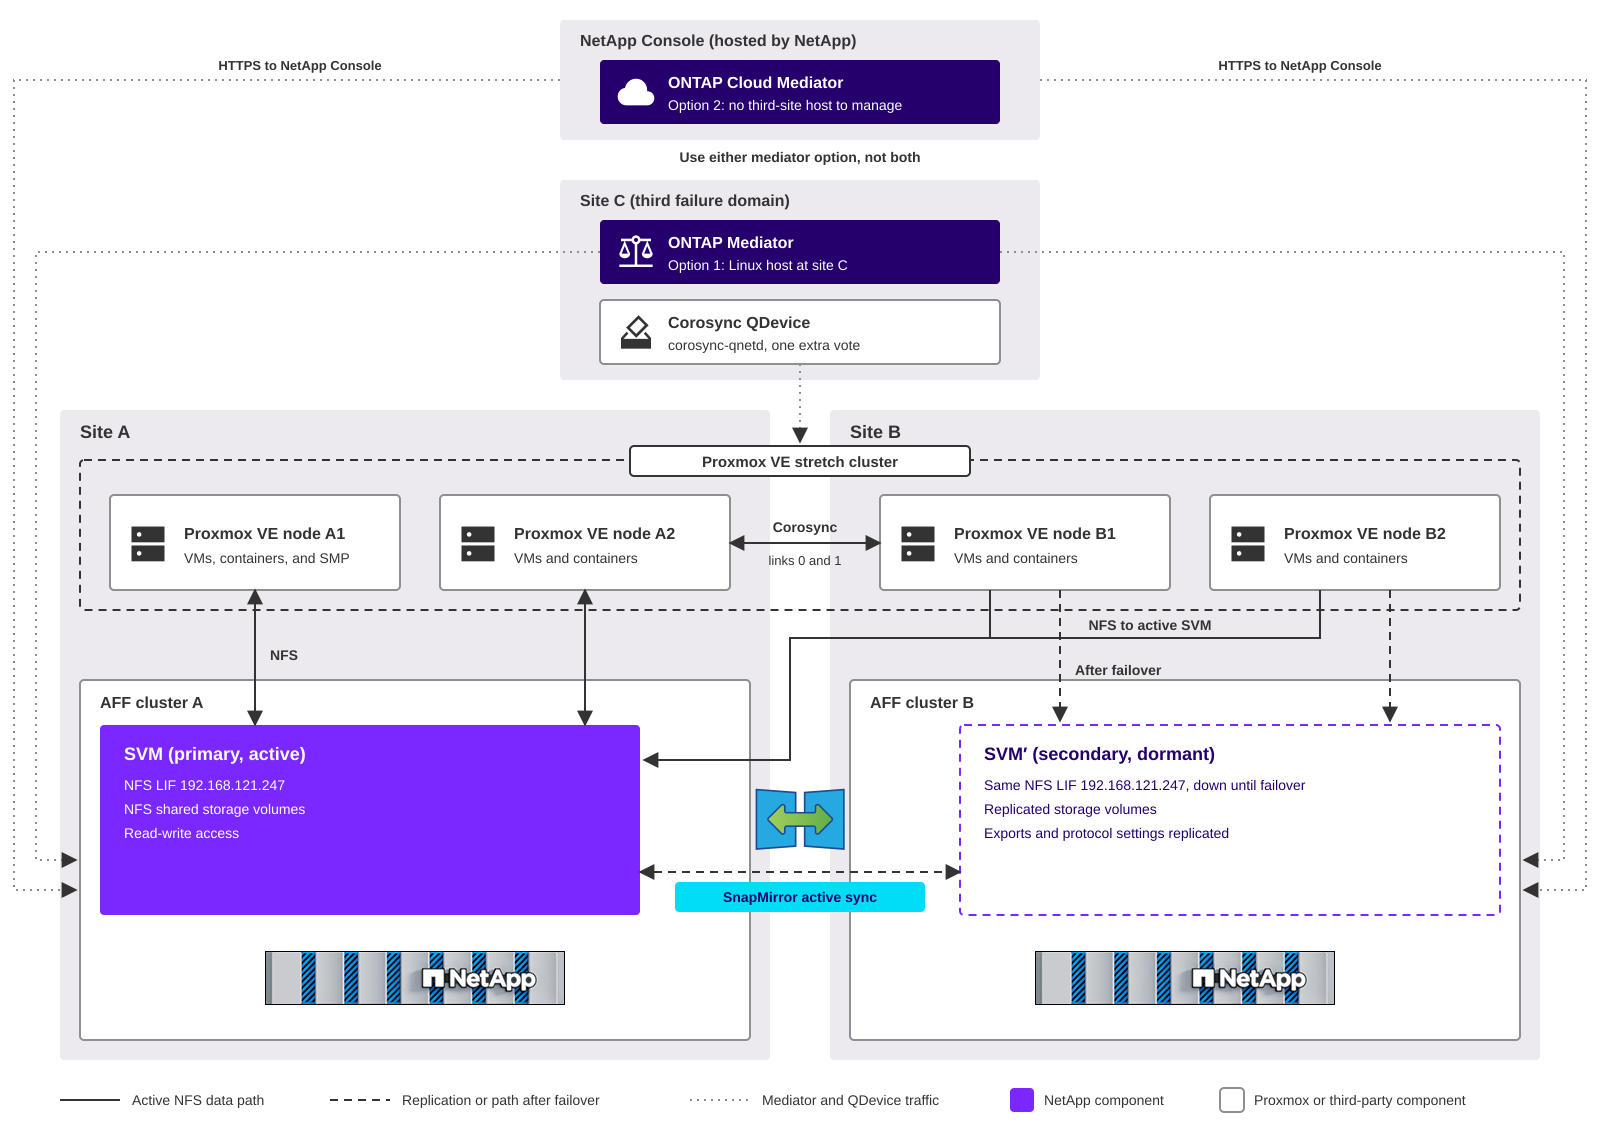
- Sito A e sito B
-
Ogni sito dispone di un cluster a due nodi AFF e di metà dei nodi Proxmox VE. Il cluster primario nel sito A fornisce lo storage condiviso a tutti i nodi Proxmox VE. I nodi nel sito B raggiungono il cluster primario attraverso la rete tra i siti. Con lo storage NFS, l'SVM secondario nel sito B rimane inattivo fino a quando non si verifica un failover.
- Sito C
-
Un terzo dominio di errore ospita il demone corosync QDevice (
corosync-qnetd) e, se scegli l'opzione 1, ONTAP Mediator. QDevice fornisce un voto aggiuntivo in modo che il cluster Proxmox VE mantenga il quorum quando un sito si guasta. - NetApp Console
-
Se scegli l'opzione 2, ONTAP Cloud Mediator viene eseguito come servizio nella NetApp Console, che NetApp ospita e gestisce. Entrambi i cluster AFF si connettono a questo servizio tramite HTTPS, quindi non devi installare né gestire un host mediatore.
- Mediator
-
ONTAP Mediator o ONTAP Cloud Mediator aiuta ONTAP a decidere quale cluster fornisce i dati. Utilizzane uno solo, non entrambi. Per un confronto, vedi Opzioni del mediatore.
- cluster stretch Proxmox VE
-
Tutti i nodi Proxmox VE appartengono a un unico cluster e condividono le stesse definizioni di storage. Proxmox VE HA riavvia le VM da un sito guasto sui nodi rimanenti. Storage Manager for Proxmox (SMP) viene eseguito come VM HA sul cluster per effettuare il provisioning dello storage condiviso e per eseguire il backup, il ripristino e la clonazione delle VM.
Opzioni del mediatore
SnapMirror active sync utilizza un mediatore come testimone passivo. Durante una partizione di rete o il guasto di un cluster, ONTAP utilizza il mediatore per decidere quale copia continua a gestire le operazioni di I/O. Il mediatore non si trova nel percorso dei dati e non avvia autonomamente i failover. Puoi utilizzare una delle seguenti opzioni, ma non entrambe contemporaneamente.
| Considerazione | Opzione 1: ONTAP Mediator | Opzione 2: ONTAP Cloud Mediator |
|---|---|---|
Dove viene eseguito |
Un host Linux che installi e gestisci in un terzo dominio di errore, come il sito C, con alimentazione e infrastruttura di rete indipendenti. |
Un servizio cloud in NetApp Console. NetApp lo ospita e lo gestisce, quindi non ti serve un host mediatore in un terzo sito. |
Versione ONTAP |
ONTAP 9.19.1 o versione successiva per la sincronizzazione attiva di SnapMirror per NAS. |
ONTAP Cloud Mediator è disponibile a partire da ONTAP 9.17.1. SnapMirror active sync per NAS richiede ONTAP 9.19.1 o versioni successive. |
Connettività del cluster |
Entrambi i cluster si connettono all'host mediatore. La porta di servizio predefinita è la 31784. |
Entrambi i cluster si connettono outbound a NetApp Console tramite HTTPS, direttamente o tramite un proxy HTTP. La latenza ping consigliata verso NetApp Console è inferiore a 200 ms. |
Configurazione |
Installa il pacchetto sull'host Linux, quindi aggiungilo ai cluster specificando l'indirizzo dell'host e un utente mediatore. |
Crea un account di servizio NetApp Console con il ruolo ONTAP Mediator Setup Role, quindi aggiungi il mediatore ai cluster con l'ID dell'organizzazione, l'ID client e il segreto client. |
Operazioni |
Applichi patch e aggiornamenti al sistema host e lo mantieni disponibile. |
Nessun host da sottoporre a patch o aggiornare. Dipendi dall'accesso a internet da entrambi i siti e dalla disponibilità del servizio NetApp Console. |
Migliore corrispondenza |
Ambienti che dispongono di un terzo sito o che non consentono ai cluster di storage di raggiungere internet. |
Ambienti senza un terzo sito per un mediatore o che vogliono evitare di gestirne uno. |
Tieni presente quanto segue al momento della scelta:
-
Il QDevice necessita comunque di una terza posizione. ONTAP Cloud Mediator rimuove l'host del mediatore, non l'host del QDevice di corosync. Il QDevice necessita di un piccolo host Linux raggiungibile da tutti i nodi Proxmox VE sulla porta TCP 5403 e non richiede la bassa latenza di corosync.
-
Entrambi i cluster devono avere accesso a NetApp Console. Se i cluster utilizzano un proxy, installa il certificato della CA radice del proxy su entrambi i cluster. NetApp consiglia un proxy server diverso per ciascun cluster.
-
Con entrambe le opzioni, pianifica lo stesso comportamento in caso di errore. Quando il mediatore non è disponibile, la replica continua senza perdita di dati, ma i failover automatici e pianificati non sono possibili finché il mediatore non torna di nuovo disponibile. Con ONTAP Cloud Mediator, questo include una perdita di connettività dai cluster alla NetApp Console.

|
Le opzioni del mediatore in questa sezione si applicano alla sincronizzazione attiva di SnapMirror. Per MetroCluster, questa soluzione utilizza ONTAP Mediator o MetroCluster Tiebreaker. Prima di eseguire il deployment, verifica che la tua versione di ONTAP, l'opzione del mediatore e la versione di Proxmox VE siano elencate insieme in "NetApp Interoperability Matrix Tool (IMT)". |
Vantaggi per i fornitori di servizi
-
Disponibilità delle VM oltre l'HA dell'host. Le VM del tenant continuano a funzionare quando il sistema storage che ospita i loro dischi si guasta. ONTAP esegue il failover al secondo AFF cluster e le VM riprendono le operazioni di I/O sullo stesso storage condiviso senza bisogno di riavvio.
-
Un livello di disponibilità premium. Puoi offrire un servizio VM a RPO zero e resiliente allo storage come componente aggiuntivo, insieme ai livelli standard su storage non protetto negli stessi cluster.
-
Protezione e failover per singolo tenant. Con uno storage protetto separato per ogni tenant o livello di servizio, puoi proteggere, eseguire il failover e testare il disaster recovery per ogni tenant in modo indipendente, senza influire sugli altri tenant.
-
Uso ottimale di entrambi i siti. Puoi impostare alcuni carichi di lavoro come primari nel sito A e altri come primari nel sito B, in modo che entrambi i data center gestiscano carichi di lavoro attivi.
Vantaggi per le imprese
-
Zero perdita di dati per le VM business-critical durante un guasto del sistema storage o del sito.
-
Ripristino automatico senza script, rimontaggi di storage o modifiche a
/etc/pve/storage.cfg. -
Integrato in ONTAP, senza alcun livello software aggiuntivo sui nodi Proxmox VE.
-
Operazioni quotidiane da un'unica interfaccia. Storage Manager per Proxmox esegue il provisioning dello storage condiviso protetto ed effettua il backup, il ripristino e la clonazione delle VM con snapshot ONTAP e la tecnologia FlexClone.
Come la soluzione reagisce ai guasti
ONTAP e Proxmox VE prendono decisioni indipendenti sul quorum. La progettazione li allinea in modo che entrambi scelgano lo stesso sito di sopravvivenza.
| Evento | Comportamento di ONTAP | Comportamento di Proxmox VE |
|---|---|---|
Il sito A ha un guasto |
Il mediatore conferma il guasto e ONTAP esegue automaticamente il failover dello storage condiviso al cluster B. |
I nodi del sito B e il QDevice mantengono il quorum. L'HA isola i nodi del sito A e riavvia le relative VM sui nodi del sito B. Le VM già presenti sul sito B riprendono le operazioni di I/O dopo il failover dello storage. |
Il cluster AFF A si blocca, i nodi Proxmox VE del sito A continuano a funzionare |
Il mediatore conferma che cluster A non è raggiungibile e ONTAP esegue automaticamente il failover dello storage condiviso al cluster B. |
Nessuna modifica del quorum e nessun riavvio delle VM. Le VM su tutti i nodi riprendono le operazioni di I/O sullo stesso storage condiviso dopo il failover dello storage, con i nodi del sito A che raggiungono il cluster B attraverso la rete tra i siti. |
Un controller AFF nel sito A si guasta |
Il partner controller subentra in un takeover HA locale. Non si verifica alcun failover attivo di SnapMirror. |
Nessun impatto. Le macchine virtuali interrompono brevemente le operazioni di I/O durante il takeover. |
Il sito B si guasta |
Il cluster A continua a fornire dati. La replica riprende quando il sito B torna operativo. |
I nodi del sito A e il QDevice mantengono il quorum. L'HA riavvia le VM del sito B sui nodi del sito A. |
Il collegamento tra siti non funziona |
Il cluster A continua a servire i dati. Non si verifica alcun failover. |
Il QDevice assegna il proprio voto alla partizione del sito A quando l'interruttore è allineato con il cluster primario. I nodi del sito B perdono il quorum e si auto-isolano, e HA riavvia le loro VM sul sito A. |
Il sito C non funziona o i cluster perdono l'accesso alla NetApp Console |
La replica continua senza perdita di dati, ma i failover automatici e pianificati non sono possibili finché il mediatore non è disponibile. Con ONTAP Cloud Mediator, un guasto del sito C influisce solo sul QDevice. |
Il cluster mantiene il quorum grazie ai voti dei quattro nodi. Nessuna VM è interessata. |
Un nodo Proxmox VE non funziona |
Nessun impatto. |
HA riavvia le VM da quel nodo su altri nodi, privilegiando i nodi nello stesso sito. |
Guasto del sistema storage
Il guasto di un sistema storage è un caso che l'HA a livello host da sola non può gestire, ed è il caso in cui SnapMirror active sync aggiunge il massimo valore per i service provider. Il diagramma seguente mostra lo stato dopo il guasto del cluster AFF A, mentre tutti i nodi Proxmox VE rimangono online utilizzando lo storage condiviso NFS.
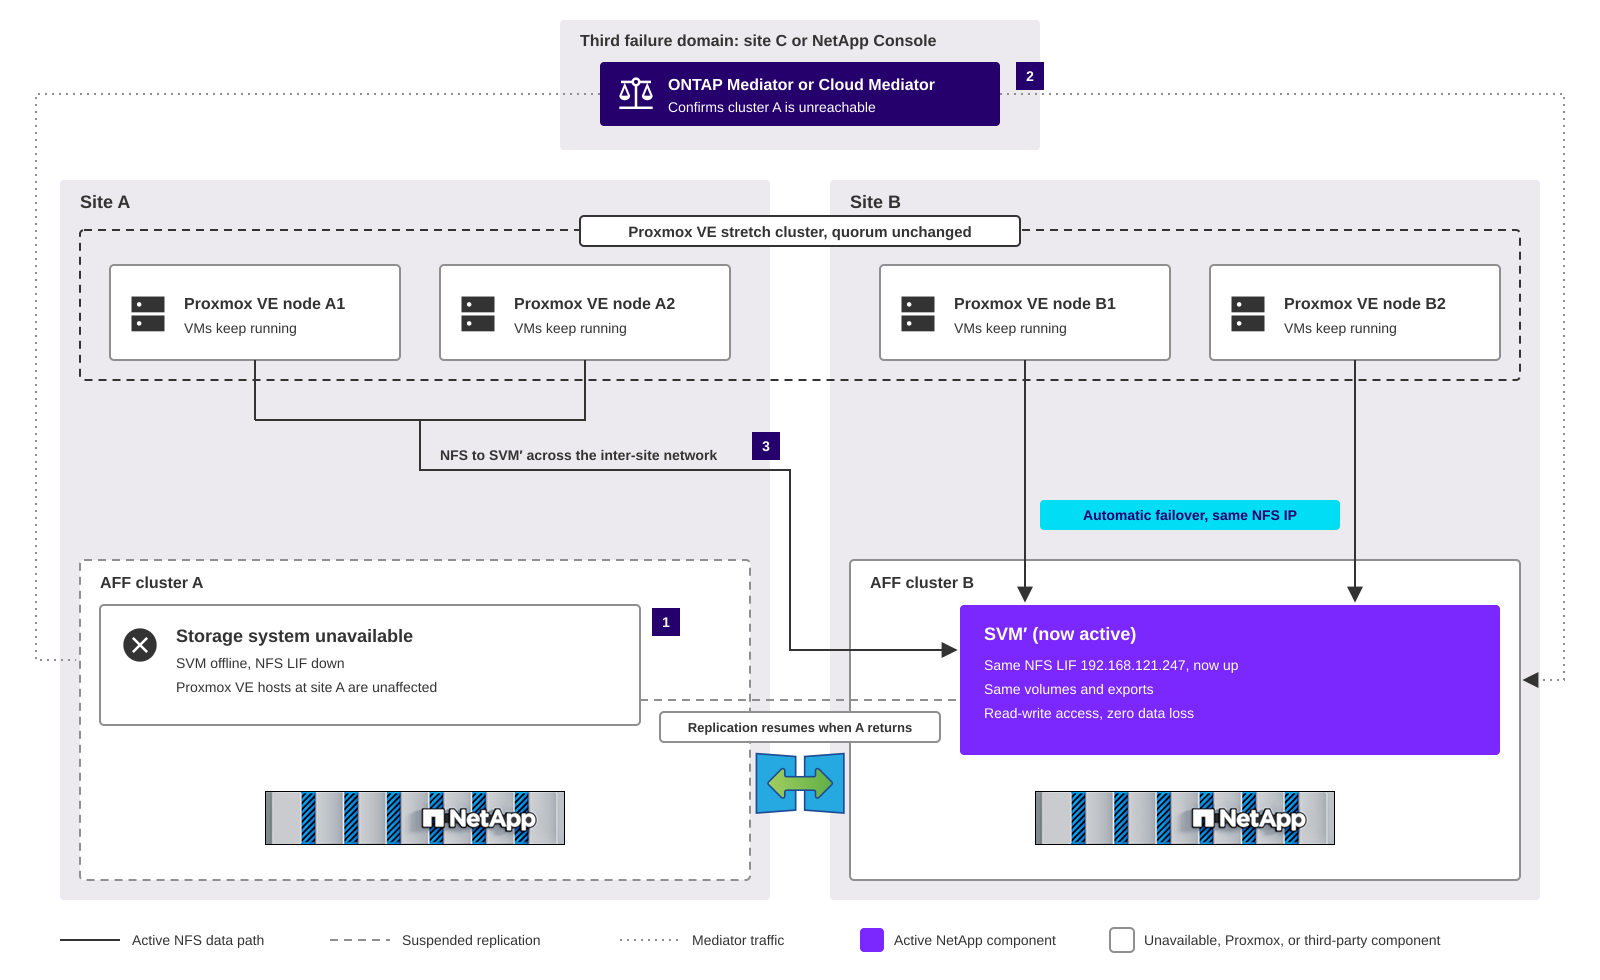
-
Il cluster AFF A diventa non disponibile. I nodi Proxmox VE nel sito A continuano a funzionare, quindi il cluster non perde il quorum e l'HA non isola alcun nodo.
-
Il mediatore, ONTAP Mediator nel sito C o ONTAP Cloud Mediator nella NetApp Console, conferma che il cluster A non è raggiungibile e ONTAP attiva la SVM secondaria sul cluster B con lo stesso indirizzo NFS LIF, gli stessi volumi e le stesse policy di esportazione.
-
Tutti i nodi Proxmox VE riprendono le operazioni di I/O sullo stesso storage condiviso. I nodi del sito B raggiungono cluster B localmente, mentre i nodi del sito A lo raggiungono tramite la rete tra i siti. Le macchine virtuali mettono in pausa le operazioni di I/O durante il failover e continuano a funzionare senza riavviarsi.
Quando cluster A torna operativo, la replica riprende. Pianifica il failback al cluster A durante una finestra di manutenzione in modo che le VM del sito A possano accedere nuovamente allo storage locale.
Guasto del sito
In caso di guasto di un sito, sia il sistema storage che i nodi Proxmox VE di quel sito vanno offline. ONTAP esegue il failover dello storage condiviso sul cluster superstite e Proxmox VE HA riavvia le VM del sito guasto sui nodi superstiti, come descritto nella tabella.
Scegli tra SnapMirror active sync e MetroCluster
NetApp MetroCluster configurations offrono anche RPO pari a zero e ripristino automatico per un cluster stretch Proxmox VE. Le due soluzioni differiscono per ciò che proteggono:
-
MetroCluster protegge tutti i carichi di lavoro. MetroCluster combina il clustering basato su array con la replica sincrona. Esegue il mirroring dei dati in ogni aggregato mirrorato, della memoria non volatile (NVRAM) e della configurazione di ogni SVM nel sito partner, in modo che tutto lo storage condiviso sul cluster sia protetto senza una configurazione per singolo carico di lavoro.
-
SnapMirror active sync protegge un sottoinsieme di carichi di lavoro. Scegli quali SVM o volumi proteggere e puoi eseguire il failover di ciascuno in modo indipendente. I carichi di lavoro non protetti possono condividere gli stessi cluster.
Entrambe le soluzioni mantengono una copia completa dei dati protetti in ogni sito, necessitano di un testimone in un terzo dominio di errore e aggiungono carico di replica ai controller di storage. Differiscono per ambito di protezione, granularità del failover e progettazione del cluster.
|
|
Prima di implementare una delle due soluzioni, verifica che la tua versione di ONTAP, la configurazione di sincronizzazione attiva di MetroCluster o SnapMirror e la versione di Proxmox VE siano elencate insieme in "NetApp Interoperability Matrix Tool (IMT)". |
MetroCluster architettura con Proxmox VE
Il diagramma seguente mostra un cluster esteso Proxmox VE con una configurazione IP MetroCluster a quattro nodi e storage condiviso NFS.
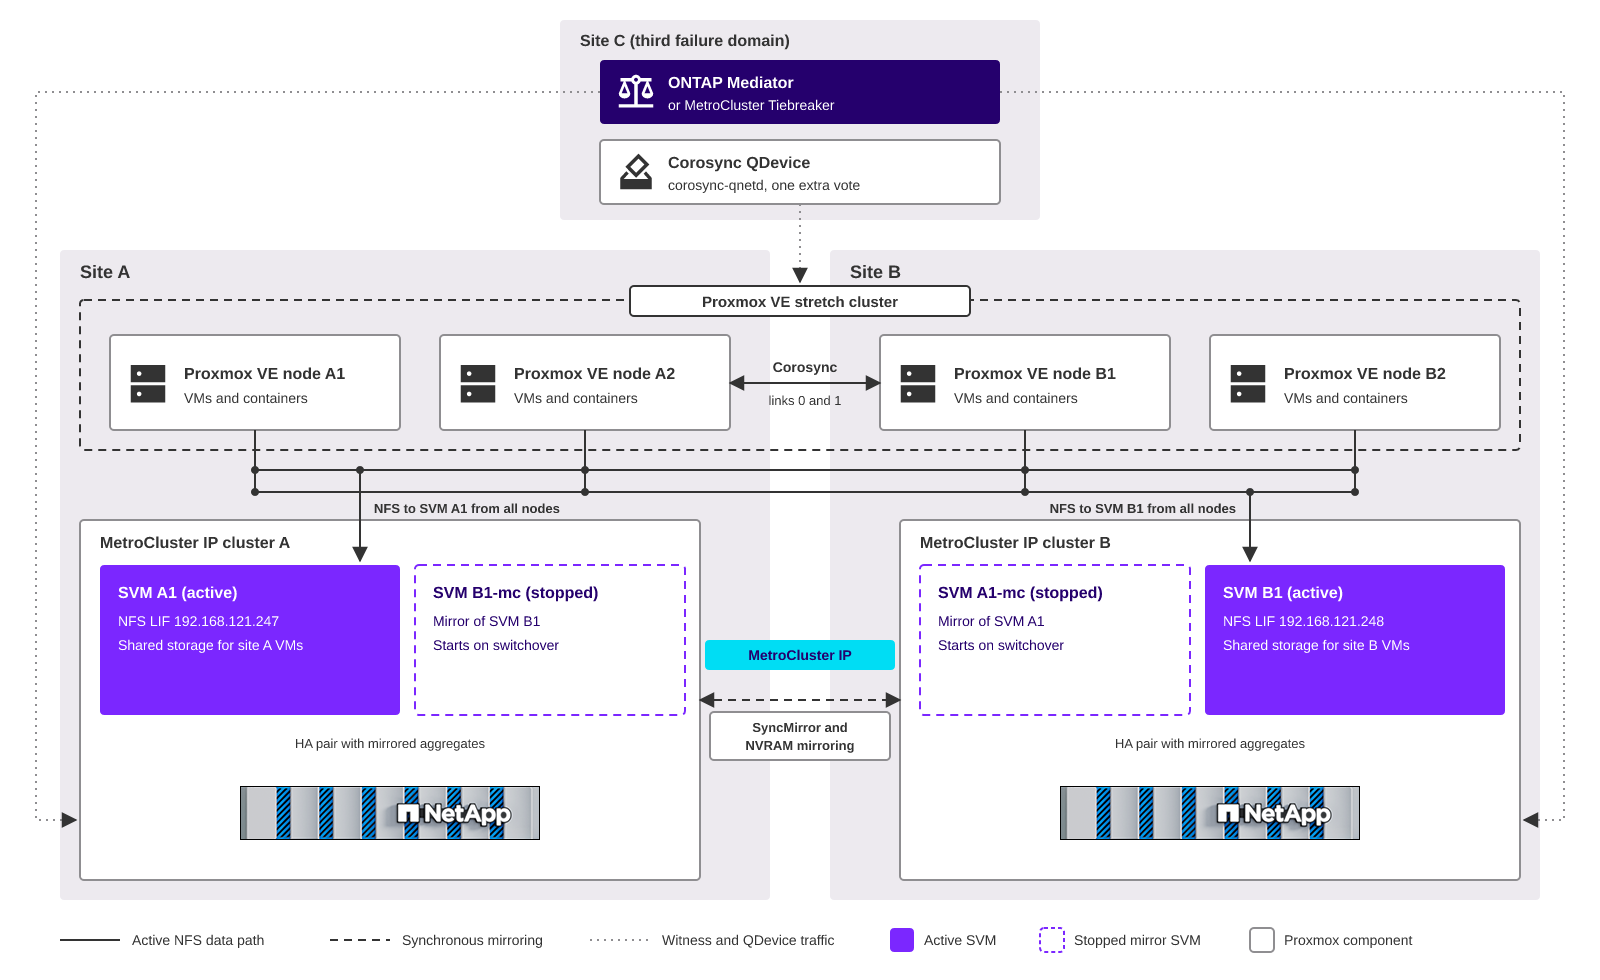
- MetroCluster cluster IP
-
Ogni sito ha una coppia HA con aggregati mirrorati. La rete IP di back-end di MetroCluster replica i dati (SyncMirror) e NVRAM sul sito partner in modo sincrono.
- SVM in entrambi i siti
-
Ciascun sito può gestire le proprie SVM. Per ogni SVM, MetroCluster mantiene una SVM mirrorata arrestata con il suffisso
-mcnel sito partner, con la stessa configurazione e gli stessi indirizzi LIF. - Accesso NFS da tutti i nodi
-
Ogni nodo Proxmox VE monta lo storage condiviso di entrambe le SVM attive, SVM A1 e SVM B1, in modo che l'HA possa riavviare qualsiasi VM su qualsiasi nodo. I nodi del sito B accedono a SVM A1 e i nodi del sito A accedono a SVM B1 attraverso la rete intersito. Questo è lo stesso modello di accesso di SnapMirror active sync.
- Commutazione
-
Se un sito si guasta, ONTAP Mediator o MetroCluster Tiebreaker nel sito C abilita uno switchover automatico. Le SVM mirror nel sito superstite si avviano e servono tutto lo storage condiviso con gli stessi indirizzi NFS, e Proxmox VE HA riavvia le VM dal sito guasto. Un guasto di un singolo controller viene gestito da un takeover HA locale, senza switchover. Dopo aver riparato il sito guasto, risani gli aggregati e torni indietro.
Come MetroCluster reagisce ai guasti
La tabella seguente mostra come una configurazione IP MetroCluster e il cluster esteso Proxmox VE rispondono agli stessi guasti mostrati in Come la soluzione reagisce ai guasti. In questo esempio, SVM A1 è attivo nel sito A e SVM B1 è attivo nel sito B.
| Evento | Comportamento di ONTAP | Comportamento di Proxmox VE |
|---|---|---|
Il sito A ha un guasto |
ONTAP Mediator o MetroCluster Tiebreaker conferma il guasto e ONTAP esegue lo switchover del sito A. SVM A1-mc si avvia nel sito B con lo stesso indirizzo NFS LIF. SVM B1 continua a servire i dati. |
I nodi del sito B e il QDevice mantengono il quorum. L'HA isola i nodi del sito A e riavvia le relative VM sui nodi del sito B. Le VM già in esecuzione sui nodi del sito B continuano a funzionare, mentre quelle su SVM A1 riprendono le operazioni di I/O dopo lo switchover. |
Il cluster IP MetroCluster A si blocca, i nodi Proxmox VE del sito A continuano a funzionare |
ONTAP Mediator o MetroCluster Tiebreaker conferma che il cluster A non è raggiungibile e ONTAP esegue lo switchover del sito A. L'SVM A1-mc si avvia nel sito B con lo stesso indirizzo LIF NFS. |
Nessuna modifica al quorum e nessun riavvio della VM. Le VM su SVM A1 riprendono le operazioni di I/O dopo lo switchover, con i nodi del sito A che raggiungono il sito B attraverso la rete tra i siti. |
Un controller del sito A si guasta |
Il partner HA del sito A subentra in un takeover HA locale. Non si verifica alcuno switchover. |
Nessun impatto. Le macchine virtuali interrompono brevemente le operazioni di I/O durante il takeover. |
Il sito B si guasta |
ONTAP effettua il passaggio al sito B. SVM B1-mc si avvia nel sito A con lo stesso indirizzo LIF NFS. SVM A1 continua a servire i dati. |
I nodi del sito A e il QDevice mantengono il quorum. L'HA riavvia le VM del sito B sui nodi del sito A, dove accedono alla SVM B1 del sito A. |
Il collegamento tra siti non funziona |
Non si verifica alcuno switchover, perché entrambi i cluster sono ancora in esecuzione. Ogni sito continua a servire le proprie SVM e il mirroring verso il sito partner resta sospeso finché il collegamento non viene ripristinato. |
Il QDevice assegna il proprio voto alla partizione del sito A quando l'interruttore è allineato con il sito A. I nodi del sito B perdono il quorum e si isolano automaticamente. L'HA riavvia le VM sull'SVM A1 sui nodi del sito A. Le VM sull'SVM B1 non possono essere riavviate finché il collegamento non viene ripristinato, perché i nodi del sito A non riescono a raggiungere l'SVM B1. |
Il sito C si guasta |
Il mirroring continua senza perdita di dati, ma lo switchover automatico non è possibile finché il witness non è disponibile. Puoi comunque eseguire lo switchover manualmente. |
Il cluster mantiene il quorum grazie ai voti dei quattro nodi. Nessuna VM è interessata. |
Un nodo Proxmox VE non funziona |
Nessun impatto. |
HA riavvia le VM da quel nodo su altri nodi, privilegiando i nodi nello stesso sito. |
Il guasto del collegamento tra i siti è la principale differenza rispetto a una progettazione con un solo sito primario. Ogni volta che entrambi i siti ospitano SVM attive, con MetroCluster o con due SVM SnapMirror active sync in direzioni opposte, il tie breaker di corosync può favorire un solo sito. Le VM il cui SVM attivo si trova nell'altro sito restano inattive finché il collegamento non viene ripristinato. Per limitare l'impatto, usa collegamenti inter-sito ridondanti su percorsi fisici separati e posiziona le VM più critiche sull'SVM del sito favorito dal tie breaker.
Confronto delle funzionalità
| Considerazione | SnapMirror active sync per NAS | MetroCluster IP |
|---|---|---|
Ambito di protezione |
SVM e volumi selezionati |
Tutti gli aggregati mirrorati e tutte le SVM nella configurazione |
Granularità del failover |
Ogni SVM in modo indipendente |
L'intero sito, tramite switchover |
Carichi di lavoro non protetti |
Esegui su SVM non protette negli stessi cluster |
Puoi usare aggregati non mirrorati, che vanno offline dopo uno switchover finché non li riporti online |
Progettazione del cluster |
Due cluster indipendenti, collegati tramite una rete IP |
Una configurazione di due cluster partner, con una rete back-end IP dedicata MetroCluster |
Witness nel sito C |
ONTAP Mediator o ONTAP Cloud Mediator |
ONTAP Mediator o MetroCluster Tiebreaker |
Copie dei dati protetti |
Uno per ogni sito |
Uno in ogni sito, in aggregati mirrorati |
Percorso di replica |
SnapMirror sincrono su LIF intercluster |
SyncMirror e mirroring NVRAM sulla rete back-end IP di MetroCluster |
Indirizzo NFS in entrambe le sedi |
VLAN di livello 2 estesa. LIF VIP con qualificazione BGP in sospeso |
VLAN Layer 2 estesa o LIF VIP con BGP |
Ripristino dopo un guasto del sito |
Esegui il failback di ogni SVM |
Ripara gli aggregati, quindi ripristina il sito |
Guida alla selezione
-
Scegli MetroCluster quando tutti, o quasi tutti, i carichi di lavoro sullo storage necessitano di un RPO pari a zero, ad esempio quando un'azienda esegue solo macchine virtuali mission-critical sul cluster o quando un service provider offre lo stesso livello di disponibilità a ogni tenant. Ottieni un dominio di protezione unico senza configurazione per singolo carico di lavoro.
-
Scegli la sincronizzazione attiva di SnapMirror quando solo un sottoinsieme di carichi di lavoro richiede RPO zero, ad esempio un livello premium per alcuni tenant, oppure quando devi eseguire il failover o testare il disaster recovery per un tenant o un'applicazione alla volta.
-
SnapMirror active sync per NAS non è supportato in una configurazione MetroCluster. Usa una soluzione per ogni coppia di cluster.
-
Le linee guida relative a corosync, QDevice e HA in questa soluzione si applicano a entrambi. Con MetroCluster, allinea il tie breaker di QDevice con il sito che continua a servire i dati quando il collegamento tra i siti si interrompe e utilizza le regole di affinità dei nodi HA per mantenere le VM nello stesso sito della loro SVM attiva.
-
MetroCluster IP supporta anche VIP LIF con BGP per le reti di livello 3 tra i siti.
Considerazioni su Corosync per un cluster esteso Proxmox VE
Proxmox VE utilizza corosync per l'appartenenza al cluster e il quorum. Corosync è più sensibile alla rete tra i siti rispetto a SnapMirror active sync, quindi pianifica prima la rete del cluster.
Latenza e progettazione di rete
-
SnapMirror active sync richiede un tempo di andata e ritorno (RTT) tra cluster inferiore a 10 ms. Proxmox raccomanda una latenza di corosync inferiore a 5 ms tra tutti i nodi, quindi il requisito di corosync definisce il limite di distanza per la soluzione.
-
Corosync richiede una latenza bassa e costante piuttosto che un'elevata larghezza di banda. Utilizza una rete dedicata per corosync, separata dal traffico di storage e di migrazione live, in modo che i picchi di traffico dello storage non causino timeout di corosync.
-
Configura almeno due collegamenti corosync (ad esempio, collegamento 0 e collegamento 1) su percorsi fisici separati tra i siti. Corosync utilizza Kronosnet per commutare automaticamente i collegamenti in caso di guasto di uno di essi.
Quorum con un QDevice presso una terza sede
Suddividi equamente i nodi Proxmox VE tra il sito A e il sito B e aggiungi un QDevice al sito C. Con quattro nodi e un QDevice, il cluster ha cinque voti e ne richiede tre per il quorum, quindi uno dei due siti può guastarsi senza perdere il quorum. Il QDevice si connette al cluster tramite la porta TCP 5403 e non ha il requisito di bassa latenza di corosync, quindi può condividere il sito C con ONTAP Mediator. Se usi ONTAP Cloud Mediator, hai comunque bisogno di una terza posizione per il QDevice, ma può trattarsi di un piccolo host Linux che non ospita anche un mediatore.
Allineamento del tie breaker con il cluster primario
Quando il collegamento tra i siti si interrompe, ma entrambi i siti possono ancora raggiungere il sito C, ONTAP mantiene il cluster primario nel sito A a servire i dati. Il QDevice deve assegnare il proprio voto allo stesso sito. Per impostazione predefinita, il QDevice sceglie la partizione che contiene l'ID nodo più basso.
PRATICA CONSIGLIATA: Crea il cluster Proxmox VE su un nodo del sito A e unisci gli altri nodi del sito A prima di unire i nodi del sito B, in modo che il sito A mantenga gli ID nodo più bassi. Se lo storage primario viene spostato sul sito B per un periodo prolungato, aggiorna l'impostazione QDevice tie_breaker con un ID nodo del sito B.
Se il QDevice avesse preferito il sito B, i nodi del sito A si sarebbero autoisolati e l'HA avrebbe riavviato le VM sui nodi del sito B che non riescono a raggiungere lo storage attivo nel sito A.
Comportamento HA e posizionamento delle VM
-
In genere, Proxmox VE HA rileva un nodo guasto e ripristina le sue VM in circa due minuti, incluso un timeout di 60 secondi per il watchdog fencing. In caso di guasto del sito, il failover di SnapMirror active sync e il ripristino di Proxmox VE HA vengono eseguiti in parallelo.
-
Utilizza le regole di affinità dei nodi HA con priorità dei nodi per posizionare le VM sui nodi nello stesso sito del loro storage primario e per consentire il failover sull'altro sito.
-
Dopo un failover del sito, imposta la proprietà HA
failbacksu0per le VM interessate finché non ripristini lo storage. In caso contrario, HA migra di nuovo le VM ai nodi del sito A non appena tornano disponibili, mentre lo storage attivo è ancora nel sito B. -
Assicurati che i timeout del disco del sistema operativo guest siano più lunghi del tempo di failover previsto, in modo che i guest non segnalino errori di I/O durante un failover dello storage.
Integrazione con Storage Manager per Proxmox
Storage Manager for Proxmox (SMP) offre agli amministratori di Proxmox VE un'unica interfaccia per eseguire il provisioning dello storage condiviso ONTAP e per eseguire il backup, il ripristino e la clonazione delle VM utilizzando gli snapshot ONTAP e la tecnologia FlexClone. SMP si connette al cluster Proxmox VE e a ONTAP tramite le rispettive API, quindi non richiede agenti sui nodi Proxmox VE.
SMP e SnapMirror active sync proteggono da diversi tipi di guasti. SnapMirror active sync mantiene le VM in esecuzione anche in caso di guasto dello storage o del sito, ma replica ogni scrittura in modo sincrono, inclusi una cancellazione accidentale, un aggiornamento guest non riuscito o dati crittografati da ransomware. Gli snapshot SMP ti offrono copie point-in-time per il ripristino da questi guasti logici. Insieme, offrono disponibilità continua e un rapido ripristino operativo dallo stesso storage ONTAP.
| Livello di protezione | Protegge da | Punto di ripristino | Gestito con |
|---|---|---|---|
Sincronizzazione attiva SnapMirror |
Guasto del sistema di storage e guasto del sito |
Nessuna perdita di dati |
ONTAP |
Backup SMP (snapshot ONTAP) |
Cancellazione accidentale, corruzione dei dati, aggiornamenti non riusciti e ransomware |
Ultimo backup pianificato o su richiesta |
SMP |
SnapMirror fan-out asincrono o Proxmox Backup Server |
Perdita di entrambi i siti e mantenimento a lungo termine |
Ultima replica o backup |
ONTAP o Proxmox Backup Server |
Backup e ripristino
SMP crea backup coerenti in caso di crash o coerenti a livello di file come snapshot di ONTAP dei volumi di storage, su richiesta o in base a criteri, e ripristina singole VM, storage o gruppi di risorse:
-
Utilizza i gruppi di risorse e le policy di backup per applicare la stessa pianificazione e gli stessi criteri di conservazione alle macchine virtuali di un tenant o di un'applicazione.
-
Usa backup coerenti a livello di file per le VM che eseguono il guest agent QEMU, in modo che i file system guest vengano messi in quiescenza prima che ONTAP crei lo snapshot.
-
SMP gestisce lo storage attivo. Dopo un failover di SnapMirror active sync, esegui un rilevamento in SMP in modo che associ lo storage al cluster B prima di eseguire operazioni di backup o ripristino.
-
Per una terza copia al di fuori dei due siti, o per una conservazione più lunga, aggiungi una relazione fan-out asincrona SnapMirror dai volumi protetti oppure utilizza Proxmox Backup Server.
-
Gli snapshot a prova di manomissione non sono supportati con SnapMirror active sync, quindi non abilitare il blocco degli snapshot in SMP per i volumi protetti.
Clonazione delle VM
SMP utilizza la tecnologia ONTAP FlexClone per creare cloni di macchine virtuali efficienti in termini di spazio per lo sviluppo, i test e il provisioning rapido. I cloni che crei nello storage protetto consumano larghezza di banda di replica e capacità in entrambi i siti. Escludi dalla protezione di sincronizzazione attiva di SnapMirror i cloni e lo storage di test che non richiedono continuità operativa.
Posizionamento SMP
-
Esegui la VM SMP come risorsa HA su uno storage condiviso protetto da SnapMirror active sync, in modo che SMP rimanga disponibile dopo un guasto dello storage o del sito.
-
Registra il cluster Proxmox VE e entrambi i cluster ONTAP in SMP, in modo che SMP possa raggiungere lo storage attivo in entrambi i siti.
Storage condiviso NFS con SnapMirror active sync per NAS
A partire da ONTAP 9.19.1, SnapMirror active sync protegge i carichi di lavoro NAS. Le seguenti considerazioni si applicano solo allo storage condiviso NFS. Per implementare la soluzione con storage NFS, segui "Workflow di configurazione NAS".
Protezione a livello SVM e identità di rete
-
SnapMirror active sync per NAS protegge un'intera macchina virtuale di storage (SVM). Puoi proteggere tutti i volumi nella SVM o escludere i volumi selezionati. Sono supportati solo i volumi FlexVol e la SVM non può contenere LUN.
-
La SVM secondaria rimane inattiva, con i relativi LIF disattivati, fino a un failover. ONTAP replica la configurazione della SVM, inclusi gli indirizzi IP dei LIF, le policy di esportazione e le impostazioni NFS, in modo che la SVM secondaria presenti lo stesso endpoint NFS dopo un failover.
-
Il failover non interrompe il funzionamento per NFSv3 e versioni successive.
-
SnapMirror active sync per NAS è di tipo attivo/passivo, quindi le VM sui nodi del sito B leggono e scrivono attraverso la rete intersito verso l'SVM primario. Per i carichi di lavoro attivi in entrambi i siti, usa due SVM con direzioni di replica opposte, una primaria in ciascun sito, e allinea la regola di affinità del nodo di ogni VM al sito del relativo SVM primario.
-
SnapMirror active sync per NAS è supportato sui cluster AFF A-Series e C-Series a due nodi.
Impostazioni del client NFS
Utilizza NFSv3 o NFSv4.1 per lo storage NFS. Mantieni il comportamento predefinito di hard mount e non aggiungere l' `soft`opzione di montaggio, in modo che le operazioni di I/O NFS vengano ritentate anziché non riuscire durante un failover.
Usa più connessioni TCP allo storage per prestazioni migliori e una maggiore tolleranza ai guasti. Usa nConnect oppure il trunking di sessione, non entrambi:
-
nConnect. Apre più connessioni TCP a un singolo indirizzo LIF NFS, ad esempio
nconnect=4. nConnect funziona con NFSv3 e NFSv4.1 e con un singolo indirizzo LIF VIP, quindi è l'opzione consigliata per SnapMirror active sync per NAS, incluse le reti layer 3. -
Session trunking. Raggruppa più LIF di dati in una sessione NFSv4.1, ad esempio
vers=4.1,trunkdiscovery,max_connect=16. Il session trunking richiede NFSv4.1 o versione successiva. Utilizzalo solo quando la SVM protetta dispone di più LIF di dati raggiungibili dai client in entrambi i siti, come in una rete layer 2 estesa. Per i dettagli, consulta "Trunking NFS".
Per i comandi delle opzioni di montaggio e i passaggi di verifica, vedi "Configurare l'archiviazione NFS per Proxmox VE".
Provisioning dello storage NFS con SMP
SMP esegue il provisioning di un volume ONTAP, crea o seleziona una policy di esportazione e monta il volume come storage condiviso NFS sui nodi Proxmox VE che selezioni. Per lo storage in una SVM protetta:
-
Esegui il provisioning del volume nella SVM primaria e seleziona la LIF NFS, oppure la LIF VIP in una rete di livello 3, come LIF preferita. La SVM secondaria utilizza lo stesso indirizzo dopo un failover, quindi la definizione dello storage rimane valida.
-
Monta lo storage su tutti i nodi Proxmox VE in entrambi i siti in modo che l'HA possa riavviare le VM su qualsiasi nodo.
-
Assicurati che la policy di esportazione consenta i nodi Proxmox VE in entrambi i siti. ONTAP replica la policy di esportazione sull'SVM secondario.
-
Dopo il provisioning, verifica che il volume sia incluso nella protezione di sincronizzazione attiva di SnapMirror.
Reti di livello 3 con VIP LIFs e BGP
SnapMirror active sync per NAS richiede lo stesso indirizzo IP sulle SVM primaria e secondaria. Quando la VLAN NFS viene estesa tra i siti, l'indirizzo IP della LIF si sposta con la SVM. Quando i siti sono connessi tramite una rete instradata di livello 3, la sottorete di una LIF del sito A non esiste nel sito B.

|
Al momento della pubblicazione, NetApp non ha documentato le VIP LIF con BGP come configurazione qualificata per la sincronizzazione attiva di SnapMirror per NAS. Prima di pianificare una progettazione di livello 3, conferma il supporto attuale con NetApp. In caso contrario, estendi la VLAN NFS tra i siti. Le configurazioni IP di MetroCluster supportano le VIP LIF con BGP. |
Le LIF con IP virtuale (VIP) di ONTAP risolvono questo problema. Una LIF VIP non appartiene ad alcuna sottorete. ONTAP pubblicizza l'indirizzo VIP ai router peer come una rotta host /32 utilizzando Border Gateway Protocol (BGP), in modo che l'indirizzo possa spostarsi tra i siti senza una VLAN estesa.
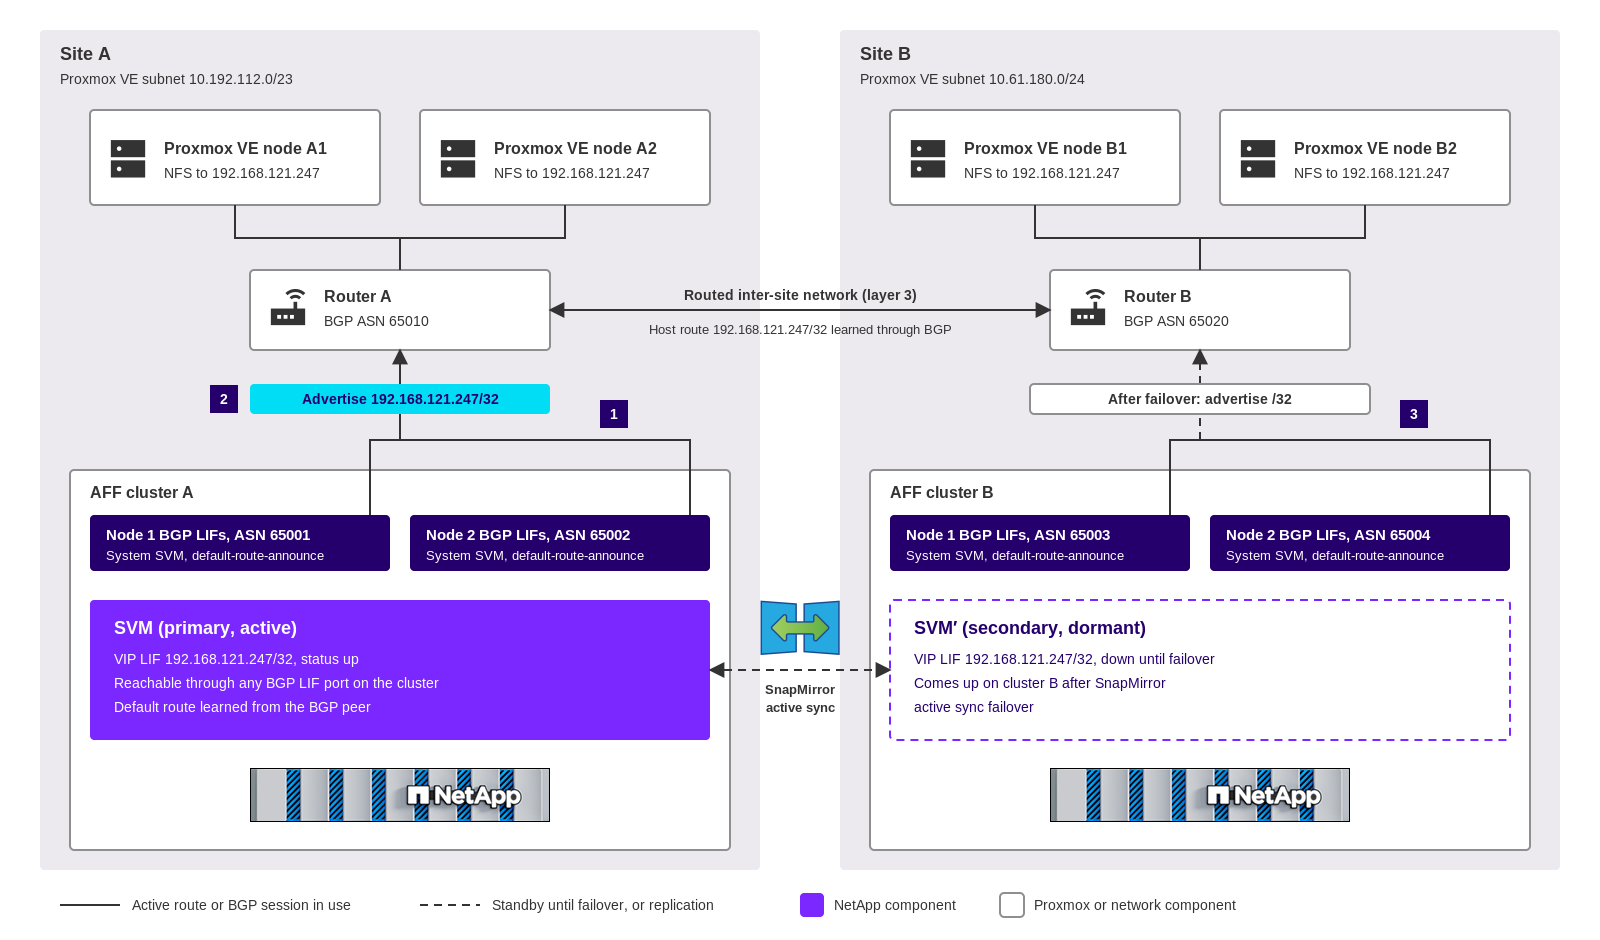
-
Ogni nodo in entrambi i siti dispone di BGP LIF nella SVM di sistema che sono in peering con i router del sito. I BGP LIF sono specifici del nodo e non vengono replicati, quindi devi configurarli su entrambi i cluster.
-
L'SVM primaria ospita la LIF VIP NFS. Il cluster A pubblicizza la rotta host /32 e i nodi Proxmox VE in entrambi i siti raggiungono lo storage attraverso la rete instradata.
-
Dopo un failover di SnapMirror active sync, il VIP LIF si attiva sulla SVM secondaria, il cluster B pubblicizza la route host e i router convergono sul sito B.
Quando pianifichi BGP in ONTAP per la prima volta, è utile sapere quale SVM possiede ciascuna LIF. Le LIF BGP appartengono alla SVM di sistema dell'IPspace, non alle SVM dati. Un set di LIF BGP su ciascun cluster serve le LIF VIP di ogni SVM dati in quell'IPspace, quindi non crei LIF BGP per ogni tenant. Il diagramma seguente mostra il layout di LIF e porte su un cluster, con le LIF BGP sulle porte VLAN.
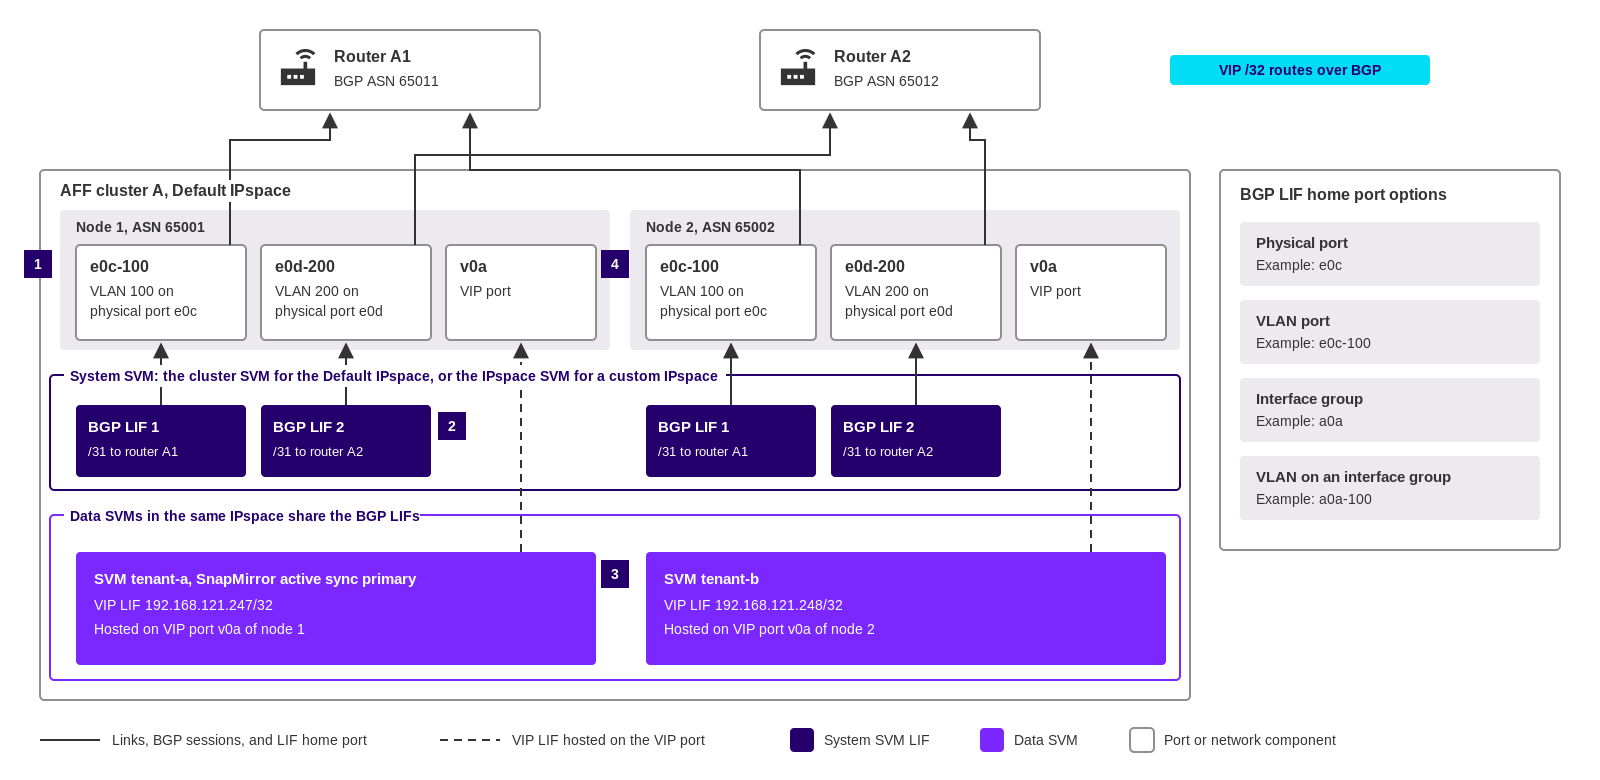
-
Ogni nodo ha due porte per BGP, in questo esempio le porte VLAN
e0c-100ee0d-200. Ogni porta si connette direttamente a un router diverso. -
Ogni nodo ha due BGP LIF nell'SVM di sistema, una su ciascuna porta, con una sottorete /31 e un gruppo peer BGP verso un router. Per l'IPspace predefinito, l'SVM di sistema è la cluster SVM. Per un IPspace personalizzato, è l'SVM con lo stesso nome dell'IPspace.
-
Le SVM di dati nello stesso IPspace ospitano VIP LIFs e non richiedono BGP LIFs proprie. I gruppi di peer BGP pubblicizzano le route VIP per tutte le SVM nell'IPspace.
-
ONTAP crea una porta VIP, ad esempio
v0a, su ciascun nodo quando crei il primo gruppo di peer BGP. Le LIF VIP sono ospitate sulla porta VIP e sono raggiungibili tramite ogni porta del nodo che ospita una LIF BGP nell'IPspace.
La porta home di un BGP LIF può essere una porta fisica, una porta VLAN, un gruppo di interfacce o una VLAN su un gruppo di interfacce. Un gruppo di interfacce non è obbligatorio. NetApp Technical Report TR-4949 raccomanda due BGP LIF su due porte separate per ogni IPspace, ciascuna connessa direttamente a un router first-hop diverso.
Tenete presenti le seguenti linee guida:
-
Le BGP LIF non sono soggette a failover. La ridondanza deriva da due BGP LIF per nodo, ognuna in peering con un router diverso. Se un nodo perde tutte le sessioni BGP per una SVM, ONTAP sposta la VIP LIF su un altro nodo che ha una sessione BGP attiva per quella SVM.
-
Usa il protocollo BGP esterno (eBGP) con un numero di sistema autonomo privato (ASN) univoco per ogni nodo ONTAP e per ogni router.
-
Usa una sottorete /31 (maschera di sottorete 255.255.255.254) per ogni BGP LIF e il relativo router. Assegna l'indirizzo dispari al BGP LIF e l'indirizzo pari al router.
-
ONTAP non elabora le rotte provenienti dai router. Configura i router in modo che accettino le rotte host /32 da ONTAP e non inviino aggiornamenti di rotta al cluster.
-
I nodi Proxmox VE non devono condividere una subnet con l'indirizzo VIP. Un router di livello 3 ridondante, ad esempio con VRRP o HSRP, deve trovarsi nel percorso tra i nodi e lo storage.
-
Configura i gruppi peer BGP con
-use-peer-as-next-hop truein modo che ogni cluster apprenda la propria rotta predefinita dai router locali. Le rotte che puntano al gateway del sito A non sono valide nel sito B dopo un failover. -
Abilita il routing multipath in modo che il traffico VIP in uscita utilizzi tutte le porte LIF BGP disponibili.
-
Riduci il tempo di hold BGP dal valore predefinito di 180 secondi. TR-4949 raccomanda un tempo di hold di 3 secondi. Un router ritira la route da un cluster guasto solo quando scade il timer di hold e, durante un guasto del sistema storage, il router nel sito A rimane online.