


Saiba mais sobre a continuidade dos negócios do Proxmox VE com o SnapMirror active sync

 Sugerir alterações

 PDFs

Empresas que executam máquinas virtuais (VMs) essenciais aos negócios no Proxmox Virtual Environment (VE) e provedores de serviços que hospedam VMs de clientes no Proxmox VE precisam que essas VMs continuem em execução quando um sistema de storage ou um data center inteiro fica offline. O ONTAP SnapMirror active sync replica de forma síncrona o storage compartilhado de um cluster do Proxmox VE estendido entre dois sites e faz automaticamente o failover do storage para o site sobrevivente. Você obtém um objetivo de ponto de recuperação (RPO) zero, recuperação automatizada sem scripts ou runbooks e o mesmo storage compartilhado em ambos os sites, para que a alta disponibilidade (HA) do Proxmox VE possa reiniciar as VMs sem qualquer reconfiguração de storage. Para o storage compartilhado NFS, a solução usa o SnapMirror active sync for NAS.
Desafios do cliente
Criar resiliência de storage e do local para o Proxmox VE usando apenas ferramentas nativas é difícil:
-
Perda de dados após falha do local. A replicação de armazenamento do Proxmox VE e o Proxmox Backup Server são assíncronos. As alterações feitas desde a última replicação ou backup são perdidas quando o site primário falha.
-
Recuperação manual e lenta. A recuperação em um site secundário geralmente envolve promover réplicas, montar o storage em um endereço diferente, atualizar
/etc/pve/storage.cfge reiniciar VMs. Cada etapa manual aumenta o tempo de inatividade e o risco de erro durante uma interrupção. -
Armazenamento estendido que compete com as VMs por recursos do host. O armazenamento estendido hiperconvergente, como o Ceph em modo estendido, é executado nos nós do Proxmox VE e mantém duas réplicas de cada objeto em cada local. O tráfego de replicação, recuperação e rebalanceamento consome CPU, memória e recursos de rede nos mesmos nós que executam as VMs.
-
Duas decisões de quórum que devem concordar. Qualquer projeto com dois sites precisa de uma testemunha em um terceiro domínio de falha, tanto para o cluster Proxmox VE quanto para o storage. Se o cluster e o storage escolherem sites sobreviventes diferentes após uma falha de link entre sites, as VMs reiniciarão em nós que não conseguem alcançar o storage ativo.
-
Um endereço de storage que deve funcionar em ambos os sites. Após um failover de storage, os nós do Proxmox VE devem acessar o storage compartilhado no mesmo endereço. Esse endereço deve ser acessível em ambos os sites, o que geralmente significa uma VLAN de camada 2 estendida entre os sites.
Desafios do provedor de serviços
Os provedores de serviços que criam serviços em nuvem no Proxmox VE enfrentam os mesmos desafios, além dos acordos de nível de serviço (SLAs) dos locatários:
-
O sistema de storage é um ponto de falha compartilhado. O Proxmox VE HA protege as VMs dos tenants contra falhas no host, mas não contra falhas no sistema de storage que hospeda seus discos. Uma interrupção de storage afeta todos os tenants nesse sistema.
-
Não há como vender maior disponibilidade. Sem replicação síncrona e failover automático de storage, um provedor não pode oferecer um nível de disponibilidade premium com zero perda de dados e compromissos de tempo de atividade mais robustos.
-
Isolamento de inquilinos durante a recuperação. Os testes de recuperação, manutenção e recuperação de desastres devem afetar apenas os inquilinos envolvidos, e não toda a plataforma.
Desafios empresariais
Empresas que migram cargas de trabalho essenciais para a missão de outros hipervisores para o Proxmox VE esperam a mesma resiliência do local que tinham antes, como perda zero de dados para bancos de dados e aplicativos de linha de negócios, além de recuperação sem a necessidade de um runbook manual. Atender a essa expectativa apenas com as ferramentas nativas do Proxmox VE exige um esforço considerável de design, scripting e operação.
Visão geral da solução
A solução combina um cluster estendido do Proxmox VE com o SnapMirror active sync em sistemas AFF da NetApp em dois locais:
-
RPO zero. O ONTAP replica cada gravação no storage compartilhado de forma síncrona, do cluster primário no local A para o cluster secundário no local B.
-
O mesmo storage compartilhado em ambos os sites. Após um failover, o cluster secundário apresenta o mesmo storage ao Proxmox VE, portanto as definições de storage no
/etc/pve/storage.cfgpermanecem válidas. -
Failover automático. Um mediador atua como testemunha fora dos dois sites. Você pode instalar o ONTAP Mediator em um terceiro site ou usar o ONTAP Cloud Mediator, um serviço hospedado na NetApp Console. Quando o storage primário ou o site falha, o ONTAP faz failover para o site B sem intervenção manual.
-
Controle granular. Você escolhe quais cargas de trabalho proteger e pode realizar failover de cargas de trabalho individualmente, por exemplo, para mover um locatário ou aplicativo para manutenção do site.
-
Utilização da cópia secundária. Você pode clonar a cópia secundária para desenvolvimento, testes ou testes de recuperação de desastres sem afetar a replicação.
Como a solução aborda os desafios
| Desafio | Como a solução ajuda | O que você ainda planeja |
|---|---|---|
Perda de dados e recuperação manual |
A replicação síncrona oferece RPO zero. O ONTAP realiza o failover automaticamente, e a SVM secundária apresenta o mesmo endereço NFS, portanto |
O Proxmox VE HA ainda reinicia VMs de um local com falha. |
Storage estendido nos hosts |
A replicação é executada nos controladores AFF, não nos nós Proxmox VE, portanto a CPU, a memória e a rede do host permanecem disponíveis para as VMs. O ONTAP mantém uma cópia em cada site, e a eficiência de storage se aplica a ambas as cópias. |
Como em qualquer replicação síncrona, a solução precisa de uma segunda cópia completa no site B, e a replicação adiciona carga a ambos os clusters AFF. Dimensione ambos os clusters para a carga de trabalho de replicação. |
Duas decisões sobre quórum |
O ONTAP Mediator, ou o ONTAP Cloud Mediator como serviço no NetApp Console, é uma testemunha leve fora do caminho de dados. Esta solução mostra como alinhar o QDevice do corosync com o cluster primário para que ambos escolham o mesmo local. |
Um terceiro local ainda é necessário para o QDevice. Ele também é necessário para o ONTAP Mediator, mas não para o ONTAP Cloud Mediator. Consulte Opções do Mediator. |
Um endereço de storage em ambos os locais |
A SVM secundária assume o mesmo endereço de LIF NFS, portanto não é necessário remontar nem reconfigurar o armazenamento. |
A sub-rede NFS deve estar acessível em ambos os locais, normalmente com uma VLAN de camada 2 estendida. Consulte Redes de camada 3 com VIP LIFs e BGP para ver o status de qualificação das VIP LIFs. |
O diagrama a seguir mostra a arquitetura da solução com NFS storage compartilhado.
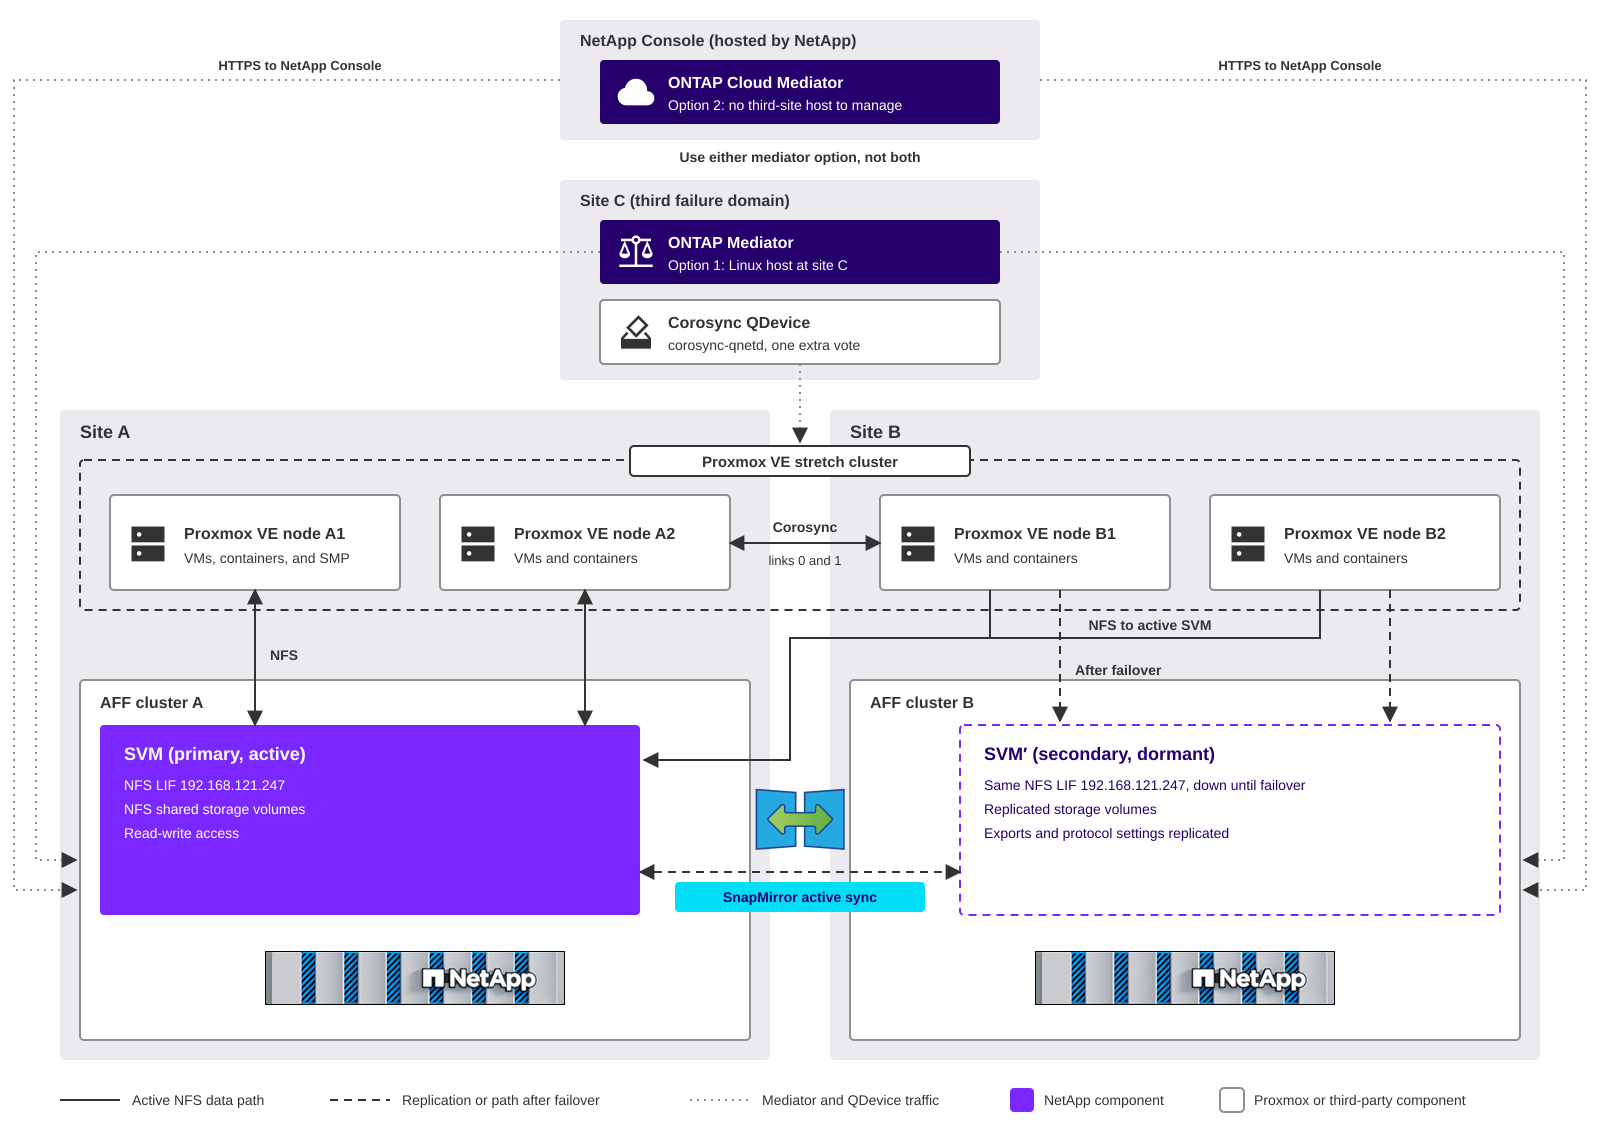
- Site A e site B
-
Cada site tem um cluster de dois nós AFF e metade dos nós do Proxmox VE. O cluster primário no site A fornece o storage compartilhado para todos os nós do Proxmox VE. Os nós no site B acessam o cluster primário pela rede entre sites. Com storage NFS, a SVM secundária no site B permanece inativa até que ocorra um failover.
- Local C
-
Um terceiro domínio de falha hospeda o daemon QDevice do corosync (
corosync-qnetd) e, se você escolher a opção 1, o ONTAP Mediator. O QDevice fornece um voto extra para que o cluster Proxmox VE mantenha o quórum quando um dos sites falhar. - NetApp Console
-
Se você escolher a opção 2, o ONTAP Cloud Mediator será executado como serviço no NetApp Console, que a NetApp hospeda e gerencia. Ambos os clusters AFF se conectam a ele por HTTPS, portanto você não precisa instalar nem manter um host mediador.
- Mediator
-
O ONTAP Mediator ou o ONTAP Cloud Mediator ajuda o ONTAP a decidir qual cluster serve os dados. Use um deles, não ambos. Para ver uma comparação, consulte Opções do Mediator.
- Cluster estendido do Proxmox VE
-
Todos os nós do Proxmox VE pertencem a um mesmo cluster e compartilham as mesmas definições de storage. O Proxmox VE HA reinicia as VMs de um local com falha nos nós sobreviventes. O Storage Manager for Proxmox (SMP) é executado como uma VM de alta disponibilidade no cluster para provisionar storage compartilhado e fazer backup, restaurar e clonar VMs.
Opções do Mediator
O SnapMirror active sync usa um mediador como testemunha passiva. Durante uma partição de rede ou a falha de um cluster, o ONTAP usa o mediador para decidir qual cópia continua a atender à E/S. O mediador não está no caminho de dados e não inicia failovers por conta própria. Você pode usar uma das seguintes opções, mas não ambas ao mesmo tempo.
| Consideração | Opção 1: o ONTAP Mediator | Opção 2: o ONTAP Cloud Mediator |
|---|---|---|
Onde ele é executado |
Um host Linux que você instala e gerencia em um terceiro domínio de falha, como o site C, com infraestrutura de energia e rede independente. |
Um serviço em nuvem no NetApp Console. A NetApp o hospeda e gerencia, então você não precisa de um host mediador em um terceiro local. |
Versão ONTAP |
O ONTAP 9.19.1 ou posterior para o SnapMirror active sync para NAS. |
O ONTAP Cloud Mediator está disponível a partir do ONTAP 9.17.1. O SnapMirror active sync para NAS precisa do ONTAP 9.19.1 ou posterior. |
Conectividade do cluster |
Ambos os clusters se conectam ao host mediador. A porta de serviço padrão é 31784. |
Ambos os clusters se conectam de saída via HTTPS ao NetApp Console, diretamente ou por meio de um proxy HTTP. A latência de ping recomendada para o NetApp Console é inferior a 200 ms. |
Configuração |
Instale o pacote no host Linux e, em seguida, adicione-o aos clusters com o endereço do host e um usuário do mediador. |
Crie uma conta de serviço do NetApp Console com a função ONTAP Mediator Setup Role e, em seguida, adicione o mediador aos clusters com o ID da organização, o ID do cliente e o segredo do cliente. |
Operações |
Você aplica patches e atualiza o host, e o mantém disponível. |
Nenhum host para aplicar patch ou atualizar. Você depende do acesso à internet em ambos os sites e da disponibilidade do serviço NetApp Console. |
Melhor ajuste |
Ambientes que têm um terceiro local, ou que não permitem que os clusters de armazenamento acessem a internet. |
Ambientes sem um terceiro local para um mediador, ou que desejam evitar operar um. |
Ao escolher, leve em consideração o seguinte:
-
O QDevice ainda precisa de um terceiro local. O ONTAP Cloud Mediator remove o host do mediador, não o host do QDevice do corosync. O QDevice precisa de um pequeno host Linux que todos os nós do Proxmox VE possam alcançar na porta TCP 5403 e não tem o requisito de baixa latência do corosync.
-
Ambos os clusters precisam ter acesso ao NetApp Console. Se os clusters usarem um proxy, instale o certificado de CA raiz do proxy em ambos os clusters. A NetApp recomenda um servidor proxy diferente para cada cluster.
-
Planeje o mesmo comportamento de falha com qualquer uma das opções. Quando o mediador estiver indisponível, a replicação continuará sem perda de dados, mas os failovers automáticos e planejados não serão possíveis até que o mediador esteja disponível novamente. Com o ONTAP Cloud Mediator, isso inclui a perda de conectividade dos clusters com o NetApp Console.

|
As opções de mediador nesta seção se aplicam ao SnapMirror active sync. Para o MetroCluster, esta solução usa o ONTAP Mediator ou o MetroCluster Tiebreaker. Antes de implantar, verifique se a sua versão do ONTAP, a opção de mediador e a versão do Proxmox VE estão listadas juntas no "NetApp Ferramenta de Matriz de Interoperabilidade (IMT)". |
Benefícios para os provedores de serviços
-
Disponibilidade de VMs além do HA do host. As VMs do locatário continuam em execução quando o sistema de storage que hospeda seus discos falha. O ONTAP realiza failover para o segundo cluster AFF, e as VMs retomam as operações de E/S no mesmo storage compartilhado sem reiniciar.
-
Um nível de disponibilidade premium. Você pode oferecer um serviço de VM resiliente ao storage com RPO zero como um complemento, juntamente com os níveis padrão em storage desprotegido nos mesmos clusters.
-
Proteção e failover por locatário. Com armazenamento protegido separado para cada locatário ou nível de serviço, você protege, realiza failover e testa a recuperação de desastres para cada locatário de forma independente, sem afetar os outros locatários.
-
Melhor aproveitamento de ambos os sites. Você pode definir algumas cargas de trabalho como primárias no site A e outras no site B, de forma que ambos os centros de dados atendam às cargas de trabalho ativas.
Benefícios para as empresas
-
Zero perda de dados para VMs essenciais aos negócios durante uma falha do sistema de storage ou uma falha do local.
-
Recuperação automatizada sem scripts, remontagem de armazenamento ou alterações em
/etc/pve/storage.cfg. -
Integrado ao ONTAP, sem nenhuma camada de software adicional nos nós Proxmox VE.
-
Operações diárias a partir de uma única interface. O Storage Manager para Proxmox provisiona o storage compartilhado protegido e faz backup, restaura e clona VMs com snapshots do ONTAP e a tecnologia FlexClone.
Como a solução reage às falhas
ONTAP e Proxmox VE tomam decisões independentes de quórum. O projeto os alinha para que ambos escolham o mesmo site sobrevivente.
| Evento | Comportamento do ONTAP | Comportamento do Proxmox VE |
|---|---|---|
Falha no local A |
O mediador confirma a falha, e o ONTAP automaticamente faz o failover do storage compartilhado para o cluster B. |
Os nós do Site B e o QDevice mantêm o quórum. O HA isola os nós do Site A e reinicia suas VMs nos nós do Site B. As VMs que já estão no Site B retomam as operações de E/S após o failover de storage. |
O cluster AFF A falha, os nós do Proxmox VE no local A continuam em execução |
O mediador confirma que o cluster A está inacessível, e o ONTAP faz automaticamente o failover do storage compartilhado para o cluster B. |
Sem alteração de quorum e sem reinicialização da VM. As VMs em todos os nós retomam as operações de E/S no mesmo storage compartilhado após o failover de storage, com os nós do site A alcançando o cluster B pela rede entre sites. |
Um controlador AFF no local A apresenta falha |
O controlador do parceiro assume em um takeover de HA local. Nenhum failover de sincronização ativa do SnapMirror ocorre. |
Sem impacto. As VMs pausam brevemente a E/S durante o takeover. |
Falha do local B |
O cluster A continua a fornecer dados. A replicação é retomada quando o site B volta a funcionar. |
Os nós do Site A e o QDevice mantêm o quorum. O HA reinicia as VMs do Site B nos nós do Site A. |
Falha no link entre sites |
O cluster A continua a fornecer dados. Não ocorre failover. |
O QDevice dá seu voto à partição do site A quando o critério de desempate está alinhado com o cluster primário. Os nós do site B perdem o quórum e se isolam automaticamente, e o HA reinicia suas VMs no site A. |
O site C falha ou os clusters perdem o acesso ao NetApp Console |
A replicação continua sem perda de dados, mas os failovers automáticos e planejados não são possíveis até que o mediador esteja disponível. Com o ONTAP Cloud Mediator, uma falha no site C afeta apenas o QDevice. |
O cluster mantém o quórum com os votos dos quatro nós. Nenhuma VM é afetada. |
Um nó do Proxmox VE apresenta falha |
Sem impacto. |
O HA reinicia as VMs desse nó em outros nós, dando preferência a nós no mesmo local. |
Falha do sistema de storage
Uma falha do sistema de storage é o caso com que a HA no nível do host sozinha não consegue lidar, e é o caso em que o SnapMirror active sync agrega mais valor para os provedores de serviços. O diagrama a seguir mostra o estado após a falha do cluster AFF A, enquanto todos os nós do Proxmox VE permanecem online, usando NFS storage compartilhado.
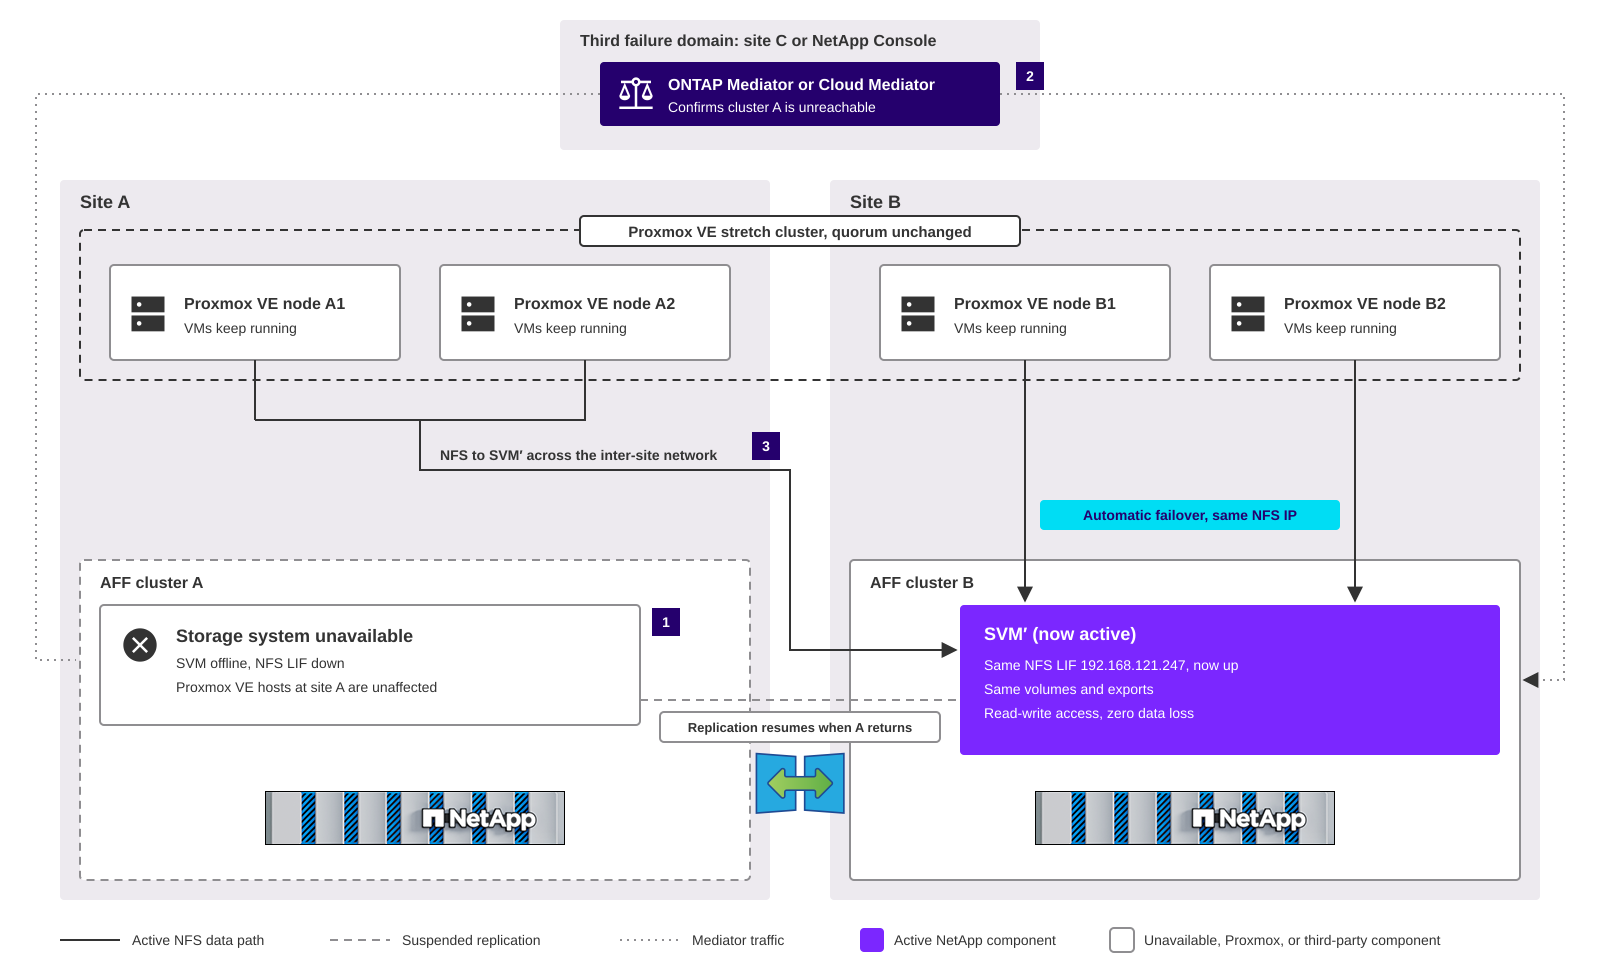
-
O cluster AFF A fica indisponível. Os nós Proxmox VE no local A continuam em execução, portanto o cluster não perde o quórum e o HA não isola nenhum nó.
-
O mediador, o ONTAP Mediator no site C ou o ONTAP Cloud Mediator no NetApp Console, confirma que o cluster A está inacessível, e o ONTAP ativa o SVM secundário no cluster B com o mesmo endereço NFS LIF, volumes e políticas de exportação.
-
Todos os nós do Proxmox VE retomam as operações de E/S no mesmo storage compartilhado. Os nós do site B acessam o cluster B localmente, e os nós do site A o acessam pela rede entre sites. As VMs pausam as operações de E/S durante o failover e continuam em execução sem reiniciar.
Quando o cluster A voltar, a replicação será retomada. Planeje o retorno ao cluster A durante uma janela de manutenção para que as VMs do site A acessem novamente o storage local.
Falha do local
Durante uma falha do local, tanto o sistema de storage quanto os nós do Proxmox VE nesse local ficam offline. O ONTAP realiza o failover do storage compartilhado para o cluster sobrevivente, e o Proxmox VE HA reinicia as VMs do local com falha nos nós sobreviventes, conforme descrito na tabela.
Escolha entre a sincronização ativa do SnapMirror e o MetroCluster
As configurações do NetApp MetroCluster também oferecem RPO zero e recuperação automática para um cluster stretch do Proxmox VE. As duas soluções diferem no que protegem:
-
O MetroCluster protege todas as cargas de trabalho. O MetroCluster combina clustering baseado em array com replicação síncrona. Ele espelha os dados em cada agregado espelhado, a memória não volátil (NVRAM) e a configuração de cada SVM para o site do parceiro, de modo que todo o storage compartilhado no cluster fique protegido sem configuração por carga de trabalho.
-
O SnapMirror active sync protege um subconjunto de cargas de trabalho. Você escolhe quais SVMs ou volumes proteger, e pode realizar failover de cada um independentemente. As cargas de trabalho não protegidas podem compartilhar os mesmos clusters.
Ambas as soluções mantêm uma cópia completa dos dados protegidos em cada local, precisam de uma testemunha em um terceiro domínio de falha e adicionam carga de replicação aos controladores de storage. Elas diferem no escopo de proteção, na granularidade de failover e no design do cluster.
|
|
Antes de implantar qualquer uma das soluções, verifique se a sua versão do ONTAP, a configuração de sincronização ativa do MetroCluster ou do SnapMirror e a versão do Proxmox VE estão listadas juntas na "NetApp Ferramenta de Matriz de Interoperabilidade (IMT)". |
A arquitetura do MetroCluster com Proxmox VE
O diagrama a seguir mostra um cluster stretch do Proxmox VE com uma configuração IP de quatro nós do MetroCluster e storage compartilhado NFS.
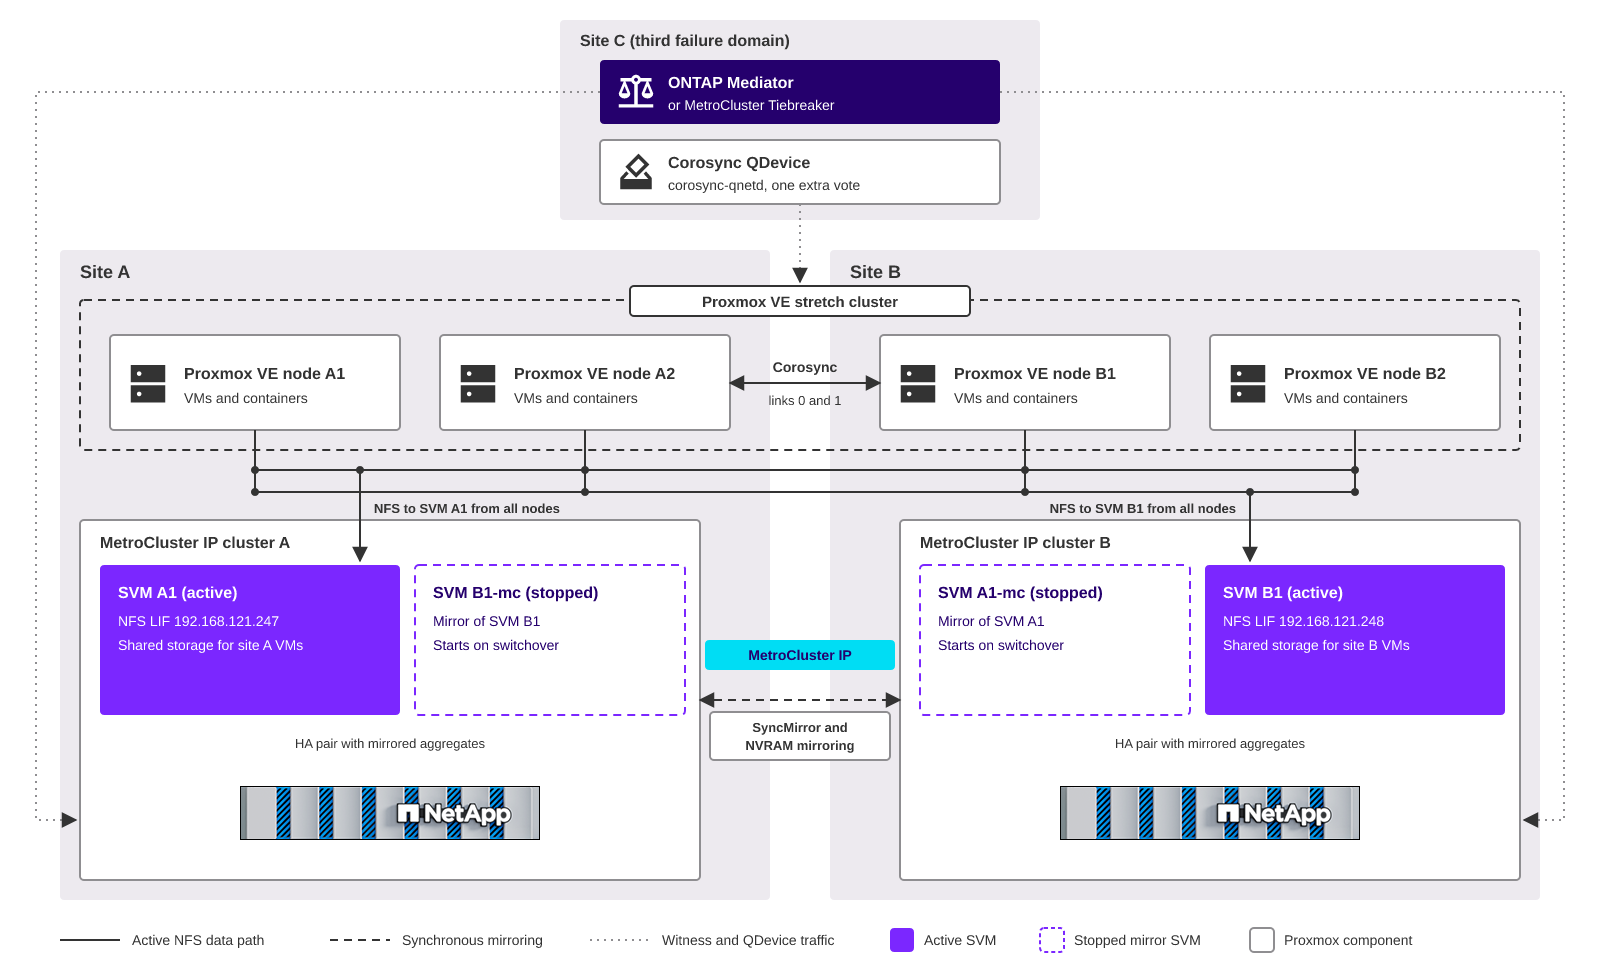
- MetroCluster clusters IP
-
Cada site possui um par de HA com agregados espelhados. A rede IP de back-end do MetroCluster espelha dados (SyncMirror) e NVRAM para o site do parceiro de forma síncrona.
- SVMs em ambos os locais
-
Cada site pode operar suas próprias SVMs. Para cada SVM, o MetroCluster mantém uma SVM espelho interrompida com o sufixo
-mcno site parceiro, com a mesma configuração e os mesmos endereços LIF. - Acesso NFS de todos os nós
-
Cada nó do Proxmox VE monta o storage compartilhado de ambas as SVMs ativas, SVM A1 e SVM B1, para que o HA reinicie qualquer VM em qualquer nó. Os nós no site B acessam a SVM A1, e os nós no site A acessam a SVM B1, pela rede entre sites. Este é o mesmo modelo de acesso do SnapMirror active sync.
- Switchover
-
Se um site falhar, o ONTAP Mediator ou o MetroCluster Tiebreaker no site C permite um switchover automático. As SVMs espelhadas no site sobrevivente iniciam e fornecem todo o storage compartilhado com os mesmos endereços NFS, e o Proxmox VE HA reinicia as VMs do site com falha. Uma falha de um único controlador é tratada por um takeover de HA local, sem switchover. Depois de reparar o site com falha, você recupera os agregados e faz o switchback.
Como o MetroCluster reage às falhas
A tabela a seguir mostra como uma configuração de IP do MetroCluster e o cluster estendido do Proxmox VE respondem às mesmas falhas que em Como a solução reage às falhas. Neste exemplo, a SVM A1 está ativa no site A e a SVM B1 está ativa no site B.
| Evento | Comportamento do ONTAP | Comportamento do Proxmox VE |
|---|---|---|
Falha no local A |
O ONTAP Mediator ou o MetroCluster Tiebreaker confirma a falha, e o ONTAP faz switchover do site A. O SVM A1-mc inicia no site B com o mesmo endereço NFS LIF. O SVM B1 continua a servir dados. |
Os nós do Site B e o QDevice mantêm o quórum. O HA isola os nós do Site A e reinicia suas VMs nos nós do Site B. As VMs que já estavam em execução nos nós do Site B continuam em execução, e aquelas na SVM A1 retomam a E/S após o switchover. |
O MetroCluster IP cluster A falha, os nós do Proxmox VE no local A continuam em execução |
O ONTAP Mediator ou o MetroCluster Tiebreaker confirma que o cluster A está inacessível, e o ONTAP faz o switchover do local A. A SVM A1-mc inicia no local B com o mesmo endereço de LIF NFS. |
Sem alteração de quorum e sem reinicialização de VM. As VMs na SVM A1 retomam as operações de E/S após o switchover, com os nós do site A alcançando o site B por meio da rede entre sites. |
Um controlador no local A apresenta falha |
O parceiro de HA no local A assume o controle em uma tomada de controle de HA local. Não ocorre nenhum switchover. |
Sem impacto. As VMs pausam brevemente a E/S durante o takeover. |
Falha do local B |
O ONTAP faz o switchover para o site B. O SVM B1-mc inicia no site A com o mesmo endereço da LIF NFS. O SVM A1 continua a servir dados. |
Os nós do Site A e o QDevice mantêm o quorum. O HA reinicia as VMs do Site B nos nós do Site A, onde elas acessam a SVM B1 no Site A. |
Falha no link entre sites |
Não ocorre nenhum switchover, porque ambos os clusters ainda estão em execução. Cada site continua atendendo às suas próprias SVMs, e o espelhamento para o site parceiro é suspenso até que a conexão seja restabelecida. |
O QDevice dá seu voto à partição do site A quando o critério de desempate está alinhado com o site A. Os nós do site B perdem o quórum e se isolam automaticamente. O HA reinicia as VMs na SVM A1 nos nós do site A. As VMs na SVM B1 não podem reiniciar até que o link seja restabelecido, porque os nós do site A não conseguem alcançar a SVM B1. |
Falha do site C |
O espelhamento continua sem perda de dados, mas o switchover automático não é possível até que a testemunha esteja disponível. Você ainda pode fazer o switchover manualmente. |
O cluster mantém o quórum com os votos dos quatro nós. Nenhuma VM é afetada. |
Um nó do Proxmox VE apresenta falha |
Sem impacto. |
O HA reinicia as VMs desse nó em outros nós, dando preferência a nós no mesmo local. |
A falha no link entre os sites é a principal diferença em relação a um projeto com um site primário. Sempre que ambos os sites hospedam SVMs ativas, com MetroCluster ou com duas SVMs do SnapMirror active sync em direções opostas, o tie breaker do corosync pode favorecer apenas um dos sites. As VMs cuja SVM ativa está no outro site permanecem inativas até que o link seja restabelecido. Para limitar o impacto, use links redundantes entre os sites em caminhos físicos separados e coloque as VMs mais críticas na SVM do site que o tie breaker favorece.
Comparação de recursos
| Consideração | SnapMirror active sync para NAS | MetroCluster IP |
|---|---|---|
Escopo de proteção |
SVMs e volumes selecionados |
Todos os agregados espelhados e todas as SVMs na configuração |
Granularidade de failover |
Cada SVM de forma independente |
O local inteiro, por meio de switchover |
Cargas de trabalho desprotegidas |
Execute em SVMs desprotegidas nos mesmos clusters |
Você pode usar agregados não espelhados, que ficam offline após um switchover até que você os coloque online novamente |
Projeto de cluster |
Dois clusters independentes, interligados por uma rede IP |
Uma configuração de dois clusters parceiros, com uma rede de back-end IP dedicada do MetroCluster |
Testemunha no site C |
O ONTAP Mediator ou o ONTAP Cloud Mediator |
O ONTAP Mediator ou o MetroCluster Tiebreaker |
Cópias de dados protegidos |
Um em cada local |
Um em cada local, em agregados espelhados |
Caminho de replicação |
SnapMirror síncrono em LIFs entre clusters |
O SyncMirror e o espelhamento de NVRAM pela rede IP de back-end do MetroCluster |
Endereço NFS em ambos os sites |
VLAN de camada 2 estendida. LIFs VIP com qualificação BGP pendente |
VLAN estendida de camada 2, ou LIFs VIP com BGP |
Recuperação após falha do local |
Faça failback de cada SVM |
Repare os agregados e depois retorne o site |
Guia de seleção
-
Escolha o MetroCluster quando todas, ou quase todas, as cargas de trabalho no storage precisarem de RPO zero, por exemplo, quando uma empresa executa apenas VMs de missão crítica no cluster ou quando um provedor de serviços oferece o mesmo nível de disponibilidade para todos os locatários. Você obtém um domínio de proteção sem configuração por carga de trabalho.
-
Escolha o SnapMirror active sync quando apenas um subconjunto de cargas de trabalho precisar de RPO zero, por exemplo, um nível premium para alguns locatários ou quando você precisar fazer failover ou testar a recuperação de desastres para um locatário ou aplicativo por vez.
-
A sincronização ativa do SnapMirror para NAS não é compatível com uma configuração do MetroCluster. Use uma solução para cada par de clusters.
-
As orientações sobre corosync, QDevice e HA nesta solução se aplicam a ambos. Com o MetroCluster, alinhe o desempate do QDevice com o site que continua fornecendo dados quando o link entre sites falha e use regras de afinidade de nó de HA para manter as VMs no mesmo site que sua SVM ativa.
-
O MetroCluster IP também suporta VIP LIFs com BGP para redes de camada 3 entre sites.
Considerações sobre o Corosync para um cluster stretch do Proxmox VE
O Proxmox VE usa o corosync para associação ao cluster e quórum. O Corosync é mais sensível à rede entre sites do que o SnapMirror active sync, portanto planeje a rede do cluster primeiro.
Latência e projeto de rede
-
A sincronização ativa do SnapMirror requer um tempo de ida e volta (RTT) entre clusters inferior a 10 ms. O Proxmox recomenda uma latência do corosync inferior a 5 ms entre todos os nós, portanto o requisito do corosync define o limite de distância para a solução.
-
O Corosync precisa de baixa latência consistente, em vez de alta largura de banda. Use uma rede dedicada para o Corosync, separada do tráfego de storage e de migração ao vivo, para que picos de uso do storage não causem timeouts no Corosync.
-
Configure pelo menos dois links do Corosync (por exemplo, link 0 e link 1) em caminhos físicos separados entre os sites. O Corosync usa o Kronosnet para alternar os links automaticamente caso um dos caminhos falhe.
Quorum com um QDevice em um terceiro local
Divida os nós do Proxmox VE igualmente entre o site A e o site B e adicione um QDevice no site C. Com quatro nós e um QDevice, o cluster tem cinco votos e precisa de três para quorum, portanto, qualquer um dos sites pode falhar sem perder o quorum. O QDevice se conecta ao cluster pela porta TCP 5403 e não tem o requisito de baixa latência do corosync, então pode compartilhar o site C com o ONTAP Mediator. Se você usar o ONTAP Cloud Mediator, ainda precisará de um terceiro local para o QDevice, mas pode ser um pequeno host Linux que não hospede também um mediator.
Alinhamento do critério de desempate com o cluster primário
Quando o link entre os sites falha, mas ambos os sites ainda conseguem alcançar o site C, o ONTAP mantém o cluster primário no site A servindo dados. O QDevice deve dar seu voto ao mesmo site. Por padrão, o QDevice escolhe a partição que contém o menor ID de nó.
MELHOR PRÁTICA: crie o cluster Proxmox VE em um nó do site A e adicione os outros nós do site A antes de adicionar os nós do site B, para que o site A tenha os menores IDs de nó. Se o storage primário permanecer no site B por um período prolongado, atualize a configuração de QDevice tie_breaker para um ID de nó do site B.
Se o QDevice priorizasse o site B, os nós do site A se isolariam automaticamente, e o HA reiniciaria as VMs nos nós do site B que não conseguissem acessar o storage ativo no site A.
Comportamento de HA e posicionamento de VM
-
O Proxmox VE HA normalmente detecta um nó com falha e recupera suas VMs em cerca de dois minutos, incluindo um tempo limite de 60 segundos para watchdog fencing. Durante uma falha do local, o failover do SnapMirror active sync e a recuperação do Proxmox VE HA são executados em paralelo.
-
Use regras de afinidade de nós de HA com prioridades de nós para colocar as VMs nos nós que estão no mesmo site que seu storage primário e para permitir que elas façam failover para o outro site.
-
Após um failover do local, defina a propriedade HA
failbackcomo0para as VMs afetadas até você fazer o failback do storage. Caso contrário, o HA migrará as VMs de volta para os nós do site A assim que eles retornarem, enquanto o storage ativo ainda estará no site B. -
Certifique-se de que os tempos limite de disco do sistema operacional convidado sejam maiores do que o tempo de failover esperado, para que os sistemas convidados não relatem erros de E/S durante um failover de storage.
Integração com o Storage Manager for Proxmox
O Storage Manager for Proxmox (SMP) oferece aos administradores do Proxmox VE uma interface para provisionar o storage compartilhado do ONTAP e para fazer backup, restaurar e clonar VMs usando snapshots do ONTAP e a tecnologia FlexClone. O SMP se conecta ao cluster do Proxmox VE e ao ONTAP por meio de suas APIs, portanto não precisa de agentes nos nós do Proxmox VE.
O SMP e SnapMirror active sync protegem contra diferentes tipos de falhas. SnapMirror active sync mantém as VMs em execução durante uma falha de storage ou do local, mas replica cada gravação de forma síncrona, inclusive uma exclusão acidental, uma atualização malsucedida do sistema operacional convidado ou dados criptografados por ransomware. Os snapshots do SMP oferecem cópias em um ponto no tempo para recuperar dessas falhas lógicas. Juntos, eles oferecem disponibilidade contínua e recuperação operacional rápida a partir do mesmo storage do ONTAP.
| Camada de proteção | Protege contra | Ponto de recuperação | Gerenciado com |
|---|---|---|---|
Sincronização ativa do SnapMirror |
Falha do sistema e falha do local |
Sem perda de dados |
ONTAP |
Backups SMP (snapshots do ONTAP) |
Exclusão acidental, corrupção de dados, falhas em atualizações e ransomware |
Último backup programado ou sob demanda |
SMP |
SnapMirror fan-out assíncrono ou o Proxmox Backup Server |
Perda de ambos os locais e retenção de longo prazo |
Última replicação ou backup |
O ONTAP ou o Proxmox Backup Server |
Backup e recuperação
O SMP cria backups consistentes com falhas ou consistentes com arquivos como snapshots do ONTAP dos volumes de storage, sob demanda ou por política, e restaura VMs, storage ou grupos de recursos individuais:
-
Use grupos de recursos e políticas de backup para aplicar o mesmo agendamento e a mesma retenção às VMs de um locatário ou de uma aplicação.
-
Use backups consistentes com o sistema de arquivos para VMs que executam o agente convidado QEMU, para que os sistemas de arquivos convidados entrem em estado de quiescência antes que o ONTAP crie o snapshot.
-
O SMP gerencia o storage que está ativo. Após um failover de active sync do SnapMirror, execute uma descoberta no SMP para que ele mapeie o storage para o cluster B antes de executar operações de backup ou restauração.
-
Para uma terceira cópia fora dos dois locais, ou para uma retenção mais longa, adicione uma relação assíncrona de fan-out do SnapMirror a partir dos volumes protegidos, ou use o Proxmox Backup Server.
-
Snapshots à prova de adulteração não são compatíveis com SnapMirror active sync, portanto não habilite o bloqueio de snapshots no SMP para volumes protegidos.
Clonagem de VM
O SMP usa a tecnologia FlexClone do ONTAP para criar clones de VM com uso eficiente de espaço para desenvolvimento, testes e provisionamento rápido. Os clones que você cria no storage protegido consomem largura de banda de replicação e capacidade em ambos os sites. Exclua da proteção do SnapMirror active sync os clones e o storage de teste que não precisam de continuidade dos negócios.
Posicionamento de SMP
-
Execute a VM SMP como um recurso de alta disponibilidade em um storage compartilhado protegido pelo SnapMirror active sync, para que o SMP permaneça disponível após uma falha de storage ou do local.
-
Registre o cluster Proxmox VE e ambos os clusters ONTAP no SMP, para que o SMP possa acessar o armazenamento ativo em qualquer um dos sites.
Storage compartilhado NFS com SnapMirror active sync para NAS
A partir do ONTAP 9.19.1, o SnapMirror active sync protege as cargas de trabalho NAS. As considerações a seguir se aplicam somente ao storage compartilhado NFS. Para implantar a solução com storage NFS, siga o "Fluxo de trabalho de configuração do NAS".
Proteção em nível de SVM e identidade de rede
-
O SnapMirror active sync para NAS protege uma máquina virtual de storage (SVM) inteira. Você pode proteger todos os volumes na SVM ou excluir volumes selecionados. Somente volumes FlexVol são compatíveis, e a SVM não pode conter LUNs.
-
A SVM secundária permanece inativa, com as LIFs desativadas, até que ocorra um failover. O ONTAP replica a configuração da SVM, incluindo os endereços IP das LIFs, as políticas de exportação e as configurações de NFS, de modo que a SVM secundária apresente o mesmo endpoint NFS após um failover.
-
O failover não causa interrupções no NFSv3 e versões posteriores.
-
O SnapMirror active sync para NAS é ativo-passivo, portanto as VMs nos nós do site B leem e gravam pela rede entre sites na SVM primária. Para cargas de trabalho ativas em ambos os sites, use duas SVMs com direções de replicação opostas, uma primária em cada site, e alinhe a regra de afinidade de nó de cada VM com o site de sua SVM primária.
-
O SnapMirror active sync para NAS é compatível com clusters AFF de dois nós das séries A e C.
Configurações do cliente NFS
Use NFSv3 ou NFSv4.1 para o storage NFS. Mantenha o comportamento padrão de hard mount e não adicione a opção de montagem soft, para que as operações de E/S do NFS sejam repetidas em vez de falhar durante um failover.
Use várias conexões TCP com o armazenamento para melhor desempenho e tolerância de falhas. Use nConnect ou trunking de sessão, não ambos:
-
nConnect. Abre várias conexões TCP para um único endereço LIF de NFS, por exemplo
nconnect=4. O nConnect funciona com NFSv3 e NFSv4.1 e com um único endereço LIF VIP, sendo a opção recomendada para o SnapMirror active sync para NAS, incluindo redes de camada 3. -
Trunking de sessão. Agrupa várias LIFs de dados em uma única sessão NFSv4.1, por exemplo
vers=4.1,trunkdiscovery,max_connect=16. O trunking de sessão requer NFSv4.1 ou posterior. Use-o somente quando a SVM protegida tiver várias LIFs de dados que os clientes possam acessar em ambos os sites, como em uma rede de camada 2 estendida. Para obter detalhes, consulte "Trunking de NFS".
Para obter informações sobre os comandos de opção de montagem e as etapas de verificação, consulte "Configure o armazenamento NFS para o Proxmox VE.".
Provisionamento de storage NFS com SMP
O SMP provisiona um volume do ONTAP, cria ou seleciona uma política de exportação e monta o volume como storage compartilhado NFS nos nós do Proxmox VE que você selecionar. Para storage em uma SVM protegida:
-
Provisione o volume na SVM primária e selecione a NFS LIF ou a VIP LIF em uma rede de camada 3 como a LIF preferencial. A SVM secundária usa o mesmo endereço após um failover, portanto a definição de storage permanece válida.
-
Monte o armazenamento em todos os nós do Proxmox VE em ambos os sites para que o HA possa reiniciar as VMs em qualquer nó.
-
Certifique-se de que a política de exportação permita os nós Proxmox VE em ambos os sites. O ONTAP replica a política de exportação para o SVM secundário.
-
Após o provisionamento, verifique se o volume está incluído na proteção de sincronização ativa do SnapMirror.
Redes de camada 3 com VIP LIFs e BGP
SnapMirror active sync para NAS requer o mesmo endereço IP na SVM primária e na secundária. Quando a VLAN NFS é estendida entre os sites, o endereço IP da LIF se move com a SVM. Quando os sites estão conectados por uma rede roteada de camada 3, a sub-rede de uma LIF do site A não existe no site B.

|
Na época da publicação, a NetApp não documentou VIP LIFs com BGP como uma configuração qualificada para o SnapMirror active sync para NAS. Antes de planejar um design de camada 3, confirme o suporte atual com a NetApp. Caso contrário, estenda a VLAN NFS entre os sites. As configurações IP do MetroCluster suportam VIP LIFs com BGP. |
As LIFs de IP virtual (VIP) do ONTAP resolvem esse problema. Uma VIP LIF não pertence a nenhuma sub-rede. O ONTAP anuncia o endereço VIP aos roteadores pares como uma rota de host /32 usando o Border Gateway Protocol (BGP), permitindo que o endereço se mova entre sites sem a necessidade de uma VLAN estendida.
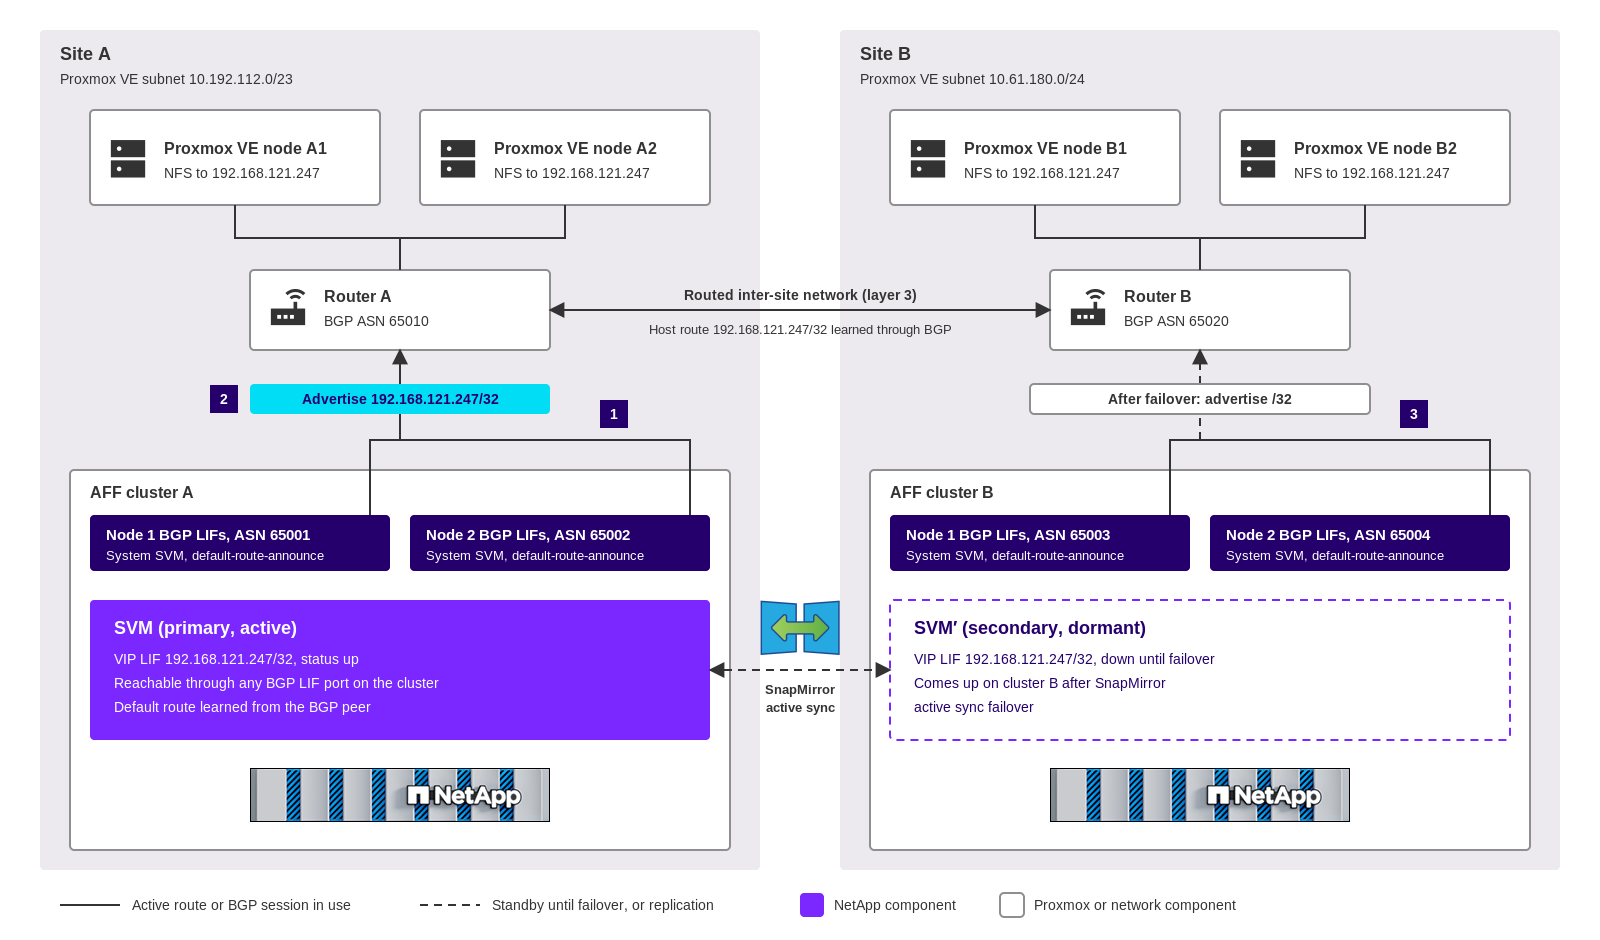
-
Cada nó em ambos os sites possui LIFs BGP na SVM do sistema que estabelecem peering com os roteadores em seu respectivo site. As LIFs BGP são específicas de cada nó e não são replicadas, portanto, configure-as em ambos os clusters.
-
A SVM primária hospeda a LIF VIP NFS. O Cluster A anuncia a rota de host /32, e os nós do Proxmox VE em ambos os locais acessam o storage por meio da rede roteada.
-
Após um failover do SnapMirror active sync, a LIF VIP fica ativa na SVM secundária, o cluster B anuncia a rota do host e os roteadores convergem no local B.
Ao planejar o BGP no ONTAP pela primeira vez, é útil saber qual SVM possui cada LIF. As LIFs BGP pertencem à SVM do sistema do IPspace, e não às SVMs de dados. Um conjunto de LIFs BGP em cada cluster atende às LIFs VIP de todas as SVMs de dados nesse IPspace, portanto, você não cria LIFs BGP para cada tenant. O diagrama a seguir mostra o layout de LIFs e portas em um cluster, com LIFs BGP em portas VLAN.
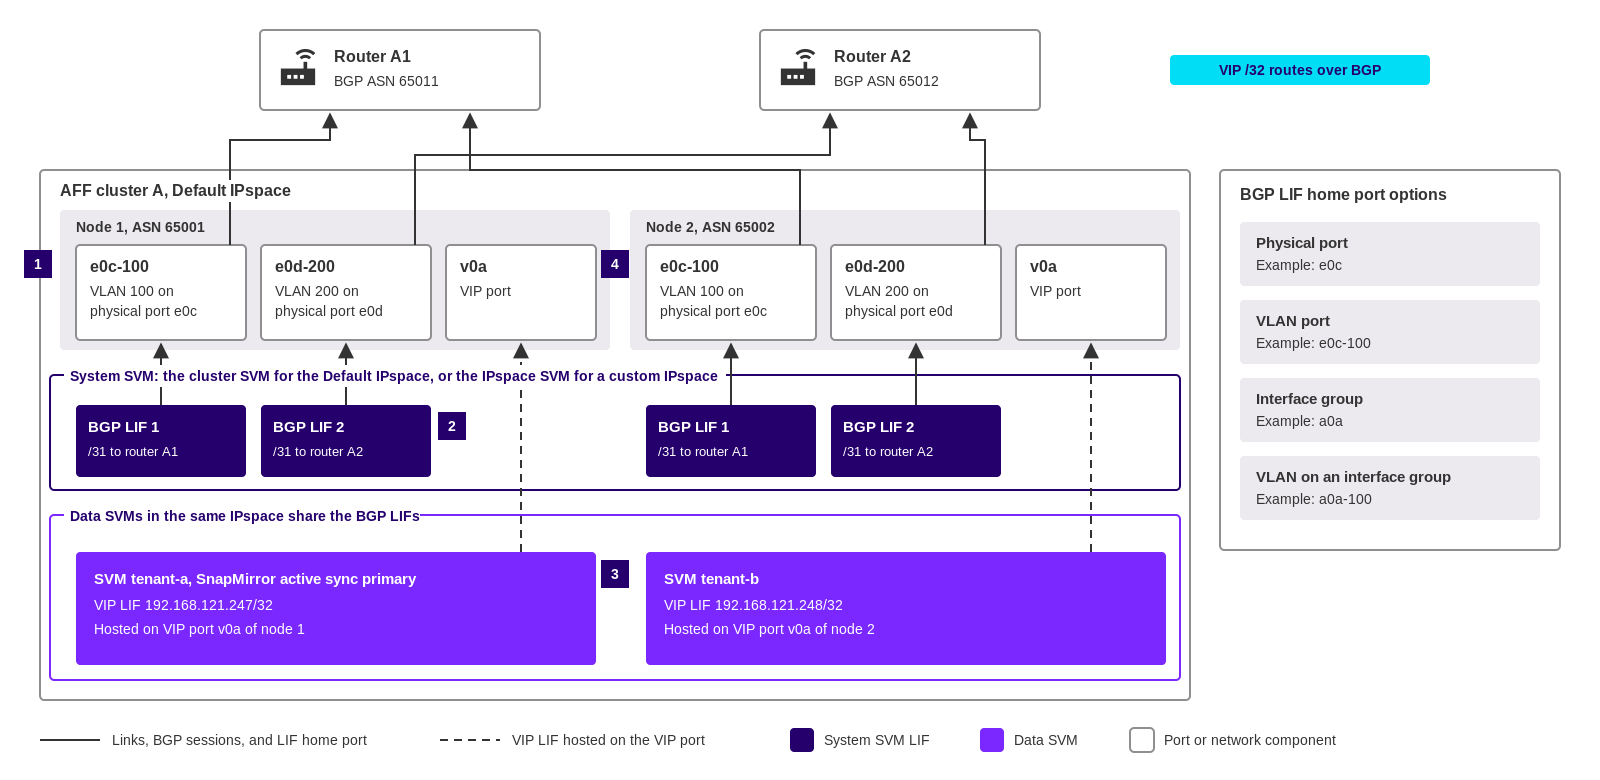
-
Cada nó possui duas portas para BGP, neste exemplo as portas VLAN
e0c-100ee0d-200. Cada porta se conecta diretamente a um roteador diferente. -
Cada nó possui duas LIFs BGP no SVM do sistema, uma em cada porta, com uma sub-rede /31 e um grupo de pares BGP para um roteador. Para o IPspace padrão, o SVM do sistema é o SVM do cluster. Para um IPspace personalizado, é o SVM com o mesmo nome do IPspace.
-
As SVMs de dados no mesmo IPspace hospedam VIP LIFs e não precisam de BGP LIFs próprias. Os grupos de pares BGP anunciam as rotas VIP para todas as SVMs no IPspace.
-
O ONTAP cria uma porta VIP, por exemplo
v0a, em cada nó quando você cria o primeiro grupo de pares BGP. As LIFs VIP são hospedadas na porta VIP e podem ser acessadas por meio de todas as portas do nó que hospeda uma LIF BGP no IPspace.
A porta inicial de uma LIF BGP pode ser uma porta física, uma porta VLAN, um grupo de interfaces ou uma VLAN em um grupo de interfaces. Um grupo de interfaces não é obrigatório. NetApp Technical Report TR-4949 recomenda duas LIFs BGP em duas portas separadas para cada IPspace, cada uma conectada diretamente a um roteador de primeiro salto diferente.
Mantenha as seguintes diretrizes em mente:
-
As LIFs de BGP não realizam failover. A redundância vem de duas LIFs de BGP por nó, cada uma estabelecendo peering com um roteador diferente. Se um nó perder todas as suas sessões de BGP para uma SVM, o ONTAP move a VIP LIF para outro nó que tenha uma sessão de BGP ativa para essa SVM.
-
Use o BGP externo (eBGP) com um número de sistema autônomo (ASN) privado e exclusivo para cada nó ONTAP e cada roteador.
-
Use uma sub-rede /31 (máscara de rede 255.255.255.254) para cada LIF BGP e seu roteador. Atribua o endereço ímpar à LIF BGP e o endereço par ao roteador.
-
O ONTAP não processa rotas dos roteadores. Configure os roteadores para aceitarem rotas de host /32 do ONTAP e para não enviarem atualizações de rotas para o cluster.
-
Os nós do Proxmox VE não devem compartilhar uma sub-rede com o endereço VIP. Um roteador redundante de camada 3, por exemplo com VRRP ou HSRP, deve estar no caminho entre os nós e o storage.
-
Configure os grupos de pares BGP com
-use-peer-as-next-hop truepara que cada cluster aprenda sua rota padrão com seus roteadores locais. As rotas que apontam para um gateway do site A não são válidas no site B após um failover. -
Habilite o roteamento multipath para que o tráfego VIP de saída utilize todas as portas BGP LIF disponíveis.
-
Reduza o tempo de espera do BGP do valor padrão de 180 segundos. A TR-4949 recomenda um tempo de espera de 3 segundos. Um roteador retira a rota de um cluster com falha somente quando o timer de espera expira e, durante uma falha do sistema de storage, o roteador no site A permanece online.