


Modifications récentes dans la NetApp Console


 Suggérer des modifications

 PDF

Découvrez les modifications les plus récentes apportées aux fonctionnalités et aux services de données qui font partie de la NetApp Console. Pour un historique complet des versions, accédez au"ensemble complet de notes de version" pour chaque service individuel.

|
Les services suivants ont été abandonnés :
|
[[02-november-2026]]
== 02 novembre 2026
Cloud Volumes ONTAP
Instructions pour la mise à niveau des correctifs ONTAP pour des versions spécifiques de Cloud Volumes ONTAP
ONTAP a publié les correctifs suivants compatibles avec les versions 9.14.1, 9.15.1, 9.16.1, 9.17.1, 9.18.1 et 9.19.1 de Cloud Volumes ONTAP :
-
9.14.1P18HF1
-
9.15.1P20HF1
-
9.16.1P16HF1
-
9.17.1P11HF1
-
9.18.1P8HF1
-
9.19.1P3HF1
Pour plus de détails, consultez "Avis de sécurité NTAP 20261021-0021".
Pour vos systèmes Cloud Volumes ONTAP, il se peut qu’une invite vous demande d’effectuer la mise à niveau vers ces correctifs dans la NetApp Console. Toutefois, ces correctifs sont pris en charge uniquement lorsque la version de l’agent Console est 4.12.0 ou ultérieure. Si la version de l’agent Console est antérieure à 4.12.0, ignorez l’invite.
[[01-november-2026]]
== 01 novembre 2026
Workload Factory
Améliorations de l'administration de Workload Factory
Vérifier et actualiser les données du tableau de bord personnalisé
Vous pouvez désormais consulter la date et l'heure de la dernière mise à jour des indicateurs de votre tableau de bord personnalisé et les actualiser manuellement. Survolez Actualiser les données pour afficher la date et l'heure de la dernière mise à jour.
Sélectionnez Actualiser les données pour lancer une nouvelle analyse. Une bannière confirme que l'analyse a démarré, et le bouton est désactivé jusqu'à la fin de l'analyse.
Lorsque de nouvelles données sont disponibles, sélectionnez Charger maintenant dans la bannière de notification pour mettre à jour le tableau de bord.
Les options Refresh data et Load it now créent toutes deux des événements de collecte de données dans Tracker.
Spécifiez les régions pour les tableaux de bord personnalisés
Les tableaux de bord personnalisés vous invitent désormais à sélectionner une ou plusieurs régions si votre requête ne les inclut pas. Les données du tableau de bord sont limitées aux régions sélectionnées.
Stratégie IAM pour la création de liens FSx for ONTAP
Le modèle CloudFormation et le code Terraform permettant de créer des liens utilisent désormais une stratégie IAM au lieu des autorisations Lambda intégrées.
Audit et suivi des actions des agents d’IA
Vous pouvez désormais utiliser Tracker pour consulter les modifications apportées aux paramètres de l'agent IA et, en mode lecture/écriture, chaque demande d'approbation, y compris la question de l'agent et la réponse de l'utilisateur.
Les modifications de ressources effectuées via les API Workload Factory sont consignées par le service Workload Factory qui effectue l'opération.
Améliorations d’Amazon FSx for NetApp ONTAP
Améliorations apportées au diagramme du groupe initiateur
Le diagramme affichant les groupes d'initiateurs pour les périphériques de stockage bloc sur la page « Gérer l'accès client » contient désormais plus de détails sur les hôtes. Lorsque vous survolez un hôte dans le diagramme, ses détails s'affichent, notamment le nom de l'hôte, l'ID d'instance, le type de workload, la région et le nom qualifié iSCSI (IQN).
Amélioration des e-mails pour les problèmes bien architecturés
Le nouveau format des e-mails fournit davantage de détails et de contexte sur les problèmes de configuration détectés par Workload Factory. L'e-mail indique le nombre de ressources analysées, le nombre de celles présentant des alertes ou des problèmes critiques, ainsi que la nature de ces problèmes. L'e-mail contient également un lien vers le tableau de bord Well-Architected de FSx for ONTAP afin que vous puissiez résoudre les problèmes immédiatement.
Améliorations du tableau de bord bien architecturé
Prise en charge de certaines vérifications de configuration
Vous pouvez exécuter manuellement une analyse sur les configurations sélectionnées afin d'analyser uniquement les configurations qui vous intéressent et de réduire ainsi le temps d'attente.
Nouvelles recommandations dans l'analyse bien architecturée
Workload Factory inclut désormais les configurations suivantes dans l'analyse bien architecturée pour les systèmes de fichiers FSx for ONTAP :
Pour les workloads de stockage :
-
Connecter l'hôte au nœud de basculement : vérifie si les hôtes sont connectés au nœud de basculement dans un système de fichiers FSx for ONTAP actif-passif pour des raisons de fiabilité.
-
Connecter l'hôte au nœud préféré : vérifie si les hôtes sont connectés à leurs périphériques bloc en utilisant le nœud préféré pour optimiser les performances.
-
Lacune de la détection multi-périphériques ARP/AI : ARP/AI assure une protection complète lorsqu'un volume n'a qu'un seul périphérique de bloc qui lui est associé. Si un volume comporte plusieurs périphériques de bloc qui lui sont attachés, Workload Factory les déplace vers de nouveaux volumes afin que chaque volume n'ait qu'un seul périphérique de bloc.
-
Nettoyage des clones : vérifie s’il existe des clones de volume datant de plus de 30 jours qui peuvent être supprimés afin d’optimiser l’utilisation du stockage et de réduire les coûts.
-
Correspondance du système d'exploitation du groupe d'initiateurs à celui de l'hôte : vérifie si le système d'exploitation du groupe d'initiateurs (igroup) correspond à celui de l'hôte afin d'éviter les problèmes d'E/S ou de performances.
Pour les workloads Kubernetes :
-
Configuration QoS : vérifie si les volumes persistants Kubernetes sont protégés par une politique QoS ONTAP pour optimiser les performances.
-
VM de stockage Kubernetes dédiée : vérifie si le système de fichiers utilise une VM de stockage dédiée pour les workloads Kubernetes afin d’améliorer l’isolation et de simplifier la gestion du stockage.
-
Règles d'export Kubernetes dédiées : vérifie si chaque volume persistant Kubernetes possède des règles d'export dédiées qui autorisent uniquement l'accès depuis les nœuds worker du cluster.
-
CHAP bidirectionnel pour les backends iSCSI Kubernetes : vérifie si les backends iSCSI Trident ont l’authentification CHAP mutuelle activée pour des raisons de sécurité.
-
Désactiver
showmountsur la VM de stockage d'application : vérifie sishowmountest désactivé sur la VM de stockage d'application afin d'empêcher les clients de lister les exports auxquels ils ne peuvent pas accéder.
Pour les workloads de base de données :
-
Stratégie de snapshot SAP HANA : vérifie si la stratégie de snapshot est définie sur « Aucun » pour les volumes SAP HANA afin de réduire les coûts de stockage et d’améliorer les performances des données actives de la base de données.
-
Politique de snapshot MySQL : vérifie si la politique de snapshot est définie sur « Aucun » pour les volumes MySQL afin de réduire les coûts de stockage et d’améliorer les performances des données actives de la base de données.
-
Politique de snapshot PostgreSQL : vérifie si la politique de snapshot est définie sur « Aucun » pour les volumes PostgreSQL afin de réduire les coûts de stockage et d’améliorer les performances des données de base de données actives.
Valeurs actuelles et recommandées pour les configurations
Vous pouvez consulter les valeurs actuelles et recommandées de certaines configurations non optimisées dans le tableau de bord Well-Architected. Cela vous indique la valeur recommandée avant de la corriger.
-
Hiérarchisation des données froides
-
Stratégie de snapshot
-
marge de capacité SSD
Optimisation des coûts
Prévisions et analyses de coûts
Vous pouvez désormais prévoir les coûts de vos systèmes de fichiers FSx for ONTAP grâce à la fonctionnalité de prévision des coûts. Cela vous permet de planifier votre budget et d'optimiser efficacement vos ressources. Vous pouvez également consulter des informations sur vos coûts et vos habitudes d'utilisation afin d'identifier des opportunités d'optimisation des coûts.
Rapports de coûts et d'utilisation AWS (CUR)
Workload Factory utilise désormais AWS Cost and Usage Reports (CUR) au lieu d'AWS Cost Explorer pour fournir des relevés de facturation détaillés livrés dans des compartiments S3 appartenant aux clients. CUR offre une meilleure granularité des coûts et constitue la base pour des cas d'utilisation avancés de FinOps, de refacturation et d'allocation des coûts.
Améliorations de la migration des machines virtuelles de stockage
Workload Factory fournit des conseils améliorés dans l'interface utilisateur pour la migration des machines virtuelles de stockage. Cela comprend des instructions étape par étape et une exécution de test avant de valider la migration en production.
Amélioration des notifications par e-mail concernant le délai de réplication
En cas de grand nombre d'événements de retard de réplication liés, Workload Factory les regroupe automatiquement dans une seule notification par e-mail afin que vous ne soyez pas submergé de notifications.
Amélioration automatique de la gestion de la capacité
Vous pouvez désormais activer les notifications automatiques de gestion de la capacité pour essayer la fonctionnalité avant de demander à Workload Factory de gérer automatiquement votre capacité. Vous serez averti lorsque votre système de fichiers manquera de capacité.
Configurations de base de données incluses dans un tableau de bord bien architecturé
Le tableau de bord à l’architecture optimisée inclut désormais des recommandations pour les configurations de votre base de données, vous permettant d’évaluer et d’optimiser votre installation selon les meilleures pratiques. Les premières configurations affichées dans le tableau de bord sont :
-
Hiérarchisation des données froides
-
Efficacités du stockage
-
Stratégie de snapshot
-
marge de capacité SSD
-
Gestion de l'espace des périphériques de blocs
-
Type de OS
-
Faire correspondre le type de système d'exploitation du périphérique de bloc à l'hôte
-
Périphériques de bloc inactifs (LUNs)
-
Placement des fichiers de données (.mdf)
-
Emplacement des fichiers journaux (.ldf)
-
État des E/S multipath
-
Délai d'attente des E/S multivoies
-
quorum du cluster
-
Dimensionnement optimal des ressources de calcul
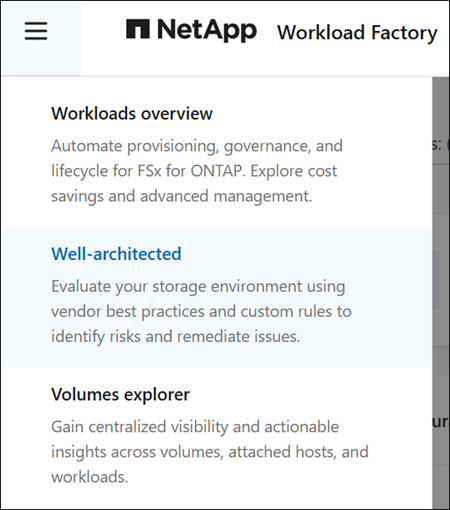
Sélectionnez le menu principal dans la console Workload Factory, puis sélectionnez Well-architected pour trouver le tableau de bord Well-architected.
Points de décision relatifs au débit
Vous pouvez désormais consulter les recommandations de débit client et les points de décision d'automatisation. Survolez un point de décision pour afficher des détails, tels que le SKU actuel et recommandé ou les métriques dépassées dans la fenêtre temporelle (%).
Améliorations de Workload Factory pour VMware
Ces améliorations concernent le calculateur de coût total de possession (TCO) d'EVS pour les migrations VMware.
Prise en charge des instances i7i.metal-24xl et i7i.metal-48xl dans l’EVS TCO calculator
Le calculateur de coût total de possession (TCO) d'EVS prend désormais en charge les instances EC2 AWS i7i.metal-24xl et i7i.metal-48xl comme hôtes de cluster. Par rapport aux configurations i4i.metal, les instances i7i.metal-24xl permettent de réduire le coût initial d'EVS d'environ 33 % pour le calcul et de 25 % pour le stockage vSAN.
Le calculateur compare tous les types d'instances et sélectionne automatiquement l'option la plus économique. Une nouvelle section de comparaison affiche les configurations hôtes EVS côte à côte, facilitant ainsi le choix de la configuration la mieux adaptée à vos besoins.
Améliorations de Workload Factory pour EDA
Ces améliorations portent sur les détails du volume dans l'analyse de latence, une vérification de la pression du système de fichiers, les points de décision du débit et la relance d'une analyse de latence.
Afficher les détails du volume pendant l'analyse de latence
Vous pouvez consulter plus de détails sur le volume dans Workload Factory pendant que vous analysez un événement de latence afin de voir comment le volume est configuré. La page d'analyse détaillée de la latence affiche le type de volume (RW ou DP) et le style de volume (FlexVol ou FlexGroup).
Vérifiez la pression du système de fichiers pour un événement de latence
Dans Workload Factory, vous pouvez vérifier si la pression sur le système de fichiers a affecté les performances lorsqu’un événement de latence s’est produit afin de décider si vous devez examiner le système de fichiers. Pour un volume présentant une alerte de latence, vous pouvez consulter les données CloudWatch des 40 minutes précédant l’événement et ouvrir le système de fichiers pour approfondir l’analyse.
Examiner les points de décision relatifs au débit pour l'EDA
Vous pouvez consulter les points de décision relatifs au débit du client sur le tableau de bord EDA Overview afin de voir quand Workload Factory a recommandé ou appliqué une modification du débit. Survolez un point de décision pour afficher des détails, tels que la référence SKU actuelle et recommandée ou les métriques ayant dépassé les seuils dans la fenêtre temporelle.
Effectuez à nouveau une analyse de latence
Vous pouvez relancer une analyse de latence dans Workload Factory pour un volume afin d’actualiser les résultats après vos investigations ou modifications. Sélectionnez Relancer l’analyse pour démarrer une nouvelle analyse et mettre à jour les résultats.
Améliorations de Google Cloud NetApp Volumes
Afficher les pools de stockage Google Cloud NetApp Volumes
Vous pouvez désormais consulter vos pools de stockage Google Cloud NetApp Volumes dans NetApp Workload Factory. Filtrez par projets, identifiants et région, puis sélectionnez le nom d’un pool de stockage pour afficher tous ses détails, notamment la zone, la zone de réplication, le débit, la description et les étiquettes.
Améliorations du service de stockage OCI NetApp
Analyse de l’architecture optimisée des systèmes OCI NSS
NetApp Workload Factory inclut l’évaluation well-architected pour les systèmes OCI NSS. L’évaluation fournit des informations, des recommandations et des correctifs pour vous aider à atteindre l’excellence opérationnelle.
Des évaluations de configuration sont disponibles pour les piliers suivants du cadre OCI Well-Architected :
-
Fiabilité : capacité des objets de fichier, stratégie de snapshots et marge de capacité SSD
-
Excellence opérationnelle : rapports de capacité visibles par l’hôte et marge de capacité du volume
-
Optimisation des coûts : hiérarchisation des données froides, nettoyage des instantanés et efficacité du stockage
Apprenez-en davantage sur "l'analyse bien architecturée des systèmes OCI NSS" et sur "mise en œuvre de configurations bien architecturées".
[[26-october-2026]]
== 26 octobre 2026
AI Data Engine
AI Data Engine 1.3
AI Data Engine est un service d'intelligence des métadonnées, géré via NetApp Console, qui analyse vos systèmes connectés, crée un catalogue de métadonnées et vous offre la visibilité et les outils nécessaires pour optimiser le stockage et gouverner les données à grande échelle. Vous pouvez déployer AI Data Engine en tant qu' "Déploiement AIDE sur un seul nœud", ou comme déploiement AIDE multi-nœuds si votre environnement nécessite une haute disponibilité basée sur Kubernetes à grande échelle.
AI Data Engine 1.3 est la première version en disponibilité générale (GA).
- "Déployez à l’échelle requise par votre environnement"
-
Choisissez un déploiement AIDE mono-nœud pour un démarrage rapide sur une seule machine virtuelle, ou un déploiement AIDE multi-nœuds sur votre propre cluster Kubernetes pour une haute disponibilité et une plus grande évolutivité. Si votre environnement nécessite un proxy pour accéder à internet, "en savoir plus sur les proxys pour AIDE" déployez avec un proxy.
- "Intégrez vos données dans le périmètre"
-
Connectez les partages de fichiers, les serveurs de base de données et les systèmes StorageGRID, puis choisissez les ressources de données à analyser.
- "Maintenez l’analyse en bon état"
-
Surveillez l'état de votre déploiement pour identifier les problèmes susceptibles d'interrompre l'analyse et recueillir les informations nécessaires à leur résolution.
- "Récupérer la capacité de stockage"
-
Identifiez les données froides, obsolètes et en double dans vos systèmes connectés en fonction des seuils que vous avez configurés, et voyez quels systèmes et propriétaires des données présentent les plus fortes concentrations de ces données.
- "Définissez les données froides et obsolètes pour votre organisation"
-
Définissez les seuils qui déterminent quelles données sont classées comme froides ou obsolètes afin qu'elles correspondent à vos politiques de conservation.
- "Identifier les personnes à contacter concernant les données"
-
Identifiez les propriétaires des données qui détiennent les plus fortes concentrations de données froides, obsolètes ou dupliquées sur le tableau de bord. Filtrez ensuite par propriétaire ou par groupe dans la vue d'investigation pour examiner les résultats et déterminer les personnes à contacter.
- "Réduisez les coûts et les risques"
-
Filtrez dans tous les systèmes connectés selon le temps d'accès, la date de modification, la date de création, la taille du fichier, le statut de doublon et d'autres critères afin de trouver les fichiers qui répondent aux objectifs de gestion des données de votre organisation. Agissez directement sur les résultats ou enregistrez les critères comme stratégie.
- "Éliminer les données en double"
-
Recherchez les fichiers qui ont des copies en double sur vos systèmes connectés. Filtrez par l’attribut « Doublons » ou par hachage de fichier pour examiner les groupes de doublons, puis supprimez les copies en double.
- "Identifier les risques d'accès"
-
Identifiez les répertoires dont les autorisations sont ouvertes afin de pouvoir les classer par priorité pour un examen des autorisations.
- "Analyser les données structurées"
-
Trouvez les tables de base de données surdimensionnées ou inutilisées sur vos serveurs de base de données connectés.
- "Réduisez les coûts de stockage"
-
Appliquez les politiques de cycle de vie des données de votre organisation en copiant et en archivant les fichiers vers des destinations NFS ou SMB, en étiquetant les éléments pour le suivi ou en supprimant définitivement les fichiers conformément à vos exigences de conservation.
- "Surveiller en continu les conditions des données"
-
Enregistrez les critères de filtrage sous forme de stratégies nommées pour suivre les conditions récurrentes des données au fil du temps, telles que les fichiers froids ou surdimensionnés, et recevez des notifications lorsque le nombre de fichiers affectés change.
- "Donnez aux clients d'IA un accès gouverné à vos métadonnées"
-
Connectez Claude Code, Claude Desktop, Cursor ou OpenCode à AI Data Engine via le protocole Model Context Protocol (MCP). Activez les collections que les clients d’IA peuvent rechercher et utilisez les portées Microsoft Entra ID pour contrôler qui peut rechercher dans chaque collection. Les clients d’IA peuvent rechercher des métadonnées et des fichiers de balises.
- "Attribuer les rôles d'administrateur et de lecteur"
-
Contrôlez qui peut analyser les données et prendre des mesures en attribuant aux utilisateurs de votre organisation le rôle d’administrateur ou de lecteur AI Data Engine.
Sauvegarde et récupération
Améliorations des charges de travail Kubernetes
Dans cette version, NetApp Backup and Recovery introduit les améliorations suivantes pour les charges de travail Kubernetes :
-
Trident Protect 26.10 : Cette version inclut Trident Protect 26.10.
-
Prise en charge des pilotes ontap-nas-economy et ontap-san-economy : Vous pouvez désormais protéger les revendications de volume persistant (PVC) provisionnées par le pilote NetApp Trident
ontap-nas-economy(Qtrees) et par le piloteontap-san-economy(LUN). Lorsque vous protégez des PVC à l’aide de pilotes economy, l’intégralité du FlexVol® ou du LUN sous-jacent est protégée. Vous pouvez restaurer des PVC individuels à partir de ces sauvegardes. -
Alertes prenant en compte Kubernetes : les alertes sont désormais envoyées une fois par application Kubernetes au lieu d'une fois par volume.
-
Prise en charge des snapshots de groupes de volumes : Vous pouvez désormais créer des groupes de volumes lors de la définition d’une application Kubernetes. Les groupes de volumes vous permettent de créer des snapshots de plusieurs volumes ensemble en tant qu’ensemble cohérent en cas de panne, garantissant la cohérence des données sur l’ensemble des volumes du groupe.
-
Prise en charge du stockage d'objets compatible S3 : Vous pouvez désormais sauvegarder les ressources et les données de votre application Kubernetes sur un stockage d'objets compatible S3 en ajoutant les identifiants de la cible de sauvegarde et en configurant les politiques de protection.
Pour plus de détails sur la protection des charges de travail Kubernetes, consultez "Découvrez comment protéger les charges de travail Kubernetes avec NetApp Backup and Recovery".
Améliorations des charges de travail des volumes ONTAP
Dans cette version, NetApp Backup and Recovery apporte les améliorations suivantes pour les charges de travail associées aux volumes ONTAP :
-
Rapports de protection : NetApp Backup and Recovery prend désormais en charge la création et le téléchargement de rapports détaillés pour les charges de travail associées aux volumes ONTAP.
-
Conservation des sauvegardes lors de la désinscription d'un système ONTAP : lorsque vous désinscrivez un système ONTAP de NetApp Backup and Recovery, vous pouvez désormais choisir de supprimer les données précédemment sauvegardées ou de les conserver pour une éventuelle restauration. La documentation de NetApp Backup and Recovery contient désormais des instructions sur l'utilisation de la CLI ONTAP pour restaurer les données conservées après la désinscription du système.
Pour plus de détails, reportez-vous à "Annuler l’enregistrement de Backup and Recovery pour un système".
Pour plus de détails sur la protection des charges de travail ONTAP Volumes, reportez-vous à "Découvrez la protection des volumes ONTAP avec NetApp Backup and Recovery".
Amélioration des charges de travail Oracle Database
Dans cette version, NetApp Backup and Recovery apporte l'amélioration suivante pour les charges de travail Oracle Database :
Restauration vers un autre emplacement : NetApp Backup and Recovery prend désormais en charge la restauration d'une base de données Oracle vers un autre emplacement (un hôte enregistré différent).
Pour plus de détails sur la protection des charges de travail Oracle Database, consultez "Découvrez comment protéger les charges de travail Oracle Database avec NetApp Backup and Recovery".
Résilience aux ransomwares
Nouveau flux de travail manuel pour la création d'un agent d'activité utilisateur
Ransomware Resilience propose désormais un workflow de création manuelle de l’agent d’activité utilisateur, offrant un contrôle accru sur la façon dont vous créez votre agent d’activité utilisateur sur votre VM. Grâce à ce nouveau workflow, vous pouvez installer directement l’agent d’activité utilisateur et configurer les paramètres de proxy sans fournir de clés SSH de la VM.
Pour plus d'informations, consultez "Créer un agent d'activité utilisateur".
[[20-october-2026]]
== 20 octobre 2026
Résilience aux ransomwares
Configuration améliorée de l’environnement de récupération isolé
Ransomware Resilience propose désormais un flux de travail amélioré pour la configuration d'un environnement de récupération isolé. Ce nouveau flux de travail clarifie et simplifie le processus de mise en place d'un environnement de récupération isolé pour le cloud ou les environnements sur site.
Pour plus d'informations, consultez "Créez un environnement de récupération isolé pour une restauration propre".
Flux de travail amélioré pour activer la surveillance de l'activité des utilisateurs
Ransomware Resilience a amélioré le flux de travail d’activation de la surveillance de l’activité utilisateur. Auparavant, Ransomware Resilience testait la connexion du collecteur de données chaque fois que vous activiez une stratégie de protection contre les ransomwares avec surveillance de l’activité utilisateur sur une charge de travail. Avec cette mise à jour, cette vérification est désormais ignorée s’il existe un collecteur de données pour la storage VM et qu’il est dans l’état "running", ce qui accélère le flux de travail de protection.
Pour plus d'informations, consultez "protéger les charges de travail".
Niveau de service Flex de Google Cloud NetApp Volumes généralement disponible
La prise en charge du niveau de service Flex de Google Cloud NetApp Volumes dans Ransomware Resilience est désormais en disponibilité générale (GA).
[[19-october-2026]]
== 19 octobre 2026
Sauvegarde et récupération
Amélioration des charges de travail Oracle Database
Cette version introduit l'amélioration suivante pour les charges de travail Oracle Database :
Prise en charge d'Oracle Data Guard : NetApp Backup and Recovery prend désormais en charge l'utilisation de groupes de protection pour protéger les bases de données principales et de secours qui utilisent Oracle Data Guard pour une haute disponibilité.
Pour plus de détails sur la protection des charges de travail Oracle Database, consultez "Découvrez comment protéger les charges de travail Oracle Database avec NetApp Backup and Recovery".
[[15-october-2026]]
== 15 octobre 2026
Configuration et administration de la console
Agent Console 4.12.0
La version 4.12.0 prend en charge à la fois le mode standard et le mode restreint.
Cette version de l'agent Console inclut des améliorations de sécurité et des corrections de bugs.
Administration de la NetApp Console
Cette version inclut des améliorations de sécurité et des corrections de bugs.
Conseiller numérique
Prise en charge d’E-Series et de StorageGRID dans Value Insights
Value Insights inclut désormais les systèmes ONTAP, E-Series et StorageGRID dans les totaux relatifs à l’état de santé, aux risques, aux risques de sécurité et au cycle de vie. Vous pouvez filtrer le tableau de bord par plateforme pour afficher des détails spécifiques à la plateforme. Les économies réalisées et projetées restent disponibles pour les systèmes ONTAP uniquement.
[[14-october-2026]]
== 14 octobre 2026
Cloud Volumes ONTAP
Cloud Volumes ONTAP 9.19.1 dans Azure
Vous pouvez désormais utiliser la NetApp Console pour déployer et gérer la version en disponibilité générale (GA) de Cloud Volumes ONTAP 9.19.1 dans Azure.
La Console prend en charge Cloud Volumes ONTAP 9.19.1 sur AWS et Google Cloud depuis août 2026.
Chiffrement Azure sur l'hôte pour Cloud Volumes ONTAP
À partir de Cloud Volumes ONTAP 9.19.1 GA, le chiffrement Azure sur l’hôte est activé par défaut pour les nouveaux déploiements Azure à nœud unique et en haute disponibilité (HA) qui répondent aux prérequis. Cette fonctionnalité chiffre les données sur le serveur physique qui héberge la machine virtuelle, y compris le disque éphémère et les caches associés au niveau de l’hôte, lors de leur écriture sur l’hôte et de leur lecture depuis celui-ci.
Avant de déployer Cloud Volumes ONTAP dans Azure, assurez-vous que votre environnement répond aux prérequis suivants :
-
Cette
EncryptionAtHostfonctionnalité est enregistrée pour votre abonnement Azure. Reportez-vous à "Documentation Microsoft : Activer le chiffrement sur l’hôte". -
Le type d'instance de machine virtuelle que vous avez sélectionné prend en charge le chiffrement sur l'hôte dans votre région Azure. Reportez-vous à "Documentation Microsoft : recherche des tailles de VM prises en charge".
Notez ces points :
-
Aucune configuration supplémentaire n'est requise.
-
Si ces conditions préalables ne sont pas remplies, le chiffrement sur l'hôte Azure n'est pas activé pour votre déploiement Cloud Volumes ONTAP.
-
Le chiffrement côté hôte s'applique uniquement à Azure, et non à AWS ou Google Cloud.
Chiffrement du réseau back-end sur les clusters Cloud Volumes ONTAP dans Azure et Google Cloud
Cloud Volumes ONTAP 9.19.1 et les versions ultérieures prennent en charge le chiffrement du réseau de cluster back-end pour les configurations haute disponibilité dans Azure et Google Cloud.
L'activation du chiffrement du réseau du cluster peut affecter les performances du cluster. Faites preuve de prudence et assurez-vous que votre environnement peut supporter la charge supplémentaire avant d’activer cette fonctionnalité.
Capacité à réduire les interruptions lors de la maintenance planifiée d'Azure
Lors d'une maintenance planifiée, Azure peut suspendre brièvement une machine virtuelle dans une paire haute disponibilité Cloud Volumes ONTAP. ONTAP peut interpréter cette suspension comme une panne de nœud et transférer les opérations de stockage vers le nœud partenaire, puis les rétablir lorsque la machine virtuelle reprend (basculement et rétablissement). Ce processus peut interrompre les connexions client actives, même en l'absence de panne de nœud.
Avec Cloud Volumes ONTAP 9.19.1 et versions ultérieures, vous pouvez activer un paramètre facultatif qui permet à la paire haute disponibilité de continuer à fonctionner pendant un gel de maintenance planifiée d’Azure sans lancer automatiquement le basculement et le rétablissement.
|
|
Cette fonctionnalité est disponible en avant-première publique avec Cloud Volumes ONTAP 9.19.1. |
[[12-october-2026]]
== 12 octobre 2026
Sauvegarde et récupération
Amélioration générale de la sauvegarde et de la restauration NetApp
Dans cette version, NetApp Backup and Recovery introduit l’amélioration de licence suivante pour toutes les charges de travail :
Modification des licences : les frais ne s’appliquent plus aux sauvegardes utilisant une architecture disque à disque ou disque à disque en mode fan-out. Les frais s’appliquent uniquement aux sauvegardes sur stockage objet, y compris celles utilisant une architecture 3-2-1 ou disque vers stockage objet.
Pour plus de détails sur les licences, reportez-vous à "Configurer les licences pour NetApp Backup and Recovery".
Améliorations des charges de travail Hyper-V
Dans cette version, les charges de travail Hyper-V introduisent les améliorations suivantes :
-
NetApp MetroCluster support: NetApp Backup and Recovery vous permet désormais de protéger les VM Hyper-V mises en miroir par NetApp MetroCluster.
-
Protection des disques étendus pour les VM SAN : pour les configurations CIFS et SAN, vous pouvez désormais protéger chaque disque associé à chaque VM dans un groupe de protection. Cela inclut les fichiers répartis sur plusieurs volumes ONTAP ou systèmes de stockage ONTAP (disques étendus), ainsi que les fichiers limités à un seul emplacement.
Pour plus de détails sur la protection des charges de travail Hyper-V, reportez-vous à "Découvrez comment protéger les charges de travail Hyper-V avec NetApp Backup and Recovery".
Amélioration des charges de travail Oracle Database
Cette version introduit l'amélioration suivante pour les charges de travail Oracle Database :
Gestion automatique des journaux d'archivage : lors des opérations de restauration et de clonage de base de données, NetApp Backup and Recovery détecte et monte automatiquement les journaux d'archivage requis, puis les démonte une fois l'opération terminée. Les sources de journaux de stockage primaire, secondaire et objet sont prises en charge.
Pour plus de détails sur la protection des charges de travail Oracle Database, consultez "Découvrez comment protéger les charges de travail Oracle Database avec NetApp Backup and Recovery".
Reprise après sinistre
Ordre de démarrage optionnel pour les groupes de ressources Kubernetes
NetApp Disaster Recovery prend désormais en charge la définition d'un ordre de démarrage optionnel pour les groupes de ressources dans un plan de réplication Kubernetes, en spécifiant un ordre de priorité et un délai optionnel pour les ressources. Cette option vous permet de démarrer les ressources en même temps lorsque cela est nécessaire et de différer le démarrage des ressources qui dépendent d'autres ressources, afin de permettre à vos applications de revenir en ligne correctement.
Pour plus d'informations, consultez "créer un plan de réplication".
SnapLock prise en charge des volumes
La reprise après sinistre prend désormais en charge les volumes SnapLock, ce qui vous permet de basculer vers des copies Snapshot inviolables.. Lors de l'exécution d'un rétablissement avec des volumes SnapLock, vous devez utiliser l'option Take snapshot now pour garantir la réussite du rétablissement.
Pour plus d'informations, consultez les instructions pour "basculement" et "retour arrière".
Exécutions simplifiées d’actualisation et de conformité
Les actualisations pour vCenter, les plans de réplication et la conformité ont été simplifiées en une seule tâche afin de permettre une exécution plus rapide. Pour voir cette modification, découvrez comment "surveiller les tâches".
Contrôles de conformité Kubernetes
Disaster Recovery a ajouté des contrôles de conformité pour identifier les environnements de travail manquants pour les charges de travail Kubernetes. Ces contrôles de conformité contribuent à garantir l'état de santé des charges de travail afin de préserver l'intégrité de vos plans de réplication.
Keystone
Cette version de Keystone STaaS inclut les mises à jour suivantes du tableau de bord Keystone dans la console NetApp.
Générer des informations sur l’état de santé des abonnements Keystone
Vous pouvez télécharger des rapports PowerPoint à la demande ou programmer un envoi unique, hebdomadaire, mensuel ou trimestriel depuis Storage > Keystone > Monitoring > Health reports dans la NetApp Console. Chaque rapport combine l'utilisation des abonnements, l'état opérationnel, les risques et les vulnérabilités des abonnements sélectionnés, vous aidant ainsi à identifier les problèmes et à partager des informations exploitables avec les destinataires. Pour en savoir plus, consultez "Générer et planifier des rapports de santé pour les abonnements Keystone".
Afficher la capacité du cluster ONTAP et de l’agrégat
Vous pouvez consulter la capacité physique, la capacité logique et l'efficacité du stockage des clusters ONTAP et de leurs agrégats dans Assets > Clusters and aggregates. Cette fonctionnalité est disponible uniquement pour les abonnements Keystone STaaS facturés sur la capacité physique. Pour en savoir plus, consultez "Consultez les ressources de vos abonnements Keystone" et "Afficher les ressources associées à un abonnement Keystone".
[[30-september-2026]]
== 30 septembre 2026
Workload Factory
Version initiale de Oracle Cloud Infrastructure NetApp Storage Service for Workload Factory
La version initiale d'OCI NetApp Storage Service (OCI NSS) pour Workload Factory propose l'intégration, la découverte du système, la gestion des identifiants, ainsi que la création et l'association de liens. Pour demander l'accès à OCI NSS, veuillez ouvrir un ticket de support auprès d'Oracle.
Documentation de Workload Factory pour les utilisateurs de NetApp Console
Vous trouverez une documentation détaillée sur Workload Factory dans la NetApp Console, notamment des guides sur l'intégration, la découverte du système, la gestion des identifiants, ainsi que la création et l'association de liens.
[[28-september-2026]]
== 28 septembre 2026
Sauvegarde et récupération
Amélioration générale de la sauvegarde et de la restauration NetApp
Dans cette version, les charges de travail KVM, Hyper-V et VMware introduisent l'amélioration suivante :
Prise en charge du contrôle d'accès basé sur les rôles (RBAC) de la Console : les charges de travail Hyper-V, KVM et VMware prennent désormais en charge le framework NetApp Console pour le RBAC, vous permettant de gérer l'accès à des hôtes Hyper-V, KVM ou VMware individuels.
Améliorations des charges de travail des volumes ONTAP
Dans cette version, les workloads ONTAP Volumes introduisent les améliorations en avant-première suivantes :
-
Prise en charge de Azure Entra ID pour Cloud Volumes ONTAP : vous pouvez désormais utiliser l'authentification Microsoft Entra ID pour les configurations de compartiments de stockage objet Azure si vous ne souhaitez pas utiliser la clé d'accès du compte de stockage pour l'authentification Azure. Cette option est prise en charge pour Cloud Volumes ONTAP sur les systèmes Azure exécutant ONTAP 9.16.1 ou version ultérieure.
-
Filtrage personnalisé par plage de dates dans Job Monitor : Vous pouvez désormais rechercher des tâches des 90 derniers jours en sélectionnant une date de début et une date de fin personnalisées à partir d’un calendrier dans Job Monitor.
Pour plus de détails sur la protection des charges de travail ONTAP Volumes, reportez-vous à "Découvrez la protection des volumes ONTAP avec NetApp Backup and Recovery".
Amélioration des charges de travail VMware
Dans cette version, les charges de travail VMware introduisent l'amélioration suivante :
Prise en charge de Google Cloud NetApp Volumes Flex Unified : NetApp Backup and Recovery for VMware workloads prend désormais en charge le niveau de service Flex Unified pour Google Cloud NetApp Volumes. Flex Unified est pris en charge uniquement en mode ONTAP.
Pour plus de détails sur la protection des charges de travail VMware, consultez "Protégez les charges de travail VMware avec NetApp Backup and Recovery".
[[25-september-2026]]
== 25 septembre 2026
Conseiller numérique
Mise à jour du contenu du tableau de bord Value Insights
Une mise à jour de la documentation du tableau de bord Value Insights a été publiée.
En savoir plus sur "Comment utiliser le tableau de bord Value Insights dans Digital Advisor".
Avis de dépréciation pour Config Drift
La fonctionnalité Config Drift est obsolète et n'est plus disponible dans Digital Advisor à compter de septembre 2026.
Pour toute question ou pour partager des commentaires, contactez l'équipe Active IQ.
[[21-september-2026]]
== 21 septembre 2026
Sauvegarde et récupération
Améliorations des charges de travail des volumes ONTAP
Dans cette version, les workloads ONTAP Volumes introduisent les améliorations en avant-première suivantes :
-
Prise en charge améliorée des sites distants : NetApp Backup and Recovery pour les sites distants offre désormais les mêmes fonctionnalités de protection des données ONTAP Volumes que NetApp Backup and Recovery. Cette amélioration comprend des services de sauvegarde, de restauration et de gestion des tâches mis à jour, ainsi qu'une nouvelle base de données. Lors d'une mise à niveau, les données de la base de données existante sont conservées et migrées automatiquement. Après la mise à niveau, consultez les journaux d'audit pour vérifier que la migration s'est déroulée correctement. NetApp Backup and Recovery pour les sites distants prend uniquement en charge les charges de travail ONTAP Volumes.
-
Annulation des tâches de restauration de volumes : Vous pouvez désormais annuler les tâches de restauration de volumes ONTAP en cours depuis la page de surveillance des tâches, ce qui facilite la gestion des tâches longues ou lentes.
-
Amélioration du rapport sur l’état d’indexation des volumes : Le tableau de bord ONTAP Volumes rapporte désormais l’état d’indexation avec plus de précision en introduisant le statut
Not Applicablepour les volumes et les copies d’instantané qui ne sont pas éligibles à l’indexation. Le statutNot Indexedest désormais réservé aux volumes en attente d’indexation, et les détails du volume affichent maintenant l’état d’indexation de chaque instantané avec une infobulle expliquant pourquoi un volume ou une copie d’instantané ne sera pas indexé. -
Prise en charge de NetApp AFX : Vous pouvez désormais protéger les volumes hébergés sur des clusters NetApp AFX à 2 et 4 nœuds.
Pour plus de détails sur la protection des charges de travail ONTAP Volumes, reportez-vous à "Découvrez la protection des volumes ONTAP avec NetApp Backup and Recovery".
Améliorations des charges de travail Kubernetes
Cette version introduit les améliorations suivantes pour les charges de travail Kubernetes :
-
Trident Protect 26.09 : Cette version inclut Trident Protect 26.09.
-
Contrôle d'accès basé sur les rôles (RBAC) granulaire au niveau du cluster et de l'espace de noms : lors de la découverte d'un cluster Kubernetes, vous pouvez contrôler l'accès aux ressources en sélectionnant un projet ou un dossier à associer au nouveau cluster. Vous pouvez également enregistrer des espaces de noms spécifiques pour le contrôle d'accès. Cela permet un contrôle d'accès plus granulaire au niveau du cluster ou de l'espace de noms.
-
Restauration de fichiers et de dossiers : Vous pouvez désormais restaurer ou télécharger des fichiers et des dossiers spécifiques à partir des sauvegardes d'applications basées sur des machines virtuelles Kubernetes.
Pour plus de détails sur la protection des charges de travail Kubernetes, consultez "Découvrez comment protéger les charges de travail Kubernetes avec NetApp Backup and Recovery".
Cloud Volumes ONTAP
Prise en charge des licences basées sur la capacité dans les déploiements en mode privé
Vous pouvez désormais déployer des systèmes Cloud Volumes ONTAP en mode privé avec des licences basées sur la capacité sur AWS, Azure et Google Cloud.
NetApp prend en charge uniquement le pack Essentials pour les licences basées sur la capacité en mode privé. Achetez un pack Essentials Bring-Your-Own License (BYOL) basé sur la capacité auprès de NetApp et attribuez-le à votre système lors du déploiement. Les 500 premiers Gio de capacité consommée ne sont pas déduits du coût de votre licence. Vous pouvez acheter des modules supplémentaires à mesure que vos besoins en charge de travail augmentent.
NetApp recommande une licence basée sur la capacité pour tous les déploiements Cloud Volumes ONTAP en mode privé. Si vous disposez déjà de déploiements en mode privé avec des licences par nœud, vous pouvez les convertir en licences basées sur la capacité en achetant un pack Essentials auprès de NetApp. Cette nouvelle capacité de déploiement, combinée à l’option de conversion, soutient le plan de NetApp visant à passer progressivement des licences par nœud aux licences basées sur la capacité.
[[17-september-2026]]
== 17 septembre 2026
Configuration et administration de la console
Publication du mode privé (4.10.0)
Une nouvelle version en mode privé est désormais disponible au téléchargement depuis le "Site de support NetApp"
La version 4.10.0 inclut des mises à jour des composants et services suivants de la NetApp Console.
| Composant ou service | Version incluse dans cette release | Modifications depuis la version précédente du mode privé |
|---|---|---|
Agent de console |
4.10.0 |
Rendez-vous sur le "Nouveautés de la page NetApp Console" et consultez les modifications incluses pour les versions 4.10.0. |
NetApp Backup and Recovery |
5.6.2 (31 août 2026) |
Allez à la "Nouveautés de la page NetApp Backup and Recovery". |
NetApp Data Classification |
1.546.0 (10 août 2026) |
Allez à la "Nouveautés de la page Classification NetApp". |
Le mode privé 4.10.0 prend en charge Red Hat Enterprise Linux (RHEL) 9.6
Le mode privé peut désormais être installé et exécuté sur Red Hat Enterprise Linux (RHEL) 9.6, offrant aux utilisateurs le système d'exploitation le plus récent pris en charge pour une sécurité et des performances améliorées. "Découvrez les exigences de l’hôte pour le mode privé"
[[16-september-2026]]
== 16 septembre 2026
Configuration et administration de la console
Agent de console 4.11.0
La version 4.11.0 prend en charge à la fois le mode standard et le mode restreint.
Cette version de l'agent Console inclut des améliorations de sécurité et des corrections de bugs.
Administration de la NetApp Console
Flux de déploiement d'agents simplifié pour les abonnés Cloud Volumes ONTAP dans AWS Marketplace
Si vous êtes un nouvel abonné à un "Abonnement Cloud Volumes ONTAP autonome sur AWS Marketplace", la NetApp Console simplifie désormais le déploiement de l’agent. Vous pouvez configurer les rôles, les stratégies et les informations d’identification AWS en moins d’étapes, utiliser automatiquement les valeurs par défaut sur une seule page et accélérer la configuration.
Sauvegarde et récupération
Amélioration générale de la sauvegarde et de la restauration NetApp
Dans cette version, les charges de travail KVM, Hyper-V et VMware introduisent l'amélioration suivante :
Sélection des informations d'identification lors de la découverte de l'hôte de machine virtuelle : Lorsque vous découvrez un hôte KVM, Hyper-V ou VMware, vous pouvez désormais utiliser les informations d'identification que vous avez déjà ajoutées à Backup and Recovery.
Amélioration des charges de travail Hyper-V
Dans cette version, les charges de travail Hyper-V introduisent l'amélioration suivante :
Protection étendue des disques pour les machines virtuelles : pour les configurations CIFS, NetApp Backup and Recovery prend désormais en charge la protection de chaque disque attaché à chaque machine virtuelle d'un groupe de protection. Cela inclut les fichiers répartis sur plusieurs volumes ONTAP ou systèmes de stockage ONTAP (disques étendus) ainsi que les fichiers limités à un seul emplacement.
Pour plus de détails sur la protection des charges de travail Hyper-V, reportez-vous à "Découvrez comment protéger les charges de travail Hyper-V avec NetApp Backup and Recovery".
Amélioration des charges de travail des volumes ONTAP
Dans cette version, les charges de travail ONTAP Volumes introduisent l'amélioration suivante en avant-première :
Rapport quotidien de transfert de données de sauvegarde : NetApp Backup and Recovery for Volumes inclut désormais un rapport quotidien de transfert de données de sauvegarde dans l’onglet Rapports, vous offrant une visibilité sur l’activité quotidienne de transfert de données de sauvegarde et de réplication au sein de votre environnement. Vous pouvez générer le rapport pour l’ensemble du compte ou pour des systèmes de stockage sélectionnés, filtrer par plage de dates et type de protection, et télécharger les résultats au format CSV.
Pour plus de détails sur la protection des charges de travail ONTAP Volumes, reportez-vous à "Découvrez la protection des volumes ONTAP avec NetApp Backup and Recovery".
Classification des données
Améliorations générales
Cette version de Data Classification inclut des améliorations de sécurité et de performances.
Reprise après sinistre
La prise en charge de Kubernetes dans NetApp Disaster Recovery est désormais généralement disponible (GA)
La prise en charge des charges de travail basées sur Kubernetes dans NetApp Disaster Recovery est désormais généralement disponible (GA). Avec la prise en charge des charges de travail basées sur Kubernetes, vous pouvez protéger les applications exécutées sur des clusters Kubernetes, y compris les environnements OpenShift Virtualization. Disaster Recovery est compatible avec toute version de Kubernetes actuellement prise en charge par Trident Protect, garantissant une intégration transparente et des capacités de reprise après sinistre robustes pour les applications conteneurisées.
Pour commencer à protéger les charges de travail basées sur Kubernetes, consultez "Exigences de Kubernetes pour NetApp Disaster Recovery".
Transformations des ressources
La reprise après sinistre prend désormais en charge les transformations de ressources, vous permettant de modifier n'importe quel aspect d'une charge de travail lors d'un basculement. Cette fonctionnalité offre la flexibilité nécessaire pour adapter les charges de travail à différents environnements et configurations lors d'un incident de reprise après sinistre.
Les transformations de ressources sont appliquées lors de la création d'un plan de réplication. Vous pouvez créer, modifier et supprimer des transformations de ressources dans la nouvelle page Paramètres. Pour plus d'informations, consultez "Gérer les transformations des ressources".
Exécution du script
Il est désormais possible d'intégrer des scripts personnalisés au processus de basculement afin de coordonner la mise en veille et la reprise des applications. Cette fonctionnalité permet de garantir que les applications sont correctement préparées avant qu'un instantané ne soit répliqué et restauré de manière appropriée, afin que les opérations puissent reprendre sans interruption après un basculement.
Pour savoir comment injecter un script personnalisé, consultez "Créez un plan de réplication".
Nouvelle page Charges de travail
La fonctionnalité NetApp Disaster Recovery intègre désormais une page « Workloads » à son interface utilisateur, offrant une vue d'ensemble de toutes les workloads détectées et de leur état de protection. La page Workloads vous permet de surveiller et de gérer vos workloads plus efficacement.
Pour plus d'informations, consultez "Examiner l'état de santé et de protection dans NetApp Disaster Recovery".
Page Paramètres
NetApp Disaster Recovery propose désormais une page Paramètres permettant de gérer de manière centralisée les modèles de transformation des ressources et AppVaults. Cette page offre une interface unique pour configurer et gérer ces composants essentiels de vos plans de reprise après sinistre. Pour en savoir plus sur les options de la page Paramètres, consultez "Gérer les transformations des ressources" et "Gérer AppVaults".
Améliorations générales
La fonctionnalité de Disaster Recovery a introduit des validations améliorées sur la page de création du plan de réplication afin de garantir une expérience utilisateur plus fluide et sans erreur.
La reprise après sinistre a également permis d'accroître la résilience du service afin de tolérer les délais d'attente intermittents des requêtes, améliorant ainsi les performances et la fiabilité globales de l'interface utilisateur.
Résilience aux ransomwares
Prise en charge de la restauration propre en cas de comportement utilisateur suspect et d’attaques de chiffrement basées sur l’utilisateur
Les restaurations propres sont désormais disponibles pour la récupération après un comportement utilisateur suspect et des attaques par chiffrement basées sur l'utilisateur. Cette amélioration vient s’ajouter à la prise en charge existante des attaques basées sur le chiffrement (entropie). Cette capacité améliorée vous permet de tirer parti de l’approche guidée de la restauration propre, en identifiant les points de restauration optimaux afin de minimiser la perte de données et d’accélérer la récupération.
Pour plus d'informations, consultez "Créez un environnement de récupération isolé pour une restauration propre".
[[14-september-2026]]
== 14 septembre 2026
Conseiller numérique
Avis de dépréciation pour la machine virtuelle
La fonctionnalité de machine virtuelle sera supprimée de Digital Advisor en octobre 2026.
Pour toute question ou pour partager des commentaires, contactez l'équipe Active IQ.
[[02-september-2026]]
== 02 septembre 2026
Cloud Volumes ONTAP
Prise en charge de Cloud Volumes ONTAP dans les régions Azure Secret et Top Secret (aperçu privé)
Cloud Volumes ONTAP prend désormais en charge le déploiement dans les régions Azure Government Secret et Top Secret en préversion privée. Cette fonctionnalité étend Cloud Volumes ONTAP aux environnements Azure classifiés de Microsoft, permettant ainsi aux clients gouvernementaux et de défense d'utiliser ONTAP pour la gestion des données, la protection et la reprise après sinistre, afin de prendre en charge les charges de travail liées à la sécurité nationale. Contactez votre équipe NetApp pour participer.
Pour plus d'informations, consultez la documentation Azure :
[[01-september-2026]]
== 01 septembre 2026
StorageGRID
Prise en charge de StorageGRID 12.1
Vous pouvez désormais gérer votre système StorageGRID 12.1 depuis la NetApp Console.
[[31-august-2026]]
== 31 août 2026
Reprise après sinistre
Gestion améliorée des instantanés SnapMirror
Vous pouvez désormais déclencher un basculement à l'aide du dernier instantané, ce qui est la méthode privilégiée lorsque vous ne prenez pas de nouvel instantané.
Lors de la sélection d'une ligne de base de snapshot spécifique, les snapshots de transfert SnapMirror sont masqués par défaut. En effet, ils peuvent être supprimés pendant un basculement, ce qui empêche de reprotéger la charge de travail après le basculement en raison d'une erreur « no common snapshot found ». Vous pouvez toujours utiliser ces snapshots, mais vous devrez compléter une confirmation supplémentaire pour reconnaître le risque.
Pour plus d'informations, voir "Basculement vers un site distant".
Autres améliorations
-
Des améliorations mineures ont été apportées pour accroître la résilience du workflow de test de basculement.
-
Une erreur de validation lors de l'ajout d'un script a été corrigée.
[[25-august-2026]]
== 25 août 2026
Résilience aux ransomwares
Diffusion des événements SIEM via l'agent de la Console
Ransomware Resilience prend désormais en charge la diffusion des événements SIEM via l'agent Console, en plus de l'option existante de diffusion des événements via NetApp Console.
Lorsque vous diffusez des événements SIEM via l'agent Console, vous pouvez maintenir la diffusion des événements SIEM à l'intérieur des limites de votre réseau. Cela simplifie le déploiement dans les environnements sur site dotés de listes d'adresses IP autorisées strictes et peut mieux s'aligner avec les contrôles de sécurité existants. Pour utiliser cette option, assurez-vous que l'agent Console puisse résoudre et se connecter à votre point de terminaison SIEM sur le port requis à travers tout contrôle de pare-feu ou de proxy.
Pour plus d'informations, consultez "Configurer un système SIEM".
Cloud Volumes ONTAP
Prise en charge des régions Austria East et Belgium Central dans Azure
Vous pouvez désormais déployer Cloud Volumes ONTAP 9.12.1 GA et versions ultérieures dans les régions Austria East (austriaeast) et Belgium Central (belgiumcentral) dans Azure. Les types de déploiement suivants sont pris en charge :
-
Nœud unique
-
HA dans une seule zone de disponibilité avec un stockage localement redondant (LRS)
-
HA dans plusieurs zones de disponibilité utilisant un stockage redondant de zone (ZRS)
Pour obtenir la liste de toutes les régions prises en charge, veuillez vous référer au "Carte des régions mondiales sous Azure".
[[20-august-2026]]
== 20 août 2026
Conseiller numérique
Présentation de Value Insights
La fonctionnalité Value Insights centralise les informations relatives à l'état général, aux économies, à la stabilité et à la sécurité des systèmes ONTAP. Vous pouvez utiliser ces informations pour améliorer l'état et les performances de votre système ONTAP grâce à une vision continue et basée sur les données de votre environnement ONTAP.
|
|
Value Insights est uniquement disponible pour les systèmes ONTAP. |
En savoir plus sur "Perspectives sur la valeur".
[[17-august-2026]]
== 17 août 2026
Sauvegarde et récupération
Améliorations des charges de travail Hyper-V
Dans cette version, les charges de travail Hyper-V introduisent l'amélioration suivante :
Restaurer la sauvegarde du stockage objet vers un emplacement alternatif : Vous pouvez désormais restaurer les machines virtuelles Hyper-V, les fichiers et les dossiers du stockage objet vers un emplacement de stockage alternatif.
Pour plus de détails sur la protection des charges de travail Hyper-V, reportez-vous à "Découvrez comment protéger les charges de travail Hyper-V avec NetApp Backup and Recovery".
Améliorations des charges de travail Kubernetes
Cette version introduit les améliorations suivantes pour les charges de travail Kubernetes :
-
Trident Protect 26.08 : Cette version inclut Trident Protect 26.08.
-
Tentatives de sauvegarde : Vous pouvez désormais activer les tentatives de sauvegarde et configurer le nombre de tentatives et les intervalles entre les tentatives en tant que paramètres avancés dans les politiques de protection Kubernetes.
-
Succès partiel de la sauvegarde : Vous pouvez désormais configurer les paramètres avancés des politiques de protection Kubernetes pour poursuivre la sauvegarde en cas de défaillance de certaines ressources, ce qui permet aux tâches de sauvegarde de se terminer comme partiellement réussies. Cela vous permet de restaurer les ressources sauvegardées même si certaines ressources échouent pendant l’opération de sauvegarde.
-
Sauvegardes cohérentes avec le crash et cohérentes avec la VM : le service Backup and Recovery for NetApp Console prend désormais en charge la configuration de politiques de protection qui créent des sauvegardes ou des snapshots cohérents avec le crash ou cohérents avec la VM. Vous pouvez également personnaliser la manière dont s'effectuent les gels de VM pendant l'opération de protection.
-
Reconnexion du cluster Kubernetes suite à un changement d'adresse IP de l'agent Console : Le service Backup and Recovery for NetApp Console vous permet désormais de reconnecter un cluster à son agent Console si l'adresse IP de l'agent change.
-
Migration du cluster vers un nouvel agent Console : Le service de sauvegarde et de récupération pour NetApp Console vous permet désormais de migrer un cluster vers un nouvel agent Console si l’agent d’origine tombe en panne ou est supprimé, garantissant ainsi une protection ininterrompue des applications.
Pour plus de détails sur la protection des charges de travail Kubernetes, consultez "Découvrez comment protéger les charges de travail Kubernetes avec NetApp Backup and Recovery".
Amélioration des charges de travail Oracle Database
Cette version introduit les améliorations suivantes pour les charges de travail de la base de données Oracle :
-
Restauration de pluggable databases (PDB) : Vous pouvez désormais restaurer des pluggable databases (PDB) individuelles et des espaces de tables PDB, y compris la récupération à un point précis dans le temps.
-
Clonage de base de données enfichable (PDB) : Vous pouvez désormais cloner une seule PDB dans une base de données conteneur (CDB) existante, et éventuellement exclure des PDB lorsque vous clonez une base de données conteneur complète.
Pour plus de détails sur la protection des charges de travail Oracle Database, consultez "Découvrez comment protéger les charges de travail Oracle Database avec NetApp Backup and Recovery".